 AIREITER
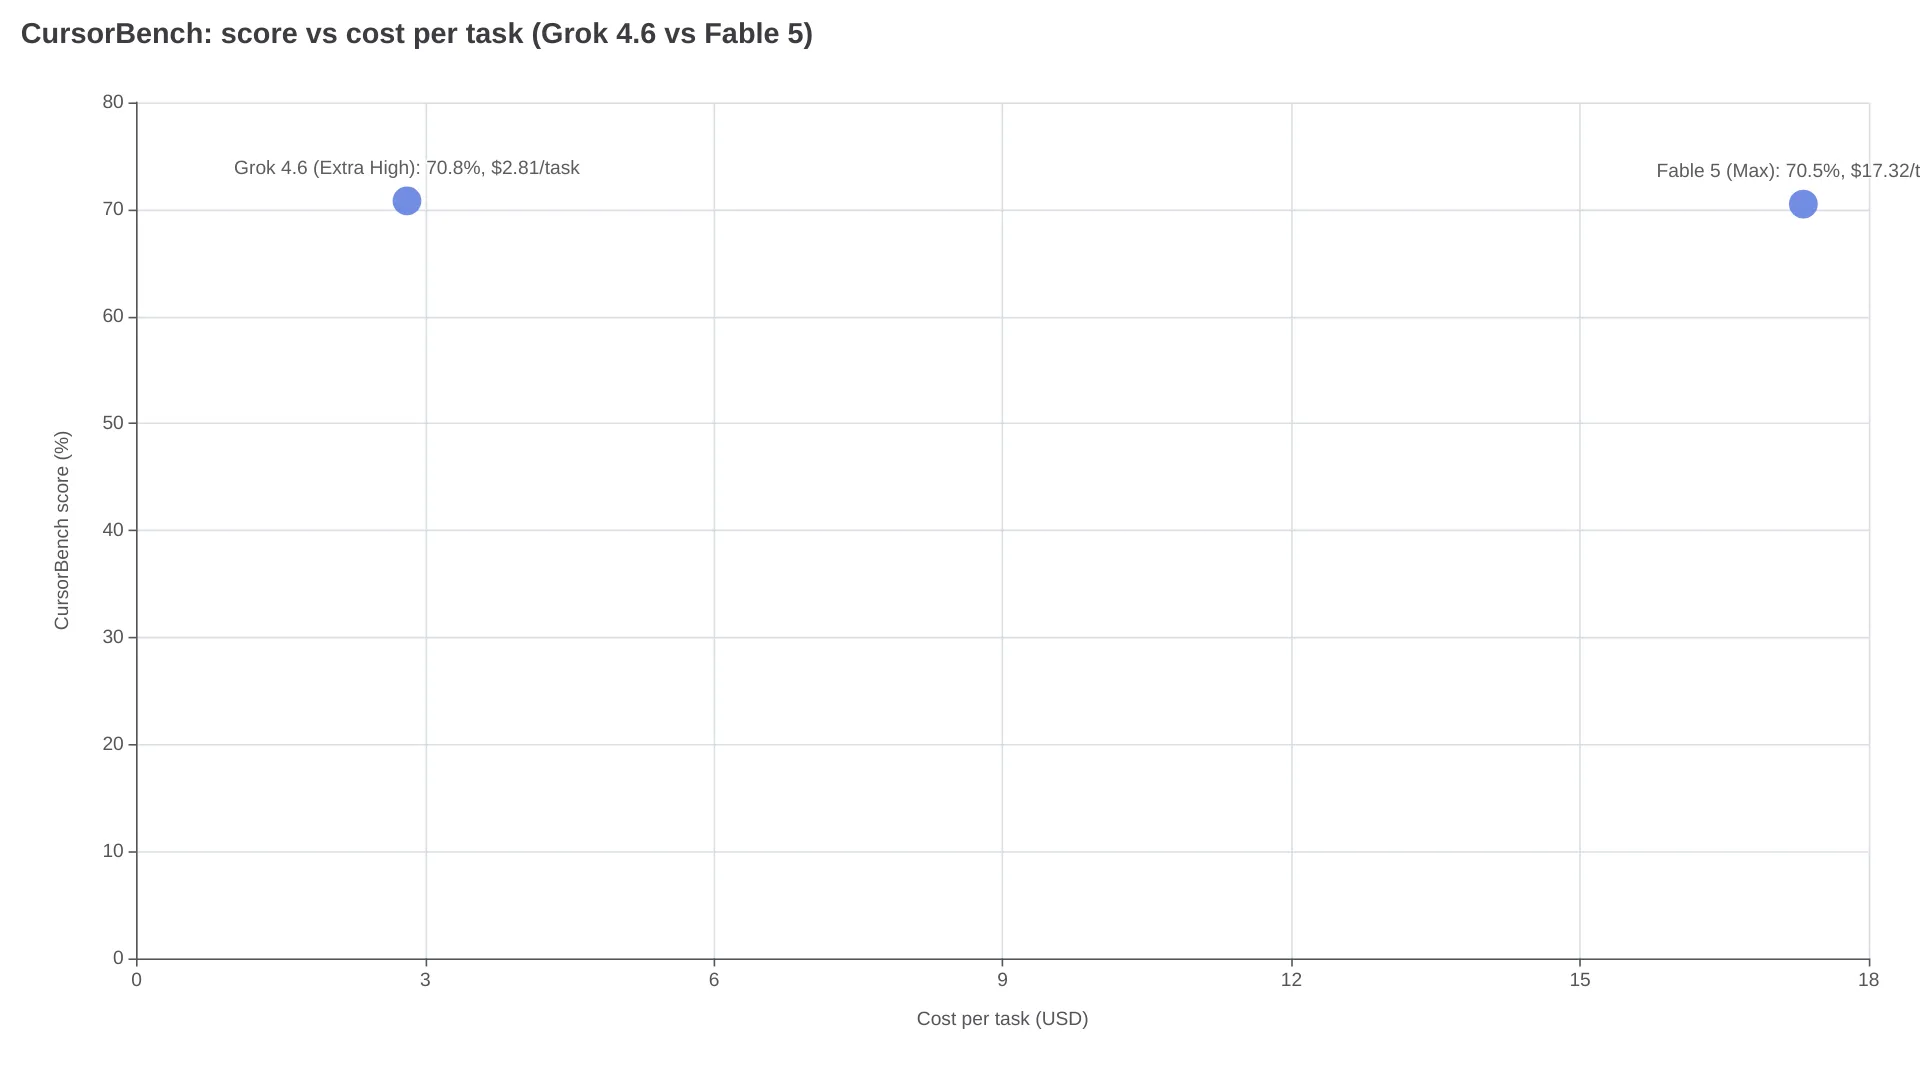
Bir kodlama ajanının gerçekten pahalı olup olmadığını token fiyatından çok, tamamladığı işin faturası gösteriyor. CursorBench'te Grok 4.6 Extra High %%70,8 puana görev başına $2.81 maliyetle ulaşırken, Fable 5 Max aynı ajan altyapısında %%70,5 ve görev başına $17.32 kaydetti. Kodlama ajanları açısından sonuç pratikte beraberlik; maliyetteyse 6 katlık ciddi bir fark var. Buna karşılık Fable 5, daha geniş Artificial Analysis zekâ endeksinde liderliğini ve iki kat büyük bağlam penceresini hâlâ elinde tutuyor.
Grok 4.6, Fable 5'e nasıl yaklaştı?
İki ay önce bu kıyaslamanın kazananı daha netti. Artificial Analysis, Temmuz 2026'da Grok 4.5'i Intelligence Index'te 56, Fable 5'i ise 62 puanda değerlendirmişti; arada altı puan vardı. Ağustos 2026'da çıkan Grok 4.6, bildirilen benchmark farklarına göre tahminen beş puan kazanarak ~59'a, yani GPT-5.6 Sol seviyesine yaklaştı. Böylece Fable 5'in avantajı yaklaşık üç puana indi.
Kodlama ajanı tarafında fark daha da kapandı. Fable 5, Haziran 2026'da Cursor'a geldiğinde CursorBench'te %%72,9 ile yeni bir rekor kırmıştı; bu, önceki en iyi sonucun 8 puan üzerindeydi (r/accelerate). Grok 4.6'nın yayınlanmasının ardından r/cursor'da paylaşılan Ağustos karşılaştırmasında ise Grok 4.6 Extra High %%70,8, Fable 5 Max %%70,5 aldı. Aynı ajan altyapısında bu sonuçlar fiilen beraberlik anlamına geliyor. Yine de karşılaştırmayı yapan bir Cursor kullanıcısının şu uyarısını akılda tutmak gerek:
"Grok 4.6 bana şunu düşündürdü: CursorBench skorunun ne kadarı modelden, ne kadarı ajan altyapısından geliyor?" - r/cursor başlığı, Ağustos 2026
Benchmark skorları yalnızca temel modeli değil; istem iskeletini, araçları ve yeniden denemeleri içeren tüm ajan yığınını ölçüyor. Ayrıca Fable 5'in %%72,9'luk çıkış sonucu ile Ağustos'taki %%70,5'lik sonucu farklı yapılandırmalardan geldi. Bu nedenle iki veriyi de kesin hüküm yerine yön gösterici kabul etmek doğru olur.
Görev başı maliyette Grok 4.6 açık ara önde
Ağustos karşılaştırmasındaki görev başı veriler, asıl tabloyu ortaya koyuyor:
| Metrik (CursorBench) | Grok 4.6 Extra High | Fable 5 Max |
|---|---|---|
| Skor | %%70,8 | %%70,5 |
| Görev başı maliyet | $2.81 | $17.32 |
| Görev başı adım | 46 | 72 |
Fable 5, aynı skora ulaşmak için %%57 daha fazla ajan adımına ihtiyaç duydu. Ek adımlar ve bunların taşıdığı reasoning token'ları, maliyet farkını da açıklıyor. İki model arasında geçiş yapan geliştiricilerin yalnızca etiket fiyatına bakmayı sorgulamasının nedeni bu:
"$/token, AI ajanlarını karşılaştırmak için giderek yanlış bir metrik hâline geliyor." - r/grok başlık metni, Ağustos 2026
Token başına liste fiyatları farkın bir kısmını açıklıyor. Fable 5, Anthropic API'de milyon token başına giriş için $10, çıkış için $50 talep ediyor. Grok 4.5'in yayımlanmış xAI API fiyatı ise 200K token'ın altındaki istemlerde milyon token başına $2 giriş ve $6 çıkıştı. xAI, 4.6 için ayrı bir fiyat kartı yayımlamadı; r/grok topluluğu 4.6'nın "API fiyatının çok küçük bir bölümünde Sol düzeyi performans" sunduğunu bildiriyor. Tüm katmanlardaki Fable 5 ücretleri için Fable 5 API fiyatlandırma dökümüne bakabilirsiniz.
Pratikte bu avantajı daraltan iki unsur var. xAI'ın yayımladığı fiyatlara göre Grok'un ücretleri 200K token'ı aşan istemlerde yaklaşık iki katına çıkıyor; bu katmanda milyon token için $4 giriş ve $12 çıkış ödeniyor. Ayrıca iş akışınız zaten Fable 5'e büyük ölçüde dayanıyorsa, model değiştirmeden önce Fable 5 token maliyetlerini düşürmenin yapısal yolları bulunuyor.
Fable 5'in üstün kaldığı alanlar
| Alan | Kanıt | Sizin için anlamı |
|---|---|---|
| Zekâ endeksi | Fable 5, AA Intelligence Index'te hâlâ 1 numara: 62'ye karşı Grok 4.6 yaklaşık 59 | 4.6 sıçramasından sonra eski altı puanlık farkın üç puanı korundu |
| Bağlam penceresi | Fable 5, 1.000.000 token bağlam sunuyor; Grok'ta bu değer 500.000 | Büyük bir repo ve görev geçmişi tek geçişte sığıyor; Grok'un fiyat avantajı 200K üzeri katmanda azalıyor |
| En zor görevlerde güvenilirlik | TryAI'ın uygulama testinde Fable 5, 3D Rubik Küpü'nü ilk denemede oluşturdu ve en iyi SVG'yi üretti; Grok 4.5 yeniden çalıştırma gerektirdi. Goldie Bench, 47 tek seferlik görevde Fable 5'i 20-17 önde gösterdi; shader ve GPU fiziği projelerini 0,8-1,6 puan farkla kazandı | Görev belirsizse ve tek deneme hakkınız varsa, Fable 5'in reasoning tavanı kendini gösteriyor |
Hız, gecikme ve çıktı kapasitesi
TryAI'ın aynı sağlayıcı yönlendirmesiyle, 400 token sınırı ve her istem türü için üç çalıştırmayla ölçtüğü değerler şöyle:
| Metrik | Grok 4.5 | Fable 5 |
|---|---|---|
| İlk token'a kadar süre | 0.44 sn | 3.47 sn |
| Çıktı hızı | 110 tok/sn | 28 tok/sn |
| Yanıt başı maliyet | $0.00002 | $0.00009 |
| Başarı oranı | %%100 | %%100 |
Grok, 110 tok/sn ile GPT-5.5 ve Opus 4.8'in yaklaşık iki katı, Fable 5'in 28 tok/sn değerinin de yaklaşık dört katı hız üretti. Artificial Analysis, maksimum eforlu reasoning modunda Fable 5 için daha çarpıcı bir değer paylaşıyor: Grok'ta 8.68 saniye olan ilk yanıt token'ı süresi, Fable 5'te 113.68 saniye. Ancak akış başladıktan sonra Fable 5 token'ları hafifçe daha hızlı çözüyor: 63.1 tok/sn'ye karşı 58.9 tok/sn. Pratik karşılığı net: Grok etkileşimli döngülerde daha atik hissettiriyor; Fable 5 ise uzun düşünmeyi başa yüklüyor ve bunun bedelini toplam sürede ödüyor.
Erişim, abonelikler ve ajan araçları
Fable 5, Anthropic API, Claude Code ve Cursor üzerinden sunuluyor; API dışındaki kullanımın büyük kısmı sabit ücretli Claude Pro abonelikleriyle karşılanıyor. CLAUDE.md, eklentiler, skills ve MCP sunucularını kapsayan Claude Code ekosistemi yıllardır olgunlaşıyor.
Grok 4.6, xAI API ve Grok Build CLI üzerinden erişilebilir durumda (curl -fsSL https://x.ai/cli/install.sh | bash); X Premium ise sohbet erişimini pakete dahil ediyor. ClockedCode'a göre Grok Build; mevcut CLAUDE.md dosyalarını, Claude Code eklentilerini, skills'leri, MCP sunucularını, ajanları ve hook'ları hiçbir yapılandırma gerektirmeden okuyabiliyor. CI için -p bayrağıyla headless çalışıyor ve gömme senaryoları için Agent Client Protocol sunuyor. Ekosistem daha genç olsa da Claude Code uyumluluğu, desteklenen kurulumlarda geçiş maliyetini neredeyse sıfıra indiriyor.
Her iki tarafta da önemli bir faturalandırma gerçeği var: Claude Pro ve X Premium aboneleri sabit ücret ödüyor. Bu nedenle gerçek iş yükünüz altındaki kullanım limitleri, fiyat kartından daha belirleyici olabilir.
Hangi senaryoda hangi modeli seçmeli?
| Durumunuz | Tercih | Neden |
|---|---|---|
| Yüksek hacimli, iyi tanımlanmış kodlama işleri | Grok 4.6 | CursorBench skorları berabereyken görev başına $2.81'e karşı $17.32 |
| Büyük bir repoda doğruluğun kritik olduğu işler | Fable 5 | 1M bağlam penceresi, 1 numaralı zekâ endeksi ve ilk denemede en iyi güvenilirlik |
| Etkileşimli ajan oturumları, hızlı iterasyon | Grok 4.6 | 0.44 sn ilk token, 110 tok/sn |
| Belirsiz, tek seferlik projeler ve en zor reasoning işleri | Fable 5 | TryAI'ın en zor görevini ve Goldie Bench ikili karşılaştırmalarını kazandı |
| Bütçesi sınırlı API harcaması | Grok 4.6 | Çıkış token'ları Fable 5 fiyatının yaklaşık sekizde biri |
Benim değerlendirmem şu: Sınırları net, tekrarlı işler için varsayılan tercih Grok 4.6 olmalı; yanlış cevabın token maliyetinden daha pahalıya mal olduğu görevlerde ise Fable 5 saklanmalı. Gerçek iş hacmine sahip ekiplerin iki modeli de çalıştırıp temsilî görev boyutu, yeniden deneme oranı ve tamamlanan görev maliyetine göre yönlendirme yapması daha mantıklı. Bu yaklaşım, yalnızca bir modele bağlanmaktan daha ucuz olabilir.
Sık sorulan sorular
Kodlama için Grok 4.6, Fable 5'ten daha mı iyi?
CursorBench'te berabere durumdalar: Ağustos karşılaştırmasında Grok 4.6 Extra High %%70,8, Fable 5 Max ise %%70,5 aldı. Fable 5 daha geniş Artificial Analysis zekâ endeksinde hâlâ önde (62'ye karşı ~59) ve en zor tek seferlik görevleri kazanıyor. Dolayısıyla "daha iyi" seçimi, darboğazınızın görev başı maliyet mi yoksa doğruluk tavanı mı olduğuna bağlı.
Grok 4.6, Fable 5'ten daha ucuz mu?
Evet. Tamamlanan CursorBench görevi başına yaklaşık 6 kat daha ucuz: $2.81'e karşı $17.32. Token başı kıyaslama, xAI henüz 4.6 için ayrı bir fiyat kartı yayımlamadığından Grok 4.5'in yayımlanmış ücretlerine dayanıyor: milyon token başına $6 çıkış, Fable 5'te ise $50. Grok fiyatının yaklaşık iki katına çıktığı 200K token üzerindeki kullanımda fark daralıyor.
Hangi modelin bağlam penceresi daha büyük?
Fable 5, Grok'un 500.000 token'ına karşı 1.000.000 token bağlam sunuyor. Tüm kod tabanını bağlamda tutan iş yüklerinde bu fark, Grok'un fiyat avantajından daha ağır basabilir.
Grok Build, mevcut Claude Code kurulumumu kullanabilir mi?
Evet. Grok Build; CLAUDE.md, Claude Code eklentileri, skills, MCP sunucuları, ajanlar ve hook'ları hiçbir taşıma işlemi olmadan otomatik olarak okuyor. Ayrıca Grok'a özgü yapılandırma için kendi .grok/ dizinini ekliyor.
Grok 4.5 benchmark'ları, Grok 4.6 için iyi bir gösterge mi?
Yetenek açısından hayır. Grok 4.6, 4.5'e kıyasla Intelligence Index'te yaklaşık beş puan kazandı; Fable 5 karşısındaki altı puanlık açığı yaklaşık üç puana indirdi ve 4.5'in açıkça geride kaldığı CursorBench'te Fable 5 Max ile berabere kaldı. Bu makaledeki hız ve token başı fiyat verileri ise eşdeğer Grok 4.6 rakamları henüz yayımlanmadığı için Grok 4.5 ölçümlerine ait.
Kolayca çözülemeyecek ödünleşim
Bu karşılaştırmadaki hiçbir benchmark, repo 50.000 satır olduğunda, iş talebi belirsiz kaldığında ve başarısız bir denemenin bir saatlik hata ayıklamaya mal olduğu durumda maliyet avantajının korunup korunmadığını kesin biçimde yanıtlamıyor. Fable 5'in 1M bağlamı ve yüksek zekâ tavanı tam olarak bu senaryo için var: Grok 4.6'nın ucuz adımlarına karşı pahalı ama daha güvenli bir seçenek. Aradaki fark da birçok ekibin iki modeli birden aktif tutmasını gerektirecek kadar büyük.
İlgili okumalar: Grok 4.6 vs GPT-5.6 · Grok 4.6 vs Opus 5 · Claude Sonnet 5 vs Fable 5