 AIREITER
Bir milyon çıktı token'ı başına 5 kat daha fazla ödeme yapmak, GPT-5.6 Sol'ü otomatik olarak daha iyi seçenek yapmıyor. Grok 4.6, Artificial Analysis Intelligence Index'te Sol ile neredeyse aynı seviyeye ulaşıyor: yaklaşık 61'e karşı 58.9. Ancak Sol'ün iki kat geniş bağlam penceresi ve ajan verimliliğindeki güçlü skorları, yalnızca token fiyatına bakarak karar vermeyi zorlaştırıyor.
Intelligence Index'te başa baş görünmek neyi gizliyor?
Artificial Analysis Intelligence Index v4.1; muhakeme, kodlama ve bilgi görevlerini tek bir skorda birleştiriyor. OpenAI, GPT-5.6 Sol için 58.9 puan bildiriyor. Artificial Analysis arena verilerine atıf yapan topluluk paylaşımlarına göre Grok 4.6'nın skoru ise yaklaşık 61. Bu topluluk kaynaklı değer bağımsız olarak doğrulanmış değil; ancak Artificial Analysis'ın Grok 4.6'yı Sol'e denk göstermesiyle yön olarak tutarlı.
Tek bir bileşik puan; bağlam penceresi farklarını, ajan verimliliğini ve benchmark'lar arasındaki değişkenliği görünmez kılıyor. Bunların her biri aşağıda ele alınıyor. OpenAI'ın yayımladığı sonuçlara göre Sol, Terminal-Bench 2.1'de %88.8, DeepSWE v1.1'de ise %72.7 ile ajan ağırlıklı değerlendirmelerde öne çıkıyor. Grok 4.6 için karşılaştırılabilir bağımsız skorlar henüz yayımlanmadı. Intelligence Index genel zekâ açısından iki modeli akran gösterse de ajan benchmark'ları farklı bir tablo çizebilir.
| Özellik | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| Geliştirici | xAI | OpenAI |
| Bağlam penceresi | 500K token (x.ai/api) | ~1,050,000 token (openai.com) |
| API giriş fiyatı (1M başına) | $2.00 (x.ai/api) | $5.00 (openai.com) |
| API çıkış fiyatı (1M başına) | $6.00 (x.ai/api) | $30.00 (openai.com) |
| Intelligence Index v4.1 | ~61 (topluluk bildirimi) | 58.9 (resmî) |
| Bulut erişimi | Azure AI Foundry, Oracle OCI, Google Vertex (x.ai/api) | Azure, AWS Bedrock (openai.com) |
API fiyatları: Girişte 2,5 kat, çıkışta 5 kat fark
xAI'ın API sayfasında Grok 4.6'nın fiyatı milyon giriş token'ı başına $2.00, milyon çıktı token'ı başına ise $6.00 olarak listeleniyor. OpenAI'ın GPT-5.6 sayfasında Sol için karşılık gelen rakamlar $5.00 ve $30.00.
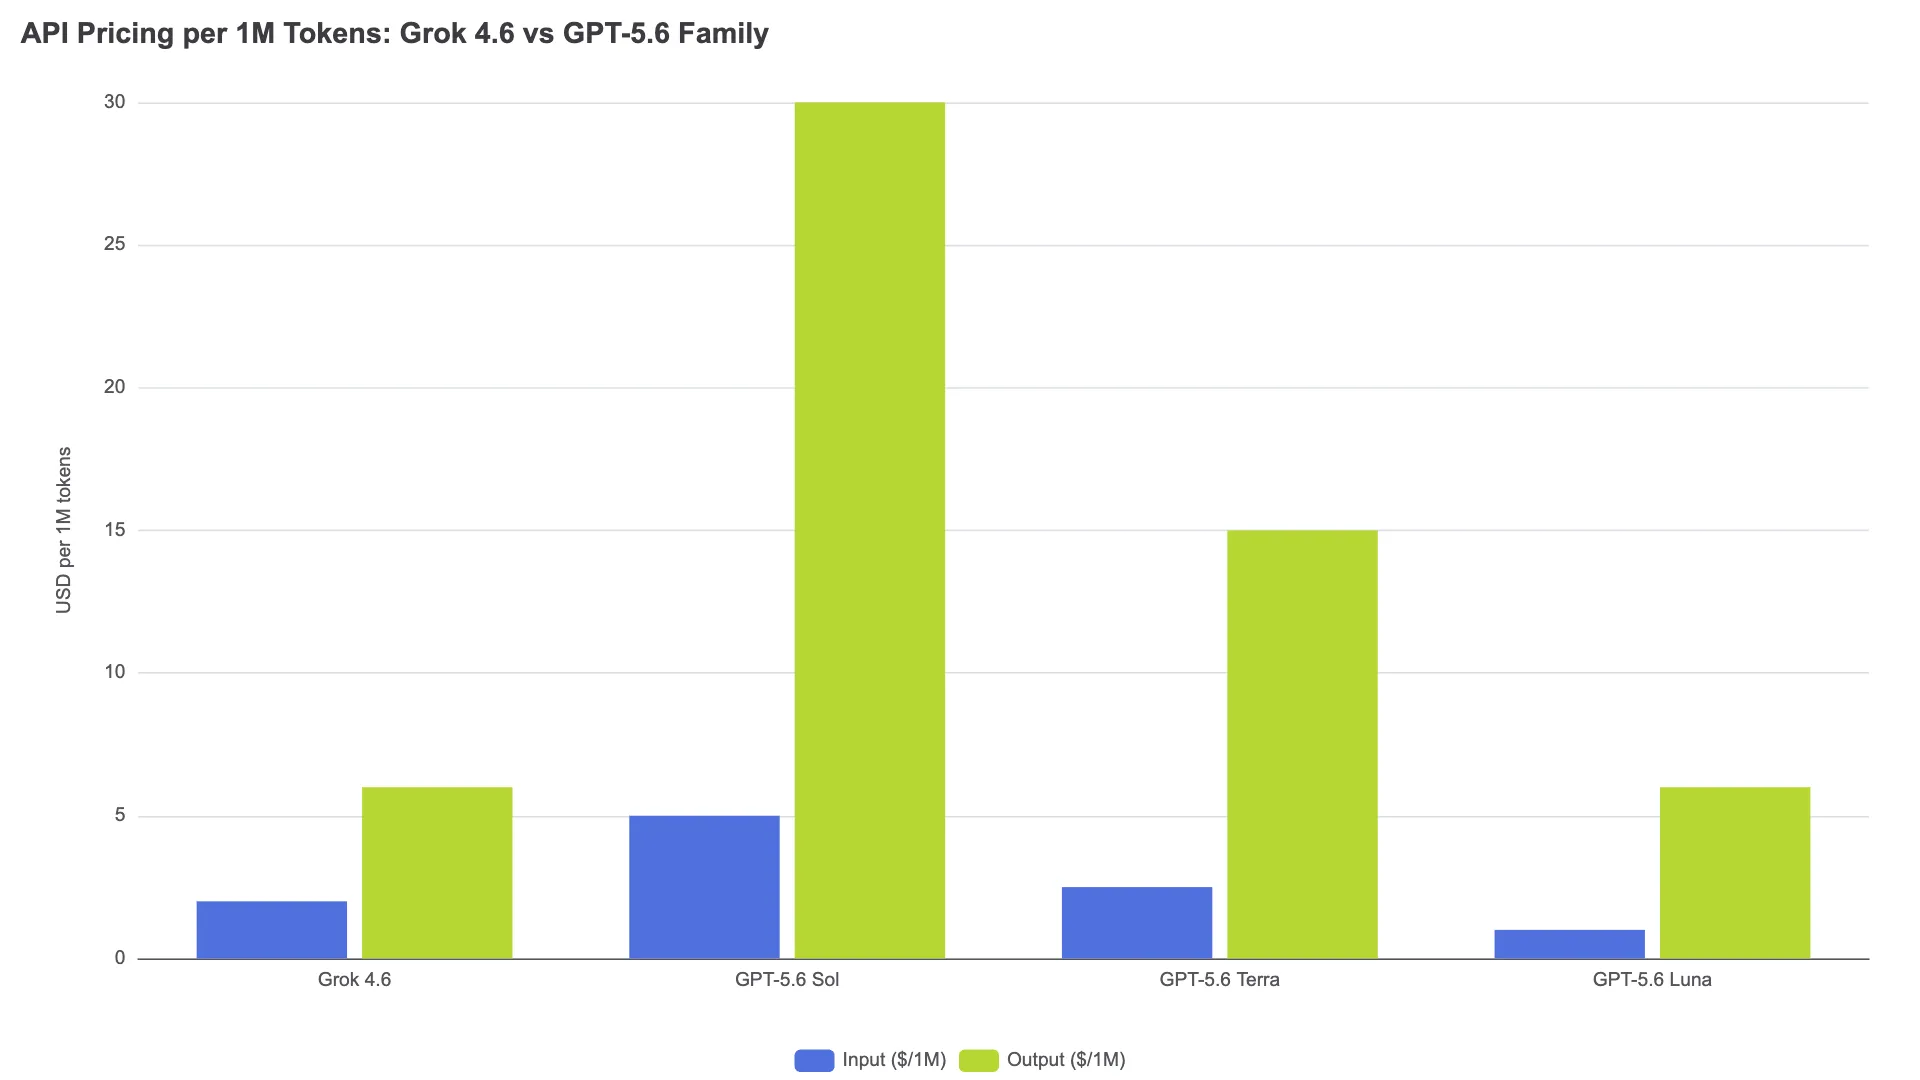
Aylık 50M giriş ve 10M çıktı token'ı tüketen bir iş yükünde Grok 4.6'nın maliyeti $160 oluyor. Sol için bu rakam $550. Sol'ün muhakeme modlarının görev başına daha fazla token harcadığı hesaba katılmadan önce bile fark 3.4 kat.
OpenAI'ın daha uygun fiyatlı katmanları da var: GPT-5.6 Terra $2.50/$15.00, GPT-5.6 Luna ise $1.00/$6.00 seviyesinde (Luna'nın fiyatı 30 Temmuz 2026'da %80 düşürüldü). Luna, çıktı fiyatında Grok 4.6 ile eşit, girişte ise ondan ucuz. Buna karşın daha küçük bir model ve tüm benchmark'larda daha düşük skorlar veriyor. Zekâ eşdeğerliği açısından dürüst karşılaştırma Grok 4.6 ile Sol arasında yapılmalı; bu eşleşmede Grok'un maliyet avantajı kayda değer.
Bağlam penceresi: 500K'ya karşı 1M token
xAI'ın API sayfasına göre Grok 4.6, 500K token'lık bağlam penceresine sahip. OpenAI dokümantasyonu Sol için yaklaşık 1.05 milyon token belirtiyor. 500K token; sıradan bileşen, modül ve çoğu servis düzeyindeki kodlama işi için yeterli. Tek bir prompt içinde tüm monorepo'nun, birden fazla büyük belgenin veya uzun bir konuşma geçmişinin yüklenmesi gereken işlerde Sol'ün 1M penceresi önem kazanıyor. Ajan akışınız tek seferde 800K token kod tabanı bağlamını analiz etmeyi gerektiriyorsa bunu Sol yapabilir, Grok 4.6 yapamaz.
Bir de bilgiyi büyük bağlamdan geri getirme güvenilirliği var. OpenAI, Sol'ün 1M token'da GraphWalks BFS testinden %77.1 aldığını bildiriyor. Grok henüz eşdeğer uzun bağlam geri getirme skorları yayımlamadı. Kullanım senaryonuz "600K token'lık bu kod tabanındaki hatayı bul" ise Sol'ün daha geniş penceresi yalnızca kapasite değil, modelin bu derinlikteki bilgiyi gerçekten bulup bulamayacağı anlamına da geliyor.
Kodlama ve ajan benchmark'larında fark nerede açılıyor?
Intelligence Index'teki yakınlık, kodlamaya özel benchmark'lara aynı ölçüde yansımıyor. Aşağıda GPT-5.6 Sol'ün OpenAI tarafından açıklanan resmî skorları, referans olarak da Fritz.ai'ın bildirdiği Grok 4.5 sonuçları yer alıyor. Grok 4.6'ya özgü kodlama benchmark'ları bağımsız biçimde yayımlanmadığı için Grok sütununu doğrudan bir Grok 4.6 karşılaştırması değil, önceki sürüm referansı olarak değerlendirmek gerekiyor:
| Benchmark | GPT-5.6 Sol (resmî) | Grok 4.5 (referans) | Fark |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.1 | 58.9 | - | Grok 4.6: ~61 (neredeyse berabere) |
| Coding Agent Index v1.1 | 80.0 | - | Grok 4.6 verisi yok |
| Terminal-Bench 2.1 | 88.8% | 83.3% | Sol +5.5 puan |
| DeepSWE v1.1 | 72.7% | 53.0% | Sol +19.7 puan |
| SWE-Bench Pro | 64.6% | 64.7% | Fiilen berabere |
| GPQA Diamond | 94.6% | 93.1% | Sol +1.5 puan |
Sol'ün Terminal-Bench ve DeepSWE'deki farkı en dikkat çekici sonuçlar. Terminal-Bench; paket yükleme, test çalıştırma ve başarısızlıkları ayıklama gibi gerçek terminal görevlerini tamamlama becerisini ölçüyor. DeepSWE ise gerçek GitHub sorunlarında uçtan uca yazılım mühendisliği performansını değerlendiriyor. Sol'ün Grok 4.5 karşısında DeepSWE'de yakaladığı 19.7 puanlık fark, planlama, uygulama ve hatalardan toparlanma gerektiren karmaşık çok adımlı kodlama işlerinde belirgin biçimde daha iyi olabileceğine işaret ediyor. Grok 4.6'nın eğitim sonrası iyileştirmelerinin bu farkı kapatıp kapatmayacağı ise henüz belli değil.
Benchmark sonuçları kesin hüküm değil, yön gösterici olarak görülmeli. Ajan altyapısı, araçlar, prompt'lar ve çalıştırma ortamları sonucu etkiler; bir altyapıda düşük puan alan model, başka birinde daha yüksek performans sergileyebilir.
Token fiyatından çok görev başına maliyet önemli
Fiyat listesine bakıldığında Grok 4.6'nın token başına maliyet avantajı baskın görünüyor. Fakat ajan kullanımında satın alınan şey token değil, tamamlanmış görevdir. Sol bir kodlama görevini 3,000 çıktı token'ıyla bitirirken Grok 4.6 aynı iş için 6,000 token harcıyorsa —daha fazla yeniden deneme, daha uzun muhakeme zincirleri veya daha verimsiz araç kullanımı nedeniyle— maliyet farkı daralır.
Mevcut fiyatlarla yapılan bir duyarlılık analizi, olası aralığı gösteriyor. Sol'ün 10K giriş ve 4K çıktı token'ı kullandığı; Grok 4.6'nın ise 12K giriş ve 8K çıktı token'ına ihtiyaç duyduğu bir kodlama görevini ele alalım. Bu, Sol lehine 2 kat token verimliliği anlamına geliyor:
| Maliyet kalemi | GPT-5.6 Sol | Grok 4.6 |
|---|---|---|
| Giriş maliyeti | $0.05 | $0.024 |
| Çıkış maliyeti | $0.12 | $0.048 |
| Görev başına toplam | $0.17 | $0.072 |
Sol'ün 2 kat verimlilik avantajına sahip olduğu bu senaryoda bile Grok 4.6, görev başına 2.4 kat daha ucuz kalıyor. Artificial Analysis'a atıf yapan Reddit kullanıcıları, Grok 4.6'nın Intelligence Index görevi başına maliyetini yaklaşık $0.86 olarak tahmin etti. Grok'un Sol düzeyindeki token verimliliğinde kendi iş yükünüzde maliyet avantajını koruyup korumayacağı; görevin karmaşıklığına ve ajan altyapısına bağlı.
Asıl risk token ekonomisi değil, görevin tamamlanması. Sol'ün Terminal-Bench ve DeepSWE'deki yüksek skorları, Grok'un tamamen başarısız olabileceği karmaşık ajan görevlerinde başarıya daha sık ulaşabildiğini gösteriyor. Bu tür bir başarısızlık yeniden deneme veya insan müdahalesi gerektirir. Hangi fiyattan olursa olsun, başarısız görev başarılı görevden daha pahalıdır.
Erişim seçenekleri ve ekosistem
Her iki model de tek sağlayıcılı API erişiminin ötesine geçmiş durumda. Aşağıdaki bilgilerde temel kaynak olarak xAI'ın API sayfası ve OpenAI dokümantasyonu kullanıldı:
| Erişim kanalı | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| Azure | AI Foundry (x.ai) | Azure OpenAI (openai.com) |
| AWS | Listelenmemiş | Bedrock (openai.com) |
| Google Cloud | Vertex Model Garden (x.ai) | Listelenmemiş |
| Oracle | OCI Generative AI (x.ai) | Listelenmemiş |
| IDE entegrasyonları | Cursor, Devin | Cursor, Codex |
| SDK uyumluluğu | OpenAI + Anthropic SDK'ları (x.ai) | OpenAI SDK |
| Tüketici sohbeti | SuperGrok ($30/ay), X Premium+ | ChatGPT Plus ($20/ay) (fritz.ai) |
| Tüketici verileriyle eğitim | Varsayılan olarak dahil; çıkış yapmak gerekiyor | API/Business verileri varsayılan olarak hariç |
xAI dokümantasyonuna göre Grok, hem OpenAI hem de Anthropic SDK'larını destekliyor. Bu nedenle geçiş için yalnızca API anahtarını ve endpoint'i değiştirmek yeterli. Hassas veya tescilli kodlarla çalışan ekipler için OpenAI'ın API ve Business verilerini varsayılan olarak eğitimde kullanmama politikası, satın alma sürecinde avantaj sağlıyor. Fritz.ai'ın gizlilik analizine göre Grok tüketicilerinin eğitim kullanımını engellemek için manuel olarak çıkış yapması gerekiyor.
Hangi modeli seçmelisiniz?
| İş yükü | Tercih | Neden |
|---|---|---|
| Yüksek hacimli kodlama ajanları | Grok 4.6 | Ölçekte 2.5-5 kat daha düşük token maliyeti |
| Karmaşık, çok adımlı ajan görevleri | GPT-5.6 Sol (geçici değerlendirme) | Ajan benchmark üstünlükleri Grok 4.6'ya değil, Grok 4.5'e karşı |
| Büyük kod tabanı analizi (>500K token) | GPT-5.6 Sol | 2 kat daha büyük bağlam penceresi |
| Maliyete duyarlı toplu işlemler | Grok 4.6 | Daha düşük token maliyetinde neredeyse eşdeğer zekâ |
| Gerçek zamanlı sosyal ağ/web araştırması | Grok 4.6 | Yerleşik X ve web araması (x.ai) |
| Hassas / tescilli kod | GPT-5.6 Sol | API verileri varsayılan olarak eğitimde kullanılmıyor |
| Kurumsal Azure dağıtımı | Her ikisi de | İkisi de Azure AI Foundry'de mevcut |
Karar vermenin en güvenilir yolu, gerçek görevlerinizden temsil niteliği taşıyan bir örneği iki API'de de çalıştırmak. Başarılı tamamlama oranını, başarılı görev başına medyan maliyeti, yeniden deneme sayısını ve gecikmeyi karşılaştırın.
Sık sorulan sorular
Grok 4.6'yı Sol yerine GPT-5.6 Terra ile mi karşılaştırmalıyım?
Terra ($2.50/$15.00), fiyat bakımından Grok 4.6'ya daha yakın; ancak yayımlanmış tüm benchmark'larda Sol'ün gerisinde: Intelligence Index'te 55.0, Coding Agent Index'te 77.4 ve Terminal-Bench'te %87.4 (OpenAI'a göre). Karşılaştırmayı zekâ düzeyinde yapıyorsanız Grok 4.6 ile Sol adil eşleşme. Fiyat düzeyini temel alıyorsanız Grok 4.6 ile Terra karşılaştırmasında Grok hem maliyet hem benchmark skorlarında avantajlı. Luna ($1.00/$6.00) ise ikisinden de ucuz, ancak kalite tarafında önemli tavizler veriyor.
Grok 4.6'nın teknik özellikleri ve yetenekleri için Grok 4.6 rehberimize göz atabilirsiniz. GPT-5.6'yı daha eski bir Grok sürümüyle karşılaştırıyorsanız GPT-5.6 Sol ve Grok 4.5 analizimizde önceki sürümlerin eşleşmesini ele alıyoruz.