 AIREITER
Grok 4.6, 12 Ağustos 2026'da yayınlandı. Elon Musk'ın “iki hafta” ifadesinin işaret ettiği tarihten beş gün sonra gelen modelin liste fiyatı ilk bakışta değişmemiş görünüyor: milyon token başına 2,00 $ girdi, 6,00 $ çıktı ve 500K bağlam penceresi; yani Grok 4.5 ile aynı şartlar. Fakat faturada durum farklı. Önbelleğe alınmış girdi, 4.5'e kıyasla %67 daha pahalı. Bağımsız ölçümler de modelin aynı işi tamamlamak için daha fazla token ürettiğini gösteriyor.
12 Ağustos'ta neler geldi?
Model kimliği grok-4.6. SpaceXAI'nin sürüm notlarına göre API erişimi 12 Ağustos 2026'da açıldı. Belgelerdeki teknik çerçeve şöyle:
| Özellik | Grok 4.6 |
|---|---|
| Model kimliği | grok-4.6 |
| Bağlam | 500K token |
| Girdi | Metin ve görsel |
| Çıktı | Yalnızca metin, belirtilmiş bir çıktı sınırı yok |
| Muhakeme seviyesi | low, medium, high (varsayılan), xhigh |
| Bilgi kesim tarihi | 1 Şubat 2026 |
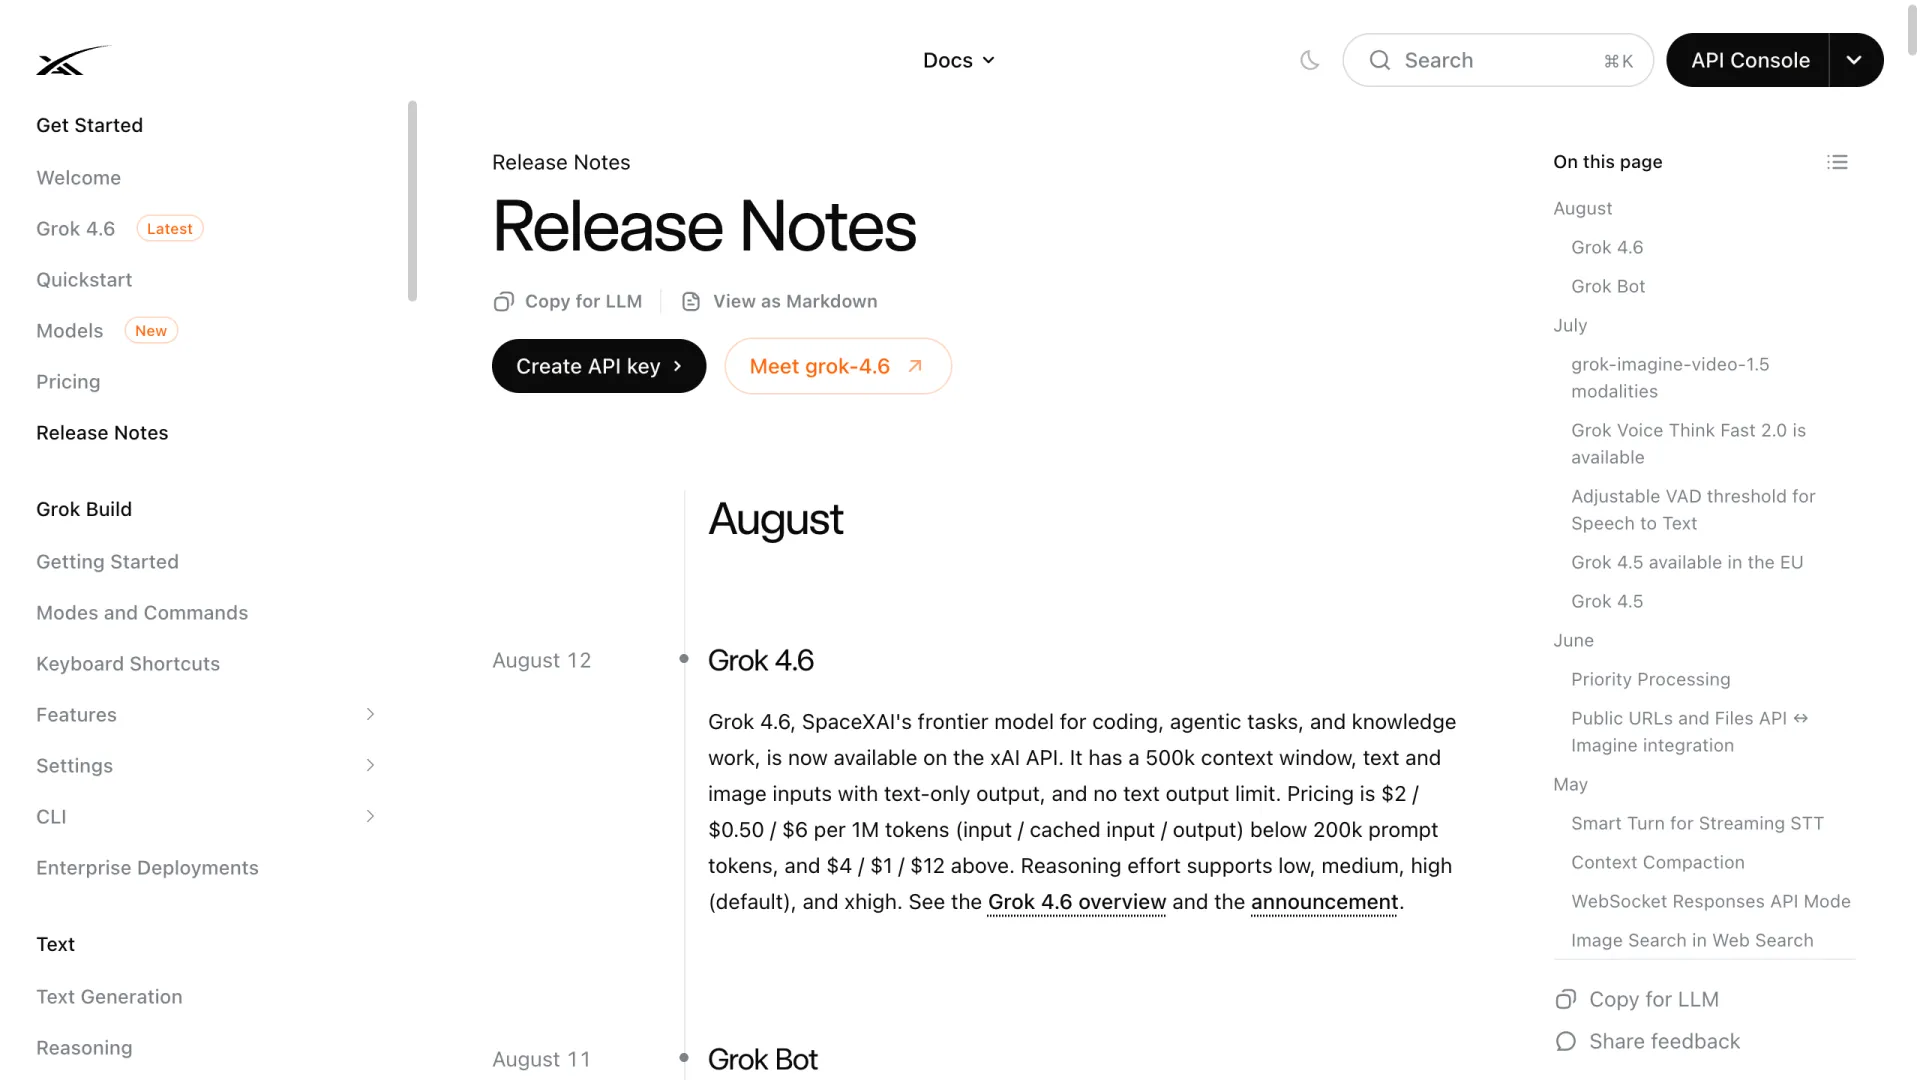
Bu tablodaki iki satır yeni. xhigh, Grok 4.5'te bulunmayan dördüncü muhakeme seviyesi; 4.5, high seviyesinde sona eriyordu. Belgelerde artık 1 Şubat 2026 bilgi kesim tarihi de yer alıyor. Modelin güncel bilgi kör noktasını dikkate alarak tarihli soruları yönlendiriyorsanız, bu ayrıntı önemli.
Model kataloğu, Grok 4.6'yı kodlama ve sohbet için amiral gemisi model olarak gösteriyor. Kenar çubuğunda Latest etiketi bulunan sayfa 12 Ağustos 2026 tarihini taşıyor. Grok 4.5 ise emekliye ayrılmış değil; kendi fiyatlarıyla fiyatlandırma sayfasında yer almaya devam ediyor.
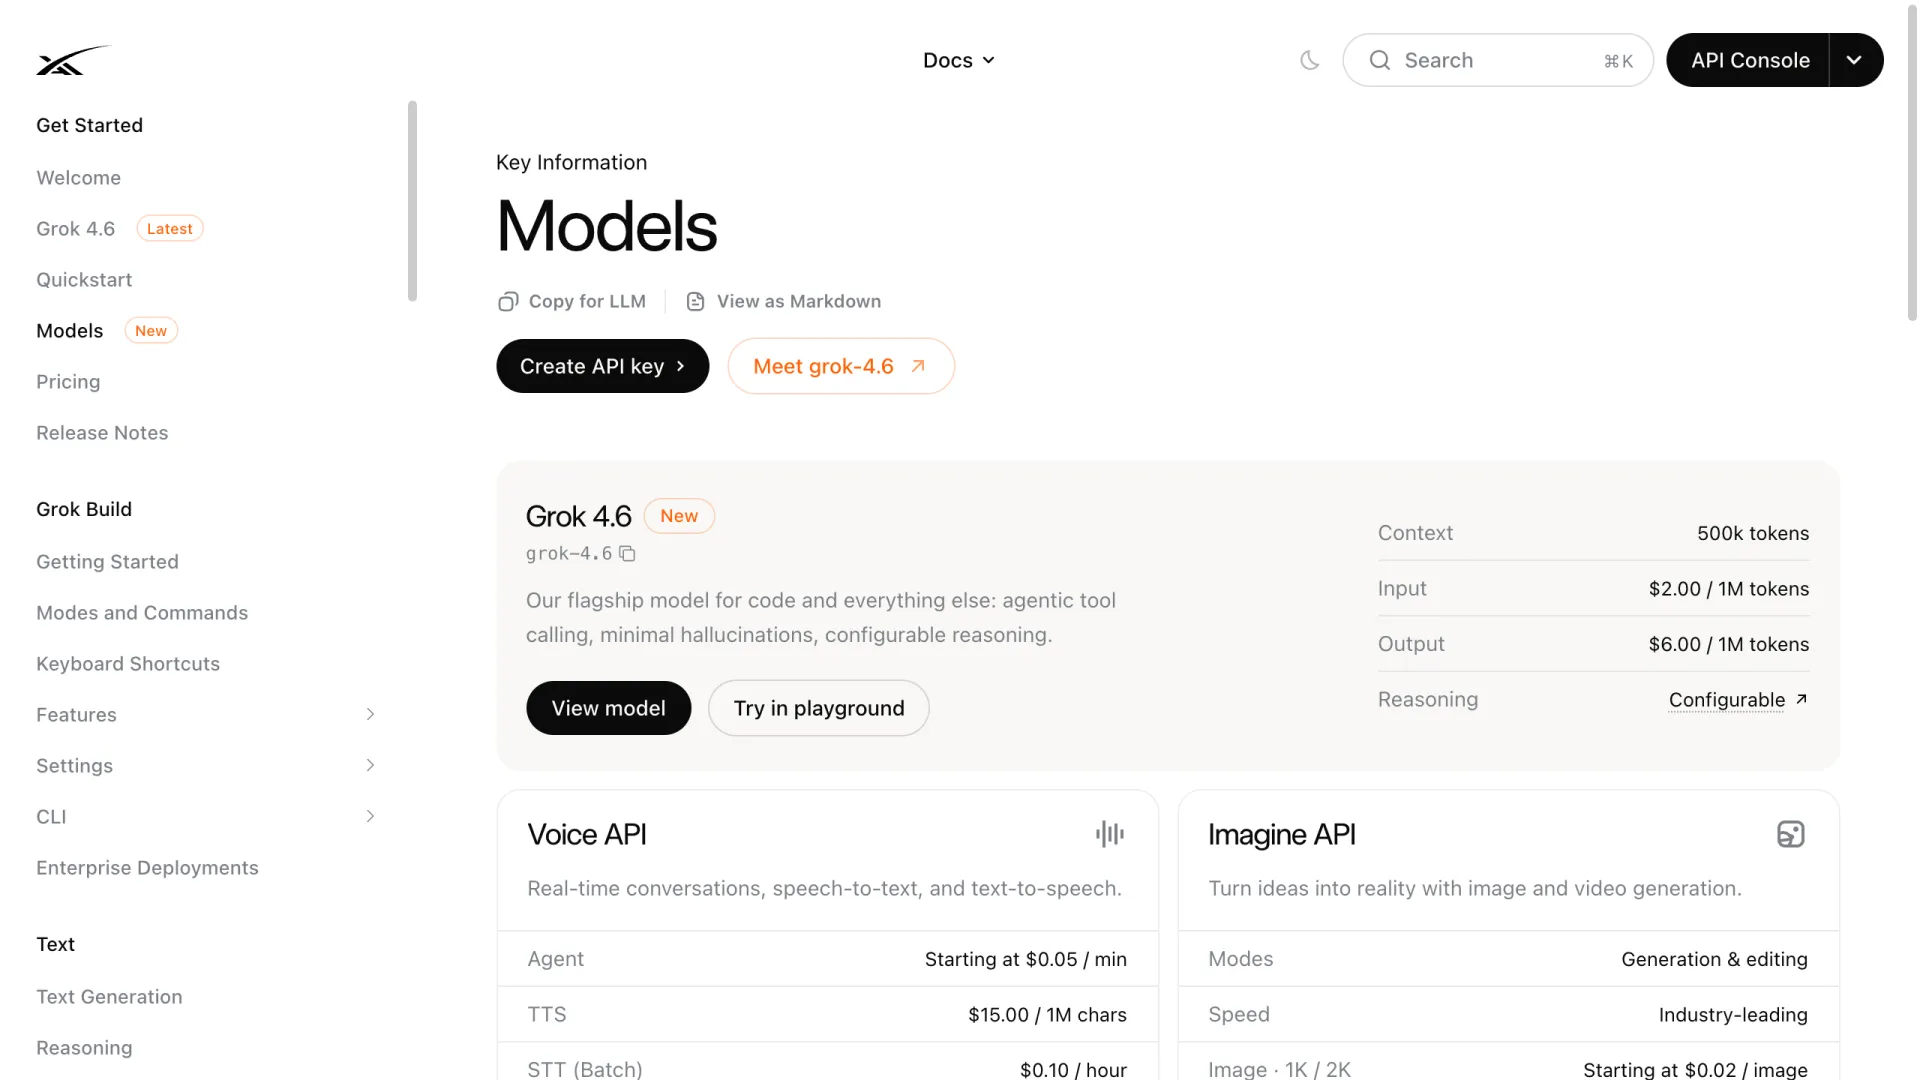
Dağıtım ilk günden genişti. SpaceXAI'nin duyurusunda Cursor ve Grok Build yer alıyor; ilk hafta her ikisinde de dahil kullanım miktarı 2 katına çıkarılmış. API'nin yanında OpenRouter, Vercel ve Cloudflare gibi ortaklar da listeleniyor. Duyuruda iki kat fiyatlı hızlı bir varyanttan da bahsediliyor. Ancak bu varyantın herkese açık fiyatlandırma sayfasında henüz bir satırı yok; dolayısıyla 2 kat bilgisi yayınlanmış bir tarife değil, duyurudaki ifade olarak ele alınmalı.
Grok 4.6 fiyatlandırması: Liste aynı, önbellek daha pahalı
Girdi ve çıktı birim ücretleri Grok 4.5'ten aynen devralınmış. Değişen kalem, önbelleğe alınmış girdi fiyatı.
| 1 milyon token başına ücret | Grok 4.5 | Grok 4.6 |
|---|---|---|
| Girdi (200K altı) | $2.00 | $2.00 |
| Önbelleğe alınmış girdi (200K altı) | $0.30 | $0.50 |
| Çıktı (200K altı) | $6.00 | $6.00 |
| Girdi / önbellek / çıktı (200K+) | $4.00 / $0.60 / $12.00 | $4.00 / $1.00 / $12.00 |
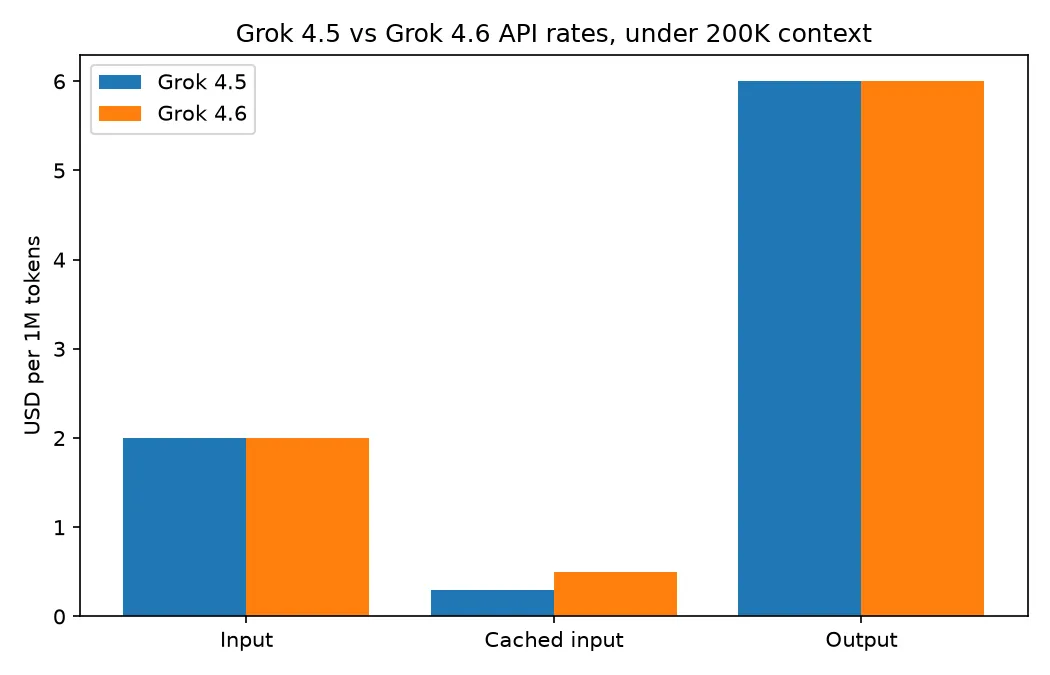
Önbelleğe alınmış girdideki indirim oranı %85'ten %75'e düştü. Bu, milyon token başına 20 sentlik artış demek ve görev sayısından çok ajan adımıyla büyüyen maliyet kalemini etkiliyor. Günde 50M önbelleğe alınmış tokeni yeniden oynatan bir test altyapısı, 4.5'te 9,00 $ yerine 4.6'da 15,00 $ öder.
Uzun bağlam kuralı değişmedi ve hâlâ kolayca gözden kaçıyor. Bir isteğin prompt'u 200K tokena ulaştığında, o istekteki tüm tokenlar yüksek kademeden ücretleniyor. Örneğin 210K tokenlık bir çağrı, iki kademenin harmanlanmış fiyatıyla değil, isteğin tamamında milyon girdi tokenı başına 4,00 $ üzerinden hesaplanır. OpenRouter'ın herkese açık model listesi de aynı ücretleri ve aynı 200K sınırını bildiriyor; üçüncü taraf üzerinden yönlendirmek hesabı değiştirmiyor.
Resmî değerlendirmelerde Grok 4.6'nın güçlü ve zayıf yanları
SpaceXAI, Grok 4.5, GPT-5.6 Sol Max ve Fable 5 Max'e karşı on satırlık bir karşılaştırma yayınladı. Grok 4.6 bunların üçünde en yüksek puanı aldı: GDPVal-AA v2 (1753), AA-Briefcase (1577) ve Harvey LAB (15.8%). Kalan yedisinde lider değil. Yönlendirme kararını ilgilendiren sekiz satır aşağıda:
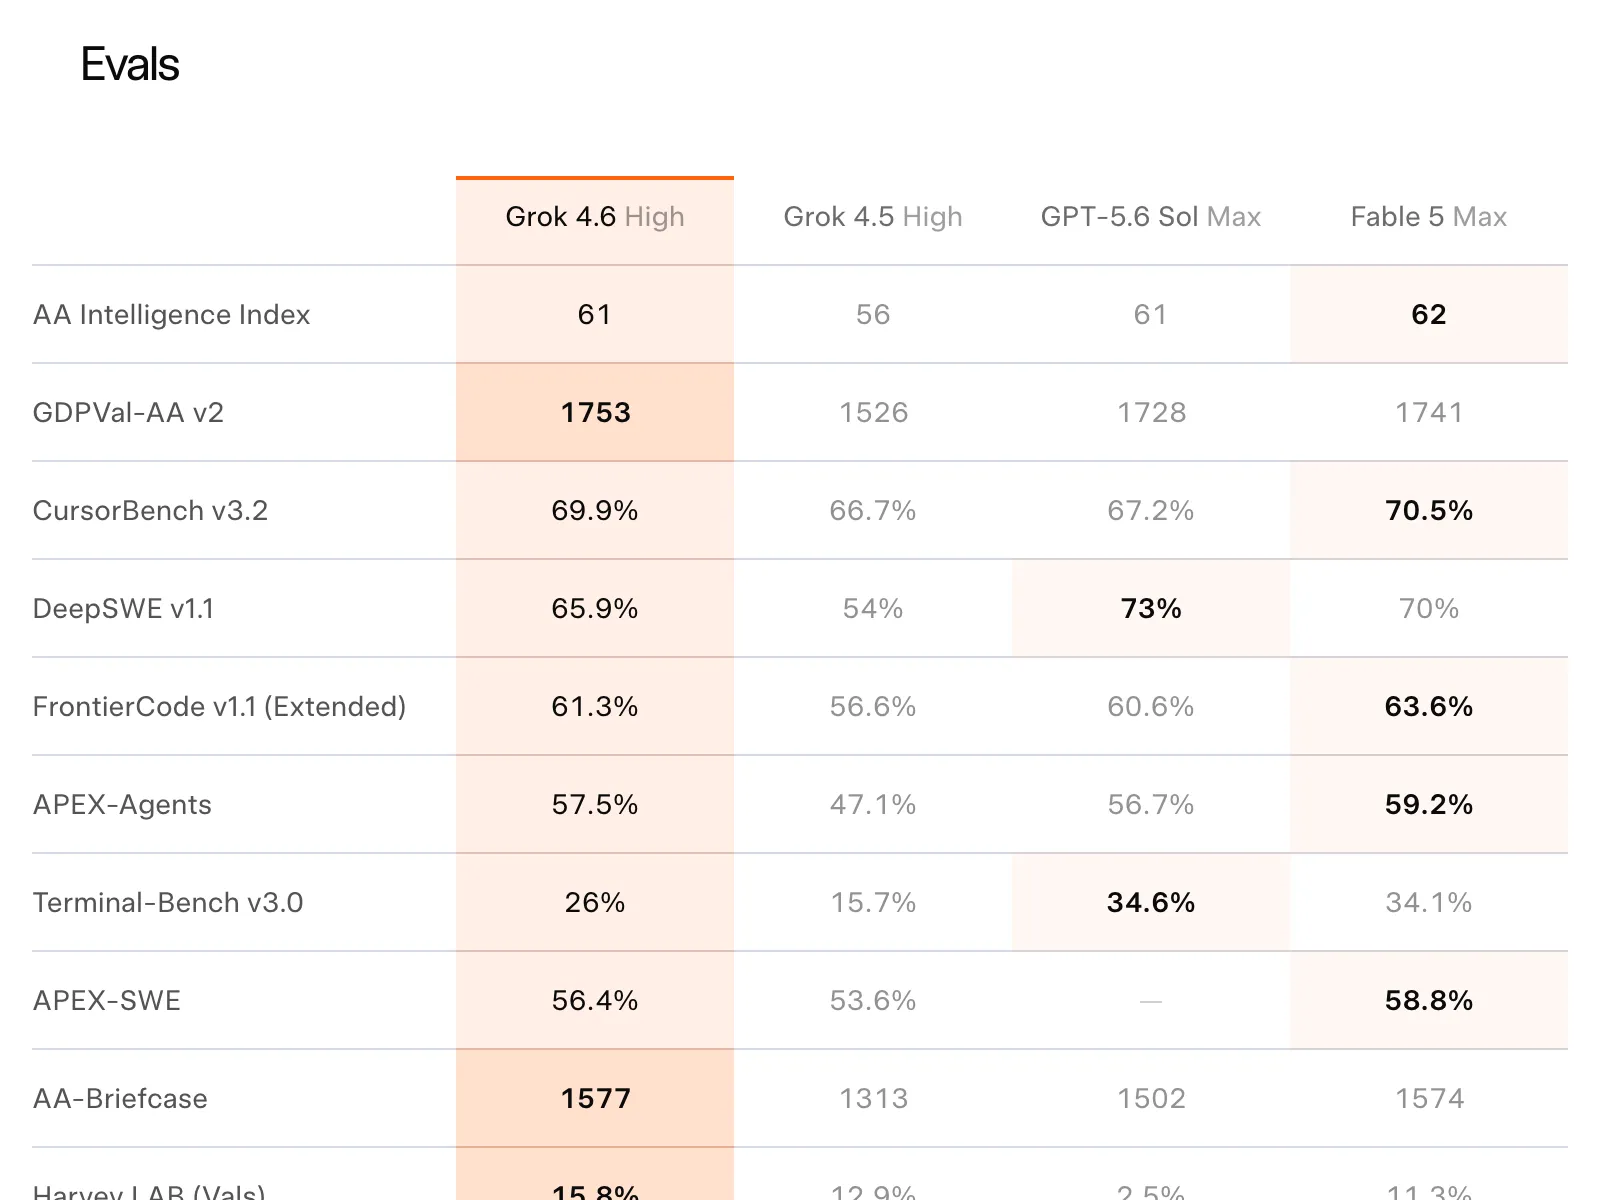
| Değerlendirme | Grok 4.6 | Grok 4.5 | GPT-5.6 Sol | Fable 5 |
|---|---|---|---|---|
| AA Intelligence Index | 61 | 56 | 61 | 62 |
| GDPVal-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 66.7% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 54% | 73% | 70% |
| FrontierCode v1.1 | 61.3% | 56.6% | 60.6% | 63.6% |
| APEX-Agents | 57.5% | 47.1% | 56.7% | 59.2% |
| Terminal-Bench v3.0 | 26% | 15.7% | 34.6% | 34.1% |
| AA-Briefcase | 1577 | 1313 | 1502 | 1574 |
Terminal-Bench farkı özellikle dikkat çekici. GPT-5.6 Sol'un 34.6%, Fable 5'in ise 34.1% aldığı testte Grok 4.6 26%'da kalıyor. Kabuk yöneten bir ajana en çok benzeyen değerlendirmede, sekiz puan farkla üçüncü sırada. DeepSWE de farklı rakamlarla aynı tabloyu çiziyor: Sol'un 73%'üne karşı 65.9%. İş yükünüz terminal odaklı ajanlardan oluşuyorsa, üreticinin kendi tablosu bu modelin lider olmadığını söylüyor.
Yine de Grok 4.5'e göre ilerleme gerçek ve tutarlı. Tüm satırlarda iyileşme var; APEX-Agents'ta 47.1%'den 57.5%'e, Terminal-Bench'te ise 15.7%'den 26%'ya çıkış on puanı aşıyor. SpaceXAI bunu daha uzun bir ek eğitim sürecine, yeniden üretilmiş SFT rotalarına ve kodlama ile bilgi çalışması ortamlarındaki ajan odaklı RL'e bağlıyor. Duyurunun söylemediği bir ayrıntı var: parametre sayısı. Bu modele bağlanan 2 trilyon rakamı sürüm duyurusundan değil, Musk'tan geliyor.
Ölçülen bedel: Daha yüksek zekâ, daha yüksek maliyet
Üretici tabloları skorları verir, fakat o skorların neye mal olduğunu söylemez. Artificial Analysis her ikisini de yayınlıyor. 13 Ağustos tarihli ölçüm, Grok 4.6'nın asıl ödünleşimini ortaya koyuyor.
| Aynı endekste ölçülen değerler | Grok 4.5 (high) | Grok 4.6 (high) |
|---|---|---|
| Intelligence Index | 56 (#16 of 184) | 61 (#6 of 184) |
| Çıktı hızı | 56.9 token/s (#102) | 67.6 token/s (#74) |
| Üretilen çıktı tokenları | 60M | 72M |
| Tam değerlendirmenin maliyeti | $579.21 | $1,068.47 |
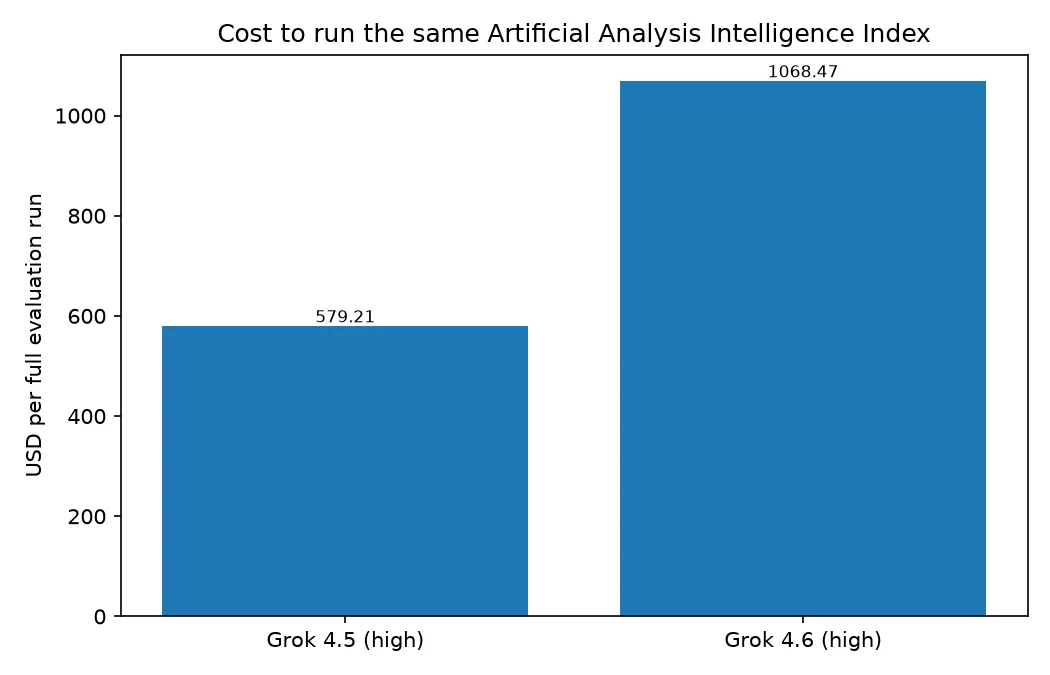
Beş puanlık zekâ artışı 1.8 kat maliyet getirmiş. Liste fiyatları aynı olsa da, aynı benchmark paketi 489 $ daha pahalıya çalışmış. Bunun bir nedeni daha uzun çıktılar: 60M yerine 72M çıktı tokenı. Diğer neden ise yukarıdaki önbellek fiyat artışı. Artificial Analysis çalıştırmanın kalem kalem maliyet dağılımını yayınlamıyor; bu nedenle 1.8 kat, yeniden hesaplanabilecek bir formül değil, gözlemlenmiş toplam sonuç.
Hız tarafında iyileşme sizin lehinize: 4.5'teki 56.9'a karşı saniyede 67.6 çıktı tokenı. Bu da modeli kendi sınıfındaki 184 model arasında alt yarıdan yaklaşık medyan seviyesine taşıyor.
Musk'ın söyledikleri ve yayınlanan model arasındaki fark
Modelin adı kayıtlara üç kelimelik bir yanıtla geçti. Musk, 18 Temmuz'da @minchoi'ye yanıt olarak şunu yazdı: “Her açıdan 1.5T modelimizden daha iyi olan 2T modelimizin ilk eğitimi gelecek hafta tamamlanacak. Kimi'yi geçebilir; hız ve token verimliliği ise 1.5T modelimize, yani Grok 4.5'e yakın olabilir.” Andrew Curran bunun Grok 4.6 olup olmadığını sorduğunda yanıtı şuydu: “Yeah, Grok 4.6.”
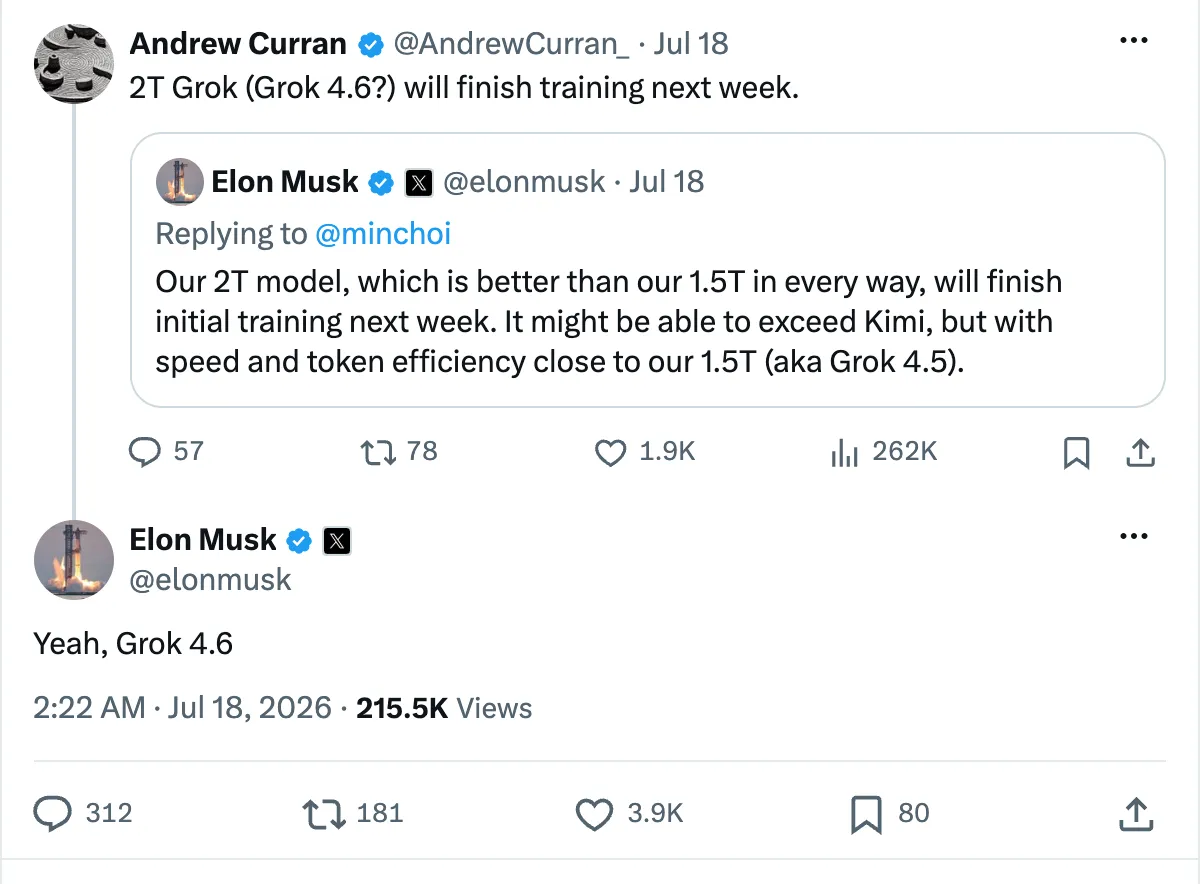
24 Temmuz'da ise takvim geldi: “Grok 4.6 2 hafta içinde, Grok 4.7 ise 4 hafta içinde.” Bu tarihten iki hafta sonrası yaklaşık 7 Ağustos'a denk geliyor; model beş gün gecikmeyle 12 Ağustos'ta yayınlandı.
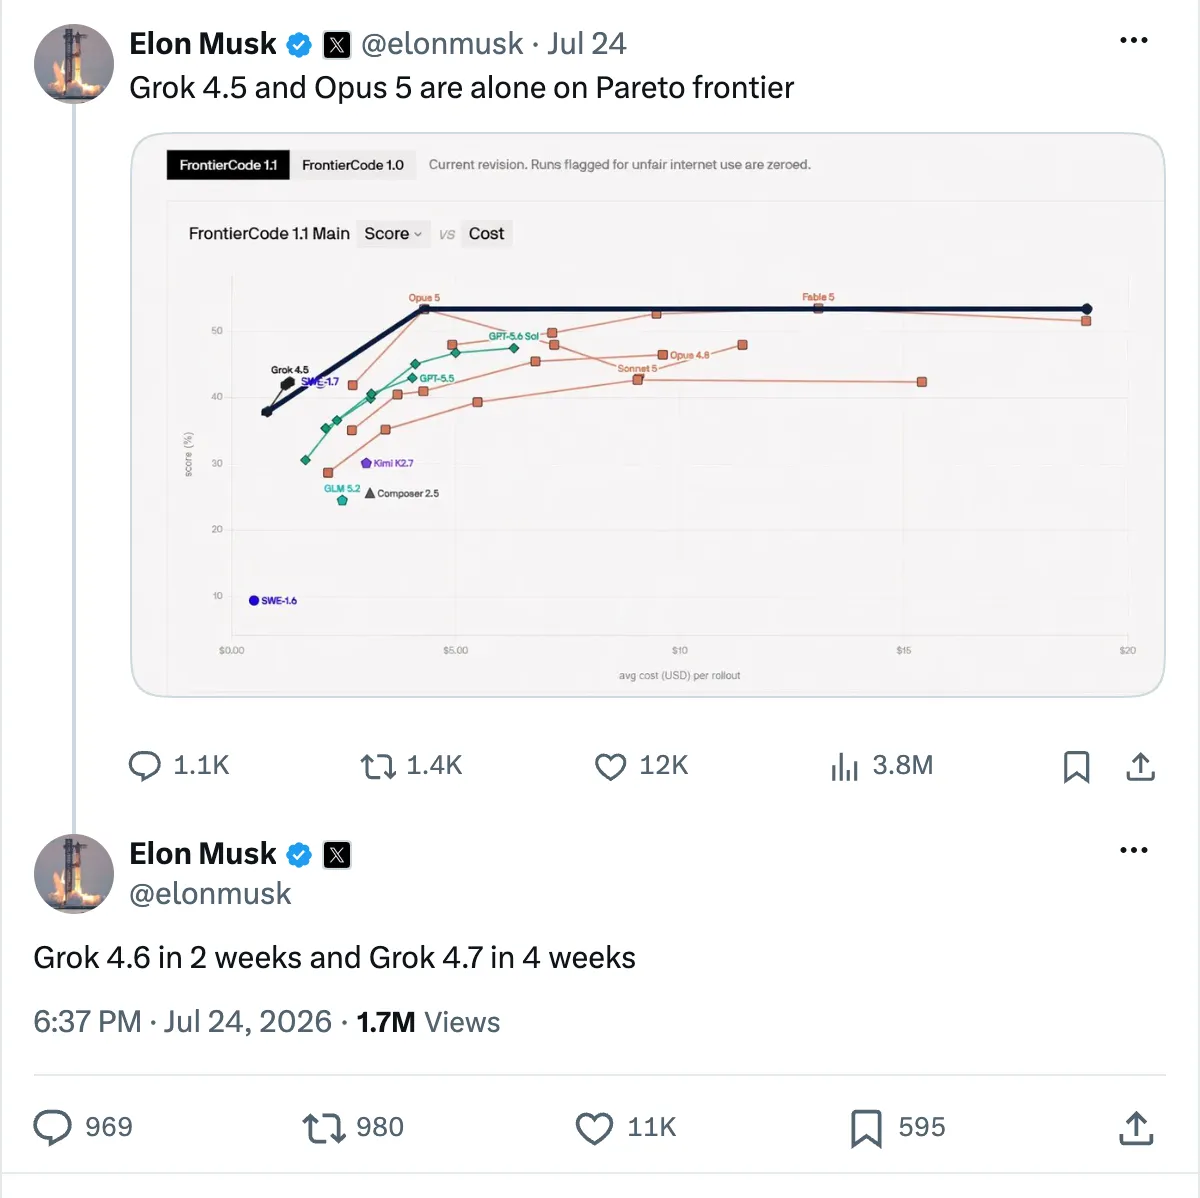
Bu paylaşımlardaki üç iddia, sürümle birlikte olduğu gibi doğrulanmadı:
- 2 trilyon parametre hâlâ teyitsiz. SpaceXAI'nin duyurusu, model belgeleri ve sürüm notlarında Grok 4.6 için parametre sayısı verilmiyor.
- “Grok 4.5'e yakın token verimliliği” iddiası Artificial Analysis ölçümüyle çelişiyor: aynı değerlendirmede 60M yerine 72M çıktı tokenı üretildi.
- “Kimi'yi geçebilir” iddiası da henüz sınanmış değil. SpaceXAI'nin tablosunda Moonshot'ın K3 modeli yok; yalnızca GPT-5.6 Sol ve Fable 5 ile karşılaştırma yapılıyor.
Grok 4.5'ten Grok 4.6'ya geçmeli misiniz?
Grok 4.5'ten geliyorsanız, ajan odaklı ve bilgi çalışması yükleri için evet; ancak token faturasını geçiş anında değil, bir haftalık kullanımın sonunda değerlendirin. Grok 4.5 eski fiyatlarıyla kullanılabilir durumda kaldığından, geçiş geri alınabilir. Varsayım yapmak yerine ölçmek daha doğru yaklaşım.
Uzun ufuklu ajanlar veya bilgi görevleri çalıştırıyorsanız şimdi geçin: APEX-Agents'ta 10.4 puan, GDPVal-AA'da 227 puan artış var; daha yüksek üretim hızı da çok adımlı çalışmalarda bu avantajı büyütüyor. Trafiğiniz yoğun biçimde önbellek kullanıyor ve fiyat hassasiyetiniz yüksekse 4.5'te kalın. Önbellek okuma ücretindeki %67 artış gerçek bir gerileme; ayrıca 4.6 çıktığında 4.5'in skorları düşmedi. Terminal ajanları içinse başka modellere bakın: SpaceXAI'nin kendi tablosu, Grok 4.6'yı GPT-5.6 Sol ve Fable 5'in sekiz puan gerisinde gösteriyor.
Üretim trafiğini yeni modele yönlendirmeden önce şu üç noktayı kontrol edin:
- Her iki kimliğin de takma ad olduğunu unutmayın. SpaceXAI'nin takma ad kuralları,
grok-4.6kimliğini en güncel kararlı sürüme,grok-4.6-latestkimliğini ise en yeni sürüme yönlendiriyor. Yalnızca tarih içeren<modelname>-<date>kimliği sabitlenmiş sayılıyor; ancak ne model kataloğu ne de OpenRouter tarihli bir 4.6 varyantı listeliyor. Bugün tekrarlanabilir iş akışları için sabitlenebilir bir sürüm yok. - Muhakeme seviyenizi yeniden test edin. Yeni
xhighseviyesi ücretsiz bir yükseltme değil. Zaten öncülünden daha uzun çıktı verdiği ölçülen modelde daha fazla token harcıyor. 4.5 ile bire bir karşılaştırma için varsayılanhighseviyesi kullanılmalı. - Sağlayıcınızın modeli sunduğunu doğrulayın. SpaceXAI'de ilk gün erişim, her yerde ilk gün erişim anlamına gelmiyor. 13 Ağustos'ta
/v1/modelssorgusunda resmî API ile OpenRouter ikisi degrok-4.6döndürdü. Test ettiğim OpenAI uyumlu bir yeniden satıcı uç noktası ise hâlâgrok-4.5ile sınırlıydı ve yeni kimliğimodel_not_foundhatasıyla reddetti. Trafiği yönlendirmeden önce kendi anahtarınızla tam model kimliğinin yanıt verdiğini doğrulayın.
Sık sorulan sorular
Grok 4.6 API ne kadar tutuyor?
200K bağlamın altında milyon girdi tokenı başına 2,00 $, milyon çıktı tokenı başına 6,00 $; önbelleğe alınmış girdi için ise 0,50 $. Prompt 200K tokenı aştığında isteğin tamamı 4,00 $ girdi, 1,00 $ önbellek ve 12,00 $ çıktı tarifesinden ücretleniyor. Duyuruda iki kat fiyatlı hızlı bir varyant anılıyor, ancak bu model herkese açık fiyatlandırma sayfasında yer almıyor.
Grok 4.6, Grok 4.5'ten daha mı iyi?
SpaceXAI'nin yayınladığı her benchmark'ta evet. AA Intelligence Index'te 56'ya karşı 61 alıyor; en büyük artışlar da ajan odaklı değerlendirmelerde görülüyor. Bağımsız ölçüm ise önemli bir not ekliyor: aynı değerlendirmede Grok 4.5'in 60M tokenına karşı 72M çıktı tokenı ürettiği için, aynı görev daha pahalıya geliyor.
Grok 4.6 kaç parametreye sahip?
Açıklanmadı. Musk, 18 Temmuz 2026'da 2 trilyon parametreli bir modelden söz etti ve adının Grok 4.6 olduğunu doğruladı. Ancak SpaceXAI'nin sürüm materyalleri parametre sayısını, mimari ayrıntıları veya token başına kaç parametrenin etkinleştiğini açıklamıyor.
Grok 4.6'nın bağlam penceresi ve bilgi kesim tarihi nedir?
Bağlam penceresi 500K token. Model metin ve görsel girdi kabul ediyor, yalnızca metin çıktısı veriyor. Belgelerde bilgi kesim tarihi 1 Şubat 2026 olarak belirtiliyor. Sunucu tarafında Web Search veya X Search etkin değilse modelin bu tarihten sonraki olaylara erişimi yok.
Grok'u xAI mi, SpaceXAI mi geliştiriyor?
İki isim de aynı şirketi ifade ediyor. Geliştirici belgelerinin başlığı “SpaceXAI Docs”, duyuru alt bilgisinde ise 2026'daki SpaceX geçişinin ardından hâlâ X.AI LLC yazıyor. x.ai alan adları ve grok-* model kimlikleri yeniden adlandırılmadı.
Grok 4.7 ne zaman çıkacak?
Henüz açıklanmış bir tarih yok. Musk'ın 24 Temmuz paylaşımı Grok 4.7 için yaklaşık dört hafta sonrasını, yani 21 Ağustos 2026 civarını işaret ediyordu. Grok 4.6 ise kendi işaret edilen tarihinden beş gün sonra yayınlandı.
İlgili okumalar
- Grok 4.5: şu ana kadar bildiklerimiz
- GPT-5.6 Sol ve Terra ile Grok 4.5 karşılaştırması
- Claude Opus 5: doğrulananlar
Fiyatlandırma, model kimlikleri ve benchmark rakamları; 13 Ağustos 2026'da SpaceXAI dokümantasyonu, Grok 4.6 duyurusu ve Artificial Analysis üzerinden doğrulandı.