 AIREITER
Bir kodlama ajanının maliyeti, bağlamı bir fiyatlandırma eşiğini geçtiğinde veya akıl yürütme bütçesi çıktı sınırını tükettiğinde beklenenden çok daha hızlı artabilir. Bu Grok 4.6 ve Opus 5 karşılaştırmasında karar net: Prompt başına 200K tokenın altında kalan ve maliyet hassasiyeti taşıyan işler için Grok 4.6; 1M tokenlık pencereye, 128K çıktıya ya da belgelenmiş Claude ajan kontrollerine gerçekten ihtiyaç duyulan senaryolar için Claude Opus 5 tercih edilmeli.
Önce iş yükünüzün sınırlarını belirleyin
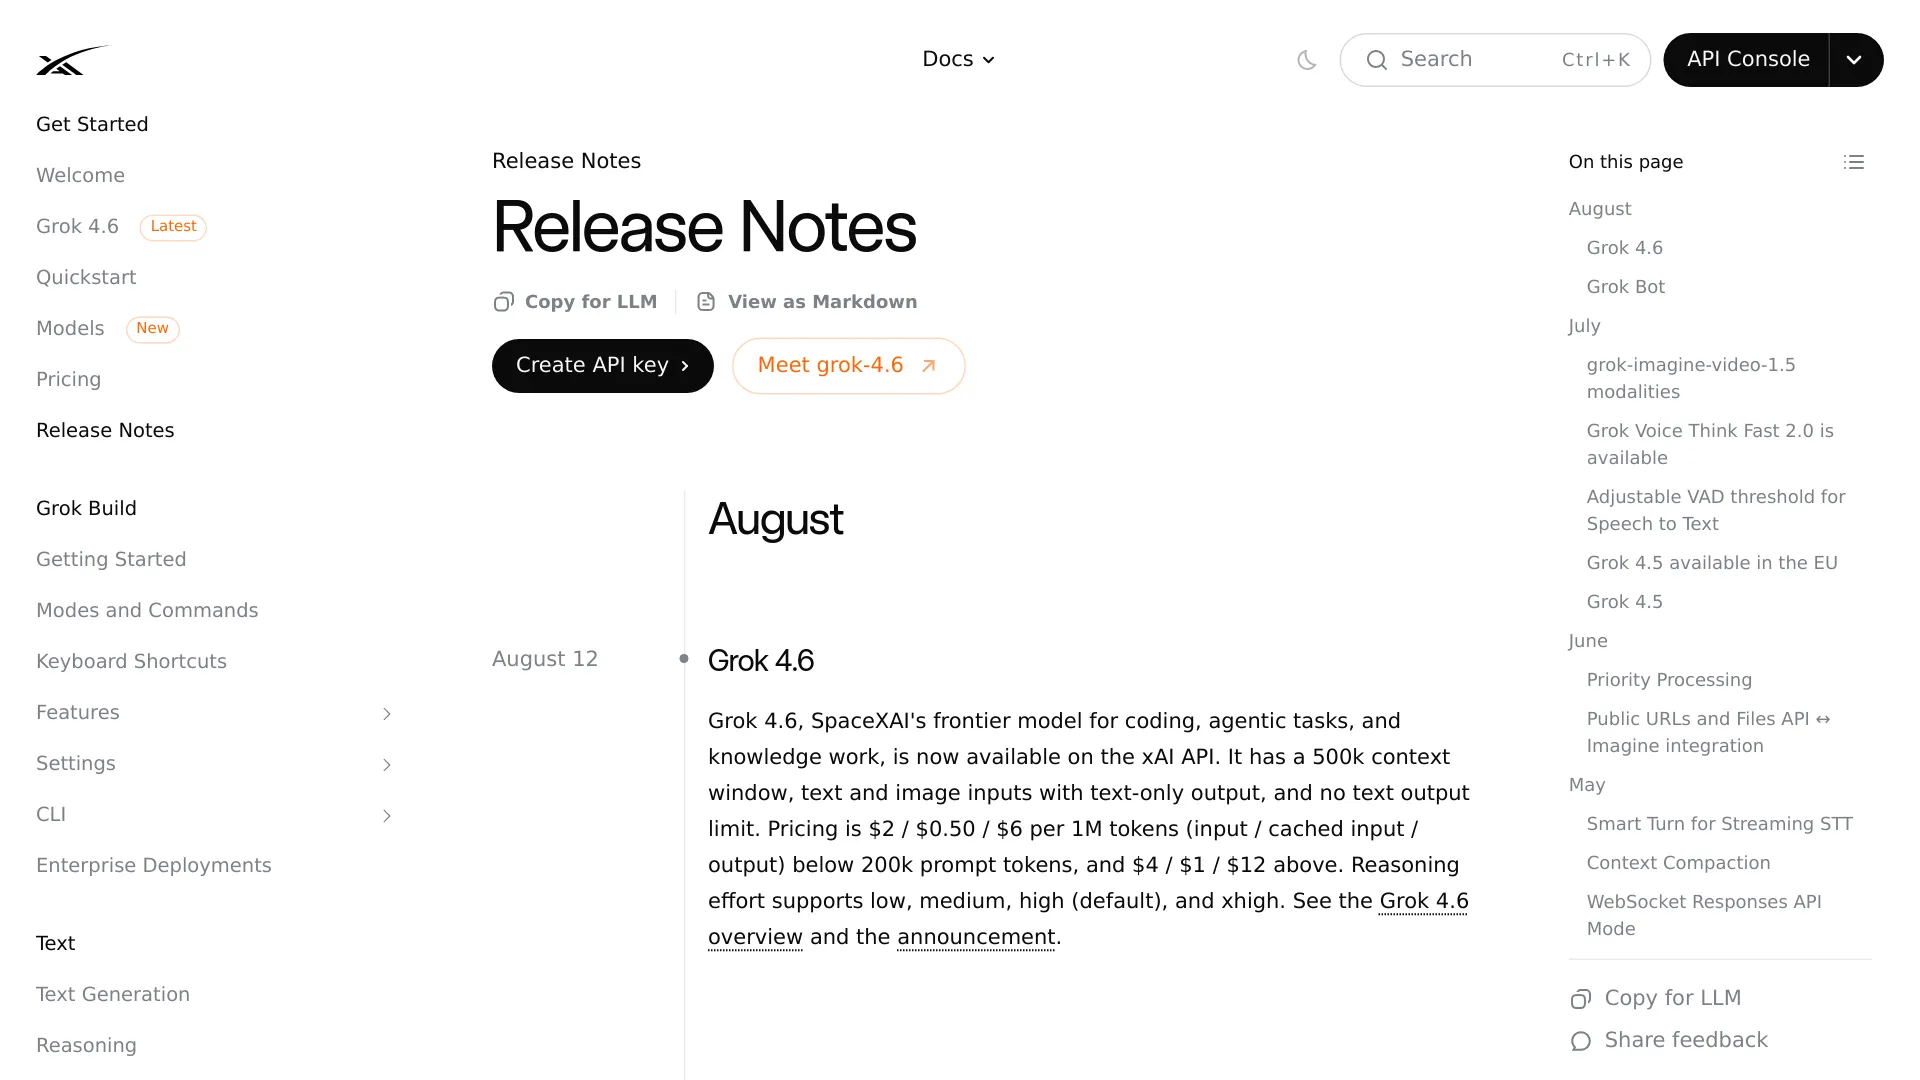
Metin üreten bir kodlama veya bilgi-işi ajanı, xAI’ın 200K prompt token fiyatlandırma eşiğinin altında kalıyorsa Grok 4.6 pratik varsayılan tercih haline geliyor. xAI, 12 Ağustos 2026 tarihli sürüm notlarında 500K bağlam penceresi, metin ve görsel girişi, metin çıktısı ve low’dan xhigh’a uzanan dört efor seviyesi listeliyor. Ana teknik referans, xAI geliştirici sürüm notları.
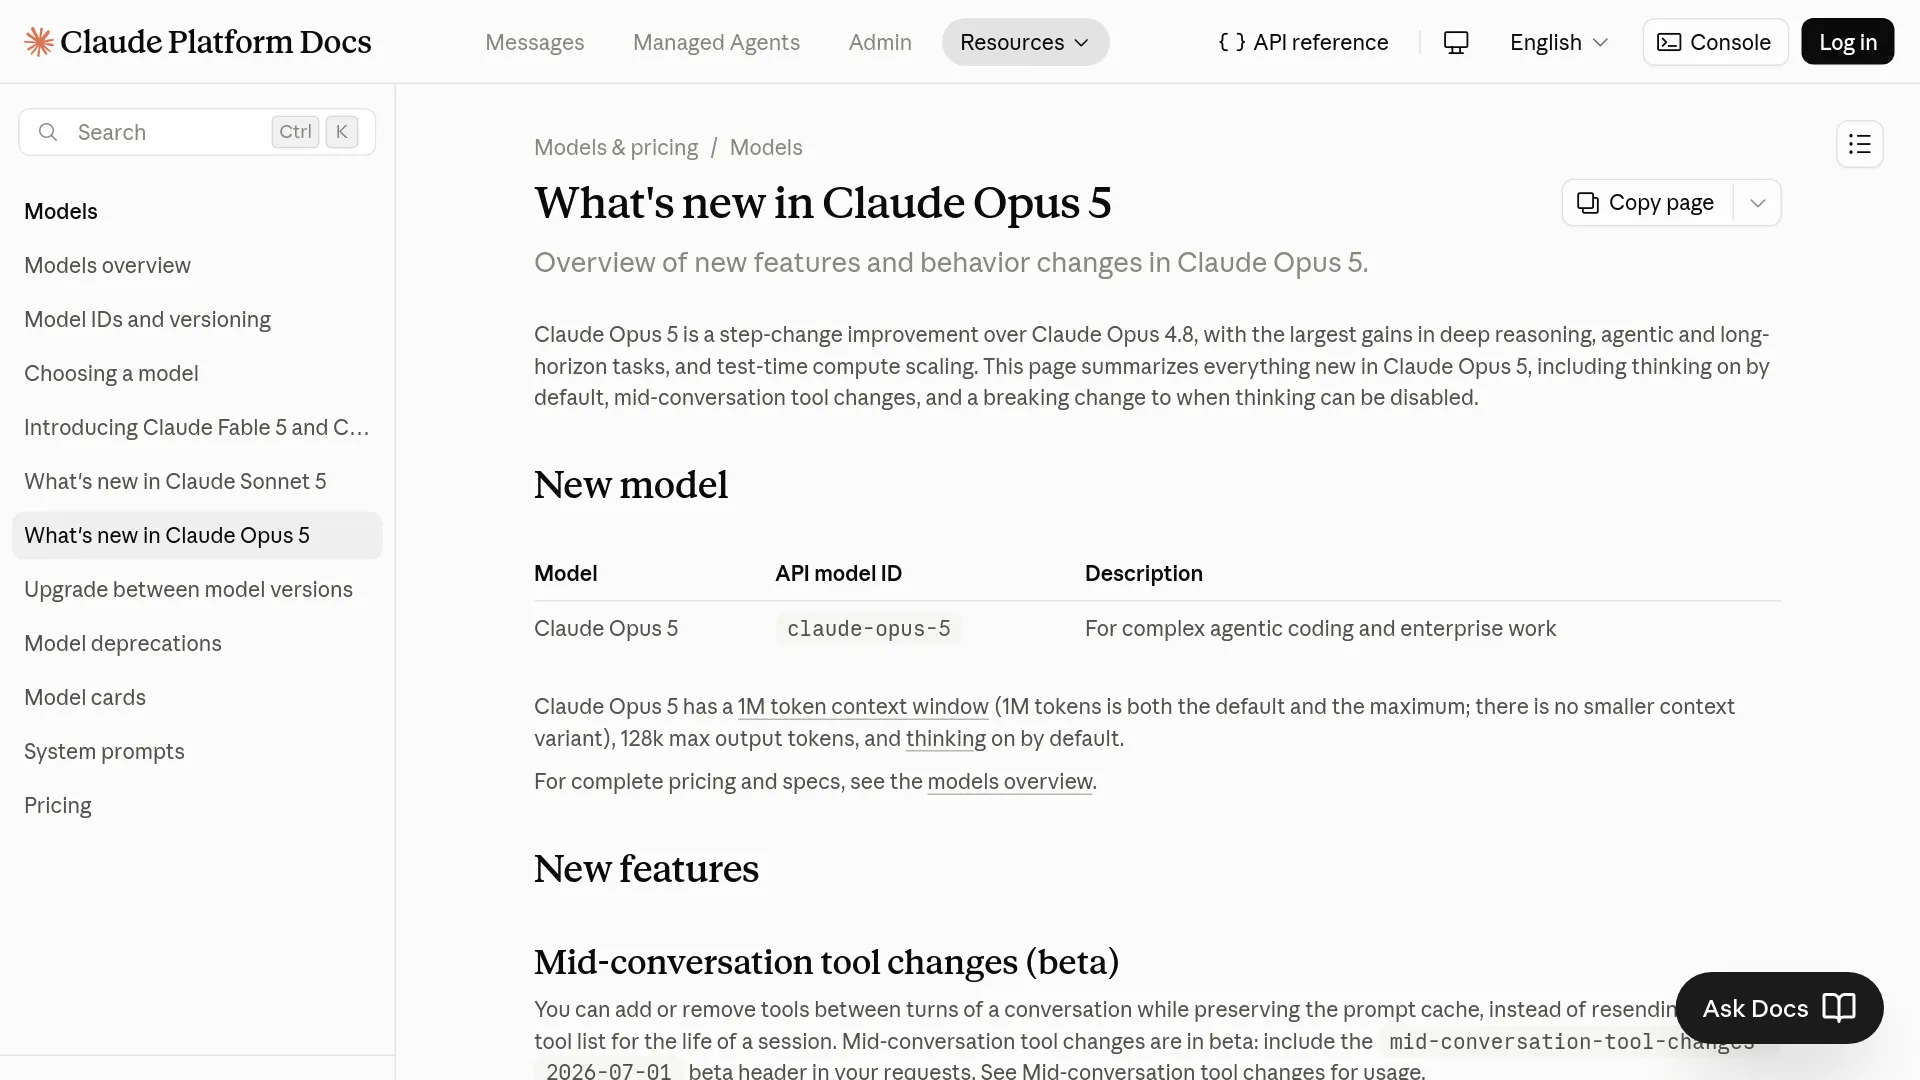
500K tokenın yetersiz kaldığı, iş akışının 128K tokene kadar çıktı gerektirdiği veya entegrasyonun Anthropic’in fallback ve dinamik araç listesi özelliklerine dayandığı durumlarda Claude Opus 5 daha uygun. Anthropic; varsayılan ve azami 1M token bağlam penceresini, varsayılan olarak etkin düşünme özelliğini ve claude-opus-5 modelinin kendi API’siyle başlıca bulut ortaklarındaki erişilebilirliğini belgeliyor. Burada küçük bir liderlik tablosu farkından çok, Claude Platform Opus 5 dokümantasyonu belirleyici.
Buradaki kaynaklar, tüm kodlama görevleri için kesin bir kazanan ilan edecek ortak bir benchmark sunmuyor. Kendi test düzeneğinizde önce en yüksek prompt boyutunu, gerekli çıktı uzunluğunu, araç sözleşmesini ve tamamlanmış görev maliyetini ölçün.
Puanlara geçmeden API farklarını aynı tabloda görün
Grok 4.6 ve Claude Opus 5, metin ve görsel kabul edip metin üretiyor. Esas ayrışma bağlam kapasitesi, uzun bağlam fiyatlandırması, çıktı sözleşmesi ve entegrasyon kontrollerinde ortaya çıkıyor.
| API özelliği | Grok 4.6 | Claude Opus 5 |
|---|---|---|
| Bağlam penceresi | 500K token | 1M token |
| Girdi türleri | Metin, görsel | Metin, görsel, Anthropic’in açıkladığı PDF/doküman iş akışları |
| Çıktı türü | Metin | Metin |
| Azami metin çıktısı | xAI sürüm notlarında sayısal sınır belirtilmiyor | 128K token |
| Efor ayarları | low, medium, high, xhigh | low, medium, high, xhigh, max |
| Varsayılan efor | high | high |
| Standart girdi fiyatı | $2/M token | $5/M token |
| Standart çıktı fiyatı | $6/M token | $25/M token |
| Uzun prompt kuralı | 200K prompt tokenının üzerinde $4/M girdi ve $12/M çıktı | Opus 5 sürüm dokümantasyonunda karşılık gelen bir eşik belirtilmiyor |
| Önbelleğe alınmış girdi | 200K altında $0.50/M; 200K üzerinde $1/M | Önbelleğe alınabilir prompt için 512 token minimum; önbellek fiyatlandırması ayrıca belgeleniyor |
Grok 4.6’nın listelenen birim fiyatları daha düşük, ancak 200K prompt tokenının üzerinde iki katına çıkıyor. Opus 5 daha pahalı olsa da 1M bağlamı, buna ihtiyaç duyan iş akışlarında parçalama veya retrieval yükünü ortadan kaldırabilir.
Grok 4.6’da maliyeti değiştiren eşik: 200K token
Grok 4.6, 200K prompt tokenının altında milyon girdi tokenı başına $2, milyon çıktı tokenı başına $6 olarak listeleniyor. Prompt 200K tokenı aştığında xAI’ın belirttiği fiyatlar girdi için $4/M, çıktı için $12/M oluyor; önbelleğe alınmış girdi fiyatı ise sırasıyla $0.50/M ve $1/M. Bu nedenle düşük fiyat katmanını öne çıkarmaktan çok, bu eşiği hesaba katmak gerekiyor. Her iki katman da xAI sürüm notlarında yer alıyor.
Listelenen fiyatlarla 100K önbelleksiz girdi tokenı ve 20K çıktı tokenı $0.32 tutar. Daha yüksek katman devreye girdiğinde 250K girdi ve 20K çıktı $1.24 olur. Bunlar ajan çalıştırma maliyeti değil, istek bazlı hesaplamalardır; yeniden denemeler, araç çağrıları, önbelleğe alınmış önekler ve biriken bağlam toplam faturada baskın hale gelebilir.
Yakın tarihli bir r/grok tartışması, yapılandırmaya özgü CursorBench 3.2 sonuçlarında Grok 4.6 Extra High için görev başına $2.81 ve 46 adım; Opus 5 Max için ise $8.23 ve 78 adım bildiriyor. Bunları sağlayıcıdan bağımsız bir garanti değil, yazarın kendi test düzeneğinde elde ettiği sonuçlar olarak değerlendirin: Aynı gönderide Grok 4.6’nın Terminal-Bench 3.0’da %26.0 aldığı ve adı geçen diğer modellerin gerisinde kaldığı da belirtiliyor.
Opus 5’in fark yarattığı yer: entegrasyon tasarımı
Claude Opus 5’te düşünme varsayılan olarak açık. max_tokens, gizli düşünme ile kullanıcıya görünen çıktının paylaştığı sabit bir üst sınır olduğundan, düşünmesiz Opus 4.8 isteklerinden geçişte daha yüksek bir çıktı bütçesi gerekebilir. Anthropic ayrıca thinking: {"type":"disabled"} ile xhigh veya max birlikte kullanıldığında HTTP 400 döndüğünü belirtiyor. Geçiş notları iki seçenek sunuyor: Düşünmeyi kapatırken efor seviyesini düşürmek ya da düşünmeyi devre dışı bırakan ayarı kaldırmak.
Claude Opus 5, önbelleğe alınabilir minimum prompt uzunluğunu Opus 4.8’deki 1,024 tokenden 512 tokene indiriyor. Beta kontrolleri, prompt önbelleğini geçersiz kılmadan konuşma sırasında araç değişikliği yapılmasına izin veriyor ve yönetilen bir fallbacks: "default" modu sunuyor. Ajanınızın yetkileri veya araç setleri değişiyorsa bunlar önemli özellikler; basit ve durumsuz bir completion endpoint’i içinse anlam taşımıyor.
Fast mode, yalnızca API üzerinden sunulan bir araştırma önizlemesi ve fiyatı $10/M girdi ile $50/M çıktı; yani standart Opus 5 fiyatının iki katı. Anthropic, bunun Amazon Bedrock, Google Cloud veya Microsoft Foundry üzerinden erişilemediğini söylüyor. Dolayısıyla taşınabilirlik ile hızın birlikte geleceği varsayılmamalı. Anthropic’in duyurusu, standart fiyatı $5/M girdi ve $25/M çıktı olarak veriyor.
Kodlama ajanı sonuçları yön gösterir, evrensel kazananı değil
Anthropic’in verilerine göre Opus 5, maximum effort seviyesinde CursorBench 3.2’de görev başına yaklaşık $8.50 maliyetle yaklaşık %70.0’a ulaşıyor. Bu, Fable 5’in bildirilen en iyi skorunun 0.5 yüzde puanı içinde ve yaklaşık yarı maliyetinde. Ancak bunlar Anthropic’in grafiğe döktüğü sonuçlar; sağlayıcılar arası bağımsız denetim olarak değil, üretici değerlendirmesi olarak okunmalı. Opus 5 duyurusu, Frontier-Bench yöntemini görev başına beş deneme ve Anthropic’in dahili çalıştırması olarak tanımlıyor.
Kod incelemesi açısından daha dar kapsamlı ama daha uygulanabilir bir ölçüm de var. CodeRabbit, gerçek açık kaynak pull request’lerden doğrulanmış yaklaşık 100 hata örüntüsünü test etti; her yapılandırmayı üç kez çalıştırdı ve filtreleme sonrasındaki inceleme yorumlarını değerlendirdi. xhigh eforunda Opus 5 yapılandırması bilinen sorunların %55.2’sini yakalarken, üretim temel çizgisi %61.1’e ulaştı. Buna karşılık uygulanabilir yorum hassasiyeti %39.3 ile %35.2’nin üzerindeydi; ancak 23 yerine 92 nitpick üretti. CodeRabbit’in Opus 5 değerlendirmesi, Opus 5’i tek güvenlik ağı yapmak yerine hassasiyet odaklı, belirli bir rol için kullanmayı öneriyor.
Bu verilerden çıkarılacak somut sonuç şu: Opus 5’i birden fazla efor seviyesinde değerlendirin; kendi pull request’lerinizde recall, precision, token kullanımı ve inceleme gürültüsünü ölçün. Grok 4.6 tarafında xAI’ın güncel sürüm notları API sözleşmesini ve fiyatlandırmayı sunuyor, ancak doğrudan karşılaştırılabilir bir kod inceleme çalışması yayımlamıyor. Kodlama ajanı skorundan kod inceleme başarısı çıkarmayın.
Dağıtım senaryosuna göre seçim yapın
Normal promptu 200K tokenın altında kalan ve önceliği listelenen API maliyetini düşürmek olan ajanlar için öneri Grok 4.6. Değerlendirme bütçenizi eşik etrafında kurun; ilk prompt küçük olsa bile bir repository ajanı, araç çıktıları ve yeniden denemeler sonrasında bu sınırı aşabilir.
500K tokenden fazla etkin bağlama, 128K tokene kadar çıktıya veya Anthropic’in belgelenmiş araç değiştirme ve fallback kontrollerine ihtiyaç duyan repository, doküman ya da ajan oturumları için Claude Opus 5 öneriliyor. high seviyesinden başlayın; max seviyesinin maliyetini haklı çıkardığını varsaymadan önce daha düşük eforları test edin.
Otomatik kod incelemesinde iki modelden birini genel kodlama liderlik tablosuna bakarak seçmeyin. Etiketlenmiş bir pull request setiyle test yapın; sorun recall’ını ve false-positive yükünü kaydedin. Eşzamanlılık, API kullanımı ve doğrulama kusurları için ikinci bir inceleme yolu bulundurun. CodeRabbit, test ettiği Opus 5 yapılandırmalarında bunların daha zayıf kategoriler olduğunu tespit etti. Kategori bulguları, tüm Claude dağıtımları hakkında bir iddia değil, görev uyumunu test etmek için bir gerekçe.
| Dağıtım senaryosu | Varsayılan tercih | Karar gerekçesi |
|---|---|---|
| 200K prompt tokenının altında, maliyet hassasiyetli kodlama ajanı | Grok 4.6 | Listelenen $2/M girdi ve $6/M çıktı fiyatları |
| 500K bağlamın üzerindeki uzun repository veya doküman oturumu | Claude Opus 5 | 1M bağlam penceresi ve 128K çıktı sınırı |
| Araçları dinamik olarak değişen ajan | Claude Opus 5 | Beta sürümde, konuşma içi araç değişiklikleri önbelleği koruyor |
| 200K tokenın üzerinde sık prompt alan görev | İkisini de değerlendirin | Grok 4.6’nın listelenen token fiyatları eşikte iki katına çıkıyor |
| Kod inceleme hattı | Etiketlenmiş PR’lerde ikisini de değerlendirin | Recall, precision, yeniden denemeler ve inceleme gürültüsü başlık skorundan daha önemli |
Sık sorulan sorular
Grok 4.6, Opus 5’ten daha mı ucuz?
200K prompt tokenının altında xAI, Grok 4.6 için $2/M girdi ve $6/M çıktı listeliyor; Opus 5’te bu fiyatlar $5/M girdi ve $25/M çıktı. Grok 4.6’nın listelenen fiyatları 200K prompt tokenının üzerinde iki katına çıktığı için yalnızca ilk isteği değil, tamamlanmış görevin maliyetini karşılaştırın.
Kodlama için hangi modeli kullanmalıyım?
Ajanınız normalde 200K prompt tokenının altında kalıyorsa ve daha düşük listelenen API fiyatları önceliğinizse Grok 4.6’yı seçin. 1M bağlam, 128K çıktı veya Anthropic’in ajan kontrolleri gerekiyorsa Opus 5’i seçin; hangi tercihi yaparsanız yapın, bunu kullandığınız dil, repository yapısı ve araç döngüsü üzerinde doğrulayın.
Bir sonraki dağıtım adımı
Her aday modeli, sabit araçlar, sabit yeniden deneme sınırı ve token kaydıyla 20 ila 50 temsilî görevde çalıştırın. Gereken başarı oranına daha düşük tamamlanmış görev maliyetiyle ulaşan modeli seçin. Ardından, bağlam veya kontrol katmanı avantajının belirleyici olduğu iş yükleri için diğer modeli yönlendirilmiş bir seçenek olarak elinizde tutun.
İlgili okumalar: Claude Opus 5 API fiyatlandırma rehberi, Grok 4.6 sürüm detayları ve Grok 4.6 vs GPT-5.6.