 AIREITER
В августе 2026 года сравнение Qwen 3.8 и Kimi K3 перестало сводиться к простому выбору лучшей модели. Веса обеих линеек уже можно скачать, флагманы доступны в общем доступе — но оптимальный вариант зависит от сценария. Kimi K3 показывает самый сильный подтверждённый результат в агентном программировании, Qwen 3.8 Max выигрывает по стоимости токенов, а Qwen с Apache-2.0 на 27B запускается на одной потребительской GPU. Впрочем, «открытость» Kimi K3 условна на практике: размер её чекпойнта оценивают в 1,56 ТБ, поэтому скачать веса и реально развернуть модель у себя — совсем не одно и то же.
Что на самом деле выпустили Qwen 3.8 и Kimi K3
Kimi K3 от Moonshot AI вышла 16 июля 2026 года как единый флагман: MoE-модель на 2,8 трлн параметров, из которых на токен активны 104B. Она использует Kimi Delta Attention и Gated MLA, поддерживает контекст в 1 048 576 токенов и нативно работает с изображениями. Веса и технический отчёт появились 27 июля под кастомной Kimi K3 License. Как отмечено в сравнении Emergent, лицензия содержит условия для крупных коммерческих реселлеров и продуктов с аудиторией свыше 100 млн пользователей в месяц.
Alibaba ответила не одной моделью, а целой линейкой. Qwen 3.8 Max была представлена в превью 19 июля, 3 августа стала общедоступна в QwenCloud с 2,4T общих и примерно 95B активных параметров, а около 12 августа её веса появились на Hugging Face под именем Qwen/Qwen3.8-2.4T-A95B и кастомной лицензией qwen3.8-max. Через несколько дней вышла Qwen/Qwen3.8-27B — плотная vision-language-модель на 27B под Apache-2.0. Её нативный контекст составляет 262K, а с YaRN его можно расширить до 1M; даты 13–14 августа приводит Yotta Labs.
| Kimi K3 | Qwen 3.8 Max | Qwen3.8-27B | |
|---|---|---|---|
| Всего / активных параметров | 2.8T / 104B | 2.4T / ~95B | 27B, плотная |
| Контекст | 1,048,576 | 1M (991.8K макс. вход) | 262K нативно, 1M через YaRN |
| Лицензия | Kimi K3 License (кастомная) | Кастомная лицензия qwen3.8-max | Apache-2.0 |
| Веса доступны с | 27 июля 2026 года | ~12 августа 2026 года | ~13–14 августа 2026 года |
| Вход для зрения | Текст + изображение (официально) | Текст, изображение, видео через API | Текст, изображение, видео |
По сообщениям, Moonshot также приостановила новые потребительские подписки менее чем через 48 часов после релиза K3: спрос превысил доступные GPU-мощности. Об этом стоит помнить, прежде чем строить продукт вокруг единственного провайдера.
Бенчмарки: где данные вендора, а где независимая проверка
Обе компании публикуют внушительные таблицы бенчмарков, но в них смешаны разные тестовые обвязки. В карточке Kimi прямо указано, что результаты конкурентов получены в иных агентных harness, а в отдельных строках использовались H20, а не H100. Поэтому общие для моделей строки ниже следует считать заявлениями вендоров, а не аудитом.
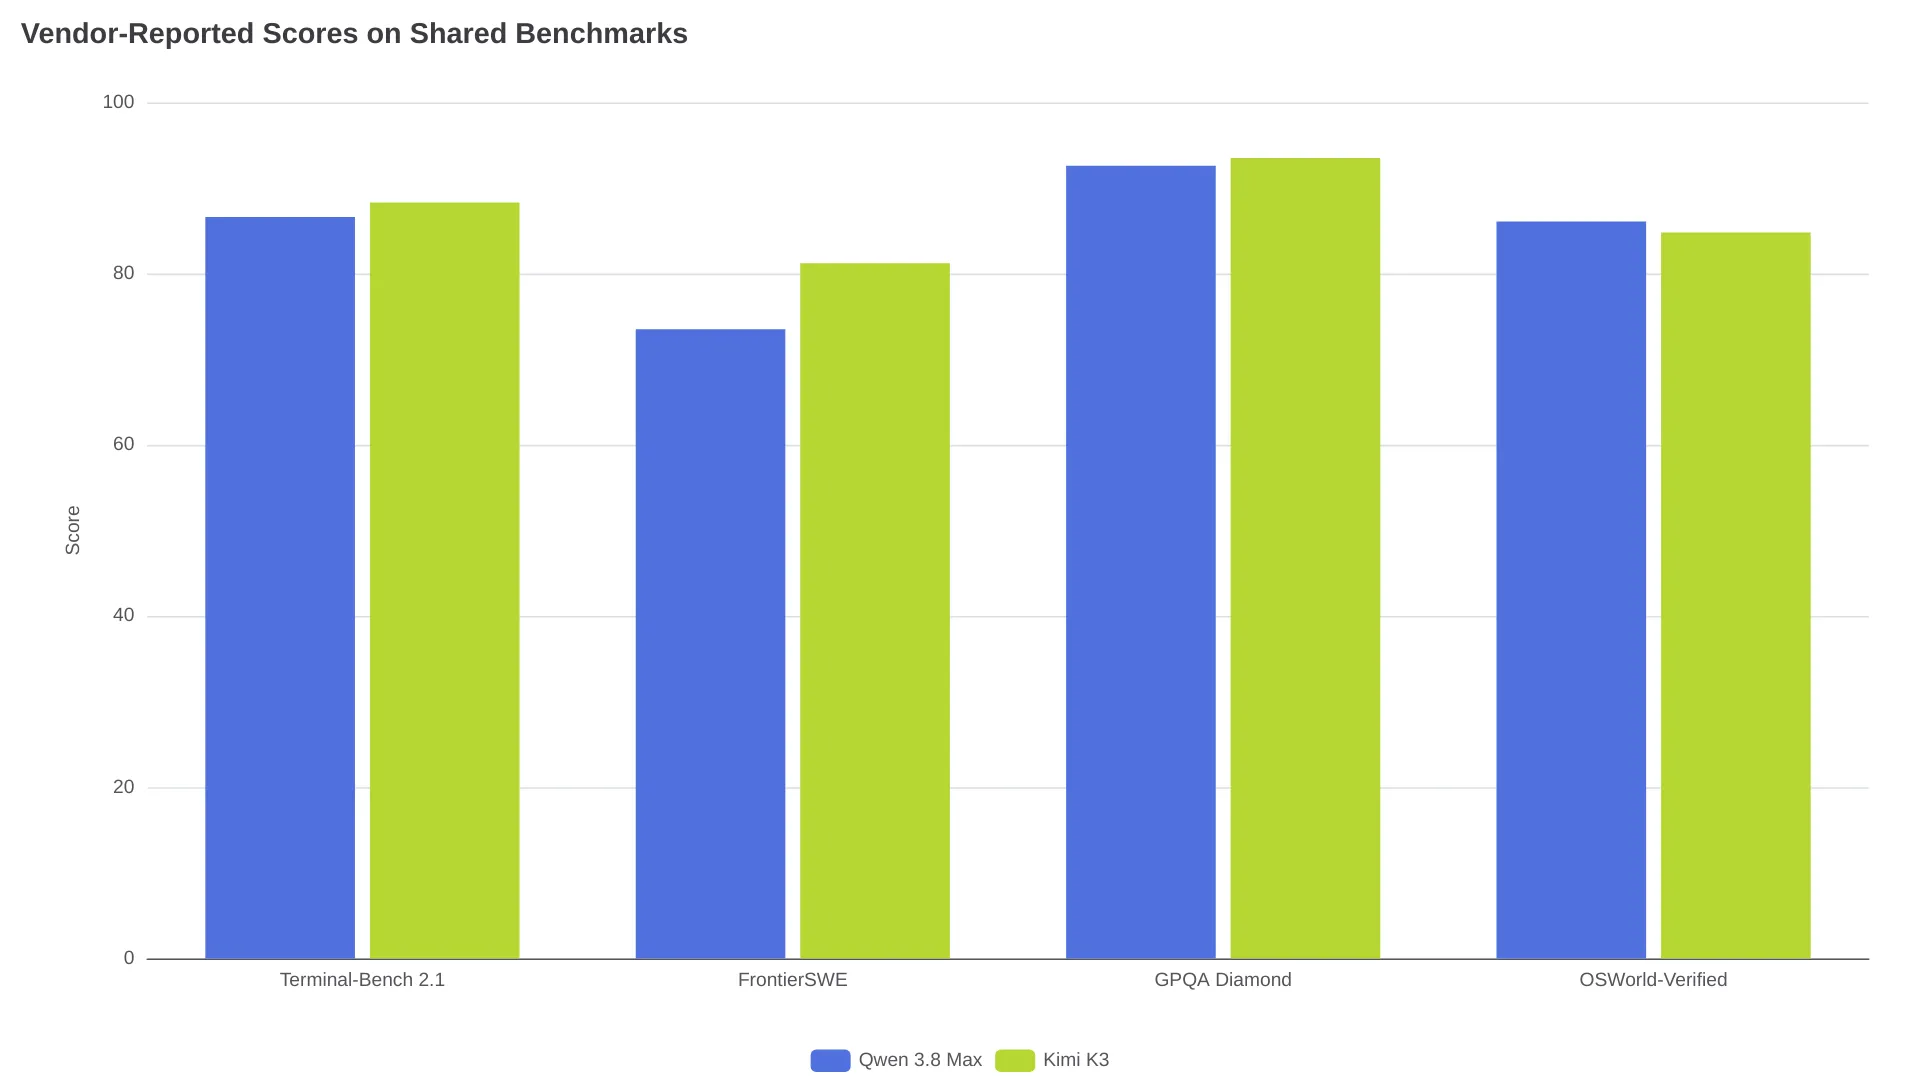
В общих строках Kimi K3 лидирует именно там, где важнее всего агентное программирование. Согласно её model card, в FrontierSWE она набирает 81.2 против 73.5, а в Terminal-Bench 2.1 — 88.3 против 86.6 у Qwen; со стороны Qwen данные приведены в карточке модели 2.4T. В материалах запуска Qwen заявлен результат 86.1 в OSWorld-Verified против 84.8 в карточке K3. У Qwen также есть сильные одиночные показатели: PaperBench 93.0, IFBench 82.8 и SWE-bench Pro 67.7. K3, в свою очередь, приводит SWE-Marathon 42.0, BrowseComp 91.2 и MCPMark-Verified 94.5 — в тестах, по которым Qwen результатов не публикует.
Независимых данных пока заметно больше у Kimi. Трекер Emergent указывает для Kimi K3 57 баллов в Artificial Analysis Intelligence Index на запуске и 60 в текущей версии индекса; модель расположена позади Claude Fable 5 и GPT-5.6 Sol. В сравнении Orcarouter также указано первое место в Frontend Code Arena с рейтингом 1,679 Elo. Qwen 3.8 Max на момент запуска независимый индекс не получил: трекер cheapestinference.com сообщал о 53 баллах по индексу Artificial Analysis, а сообщения сообщества об обновлении до 56 пока не подтверждены.
Единственное прямое сопоставление на идентичной задаче — анализ архитектур StackPerf от TrilogyAI, который документировал Orcarouter. На превью-эндпойнтах K3 получила 83/100, а Qwen — 80/100. При этом Qwen зафиксировала 354 ссылки на репозиторий против 274 у Kimi, 22 запроса к gateway против 53 и ни одного неудачного вызова инструментов против двух у Kimi.
А теперь показатель, которого нет в общих таблицах. В собственной карточке Qwen модель 27B получает 84.3 в OSWorld-Verified, тогда как у K3 — 84.8. Плотная модель на 27B отстаёт от флагмана на 2,8T всего на полбалла в задачах компьютерного использования. До уровня K3 в программировании ей далеко — 73.0 против 88.3 в Terminal-Bench, — но 90.3 в LiveCodeBench v6 и 61.7 в SWE-bench Pro делают её полноценной рабочей моделью. Практический тред со сравнением на r/AISEOInsider пришёл к тому же выводу: Qwen чаще выигрывает в одноразовых сборках, но Kimi выходит вперёд с ростом контекста и глубины доработок.
Стоимость API: $15 за выходные токены и цена рассуждений
Рекомендованные цены указывают в одну сторону. Фактические расходы — ещё сильнее, поскольку обе модели по умолчанию рассуждают: K3 в режиме reasoning_effort: max, Qwen — xhigh. А токены рассуждений тарифицируются как выходные.
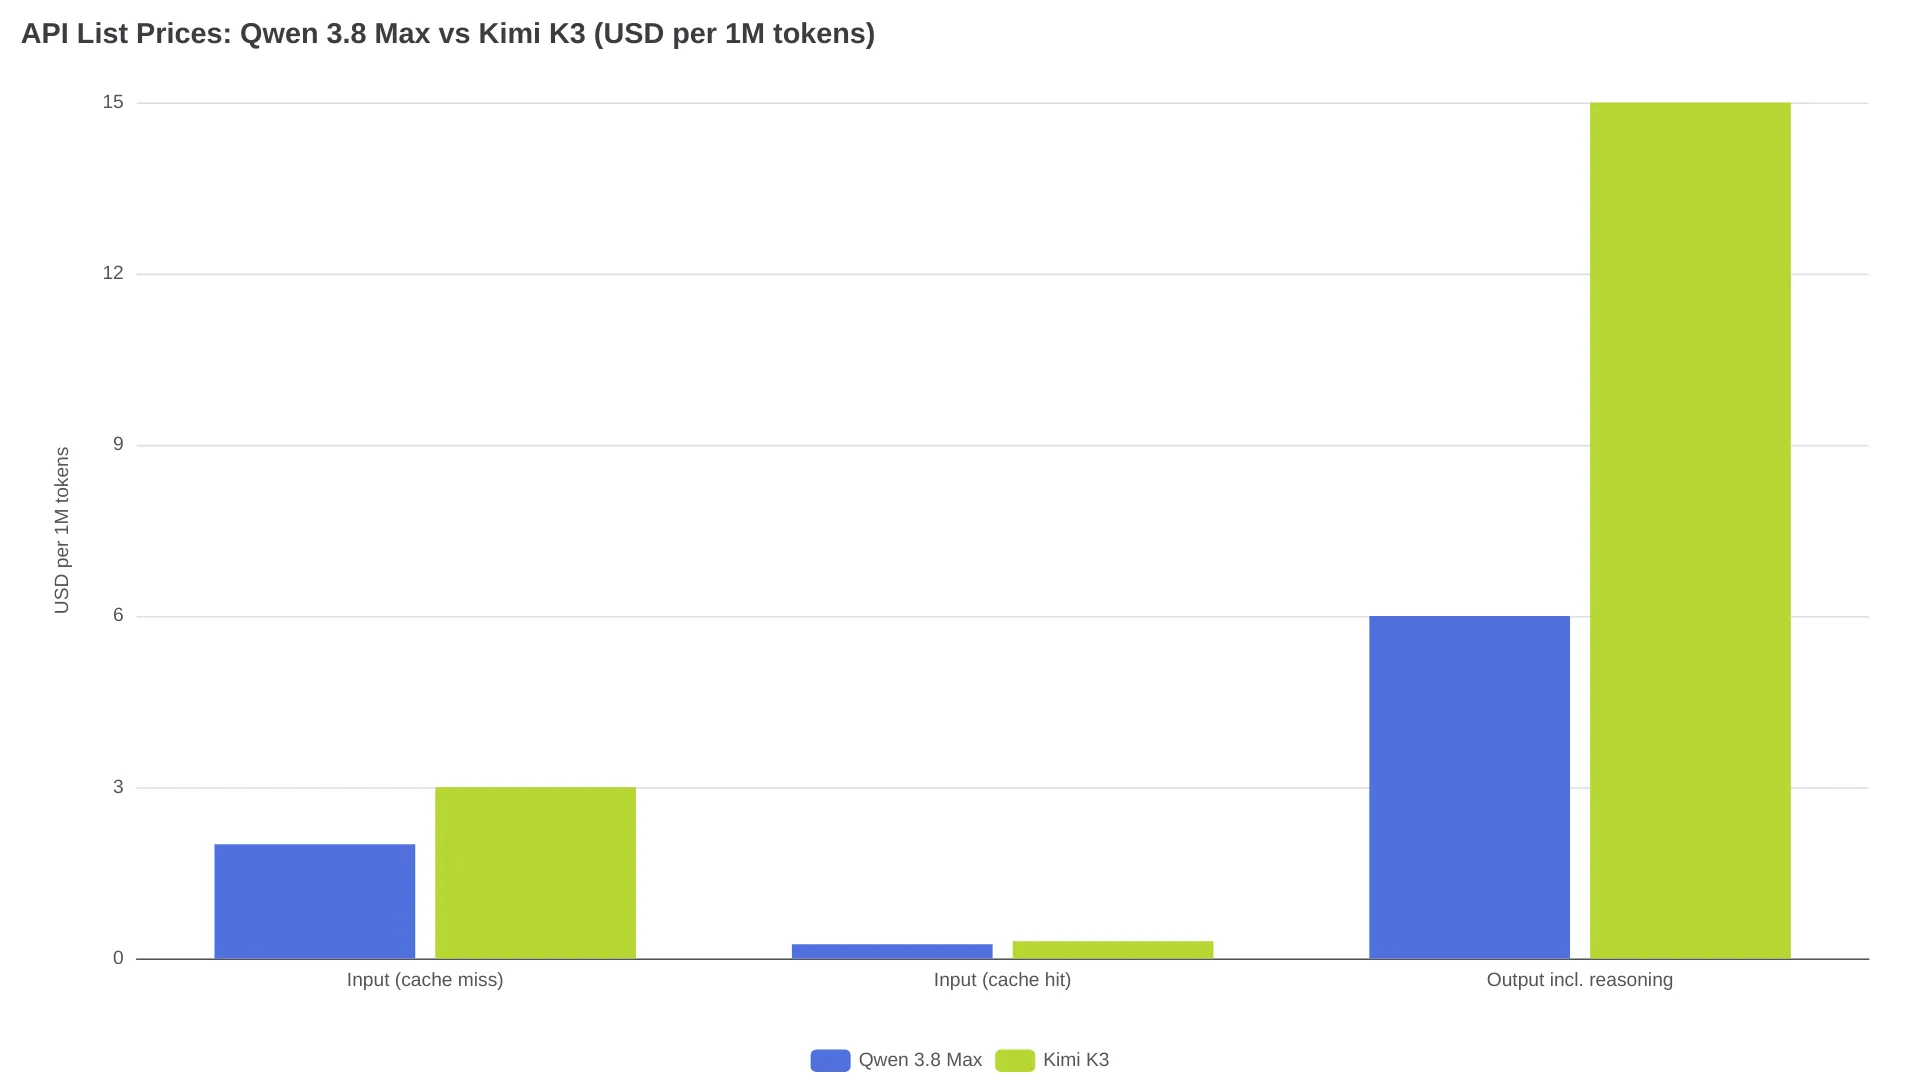
| За 1M токенов | Qwen 3.8 Max (QwenCloud) | Kimi K3 (Moonshot) |
|---|---|---|
| Вход (cache miss) | $2.00 | $3.00 |
| Вход (cache hit) | $0.25 | $0.30 |
| Выход, включая рассуждения | $6.00 | $15.00 |
| Явное создание / чтение кэша | $2.50 / $0.17 | — |
Два расчётных сценария по ценам августа 2026 года:
| Сессия | Qwen 3.8 Max | Kimi K3 | Разница |
|---|---|---|---|
| Агентное программирование: 500K входа (60% из кэша), 40K выхода | $0.72 | $1.29 | 1.8× |
| Конвейер документов со свежим контекстом: 2M входа, 100K выхода | $4.60 | $7.50 | 1.6× |
Из этих цифр следует простое правило маршрутизации: отправляйте задачу в K3, только если её доля принятых результатов на вашей нагрузке превышает показатель Qwen больше чем примерно в 1.8× — настолько отличается цена токенов. Сама Moonshot предлагает более бюджетную альтернативу: Kimi K2.7 Code за $0.95 на входе и $4.00 на выходе при контексте 256K. Поэтому самый дешёвый путь для кодинга внутри семейства Kimi — не K3. Если вы выбираете маршрут для K3 сейчас, её API-эндпойнт указан здесь по опубликованным Moonshot тарифам. Детальная механика ценообразования обеих моделей разобрана в анализе цен Qwen3.8-Max и гайде по ценам Kimi K3.
Самостоятельный запуск: 1,56 ТБ против одной RTX 4090
Именно здесь различие между двумя историями об открытых весах достигает примерно двух порядков.
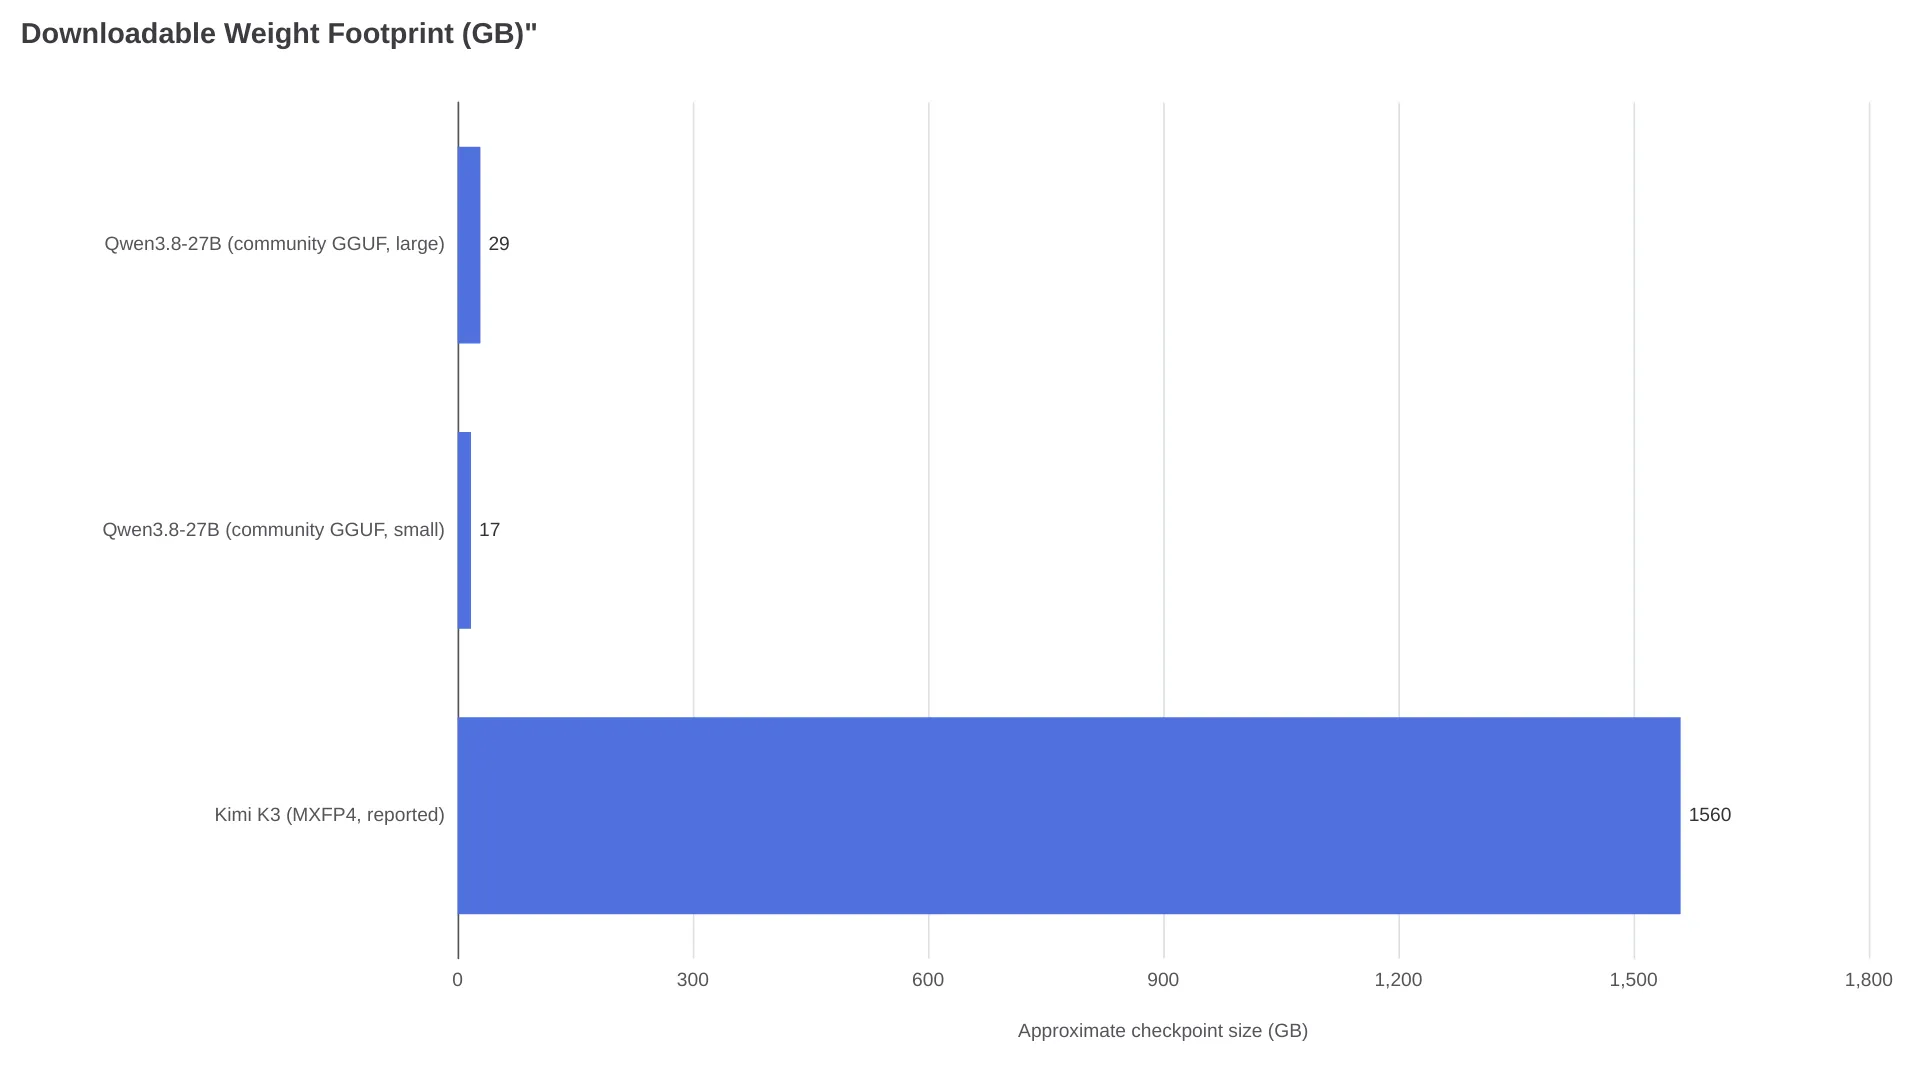
K3 поставляется с весами MXFP4, рассчитанными на квантизацию, как сказано в model card. Но чекпойнт, который оценивают в 1,56 ТБ, — это проект для кластера: тот же источник рекомендует vLLM на 64 ускорителях или более. Это вполне реальная статья расходов на аренду ещё до выдачи первого токена, а поверх неё действуют условия лицензии для крупных сценариев.
У 27B совсем другой профиль. Сборки GGUF от сообщества занимают примерно от 8.5 ГБ до 28.9 ГБ, а динамические сборки GGUF и NVFP4 от Unsloth укладываются примерно в 17 ГБ как минимум. Для серверного развёртывания есть и официальная версия FP8. Модель работает на железе, которое у многих уже есть:
"Qwen3.8-27B при контексте 160K на ОДНОЙ RTX 4090 — 47–57 ток/с, полный offload на GPU" — пост о развёртывании в r/Qwen_AI
Веса Max занимают промежуточную позицию. Qwen3.8-2.4T-A95B и её FP8-вариант можно скачать под кастомной лицензией qwen3.8-max, но открытый артефакт работает только с текстом, а отключить рассуждения в нём нельзя. Ввод изображений, режим без рассуждений и контекст 1M по умолчанию доступны в API-слое QwenCloud, а не в самом чекпойнте. О возможностях и ограничениях 27B при разных квантизациях, средах запуска и потреблении VRAM читайте в полевом гайде по Qwen3.8-27B; релиз весов K3 подробно разобран в материале об открытых весах Kimi K3.
Нюансы интеграции, которые решают судьбу агентного проекта
Три особенности из карточек моделей способны отнять целый день отладки, если обнаружить их уже в продакшене.
| Модель | Поведение / ограничение | Последствие для реализации |
|---|---|---|
| Kimi K3 | Рассуждения всегда включены; клиенты с несколькими ходами и вызовами инструментов обязаны заново передавать полное предыдущее сообщение ассистента, включая reasoning_content и tool_calls (карточка) | Если отбросить trace рассуждений, агентные циклы деградируют; если хранить его, расходы растут вместе с длиной цикла |
| Qwen3.8-27B | preserve_thinking включён по умолчанию; reasoning_effort можно снизить до medium/low; YaRN после 262K использует статическое масштабирование (карточка) | Отключение на уровне отдельного запроса поддерживается; карточка предупреждает, что снижение effort не всегда уменьшает общее время из-за повторных попыток; YaRN стоит включать только для длинных задач |
| Лимиты Qwen 3.8 Max и K3 | Max: 991.8K входа / 131.07K выхода (QwenCloud); K3: 1,048,576 входа / 131K выхода по умолчанию с ростом в сторону 1M | Ни одна формулировка «контекст 1M» не обещает 1M полезного выхода; в стороннем needle-тесте нашли 18/18 фактов на 248K и ничего не тестировали выше |
FAQ
Qwen 3.8 лучше Kimi K3 для программирования?
По доступным данным — нет. Kimi K3 лидирует в важных для агентного кодинга строках: FrontierSWE 81.2 против 73.5 и Terminal-Bench 2.1 88.3 против 86.6; кроме того, только у неё есть независимые индексные оценки. Qwen 3.8 Max близка в задачах терминала и дешевле на токен и в расчётных сессиях, а 27B относится к совершенно другому классу по размеру весов.
Что дешевле: Qwen 3.8 или Kimi K3?
Qwen 3.8 Max дешевле по каждой строке прайс-листа: $2 против $3 за вход и $6 против $15 за выход. Поскольку обе модели тарифицируют включённые по умолчанию рассуждения как выходные токены, отставание Kimi по цене растёт вместе со сложностью задачи — в расчёте выше это примерно 1.8× для агентной сессии с кэшем.
Можно ли развернуть их самостоятельно и на каких лицензиях?
Да, все три чекпойнта доступны для скачивания. Qwen3.8-27B распространяется по Apache-2.0 и в квантизованном виде помещается на одной GPU с 24 ГБ; Kimi K3 для своего чекпойнта MXFP4 объёмом около 1,56 ТБ требует кластерного железа и лицензируется по кастомной Kimi K3 License; веса Qwen3.8-Max опубликованы как Qwen3.8-2.4T-A95B под кастомной лицензией qwen3.8-max.
Контекстное окно 1M действительно работает у обеих моделей?
Приблизительно. Для Kimi K3 заявлены 1 048 576 токенов; Qwen 3.8 Max указывает 1M при максимальном входе 991.8K; у 27B нативный лимит — 262,144, а 1M достигается только масштабированием YaRN, которое ухудшает качество на коротком контексте. Независимая проверка существует лишь на уровне 248K.
Что выбрать и что может изменить вывод
| Ваш сценарий | Выбор | Причина |
|---|---|---|
| API-агенты для кодинга, качество важнее всего | Kimi K3 | FrontierSWE 81.2, Terminal-Bench 88.3, подтверждённые AA 60 |
| Работа через API, где важны расходы, много документов и vision | Qwen 3.8 Max | $6 против $15 за выход, OSWorld 86.1, явное чтение кэша за $0.17 |
| Самостоятельный запуск на собственном железе | Qwen3.8-27B | Apache-2.0, квантизации ~17–29 ГБ, контекст 160K на одной RTX 4090 |
| Самостоятельный запуск флагмана frontier-класса | Kimi K3 | Единственный здесь открытый чекпойнт с независимыми результатами frontier-класса — закладывайте бюджет на кластер |
Два события могут изменить часть этой таблицы: независимая оценка Qwen 3.8 Max, для которой пока есть лишь трекерное значение 53 против подтверждённых 60 у K3 на слабой доказательной базе, и публикация условий кастомной лицензии qwen3.8-max. Пока этого не произошло, в прямом сравнении API Qwen 3.8 Max и Kimi K3 подробнее разобран сценарий работы только через API.
Читайте также: Qwen3.8-27B: что подтверждено и на что реально хватает 17GB · Открытые веса Kimi K3 · Qwen 3.8 Max против Kimi K3: API-версия