 AIREITER
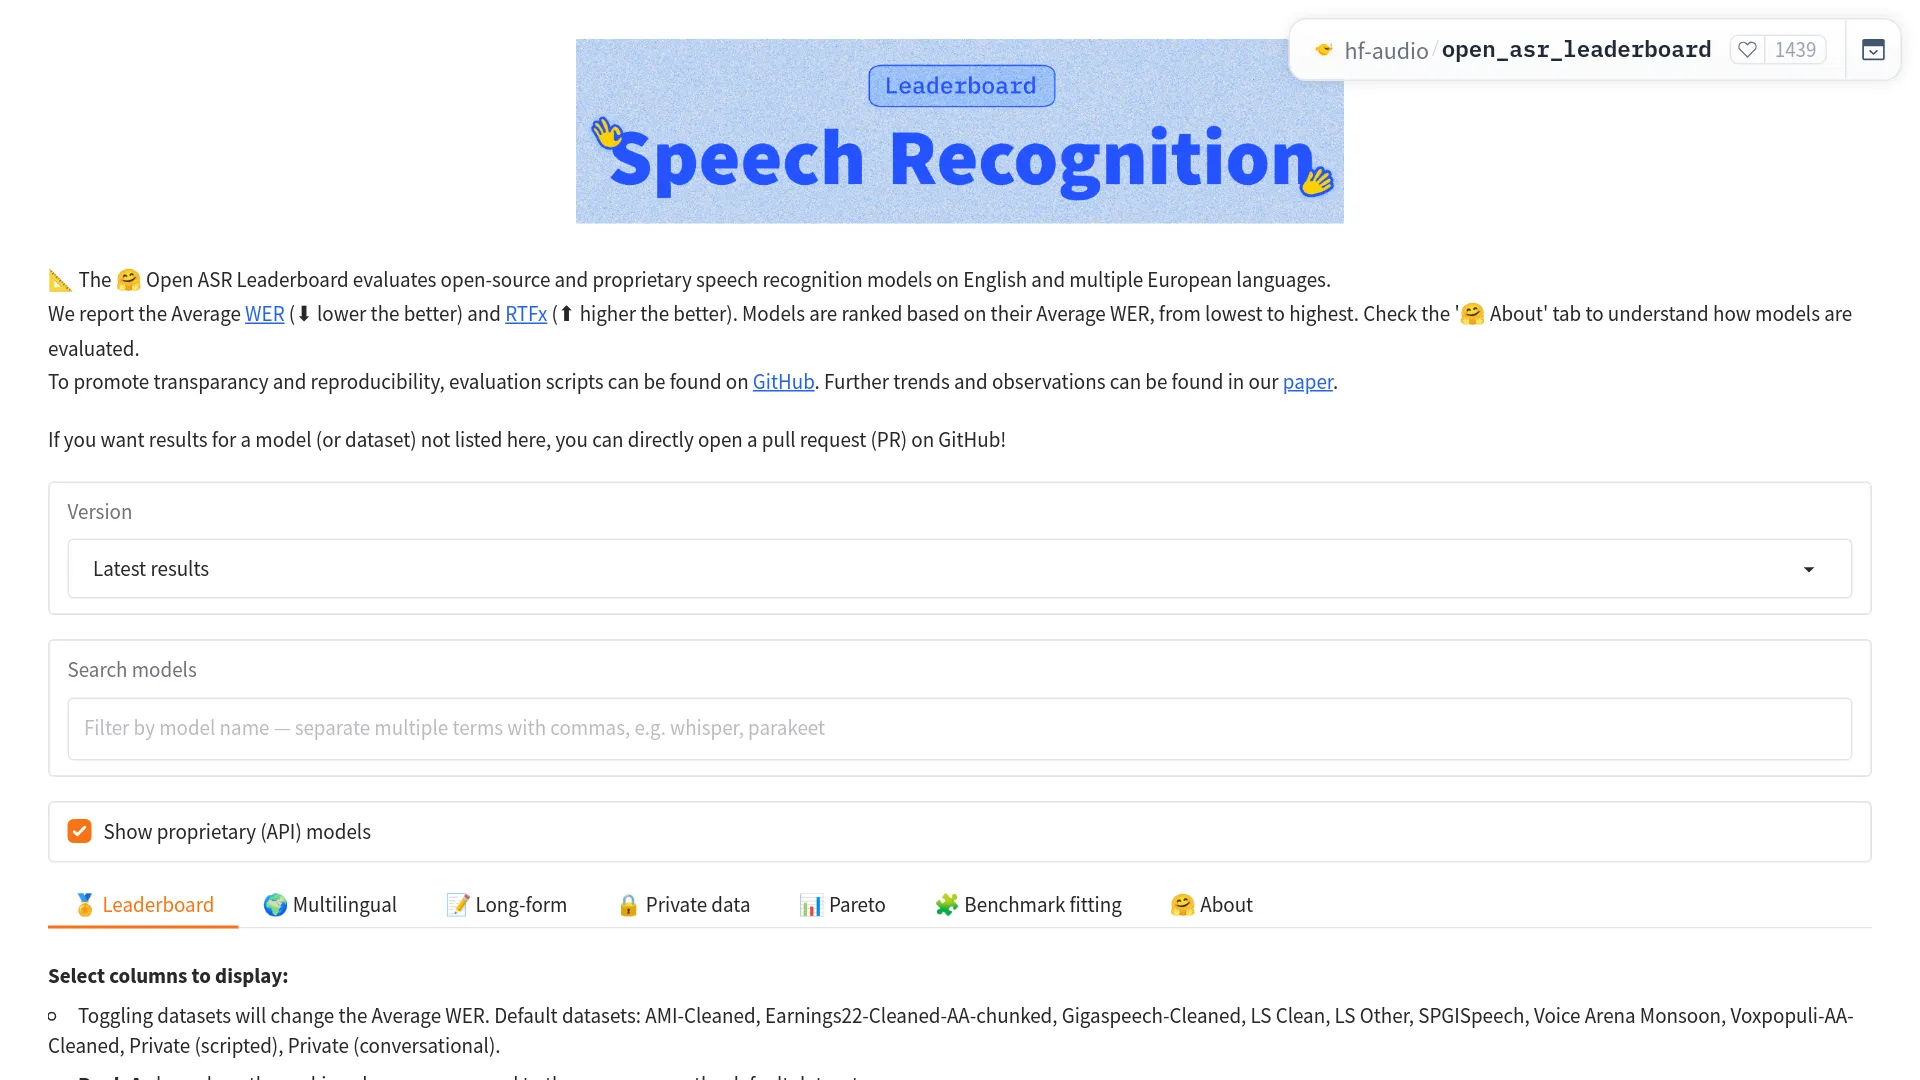
Лидерборд может показать, что два распознавателя речи идут почти вровень. Но Monsoon добавляет куда более важный вопрос: для каких именно говорящих, регионов, устройств и вариантов написания они равны? Новые наборы en-IN и hi-IN делают Open ASR Leaderboard полезнее для оценки многоязычных ASR-моделей. При этом короткие публичные записи всё равно требуют осторожной интерпретации.
Коротко: Monsoon показывает, почему модели расходятся
В Open ASR Leaderboard появились два набора Voice Arena: Monsoon en-IN для индийского английского и Monsoon hi-IN для хинди. Индийский английский вошёл в основные колонки лидерборда и влияет на итоговый Average WER. Хинди отображается в многоязычном представлении: чтобы получить место в таком рейтинге, модель должна поддерживать выбранный набор языков.
Четыре публичных и закрытых сплита включают 4 888 говорящих без пересечений между сплитами и 12 атрибутов, связанных с говорящими: демографию, окружение, географию и используемые устройства. Теперь исследователи могут спрашивать не только «у какой модели ниже средний WER?», но и смотреть, где именно модель теряет стабильность. Monsoon — заметное улучшение оценки региональной устойчивости и качества распознавания хинди, но не гарантия поведения в продакшене и не репрезентативный срез всех языков Индии.
Что Monsoon добавляет в Open ASR Leaderboard
Monsoon включает четыре тестовых сплита, собранных по одному разговорному пайплайну со спонтанной речью. Для каждого языка есть публичный сплит для самостоятельной проверки и закрытый — чтобы усложнить настройку моделей под конкретный бенчмарк. В официальном анонсе релиз назван первым добавлением индийского языка в многоязычный контекст этого лидерборда.
Что входит в каждый сплит
| Сплит | Аудио | Говорящие | Клипы | Родные округа | Штаты / союзные территории | Устройства | Формат эталона |
|---|---|---|---|---|---|---|---|
| Monsoon en-IN public | 5.62 ч | 1 444 | 2 102 | 428 | 24 / 6 | 556 | Нормализованный текст с дисфлюэнциями |
| Monsoon en-IN private | 5.58 ч | 1 405 | Не публикуется | 420 | 24 / 6 | 560 | Нормализованный текст с дисфлюэнциями |
| Monsoon hi-IN public | 1.33 ч | 468 | 753 | 202 | 11 / 3 | 315 | Lattice из допустимых вариантов |
| Monsoon hi-IN private | 4.47 ч | 1 571 | Не публикуется | 295 | 12 / 3 | 582 | Lattice из допустимых вариантов |
Публичная карточка датасета Monsoon en-IN указывает частоту дискретизации 16 кГц, среднюю длину клипа 9,6 секунды и медианную — 10,4 секунды. В карточке Monsoon hi-IN для публичного сплита указаны средняя длина 6,4 секунды и медианная 5,0 секунды. В сумме четыре сплита дают 17.00 часов аудио. Это бенчмарк, ориентированный прежде всего на разнообразие коротких разговорных фрагментов, а не на длинные звонки.
Публичные данные — для воспроизводимости, закрытые — для проверки обобщения
Публичные сплиты можно загрузить с Hugging Face, прогнать через распознаватель, нормализовать результат и посчитать итоговый score на уровне всего корпуса. Для en-IN карточка датасета требует делить общее число вставок, удалений и замен на общее количество слов в эталонных транскрипциях, а не усреднять WER по отдельным клипам.
Для хинди в публичной карточке доступен скорер voi-oiwer, учитывающий варианты в lattice. Минимальный пример загрузки выглядит так:
from datasets import load_dataset
from voi_oiwer import oiwer

hi = load_dataset(
    "VoiceArena/MonsoonASR-Open-ASR-leaderboard-hi-IN",
    split="test",
)
hypothesis = "replace with your model output for hi[0]"
result = oiwer(hypothesis, hi[0]["lattice"], "hindi")
score, (ins, dele, sub), ref_words = result[0], result[4], result[5]
Закрытые сплиты остаются недоступными и не пересекаются с публичными по говорящим, поэтому команда разработчиков не может подгонять модель под каждый пример из оценки. Архитектура с закрытыми данными сохраняет такие результаты в отдельных агрегированных представлениях и не меняет публичный рейтинг по умолчанию.
Главное изменение Monsoon — охват говорящих
В публичном en-IN-сплите участвуют 1 444 говорящих и 2 102 клипа, а в публичном hi-IN — 468 говорящих и 753 клипа. Согласно таблице охвата из официального анонса, десять крупнейших участников дают лишь от 2,8% до 6,8% общей продолжительности каждого из четырёх сплитов.
Это снижает вероятность того, что итоговый score будет определяться одним активным говорящим, микрофоном или стилем записи. Но выборка от этого не становится репрезентативной. Всего записывались 12 атрибутов: пол, дата рождения, профессия, образование, семейный статус, доход, родной округ и штат, текущий город, число лет в текущем округе, производитель устройства и модель устройства.
Индийский английский — это географическое распределение, а не один акцент
Публичный сплит en-IN охватывает 428 родных округов, 30 штатов и союзных территорий, 641 текущий город и 556 моделей смартфонов. На южный регион приходится 35% фрагментов, на восточный — 18%, центральный — 18%, северный — 16%, западный — 11%. По данным анонса Hugging Face, ни один штат не даёт больше 13% говорящих.
Поля native_district, native_state, current_city, years_spent_in_current_district, device_manufacturer и device_model позволяют сравнивать региональные срезы и разные устройства. Поэтому «индийский английский» здесь — не один микрофон и не один акцент. Модель может хорошо работать на одном региональном распределении речи и заметно проседать на другом, сохраняя при этом конкурентный общий WER.
У хинди другой охват — и другая проблема со скорингом
Публичный сплит хинди меньше: 1,33 часа, 468 говорящих, 202 округа и 315 моделей смартфонов. Охват хинди в основном сосредоточен в хинди-язычном поясе; в анонсе говорится, что на Уттар-Прадеш приходится около 40% говорящих в этой коллекции. Это важный контекст для интерпретации результата, но он не означает, что все сообщества, говорящие на хинди, представлены одинаково.
В хинди встречаются слова английского происхождения, переключение языкового кода, слитное и раздельное написание составных слов, варианты написания деванагари и альтернативы на латинице. Поэтому карточка датасета hi-IN хранит lattice, где для каждого фрагмента транскрипции могут быть указаны несколько допустимых письменных форм.
Региональный анализ ошибок показывает то, что скрывает общий WER
В официальном региональном примере используется публичный сплит индийского английского. Восемь моделей попадают в диапазон от 4.81 до 4.99 WER — разница составляет всего 0.18 пункта. В анонсе отдельно отмечается, что тестовый набор продолжительностью около пяти часов может не позволить надёжно различить настолько близкие результаты.
Но если разбить те же результаты по пяти географическим зонам, картина стабильности меняется:
| Модель | Наблюдение по общему результату | Разброс по регионам | Конкретный региональный результат |
|---|---|---|---|
openai/whisper-large-v3-turbo | Конкурентный общий score | 0.46 пункта WER | Самый слабый регион в примере не указан |
mistralai/Voxtral-Mini-3B-2507 | На 0.14 пункта хуже Whisper в целом | 1.68 пункта WER | 4.38 в центре против 6.06 на востоке |
ibm-granite/granite-speech-3.3-2b | Включена в региональный анализ | Не сообщается | Север стал самым слабым регионом |
microsoft/VibeVoice-ASR-HF | Включена в региональный анализ | Не сообщается | Юг стал самым слабым регионом |
Больший разброс означает, что Voxtral сильнее зависит от региона, а не что модель допускает в четыре раза больше ошибок при распознавании. Региональные слабые места у моделей тоже различаются, что указывает на специфичную для каждой модели чувствительность, но само по себе не объясняет её причину.
Пользователь @FoucqueThomas после релиза отметил ту же особенность:
«⚡ Open ASR Leaderboard добавил хинди и индийский английский — 4 888 говорящих и 12 атрибутов на клип. В результате две модели с почти одинаковым глобальным WER могут отличаться примерно в 4 раза в зависимости от региона говорящего. Наконец-то бенчмарк, который честно учитывает разнообразие речи». — @FoucqueThomas в X
Если основная аудитория пользователей сосредоточена в конкретном регионе, равенство моделей по агрегированному score ещё не даёт достаточных оснований для выбора. Этот пример не доказывает, что региональный паттерн вызван конкретным дисбалансом в обучающих данных.
Зачем нужна оценка хинди с lattice-вариантами
Обычный WER предполагает наличие одного канонического эталона. Для регистра и нормализации написания это подходит, но в случае хинди с переключением языков быстро возникают проблемы. Корректный результат может использовать написание в деванагари, транслитерацию латиницей, английский вариант слова или другую границу составного слова.
Monsoon hi-IN решает проблему с помощью эталонных lattice: в официальном описании релиза говорится, что варианты расширяются, проверяются лингвистами — носителями языка — и фильтруются, чтобы сохранить только формы, согласующиеся с конкретным высказыванием. Допустимая альтернатива засчитывается как правильная, а не штрафуется за отличие от записи одного конкретного аннотатора.
Для оценки хинди лидерборд использует Orthographically-Informed Word Error Rate (OIWER). Допустимый вариант считается правильным, а настоящая ошибка распознавания по-прежнему учитывается. В коммите интеграции лидерборда видно, как данные для хинди и многоязычные представления с разбивкой по языкам подключаются к приложению.
Такое правило скоринга способно изменить порядок моделей. Согласно официальному анонсу, если свести Hindi-lattice к одному эталонному варианту, error rate вырастет у всех протестированных систем, причём неравномерно. Значит, многоязычный лидерборд может стать лингвистически справедливее, не сводя каждый результат к одному универсальному числу.
Как использовать обновлённый лидерборд при выборе модели
Используйте Monsoon сначала для первичного отбора и диагностики, а финалиста затем проверяйте на аудио из своей предметной области.
- Сначала сузьте выбор по Average WER. Теперь индийский английский влияет на среднее значение основного лидерборда, поэтому модели, хорошо работающие только с дикторским или неиндийским английским, меньше защищены от разговорного теста с индийскими акцентами.
- Перед сравнением многоязычных средних проверьте покрытие языков. Исходный код лидерборда показывает отсутствующие выбранные языки как
NAи выводит значениеCoverage, например3/5. Модель получает место в многоязычном рейтинге только при поддержке всех выбранных языков. См. код интеграции. - Разбирайте публичные данные Monsoon по документированным полям. Сравнивайте родной округ, штат, город, устройство и другие доступные метаданные. Ищите разброс и концентрацию ошибок, а не только лучший результат на отдельном подмножестве.
- Проверяйте модель на репрезентативном продакшен-аудио. Тестируйте свой набор телефонов, шум, сценарии переключения языков, VAD и разную длину речи. Средняя длина публичных клипов Monsoon — менее десяти секунд, поэтому они не могут заменить проверку на всех сценариях колл-центра, встреч или голосовых агентов.
Практик @PlimmApp в X предупредил, что VAD может скрывать галлюцинации на тишине, если оценка начинается с сегментов, где уже есть речь: «шаг VAD в вашем пайплайне тоже может быть слепой зоной… модель, которая генерирует связный текст поверх тишины, никогда не получает за это штраф». Читайте полный комментарий. Для on-device-систем VAD, endpointing и обработку галлюцинаций стоит оценивать отдельно.
На какие вопросы Monsoon пока не отвечает
- Масштаб и переносимость на длинные записи: публичный en-IN-сплит содержит 5.62 часа, а публичный hi-IN — 1.33 часа; средняя длина клипа составляет 9,6 и 6,4 секунды соответственно. Небольшие различия в score и поведение на длинном аудио требуют отдельной проверки.
- Репрезентативность по стране: широкий охват округов, штатов и устройств не превращает набор в перепись говорящих на индийском английском или хинди с учётом долей населения.
- Причины ошибок: региональные корреляции не показывают, вызваны ли различия обучающими данными, акустикой, фонетикой, декодированием или другим фактором.
- Предсказательная сила закрытых наборов: закрытые сплиты без пересечений по говорящим предназначены для проверки обобщения, но их примеры нельзя изучить независимо.
- Соответствие downstream-задачам: для поиска, субтитров, аналитики и юридических расшифровок могут требоваться разные правила выбора скрипта, нормализации, пунктуации и обработки переключения языков.
FAQ по Monsoon в Open ASR Leaderboard
Влияет ли индийский английский на среднее значение основного лидерборда?
Да. Monsoon en-IN входит в основной английский рейтинг по умолчанию и влияет на Average WER. Размеры публичного и закрытого сплитов указаны в таблице сплитов.
Входит ли хинди в основной рейтинг лидерборда?
Хинди отображается в многоязычном представлении. Отсутствующие выбранные языки показываются как NA, а место в многоязычном рейтинге получают только модели с полным покрытием выбранных языков.
Можно ли скачать публичные наборы и самостоятельно посчитать score?
Да. В карточках en-IN и hi-IN есть примеры загрузки. Используйте агрегацию на уровне всего корпуса, а для lattice хинди — OIWER.
Почему для хинди не используется обычный WER?
Фиксированный эталон для хинди может штрафовать корректные варианты в деванагари, транслитерации латиницей, смешанной речи или написании составных слов. В lattice хранятся допустимые формы для каждого фрагмента транскрипции.
Означает ли меньший общий WER, что модель лучше работает во всех регионах Индии?
Нет. Официальный пример для en-IN показывает почти одинаковый общий WER, но разный разброс по регионам. Перед развёртыванием изучите поведение на подгруппах и протестируйте модель на репрезентативном аудио.
Практический вывод
Используйте en-IN для первичного отбора по общему score, hi-IN и OIWER — для сравнения хинди и многоязычных моделей, а региональный разброс — как сигнал риска, если он велик. После этого проверяйте финалиста на тех аудиозаписях, уровне шума, сценариях работы VAD и текстовых правилах, которые действительно используют ваши пользователи.