 AIREITER
Kimi K3.1 Pro от Moonshot выглядит одним из самых выгодных вариантов для программирования и агентных сценариев: контекст на 1 млн токенов, $2 за миллион входных токенов и $10 за миллион выходных. Судя по нагрузкам, о которых пользователи сообщали в неделю запуска, оплата API по факту обходилась заметно дешевле подписки за $39.
Что представляет собой Kimi K3.1 Pro
Kimi K3.1 Pro — первая модель Moonshot AI из линейки K3.1, выпущенная 23 октября 2026 года как дообученное продолжение Kimi K3. Moonshot называет её MoE-моделью класса 3T для длительных задач по разработке, работы с 3D- и CAD-инструментами, анализа финансовых документов и многошаговых агентов.
Контекстное окно составляет 1 048 576 токенов. Это общий лимит для входа, токенов рассуждений и ответа, а не 1 млн на вход плюс ещё 1 млн на выход. В продуктах Moonshot модель принимает текст, изображения и видео; через API она возвращает текст, код и вызовы инструментов, а визуальный результат создаёт внешнее ПО — например Blender, игровые движки или PDF-инструменты. Рассуждения включены всегда: параметр reasoning_effort предлагает уровни low, high и max, причём по умолчанию используется max.
Moonshot обещала открыть веса до 4 ноября, однако проверка TheQuery от 24 октября не подтвердила наличие скачиваемого чекпойнта или финальной лицензии. ArtificialWatch также указывал неизвестный статус лицензии. Пока чекпойнт и лицензия не опубликованы, стоит рассчитывать на hosted API.
Тарифы Kimi K3.1 Pro: обычный режим и Highspeed
В стандартном режиме Kimi K3.1 Pro на платформе Kimi API стоит $2 за миллион некешированных входных токенов и $10 за миллион выходных. Kimi K3.1 Pro Highspeed вдвое дороже по тарифицируемым токенам — $4 за вход и $20 за выход, — но чтение из кеша по-прежнему стоит $0.20. Такое же разделение $2/$10 и $4/$20 приводят ArtificialWatch и таблица цен AI/ML API.
| Операция (за 1 млн токенов) | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| Некешированный вход | $2.00 | $4.00 |
| Выход, включая рассуждения | $10.00 | $20.00 |
| Чтение кешированного входа | $0.20 | $0.20 |
| Запись в кеш на 5 минут | $2.00 | $4.00 |
| Запись в кеш на 1 час | $4.00 | $8.00 |
Важнее базовой цены здесь три детали. Во-первых, ставка не меняется с длиной контекста, а срок жизни кеша по умолчанию составляет пять минут. Если повторно использовать префикс промпта в этот период, миллион токенов будет стоить $0.20 вместо $2.00. Во-вторых, токены рассуждений оплачиваются по выходному тарифу: при max длинная агентная цепочка может сформировать основную часть счёта. В-третьих, API оплачивается отдельно от членства Kimi и подписок Kimi Code. Кроме того, TheQuery при проверке руководства по Batch API не обнаружил K3.1 Pro в списке, поэтому скидку за пакетную обработку заранее предполагать не стоит.
На фиксированном примере сумма невелика: 100 000 некешированных входных токенов ($0.20) и 10 000 выходных ($0.10) дают $0.30 без учёта записи в кеш, инструментов, повторных попыток и налогов.
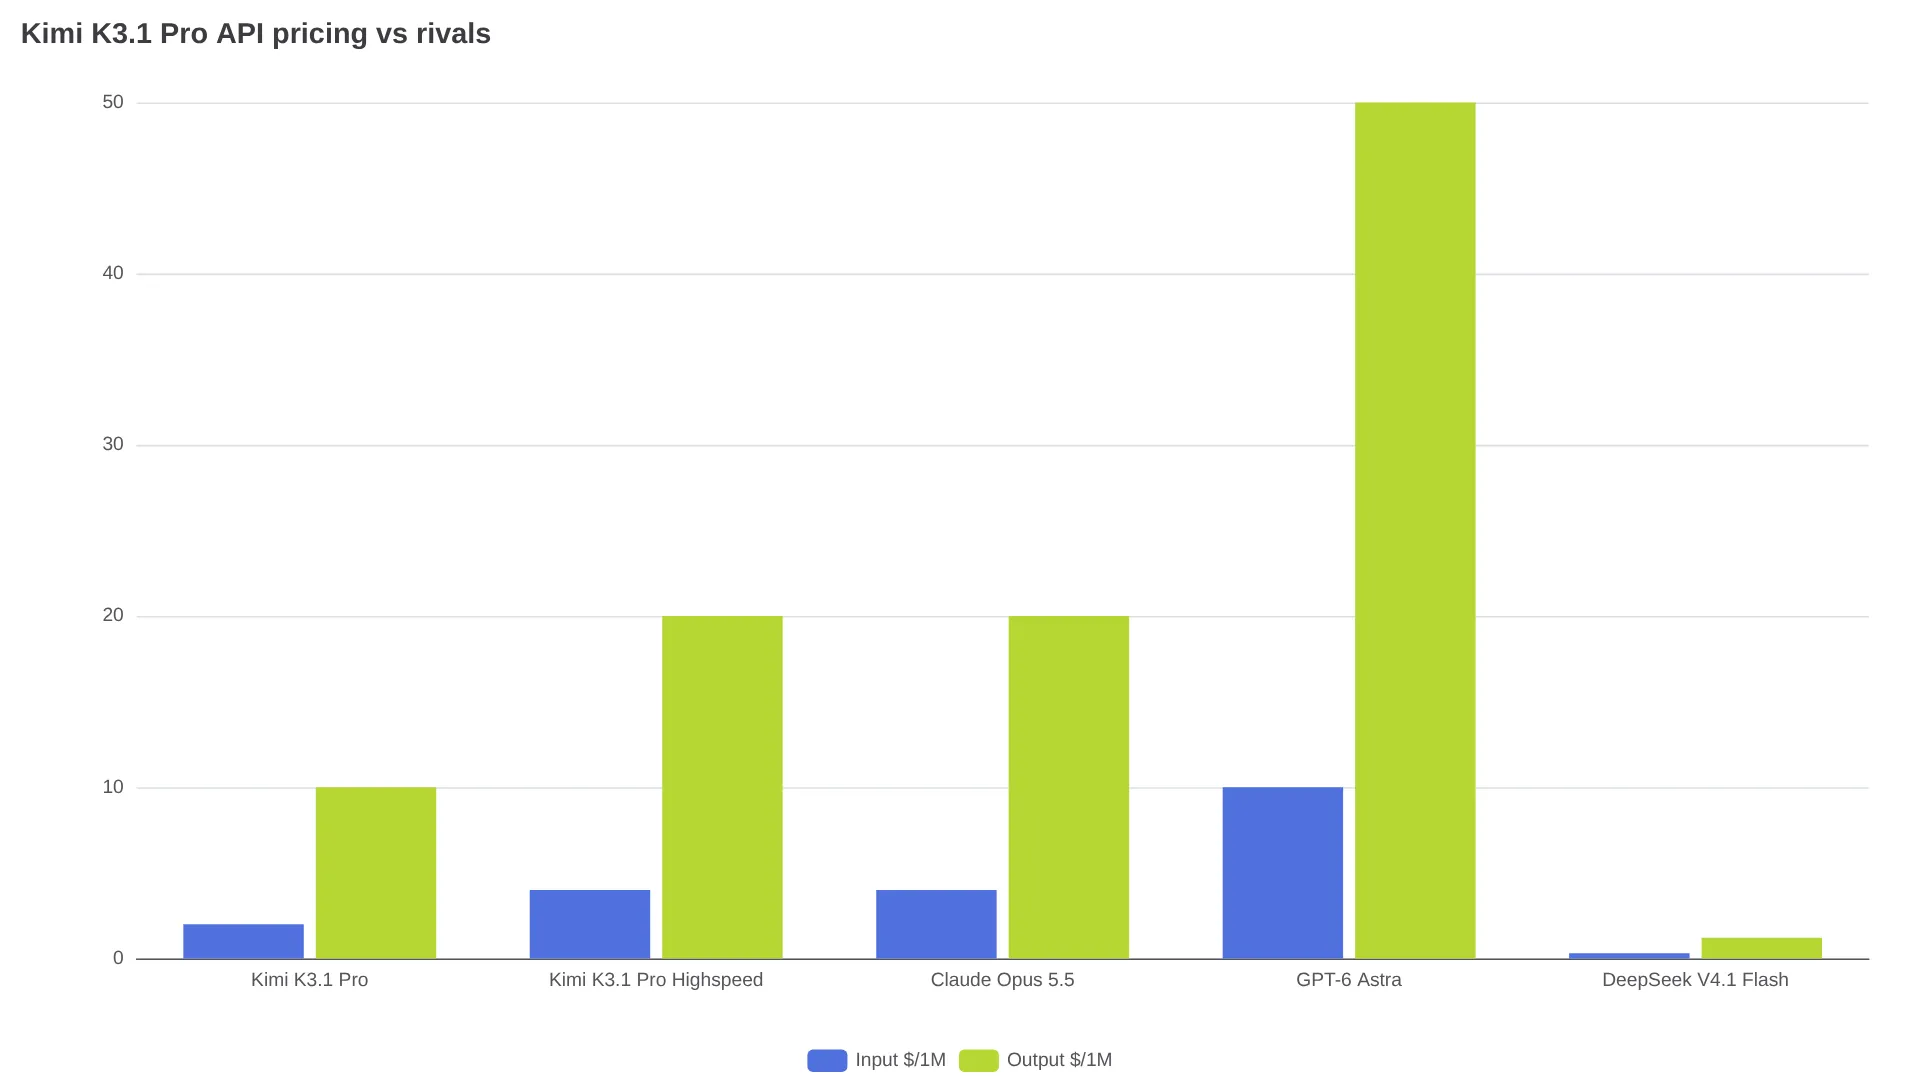
По сравнению с конкурентами стандартный K3.1 Pro на 33% дешевле Kimi K3 ($3/$15), вдвое дешевле Claude Opus 5.5 ($4/$20) и в пять раз дешевле GPT-6 Astra ($10/$50), согласно сравнению ArtificialWatch. DeepSeek V4.1 Flash дешевле всех перечисленных — $0.30/$1.20, по данным таблицы AI/ML API, — но в следующем разделе видно, что по бенчмаркам он заметно отстаёт. Highspeed в точности повторяет цены Opus 5.5, поэтому выбирать его имеет смысл лишь тогда, когда заявленное ускорение в 2–3 раза сокращает критичную к задержке задачу настолько, чтобы оправдать двукратную цену токенов.
Почему подписка за $39 быстро упирается в лимиты, а API — нет
В день запуска API выглядел адекватно по цене, чего нельзя сказать о подписке. Несколько платных пользователей сообщали, что их квота на 5 часов исчезала после одного-двух промптов, а месячный лимит мог уйти на единственную задачу по разработке.
"Kimi K3.1 Pro — лучшая открытая модель в мире прямо сейчас. Без вариантов. Но по собственной подписке ей практически невозможно пользоваться. У меня был план за $39. Я сделал ship test... и он съел 11.6% моей месячной квоты. То есть я могу собирать что-то подобное примерно 8 раз в месяц... Худшая подписка из всех... Узкое место не в качестве, а в вычислениях." — @Da7_Tech, пользовательский отчёт о расходе квоты
"Совершенно отвратительные и позорные лимиты использования Kimi K3.1 Pro. Мой лимит на 5 часов был ИСЧЕРПАН ровно через 1 минуту после начала промпта, а ничего так и не было создано!" — @MiaAI_lab, подписчик плана за $39
Один пользователь рассказал, что потратил $400 на подписки ради четырёх промптов, и оценил ту же работу в $29 через API. Другой сообщил, что одна задача по анимации съела большую часть 5-часовой квоты. Для разработчиков вывод прямой: K3.1 Pro стоит оценивать через API с оплатой по мере использования — Moonshot, OpenRouter, Vercel AI Gateway. Там 100 тыс. входных и 10 тыс. выходных токенов стоят $0.30 без повторов и инструментов, а не расходуют подписочную квоту, которая гораздо жёстче учитывает те же рассуждения.
Бенчмарки: важные оговорки к цифрам
Все ключевые результаты ниже, если не указано иное, заявлены самой Moonshot. Тесты запускались с максимальным уровнем рассуждений, temperature 1.0 и top-p 0.95. Небольшие разрывы зависят от конкретной конфигурации: результаты конкурентов собирались разными наборами инструментов — Kimi Code для Kimi, Claude Code для других моделей и Codex для GPT-6 Astra в OfficeQA, — как отмечает AI/ML API.
| Тест | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek V4.1 Flash 1017 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | 51.7% | 46.3% | 42.5% | 40.0% |
| Agents' Last Exam v1.1 | 43.2% | 42.6% | 32.8% | 37.7% |
| OfficeQA Pro v2 | 64.4% | 62.2% | 54.4% | 40.4% |
| BenchCAD с инструментами | 92.7% | 96.2% | 95.9% | 81.6% |
Kimi лидирует в трёх тестах из пяти, а в Terminal-Bench уступает 0.7 пункта. Как отмечает TheQuery, этот разрыв меньше, чем заявленная Anthropic стандартная ошибка Opus в 2.6 пункта. Результат BenchCAD в 92.7% — это пересечение вокселей на открытой подвыборке из 1 000 случаев; показатели Claude взяты из system card, а не получены единым повторным прогоном — это следует из методологических примечаний AI/ML API.
По фактической точности внутренний Kimi Hallu Bench от Moonshot показывает для K3.1 Pro 5.4% ошибок на уровне утверждений на стандартном наборе против 4.2% у GPT-6 Astra, а на наборе Hard with-tools — 8.3% против 5.5%, согласно таблице Hallu от AI/ML API. Относительно 23.4% K3 на сложном наборе это снижение на 65%, но Astra по-прежнему лидирует в обеих выборках. Если один ошибочный факт полностью портит результат, Astra стоит оставить в шорт-листе. Все эти тесты — стрессовые состязания, а не оценка повседневной вероятности ошибки.
Единственную независимую точку данных на момент запуска предоставил Artificial Analysis: K3.1 Pro получила 55 баллов в Intelligence Index и заняла #4 в общем зачёте, уступив Claude Opus 5.5, Sonnet 5.5 и Muse Wonder Full. Это подтверждает тезис о качестве, близком к переднему краю, за половину цены без опоры исключительно на замеры производителя.
Как подключить модель и не переплачивать
Kimi K3.1 Pro совместима с OpenAI API, поэтому для миграции достаточно сменить base URL и идентификатор модели. Официальный адрес — https://api.moonshot.ai/v1, идентификаторы моделей — kimi-k3.1-pro и kimi-k3.1-pro-highspeed. Это подтверждают проверка эндпоинтов TheQuery и руководство по настройке AI/ML API. У сторонних шлюзов используются ID с пространством имён: например, moonshot/kimi-k3.1-pro на Requesty или moonshotai/kimi-k3.1-pro на Vercel.
В quickstart настройки генерации зафиксированы на temperature 1.0 и top-p 0.95; вместо подбора значений рекомендуется просто не передавать их, согласно заметкам TheQuery о поведении API. Управлять расходами лучше через reasoning_effort: начинайте проверочные запросы с low, переходите на high, если задача не решилась, а max — значение по умолчанию — оставляйте для финального запуска. Бюджет max_completion_tokens в 8 192 токена может дать гораздо более короткий видимый ответ, поскольку скрытые рассуждения расходуют тот же лимит по ставке $10 за миллион.
Чек-лист контроля расходов по рекомендациям AI/ML API по инструментам и токенам:
- Сохраняйте полное сообщение ассистента между шагами с инструментами, включая
reasoning_contentпри стриминге, и возвращайте результаты инструментов перед следующим вызовом. - Повторно используйте префиксы промптов в пределах 5-минутного окна кеша, чтобы снизить цену повторного входа до $0.20 за миллион.
- Считайте стоимость принятого результата, а не отдельного токена.
- Модель с меньшей ценой за токен не будет дешевле, если ей приходится делать две повторные попытки.
from openai import OpenAI
client = OpenAI(
    base_url="https://api.moonshot.ai/v1",
    api_key="YOUR_KIMI_KEY",
)
resp = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Refactor this module with tests"}],
    extra_body={"reasoning_effort": "low"},
    max_completion_tokens=8192,
)
print(resp.choices[0].message.content)
Пополнение на $1 открывает доступ с учётом многоуровневых лимитов скорости, а корпоративный доступ по умолчанию выключен и требует активации администратором — согласно проверке поведения API от TheQuery. Что касается приватности, аудит маршрута Moonshot от Opper сообщает, что контент сохраняется, а данные клиентов по умолчанию используются для обучения; опция нулевого хранения данных на этом маршруте отсутствует. Не отправляйте через него конфиденциальные или регулируемые данные без договорных гарантий.
Стоит ли использовать: какой компромисс учитывать
| Если вам нужно | Выбор | Почему |
|---|---|---|
| Самые дешёвые запуски для программирования уровня frontier | Kimi K3.1 Pro API | Лидер SWE-Marathon за половину цены Opus, общий контекст 1 млн токенов |
| Минимальная задержка | Kimi K3.1 Pro Highspeed | Заявленное ускорение 2–3 раза, но цена токенов ровно в 2 раза выше |
| Минимум фактических ошибок | GPT-6 Astra | 4.2% против 5.4% в стандартном Hallu, но в 5 раз дороже |
| Самые дешёвые токены при более слабых результатах | DeepSeek V4.1 Flash | $0.30/$1.20, но худший результат в четырёх из пяти перечисленных бенчмарков |
| Самостоятельный хостинг | Подождать | Веса обещаны до 4 ноября, лицензия неизвестна |
Если Moonshot опубликует полные веса под разрешающей лицензией до 4 ноября, самостоятельный хостинг может изменить соотношение между квотами и API. Разработчикам, которые сравнивают модели для программирования с длинным контекстом, перед окончательным выбором также стоит посмотреть рейтинг best LLM for coding agents in 2026.
FAQ по API Kimi K3.1 Pro
Сколько стоит API Kimi K3.1 Pro?
Стандартный Kimi K3.1 Pro стоит $2 за миллион некешированных входных токенов и $10 за миллион выходных; чтение кешированного входа обходится в $0.20 за миллион. Highspeed удваивает ставки за вход, выход и запись в кеш, сохраняя цену чтения из кеша на уровне $0.20.
Чем K3.1 Pro отличается от Highspeed?
Highspeed обещает тот же уровень интеллекта при скорости обслуживания в 2–3 раза выше, но за двойную цену входа и выхода ($4/$20 вместо $2/$10). В актуальной таблице провайдера Vercel для Highspeed указаны меньшая задержка и более высокая пропускная способность, однако независимого сравнения скорости завершения задач для заявления Moonshot пока нет.
Какие ID моделей используются в API?
В официальном Kimi API используйте kimi-k3.1-pro и kimi-k3.1-pro-highspeed, а в сторонних шлюзах — варианты с пространством имён, например moonshot/kimi-k3.1-pro. Существующие интеграции K3 должны явно сменить ID модели.
Входит ли API в подписку Kimi?
Нет. API оплачивается отдельно от членства Kimi и подписок Kimi Code; пользователи в неделю запуска обнаружили, что подписочные квоты для той же работы ограничивают их гораздо сильнее, чем токены с оплатой по факту.
Можно ли отключить рассуждения?
Нет. Kimi K3.1 Pro всегда использует рассуждения; low, high и max лишь меняют их интенсивность, а по умолчанию используется max. Для коротких запросов без рассуждений нужна другая модель.
Совместим ли API с OpenAI?
Да. Направьте клиент OpenAI SDK на https://api.moonshot.ai/v1 или base URL шлюза, задайте ID модели и включите стриминг через stream=True. В quickstart зафиксированы temperature 1.0 и top-p 0.95. Вместо них настраивайте reasoning_effort и max_completion_tokens.