 AIREITER
Open weights MiniMax M3.1 Flash вышли 23 октября 2026 года. Но за громкими анонсами легко упустить главное: это скачиваемый чекпойнт на 428B параметров, который почти наверняка не стоит пытаться запускать на одной GPU. Репозиторий MiniMaxAI/MiniMax-M3.1-Flash содержит около 252 ГБ данных в 48 частях и доступен без запроса на одобрение. При этом MiniMax Community License разрешает коммерческое использование лишь при соблюдении условий: указании авторства, однократном уведомлении и предварительном разрешении MiniMax при годовой выручке свыше $20M.
Главное о чекпойнте на 252 ГБ
MiniMax M3.1 Flash — нативная мультимодальная MoE-модель: всего около 428 млрд параметров, но на каждый токен активируется примерно 23 млрд. На вход она принимает текст, изображения и видео, генерирует текст и работает с контекстом до 1,000,000 токенов. В модели используется MiniMax Sparse Attention, а также поставляется draft head для спекулятивного декодирования DSpark. Веса уже можно скачать с Hugging Face или через зеркало ModelScope. Важно не путать термины: Flash здесь означает экономику инференса, а не компактный размер; open weights — не то же самое, что open source.
| Параметр | Проверенное значение |
|---|---|
| Всего / активно параметров | ~428B всего, ~23B на токен |
| Контекстное окно | До 1,000,000 токенов |
| Входы / выход | Текст, изображения, видео на входе; текст на выходе |
| Размер чекпойнта | ~252 ГБ, 48 частей safetensors + DSpark draft head |
| Квантизация | Конфигурация MXFP8; NVFP4 для маршрутизируемого MoE-пути |
| Настройки инференса | Temperature 1.0, top-p 0.95, reasoning_effort low / medium / high / xhigh / max |
| Рецепты для сервинга | SGLang, vLLM, TokenSpeed; FlagOS для multi-chip |
| Цена API | $0.15 за вход / $0.60 за выход / $0.015 за кэш на 1M токенов |
| Измеренная стоимость задачи | ~$0.22 за агентную задачу (Artificial Analysis via TPS Report) |
| Лицензия | MiniMax Community License; коммерческое использование ограничено условиями |
Модель подходит командам, у которых уже есть multi-GPU-инфраструктура, а также агентным сценариям, где API по $0.15/$0.60 выгоднее текущих расходов. Для ноутбука или одной потребительской GPU она не подходит — как и для коммерческого продукта, который не может разместить обязательную строку атрибуции. Мой вывод: сначала используйте API, а к self-hosting переходите, только если объём запросов или требования к контролю данных оправдывают железо.
Где скачать официальные веса и что проверить
Официальный чекпойнт опубликован на Hugging Face в MiniMaxAI/MiniMax-M3.1-Flash. В посте MiniMax от 23 октября даны ссылки на загрузку с Hugging Face и ModelScope. По данным анализа релиза весов от alfw.ai, объём поставки составляет около 252 ГБ, а скачивание не требует approval gate: 48 частей весов, отдельный DSpark draft head, токенайзер и конфигурационные файлы.
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash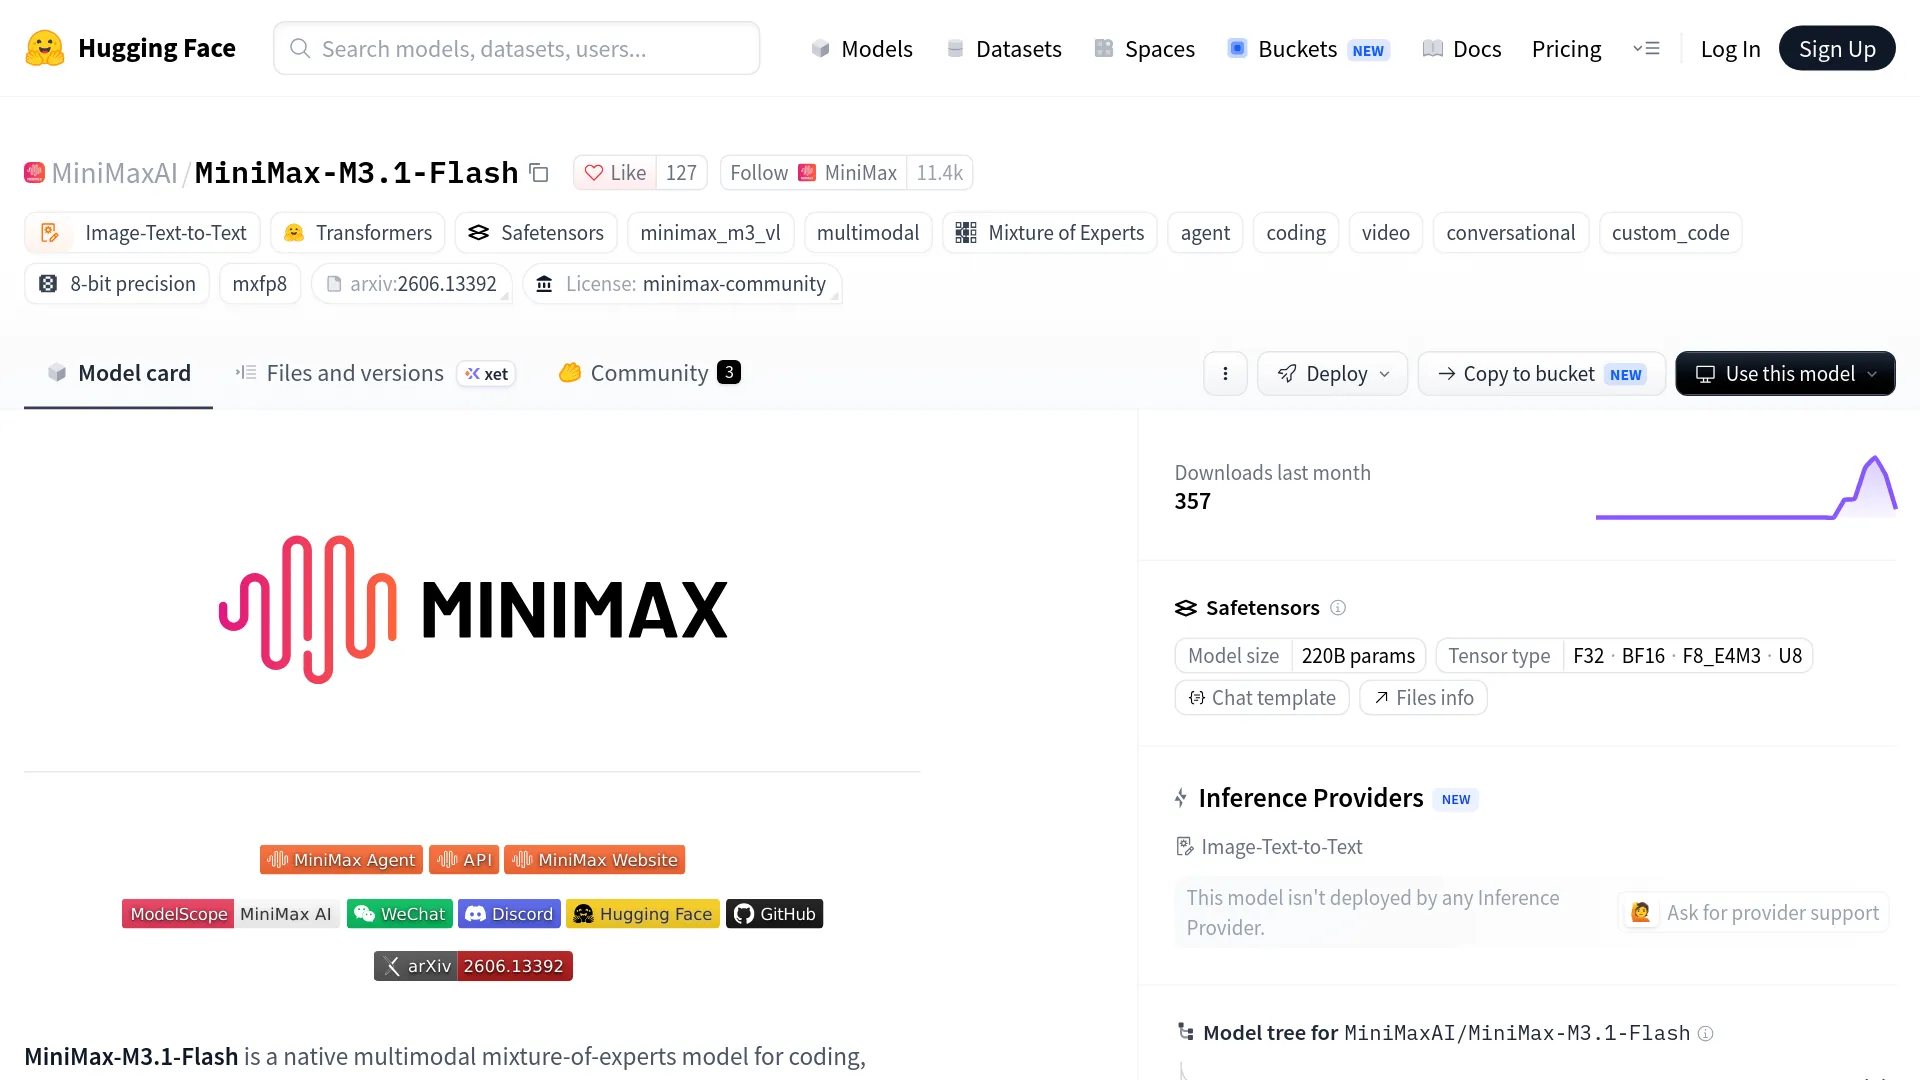
Прежде чем планировать закупку железа, проверьте на странице репозитория три пункта. Во-первых, в списке должны быть все 48 частей и draft head, а не неполное зеркало. Во-вторых, поле лицензии должно содержать minimax-community, а не MIT или Apache; не ориентируйтесь на устаревшие pre-release-метки на сайтах-агрегаторах. В-третьих, учитывайте предупреждение из model card: опубликованные результаты относятся к официальным весам, а сторонние квантизации могут вести себя иначе. Поэтому любую EXL3-версию или репак, появившийся на этой неделе, стоит считать непроверенным, пока автор не укажет базовый commit.
Потянет ли self-hosting: сначала считаем память
Тот факт, что на токен активируется лишь 23B параметров, не делает модель на 428B меньше. Именно здесь ошибается большинство обсуждений в духе «запущу ли я её локально». Число активных параметров определяет стоимость инференса на токен, а общий объём параметров — сколько данных нужно хранить и держать в памяти. При BF16 428 млрд параметров по 2 байта дают примерно 856 ГБ одних только весов. Типичное 4-битное представление потребовало бы около 214 ГБ. Реальный репозиторий на 252 ГБ отражает обученную квантизированную раскладку, а также файлы токенайзера, конфигурации и draft head — ещё до runtime-буферов и KV-кэша.
«MiniMax-M3.1-Flash open weights are now LIVE 🔥🔥 428B params, 23B active.» — @MiaAI_lab, отмечая загрузку объёмом ~252 ГБ вместе с рецептом TensorFold и работой над квантизацией EXL3
Порог по железу высок даже для команд. Как отмечает @perry_weijie, на личных машинах модель практически не запустить, а самостоятельная сборка имеет смысл для команд со свободными видеокартами. В одном из найденных мной замеров первого дня, TP4 на 4x DGX Spark от @majewskizby, сообщалось примерно о 39.7 tok/s при генерации обычного текста и 62.2 tok/s для структурированного вывода при контексте 262K, с путями NVFP4/MXFP8 и Triton sparse attention. Это практический замер первого дня, а не слайд вендора, но и он предполагает совместную работу четырёх высокопроизводительных узлов.
Реалистичные варианты запуска — от более простого к более трудоёмкому:
- SGLang — по связанному cookbook, включая Docker-схему из model card:
--shm-size 32g, порт 30000 и подключение HF-кэша. - vLLM — по связанному рецепту, где пример из card использует
vllm serveна порту 8000. - TokenSpeed — отдельный рецепт для пути, ориентированного на эффективность.
- FlagOS — для multi-chip-развёртывания.
Есть две типичные проблемы конфигурации. По умолчанию reasoning effort выставлен на максимум: если не менять параметр в диапазоне от low до max, вы без нужды увеличите задержку и счёт. В независимых заметках по настройке на minimax-m31flash.org перечислены и классические ошибки интеграции агентов: неверный суффикс модели для длинного контекста, переменные окружения, перекрывающие config-файлы, устаревшие минимальные версии Codex и снятые с использования имена preview-моделей. Интеграции с Transformers, KTransformers, unsloth и ATOM на момент выхода в card были помечены как находящиеся в работе — уточняйте статус, прежде чем строить планы вокруг них. alfw.ai указывает заявленную совместимость с 10 производителями чипов и шестью облаками, но считайте это лишь анонсами совместимости, пока модель не появится в каталоге провайдера, которому вы платите.
API или self-hosting: решение по стоимости задачи
Опираться только на цену токенов неправильно: в агентных задачах большую роль играют reasoning-токены и работа кэша. Базовая цена API MiniMax — $0.15 за миллион входных токенов, $0.60 за миллион выходных и $0.015 за кэшированный вход. На длинном контексте нет дополнительной ступени цены — в отличие от MiniMax M3, у которого тариф удваивается после 512K входных токенов, согласно minimax-m31flash.org. Artificial Analysis измерил около $0.22 на задачу для M3.1 Flash против $0.26 у DeepSeek V4.1 Flash 1017 в том же наборе: 189M против 224M выходных токенов соответственно. Это примерно 15% преимущества по цене задачи, достигнутого за счёт более эффективного reasoning, а не простого снижения тарифов.
| Вариант | Кому подходит | На что обратить внимание |
|---|---|---|
MiniMax API (api.minimax.io, совместим с Anthropic/OpenAI по данным minimax-m31flash.org) | Агенты для программирования, переменная нагрузка, задачи с контекстом 1M без собственного железа | Максимальный reasoning effort по умолчанию; итоговый счёт определяют кэширование и настройки service tier |
| Подписка M Plan (тарифы Go / Explore / Build по данным minimax-m31flash.org) | Предсказуемое использование coding assistant внутри MiniMax Code | Лимиты по окнам, а не обычный месячный пакет токенов; перед планированием проверьте цены в долларах |
| Self-host (SGLang / vLLM / TokenSpeed, FlagOS multi-chip) | Высокая постоянная нагрузка, потребность в контроле данных, база для fine-tuning | Загрузка на 252 ГБ, память нескольких GPU плюс KV-кэш на длинном контексте, нет подтверждённой минимальной спецификации |
До скачивания посчитайте экономику для своей нагрузки: умножьте месячный объём входа и выхода на $0.15/$0.60 с учётом реального cache-hit rate, затем сравните результат со стоимостью зарезервированных GPU и инженерного времени. В большинстве сценариев без стабильно высокой нагрузки API оказывается выгоднее. Self-hosting начинает выигрывать, когда месячные траты на API превышают амортизированную стоимость кластера либо веса должны оставаться внутри вашего контура.
Бенчмарки: отделяем результаты вендора от независимых
| Бенчмарк | M3.1 Flash | Лучший конкурент в приведённой таблице | Источник |
|---|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | 60.5 DeepSeek V4.1 Flash-1017 | MiniMax card (вендор) |
| BankerToolBench | 76.2 | 76.2 Opus 5 (ничья) | MiniMax card (вендор) |
| LOCA-Bench 256K | 60.3 | 60.0 GPT-5.6 Sol | MiniMax card (вендор) |
| OSWorld 2.0 | 61.7 | 70.6 Opus 5 | MiniMax card (вендор) |
| CyberGym | 82.2 | 84.5 GLM-5.3 | MiniMax card (вендор) |
| DeepSWE v1.1 | 73.7 | 77.0 DeepSeek V4.1 Flash-1017 | MiniMax card (вендор) |
| Vals Index | 53.78% (16-е место из 26) | MiMo V2.6 Flash 54.83% (на момент запуска) | Vals AI (независимый) |
| Intelligence Index | 42 | 45 DeepSeek V4.1 Flash 1017 | Artificial Analysis via TPS Report (независимый) |
| LMArena WebDev | 1587.48 | ranked field | VectorWire (единственный из 10 независимо подтверждённый показатель) |
В MiniMax card для каждого бенчмарка описаны используемые harness: например, BankerToolBench запускался на OpenCode 1.17.18 с MiniMax-M2.7 в роли judge, а CyberGym — на Claude Code 2.1.263 при контексте 1M. Это прозрачнее большинства анонсов, однако сами результаты по-прежнему сообщает вендор. Независимые оценки более сдержанны: Vals AI фиксирует рост на 26.37 пункта в Vibe Code Bench относительно M3, но указывает на слабость в длинных траекториях — Terminal-Bench 25.25%, HLAB-Vals 7.50% в их harness. Artificial Analysis сочетает сильную точность omniscience в 56% с уровнем галлюцинаций 93% в этом бенчмарке. А VectorWire считает доказательств недостаточно, чтобы ранжировать любую способность модели. Такой уровень галлюцинаций — веская причина добавить проверку в RAG, комплаенс-сценариях и ответах клиентам.
Лицензия: что нужно для коммерческого использования
Веса можно скачать, но MiniMax Community License не является неограниченной open-source-лицензией. Базовый grant сформулирован для некоммерческого использования; коммерческое разрешено только при соблюдении условий. Продукты и сервисы должны заметно показывать фразу «Built with MiniMax M3.1-Flash», пользователь обязан однократно уведомить MiniMax, а для всего, что генерирует более $20M годовой выручки, требуется предварительное письменное разрешение MiniMax. Коммерческое использование определено достаточно широко и включает платный хостинговый доступ, API моделей, fine-tunes и модифицированные производные. Запрещены военное применение и намеренная генерация вредоносной ложной или вводящей в заблуждение информации. В анализе лицензии alfw.ai не найдено территориальных ограничений для этой модели, но это вывод стороннего автора, а не FAQ от MiniMax. Перед релизом продукта стоит подтвердить трактовку с юристами. Классификация проста: open weights, но не open source.
FAQ
Веса MiniMax M3.1 Flash действительно можно скачать?
Да. Репозиторий MiniMaxAI/MiniMax-M3.1-Flash появился на Hugging Face 23 октября 2026 года: около 252 ГБ файлов, без approval gate, плюс зеркало на ModelScope.
Какой официальный репозиторий на Hugging Face?
MiniMaxAI/MiniMax-M3.1-Flash: 48 частей safetensors, DSpark draft head, токенайзер и конфигурация, лицензия с меткой minimax-community. Используйте команду hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash.
Можно ли использовать M3.1 Flash коммерчески?
Да, но с условиями. Разместите «Built with MiniMax M3.1-Flash», отправьте однократное уведомление и получите предварительное письменное разрешение при годовой выручке свыше $20M. Fine-tunes и хостинговые API считаются коммерческим использованием.
Запустится ли модель на потребительской GPU или Apple Silicon?
Нет подтверждённого запуска на одной потребительской GPU или Apple Silicon: полный чекпойнт занимает ~252 ГБ, а расчёт для BF16 даёт ~856 ГБ только под веса, что исключает обычные конфигурации GPU-памяти. Ориентируйтесь на multi-GPU-серверы или облачного провайдера; приведённый здесь замер первого дня использовал 4x DGX Spark.
Работает ли она с vLLM, SGLang или TokenSpeed?
Да, через официальные рецепты, на которые ссылается model card. Рекомендуемые пути — SGLang и vLLM, TokenSpeed указан третьим рецептом. Для multi-chip-развёртывания есть FlagOS. Интеграции семейства Transformers на момент релиза ещё находились в работе.
Как она выглядит на фоне DeepSeek V4.1 Flash?
Она дешевле на задачу (~$0.22 против ~$0.26 в наборе AA) и показала более сильные HLE и omniscience accuracy в этом срезе, но уступает по совокупному Intelligence Index (42 против 45) и DeepSWE (73.7 против 77.0 у сборки 1017). Для экономичных агентных задач программирования стоит прогнать пакет своих задач; если критичны сводный индекс и DeepSWE, проверьте DeepSeek на собственных сценариях. Следующий шаг: запустите один платный пакет API-задач, сменив reasoning effort с максимального значения по умолчанию на нужное вам, и только затем решайте, стоит ли скачивать веса.