 AIREITER
Если self-hosted-чекпойнт нужен уже на этой неделе, выбора между этими двумя моделями фактически нет: веса MiniMax M3.1 Flash можно скачать сегодня, а Kimi K3.1 Pro — пока нельзя. Moonshot обещает опубликовать их до 4 ноября 2026 года, поэтому сейчас с Hugging Face можно забрать только MiniMax.
На Hugging Face сейчас доступна только одна модель
MiniMax опубликовала веса M3.1 Flash примерно 22–23 октября 2026 года на Hugging Face по лицензии minimax-community. В материалах о запуске также сообщалось о доступности на ModelScope (Cocoloop). В официальном техническом блоге Kimi указано, что Kimi K3.1 Pro уже доступна через Kimi.com, приложения, Kimi Code и Kimi API, а полные веса модели появятся до 4 ноября 2026 года (kimi.com).
MiniMax M3.1 Flash и Kimi K3.1 Pro: ключевые различия
Открытые веса MiniMax M3.1 Flash — это нативная мультимодальная MoE-модель примерно с 428 млрд общих параметров и 23 млрд активных на токен. Она принимает текст, изображения и видео, генерирует текст и поддерживает контекст до 1 млн токенов (пост MiniMax о запуске). Kimi K3.1 Pro официально описывается как MoE-модель класса 3T с контекстным окном в 1 млн токенов (kimi.com). Числа 2.8T общих и 104B активных параметров приводят публикации о запуске (ArtificialWatch, ExplainX), а не собственное раскрытие параметров Moonshot.
| Параметр | MiniMax M3.1 Flash | Kimi K3.1 Pro |
|---|---|---|
| Общие / активные параметры | ~428B / 23B на токен | Класс 3T; в публикациях о запуске — 2.8T / 104B активных |
| Репозиторий на Hugging Face | MiniMaxAI/MiniMax-M3.1-Flash, доступен | Отсутствует по состоянию на 24 октября 2026 года; ожидается до 4 ноября |
| Размер загрузки | Примерно 252 ГБ | Неизвестен; при плотности MiniMax (~0.59 ГБ на B параметров) чекпойнт на 2.8T будет измеряться терабайтами |
| Контекст | До 1 млн токенов, зависит от развёртывания | 1 млн токенов |
| Входы / выход | Текст, изображения, видео на входе; текст на выходе | Мультимодальная модель, текстовый выход; точные модальности для self-hosting не подтверждены |
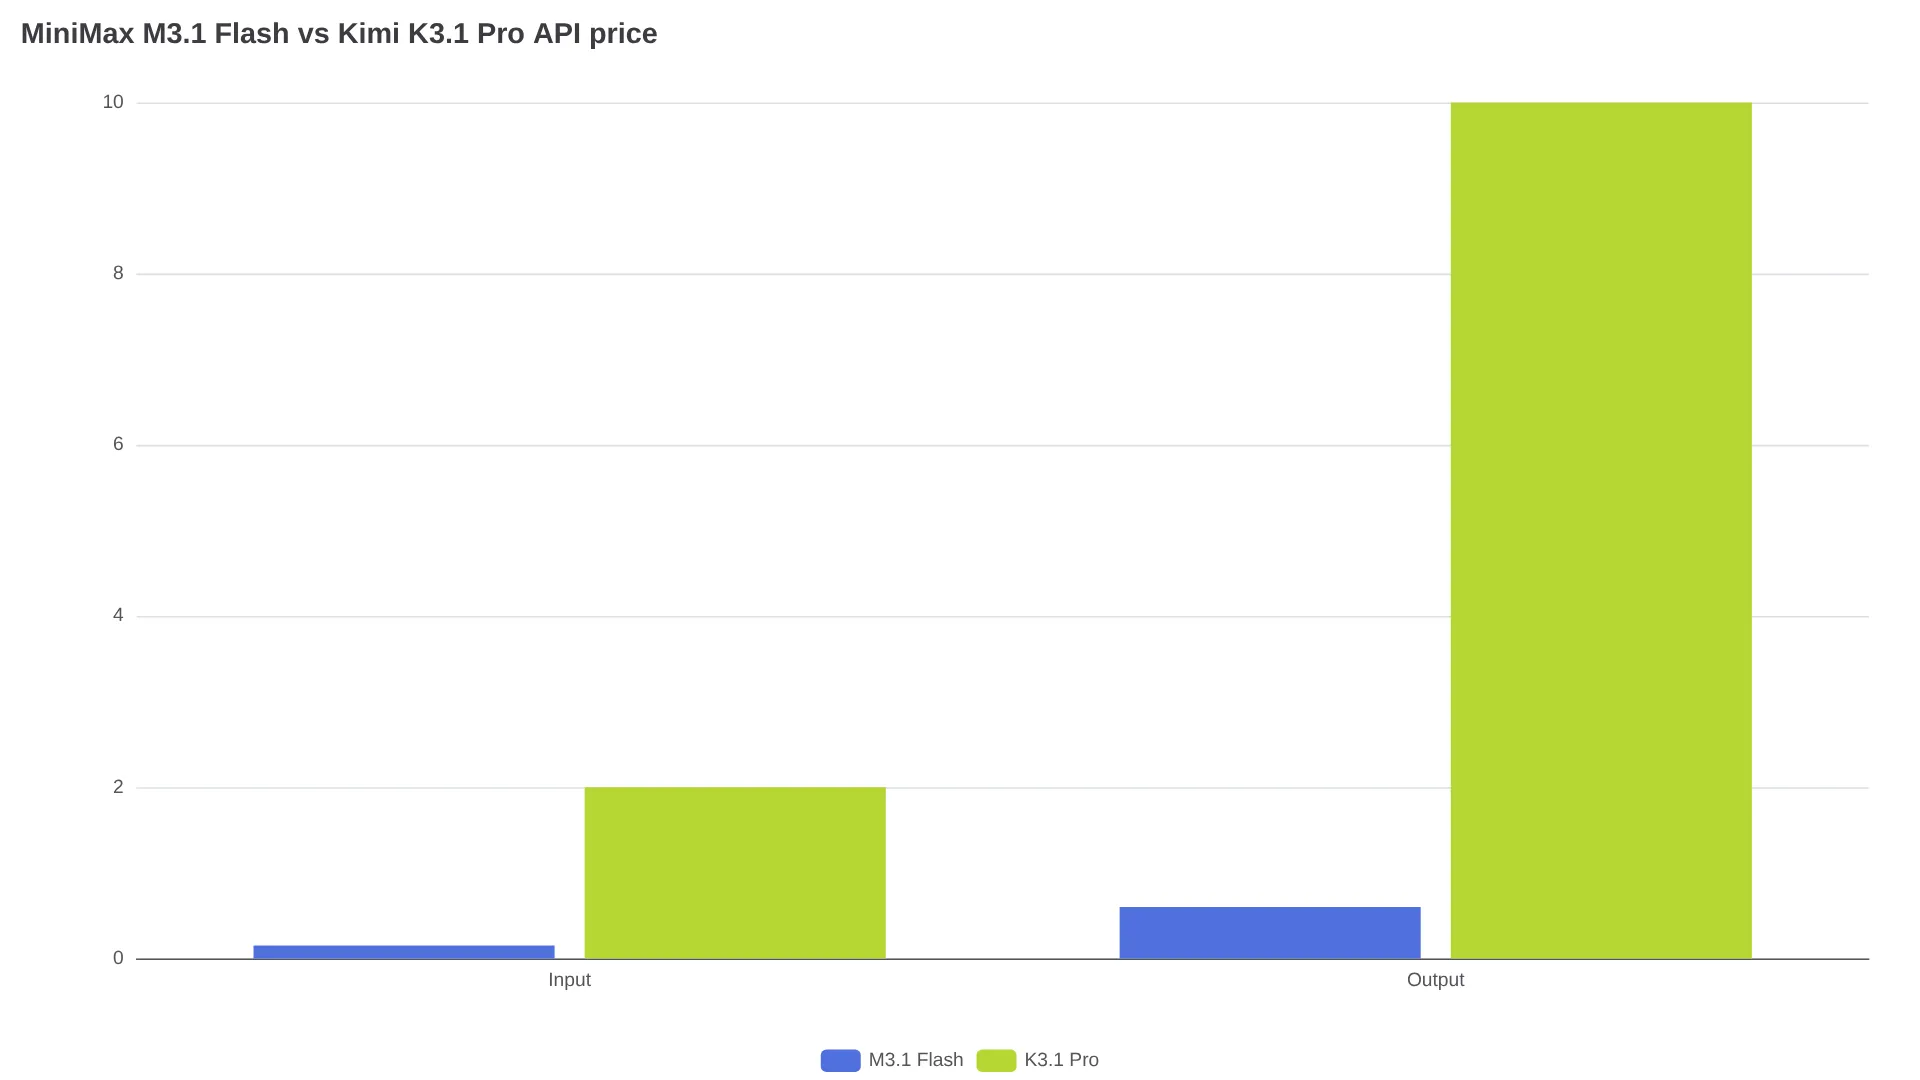
| Официальная цена API | $0.15 за вход / $0.60 за выход / $0.015 за кэшированные токены на 1 млн токенов (MiniMax) | Сообщается о $2 за вход / $10 за выход на 1 млн токенов (ArtificialWatch) |
| Рецепты для инференса | SGLang, vLLM, TokenSpeed; FlagOS для нескольких чипов | Не анонсированы; ID API-моделей — kimi-k3.1-pro / kimi-k3.1-pro-highspeed (документация Kimi) |
| Рекомендуемые параметры семплирования | Temperature 1.0, top-p 0.95; reasoning low–max | Максимальный reasoning effort, temp 1.0, top-p 0.95 по конфигурации бенчмарков Kimi |
Скачать чекпойнт MiniMax можно официальной командой:
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-FlashПеред бенчмарками проверьте, что загружен полный набор файлов: включая черновую голову DSpark, токенизатор и конфигурации. MiniMax предупреждает, что результаты относятся к официальным весам, а сторонние квантизации могут вести себя иначе.
В бенчмарках все приведённые ниже результаты стоит считать данными вендора, если не указано обратное:
| Бенчмарк | M3.1 Flash (вендор) | Конкурент, указанный вендором |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | DeepSeek V4.1 Flash-1017: 60.5 |
| BankerToolBench | 76.2 | Opus 5: 76.2 (ничья) |
| LOCA-Bench 256K | 60.3 | GPT-5.6 Sol: 60.0 |
| DeepSWE v1.1 | 73.7 | DeepSeek V4.1 Flash-1017: 77.0 |
| OSWorld 2.0 | 61.7 | Opus 5: 70.6 |
| Terminal-Bench 4.0 | 38.1 | Opus 5: 51.8 |
В одном независимом срезе M3.1 Flash находится в середине таблицы: 53.78% и 16-е место из 26, с низкими результатами на долгих задачах (Vals). На собственном графике Kimi заявляет лидерство K3.1 Pro в 6 из 14 показанных тестов, в том числе Agents' Last Exam (43.2) и SWE Marathon (51.7); результат в Terminal-Bench 4.0 составляет 65.7.
Во что обойдётся хостинг загрузки на 252 ГБ
Размер репозитория — около 252 ГБ. При 4 битах на вес одни только 428B параметров занимают примерно 214 ГБ, ещё до KV-кэша и буферов рантайма. Для рабочего контекста стоит рассчитывать на несколько GPU класса 80 ГБ. В аккаунте NVIDIA RTX Spark для локального запуска упоминаются DGX Station либо кластер из 4x DGX Spark 128 GB (пост в X), а self-хостеры в X отмечают, что загрузка на 252 ГБ и такие требования к железу исключают обычные десктопы, тогда как API остаётся дешёвым (@bufcapy).
Сначала посчитайте вариант с API: у MiniMax он необычно недорогой. При $0.15 за вход и $0.60 за выход на 1 млн токенов день с 10 млн входных и 2 млн выходных токенов обойдётся в 10 × $0.15 + 2 × $0.60 = $2.70, или примерно $81 в месяц.
Точка безубыточности считается как месячная стоимость кластера, делённая на стоимость API на токен. При $0.15 за 1 млн входных токенов каждые $150 в месяц аренды эквивалентны 1B входных токенов; при $0.60 за 1 млн выходных токенов каждые $600 соответствуют 1B выходных токенов. Подставьте свою цену аренды и время инженеров: self-hosting выгоден, только когда ежемесячный счёт за API по этим ставкам превышает итоговую сумму либо когда политика требует держать веса внутри вашего контура. У Kimi разрыв ещё заметнее: заявленная цена API в $2/$10 за 1 млн токенов примерно в 13 раз выше MiniMax по входу и примерно в 17 раз по выходу. Поэтому будущему чекпойнту на 2.8T параметров потребуется очень высокий стабильный поток запросов, чтобы оправдать терабайтное хранилище и многонодовый кластер.
Что реально доступно при self-hosting с первого дня
Поддержка фреймворков в день релиза есть, но она неполная. В карточке модели названы SGLang, vLLM и TokenSpeed, а для запуска на нескольких чипах — FlagOS; для SGLang доступны Docker-образы. Интеграции с Transformers, KTransformers, unsloth и ATOM на момент релиза ещё находились в разработке. Один из специалистов по развёртыванию отметил, что пример конфигурации vLLM для H100/H200 рассчитан на 256K токенов, а не на полный 1M, отключает видео и не включает спекулятивное декодирование DSpark (@sancaksofttech). Чекпойнт один и тот же, но разные конфигурации раскрывают не все его возможности.
В r/LocalLLaMA регулярно всплывает один и тот же вопрос: «Flash» говорит об экономике инференса, а не о компактном размере модели.
С квантизацией она поместится в 256GB? Молюсь — u/BawbbySmith на r/LocalLLaMA
Лицензия может оказаться важнее железа
M3.1 Flash — это открытые веса, а не open source. Файл LICENSE в репозитории, помеченный как minimax-community (см. файл LICENSE), свободно разрешает некоммерческое использование. Для коммерческого применения нужно заметно разместить надпись «Built with MiniMax M3.1-Flash» и один раз уведомить MiniMax. Организациям или продуктам с годовой выручкой выше $20M требуется предварительное письменное разрешение; военное применение запрещено.
Для внутренних инструментов эти условия не слишком обременительны, но для коммерческого хостинга могут стать блокером: именно там сложнее всего соблюсти требование с бейджем и порогом выручки. Лицензия Kimi до выхода весов 4 ноября остаётся неизвестной. Moonshot уже сообщила в техническом блоге, что открытый чекпойнт будет отличаться от API-модели: из открытых весов удалили данные, связанные с кибербезопасностью (kimi.com). Перед запуском обязательно прочитайте оба файла LICENSE.
Какую модель выбрать для вашего сценария
| Ваш сценарий | Выбор |
|---|---|
| Нужны веса на этой неделе для локальной оценки, базы для дообучения или изолированного развёртывания | MiniMax M3.1 Flash — единственный из двух доступный для скачивания вариант |
| Агенты для программирования с чувствительностью к цене и переменной нагрузкой | API MiniMax за $0.15/$0.60 — self-hosting имеет смысл только при стабильно большом объёме |
| Передовое программирование на длинных задачах, и вы можете подождать | Оцените Kimi K3.1 Pro API сейчас; решение о self-hosting принимайте после выхода весов, лицензии и реального размера 4 ноября |
| Коммерческий хостинговый продукт | Сначала согласуйте с юристами атрибуцию MiniMax и порог авторизации $20M; по Kimi выводов делать нельзя до публикации лицензии |
| Потребительская GPU или один Mac | Подтверждённого рецепта для одного устройства нет — используйте API, если не готовы тестировать неподдерживаемую конфигурацию |
FAQ
Где скачать официальные веса MiniMax M3.1 Flash?
Официальный репозиторий — MiniMaxAI/MiniMax-M3.1-Flash на Hugging Face; также есть зеркало на ModelScope. Для загрузки используйте hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash.
Есть ли официальный репозиторий Kimi K3.1 Pro на Hugging Face?
Нет. По состоянию на 24 октября 2026 года публичного репозитория с весами K3.1 Pro нет; технический блог Moonshot обещает полные веса до 4 ноября 2026 года.
Можно ли коммерчески использовать MiniMax M3.1 Flash?
Да, но с условиями: разместить «Built with MiniMax M3.1-Flash», один раз уведомить MiniMax и получить предварительное письменное разрешение при годовой выручке выше $20M; военное использование запрещено. Сверьте условия с LICENSE в репозитории вместе с юристами.
Запустится ли модель на потребительской GPU или Apple Silicon?
В приведённых рекомендациях по развёртыванию нет подтверждённой конфигурации на одной потребительской GPU; оценки предполагают несколько GPU с 80 ГБ для квантизированных весов и KV-кэша. NVIDIA указывает на DGX Station или кластер 4x DGX Spark 128 GB.
Работает ли она с vLLM или SGLang уже сейчас?
Для обеих систем есть рецепты первого дня, а также TokenSpeed и FlagOS для многопроцессорных запусков. Но примеры конфигураций могут ограничивать контекст 256K, отключать видео или не включать DSpark — сверяйтесь с актуальным рецептом в карточке модели для вашего оборудования.
Доступен ли полный контекст в 1M при self-hosting?
Заявленный максимум — 1 млн токенов, однако реально доступная длина зависит от памяти GPU и конфигурации сервинга. Для задач с длинным контекстом отдельно закладывайте запас под KV-кэш.
Читайте также: MiniMax M3.1 Flash Open Weights: Download, Run, Cost Guide, Kimi K3.1 Pro API Pricing Guide, Kimi K3 Open Weights