 AIREITER
Выбор зависит от характера нагрузки. Claude Opus 5 — более безопасная отправная точка для большинства ограниченных задач с большим объёмом вывода, а Claude Fable 5.1 стоит отдельно протестировать для длительных агентских сценариев и необычно больших контекстов, которые можно многократно переиспользовать. Главная экономия Fable 5.1 достигается за счёт чтения кэша, а не более низкой стоимости входных или выходных токенов.
Выбор между Fable 5.1 и Opus 5 начинается с типа нагрузки
Для большинства команд оптимальная стратегия — начать с Opus 5, повысить для сложной задачи уровень усилий модели и только проверенные трудные сценарии передавать Fable 5.1. Документация Anthropic по Fable 5.1 в целом рекомендует то же самое: использовать Opus 5 для большинства нагрузок, а к Fable 5.1 переходить, если Opus 5 на более высоком уровне усилий не справляется с требованиями.
| Главное ограничение | С чего начать | Почему |
|---|---|---|
| Короткие или чётко ограниченные запросы | Opus 5 | Его входные и выходные тарифы вдвое ниже, чем у Fable 5.1. |
| Продакшен-нагрузка с большим объёмом вывода | Opus 5 | Более низкая цена чтения кэша у Fable не распространяется на сгенерированные токены. |
| Многофайловая разработка по готовой спецификации | Opus 5 | Низкая стоимость позволяет легче компенсировать повторные попытки и повышать уровень усилий. |
| Длительно работающие агенты, использующие инструменты | Fable 5.1 — после тестирования | Fable лидирует в опубликованных Anthropic сравнениях агентских сценариев и работы с инструментами. |
| Большой контекст, который регулярно переиспользуется между ходами | Fable 5.1 — после расчёта стоимости | Чтение кэша у него стоит вдвое дешевле, чем у Opus 5. |
| Продакшен-маршрутизатор, чувствительный к резервным моделям | Сначала Opus 5 | Fable 5.1 меняет поведение блоков рассуждений и истории диалога. |
По сути, сравнивать нужно Opus 5 с подходящим уровнем усилий и стоимостью против Fable 5.1 с подходящей структурой контекста и требуемым уровнем надёжности.
Чем Fable 5.1 на самом деле отличается от Opus 5
Claude Fable 5.1 — более дорогая модель Anthropic для сложных рассуждений и длительной агентской работы. Claude Opus 5 позиционируется как менее дорогая модель для серьёзной разработки, агентов и профессиональных задач. У обеих моделей контекстное окно на 1 миллион токенов и максимальный вывод в 128 000 токенов, поэтому преимущество Fable связано с длительным выполнением задач, а не с более крупным заявленным размером контекста.
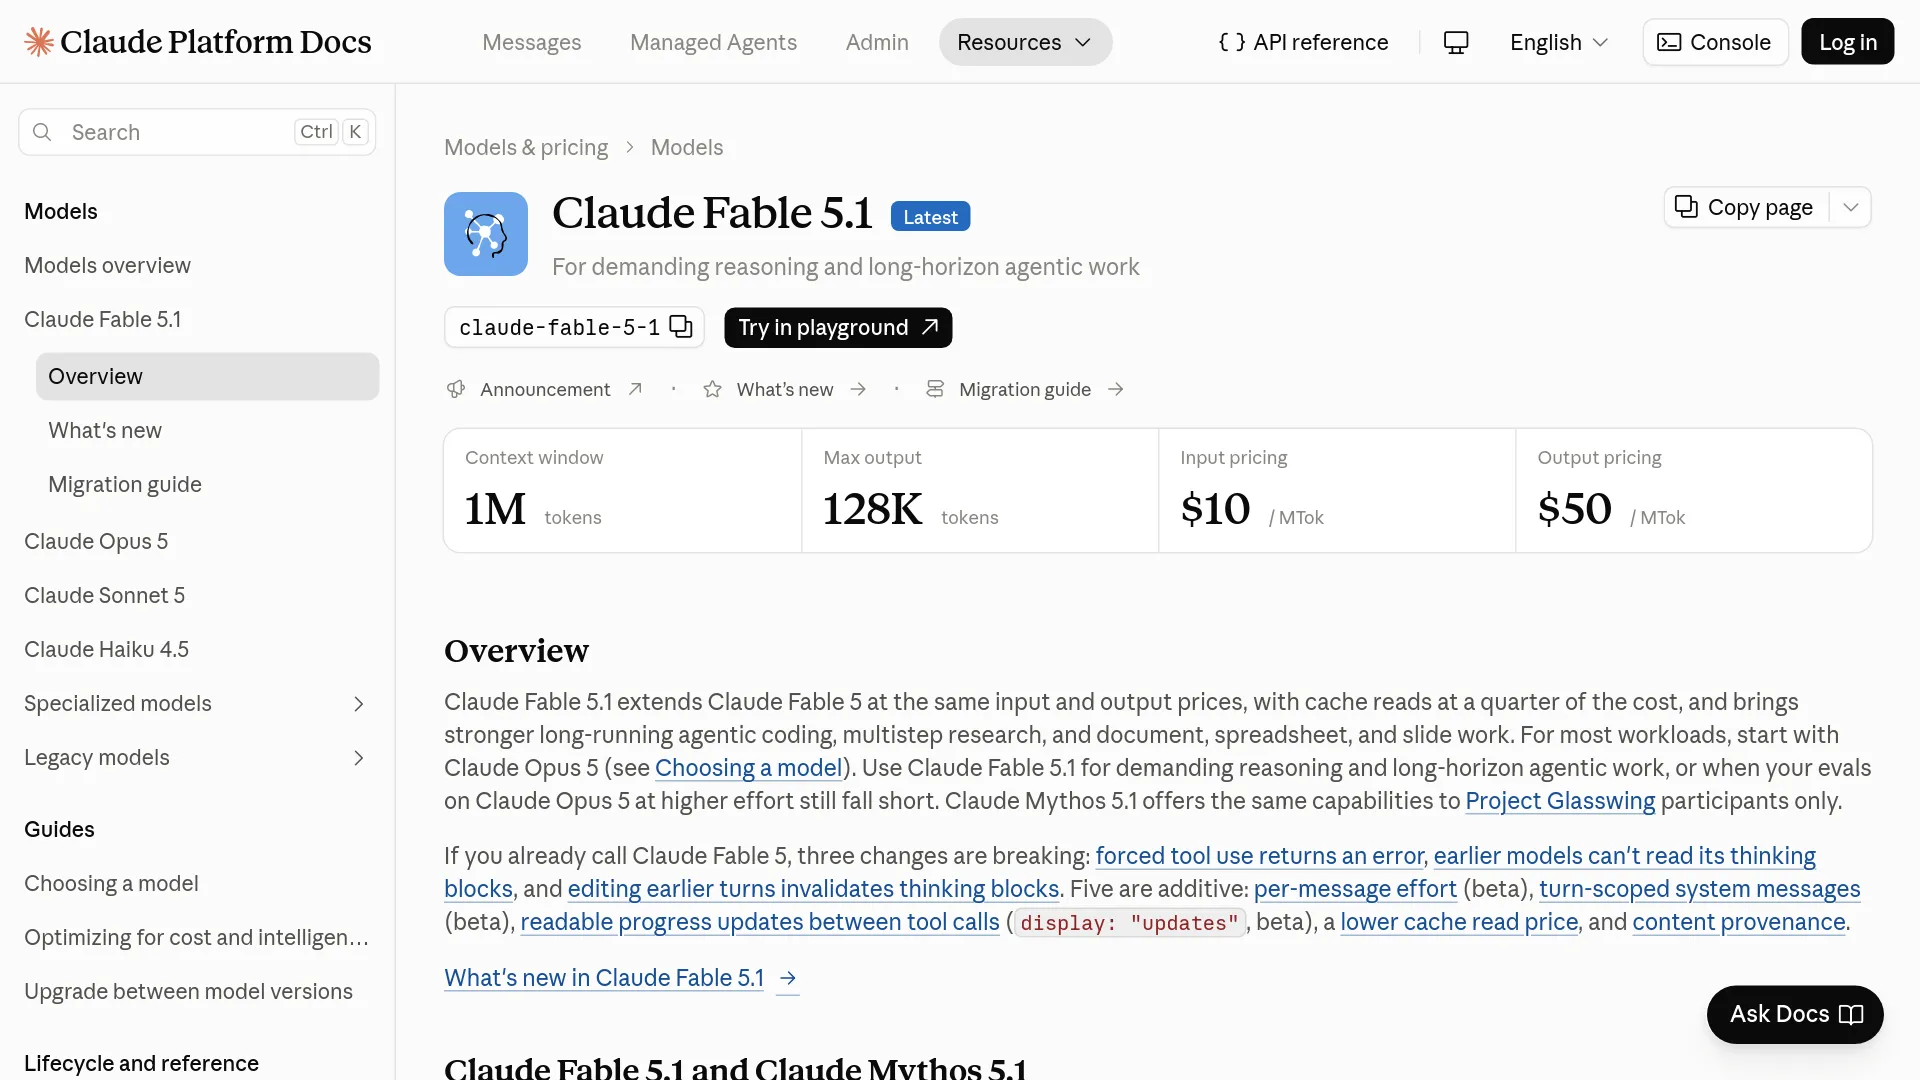
| Характеристика | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| Идентификатор модели в API | claude-fable-5-1 | claude-opus-5 |
| Контекстное окно | 1 миллион токенов | 1 миллион токенов |
| Максимальный вывод | 128 000 токенов | 128 000 токенов |
| Входные модальности | Текст и изображения | Текст и изображения |
| Выходная модальность | Текст | Текст |
| Рассуждения | Адаптивные, всегда включены | Рассуждения с управляемым уровнем усилий |
| Настройки уровня усилий | low, medium, high, xhigh, max | Настраиваемые уровни усилий |
| Позиционирование Anthropic | Сложные рассуждения и длительные агентские сценарии | Большинство задач и серьёзная разработка |
| Статус релиза | Активная/последняя версия; выпущена 1 сентября 2026 года | Активная модель Opus; выпущена 24 июля 2026 года |
Чтобы проверить идентификаторы моделей и доступность для конкретного развёртывания, используйте страницу модели Fable 5.1 и страницу продукта Claude Opus 5.
Fable 5.1 уверенно лидирует в бенчмарках, но не во всех возможных задачах
Опубликованная Anthropic таблица бенчмарков ставит Fable 5.1 выше Opus 5 во всех строках, где приведены результаты обеих моделей. При этом тестирование проводила сама компания, поэтому результаты лучше воспринимать как свидетельство итогов стартовой оценки, а не как гарантию поведения в продакшене.
| Тест Anthropic | Fable 5.1 | Opus 5 | Преимущество Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52,6% | 29,0% | 23,6 пункта |
| Terminal-Bench 4.0 | 55,8% | 52,3% | 3,5 пункта |
| GDPval-AA v2 | 1 853 Elo | 1 824 Elo | 29 Elo |
| OSWorld 2.0, строгий режим | 41,7% | 39,6% | 2,1 пункта |
| Humanity’s Last Exam, с инструментами | 65,0% | 63,6% | 1,4 пункта |
| AutomationBench | 31,4% | 26,9% | 4,5 пункта |
| CursorBench 3.2.0 | 73,4% | 70,0% | 3,4 пункта |
Anthropic сообщает, что в тестах были включены продакшен-защитные механизмы, а некоторые вмешательства могли приводить к нулевому результату или передаче задачи резервной модели. Компания также указывает стандартную ошибку примерно в 3,5–4,5 процентного пункта на модель в Terminal-Bench-Science 0.1. Поэтому разрыв в 23,6 пункта выглядит существенно убедительнее, чем разница в 1,4 пункта на Humanity’s Last Exam.
В сторонней оценке CodeRabbit на 45 задачах со 105 известными проблемными местами Fable 5.1 показала полноту 61,0% и точность 37,3%. У Opus 5 эти показатели составили 55,2% и 39,3% соответственно. Обе модели обработали по 166 комментариев, однако авторы предупреждают, что условия тестирования различались.
«Fable 5.1 — специализированный ревьюер». — так CodeRabbit описала результат своей оценки (CodeRabbit)
Цены API заметно меняют практическое сравнение
Для некэшируемых входных и выходных данных Fable 5.1 стоит вдвое дороже Opus 5, зато чтение кэша обходится вдвое дешевле. В длительных повторяющихся агентских сессиях это создаёт точку окупаемости, но не делает любой запрос к Fable 5.1 более выгодным.
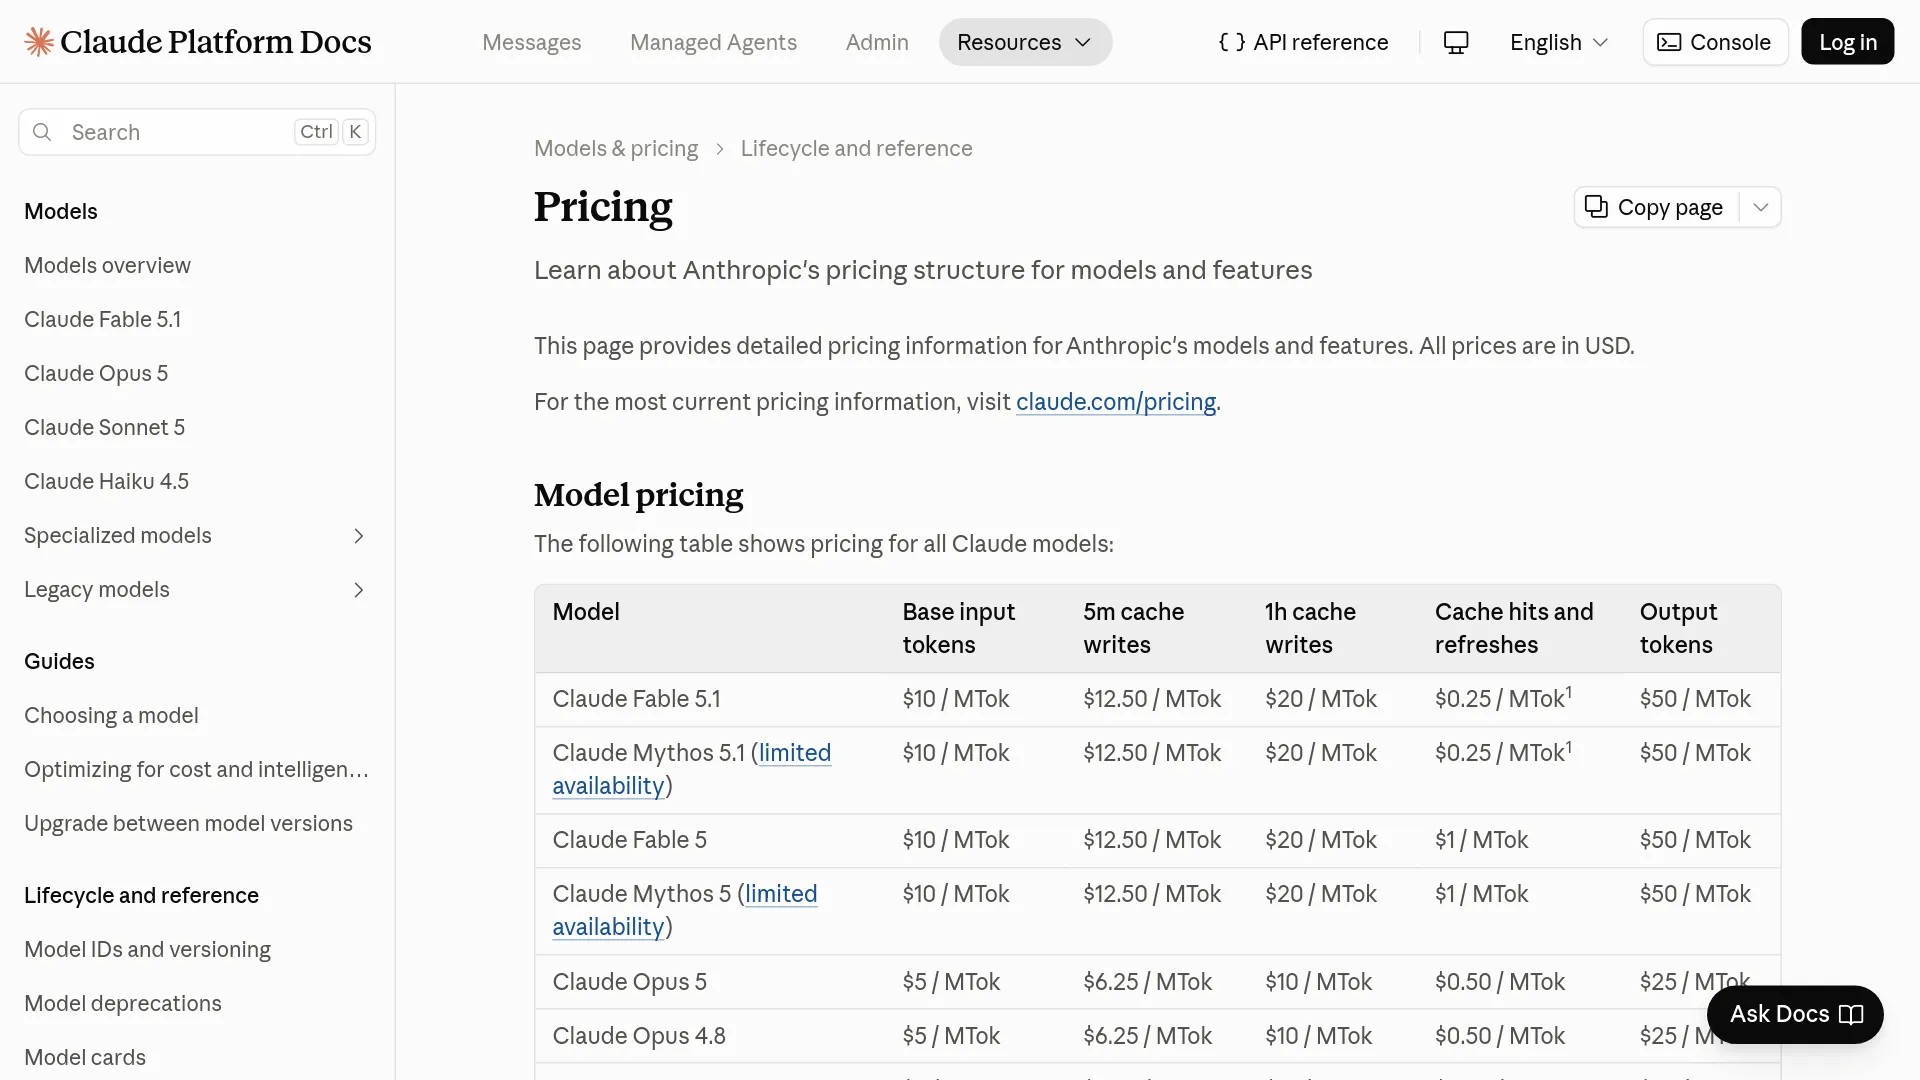
Ниже приведены тарифы из актуальной документации Anthropic по ценам API в долларах США за миллион токенов.
| Позиция биллинга | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| Базовый ввод | $10.00 | $5.00 |
| Запись в кэш на 5 минут | $12.50 | $6.25 |
| Запись в кэш на 1 час | $20.00 | $10.00 |
| Чтение кэша | $0.25 | $0.50 |
| Вывод | $50.00 | $25.00 |
| Batch: ввод / вывод | $5.00 / $25.00 | $2.50 / $12.50 |
Цены на ввод и вывод Fable 5.1 не изменились по сравнению с Fable 5. Экономию в рекламируемом сценарии обеспечивает тариф на чтение кэша: $0.25 за миллион токенов вместо $1.00 у Fable 5. Anthropic оценивает типичное снижение стоимости нагрузки примерно на 25%, а для сильно агентских сценариев — примерно до 45%. Но это оценки для отдельных типов нагрузки, а не универсальная скидка.
Разницу хорошо показывает простой расчёт для одного хода. Пусть C — кэшированный контекст, I — новые входные данные, а O — вывод; все значения измеряются в миллионах токенов. Если не учитывать стоимость записи в кэш, Fable 5.1 стоит 10I + 0.25C + 50O, а Opus 5 — 5I + 0.50C + 25O.
Более дешёвое чтение кэша у Fable компенсирует высокую стоимость новых входных и выходных токенов только при выполнении условия:
0.25C > 5I + 25O
Для нового запроса на 2 000 токенов и ответа на 1 000 токенов I = 0.002, а O = 0.001. Кэшированный контекст должен превышать примерно 140 000 токенов, прежде чем арифметика только для чтения кэша начнёт складываться в пользу Fable. Если добавить стоимость записи в кэш, точка окупаемости отодвинется ещё дальше.
Поэтому короткие задачи на извлечение данных, классификацию, рерайтинг и разовые запросы кода не стоит переводить на Fable 5.1 ради экономии. В них почти нет переиспользуемого префикса, а каждый сгенерированный токен тарифицируется по ставке, вдвое превышающей тариф Opus 5.
Как распределить модели по реальным рабочим сценариям
Практическое разделение проходит между ограниченным выполнением и длительной автономной работой. Opus 5 проще оправдать, когда задача чётко сформулирована или требует большого объёма вывода. Fable 5.1 становится интереснее, когда агенту нужно удерживать план, многократно обращаться к инструментам, восстанавливаться после ошибок и переносить большой контекст через множество ходов.
Агенты для программирования: оценивайте завершённую работу, а не место в бенчмарке
Opus 5 — разумная первая модель для обычной работы с репозиторием: локальных исправлений, рефакторинга по заданию, код-ревью и задач, где низкая стоимость позволяет повторять попытки или повышать уровень усилий. Fable 5.1 стоит протестировать на многофайловых изменениях, миграциях, отладке на уровне системы и асинхронных сессиях разработки, где поздний сбой обходится дороже, чем более медленный ответ.
Отзывы сообщества указывают на два разных операционных риска. В большом обсуждении на r/ClaudeCode пользователь u/CyCoCyCo написал:
«Добиться успеха у меня получилось только так: попросить её составить целевые промпты и прогнать всё от начала до конца». — u/CyCoCyCo на Reddit
Это свидетельство проблем с промптингом и рабочим процессом, а не доказательство того, что Opus 5 не справляется с любой кодовой базой. Другие участники того же обсуждения описывали сложности в более длинных задачах с большим контекстом, включая отклонение от инструкций и исправления, которые порождали новые дефекты.
У Fable 5.1 профиль жалоб другой: в обсуждении релиза пользователи сообщали о необычно быстром расходовании токенов или квоты. Это анекдотические наблюдения, которые не подтверждают существование универсального лимита подписки, но служат поводом отслеживать расход во время пилотного запуска, а не оценивать модель только по качеству ответов.
Во время пилотного запуска агента для программирования стоит фиксировать:
- Количество задач, завершённых без вмешательства человека.
- Число повторно открытых багов и регрессий после сообщения модели об успехе.
- Общее количество входных, кэшированных входных и выходных токенов.
- Время выполнения и число обращений к инструментам.
- Время на исправления человеком и стоимость поздних неудачных запусков.
Исследования и работа с документами: здесь аргументы в пользу Fable сильнее
Fable 5.1 выглядит более подходящим кандидатом для задач с очень большим набором документов, многочисленными обращениями к инструментам, визуальными графиками, многоэтапным исследованием или результатом, который должен выдержать несколько раундов доработки. Anthropic прямо позиционирует модель для работы с документами, таблицами, презентациями, диаграммами, а также для длительных исследовательских процессов.
У Opus 5 такое же контекстное окно на 1 миллион токенов, и Anthropic также заявляет, что модель умеет работать со сложными документами и продвинутыми агентами. Если задача сводится к одному анализу с большим объёмом сгенерированного текста, более низкий тариф Opus может оказаться важнее преимущества Fable при работе с кэшем. Прежде чем считать лидерство Fable в бенчмарках обязательным условием для продакшена, проведите тест на репрезентативной выборке.
Работа с компьютером и бизнес-автоматизация: проверяйте весь сценарий целиком
В строках OSWorld и AutomationBench Anthropic Fable 5.1 опережает Opus 5, однако эти тесты оценивают последовательность действий, а не один ответ. Для агента, работающего в браузере или бизнес-процессе, важно проверить, достигает ли он правильного конечного состояния, как часто ему требуется восстановление после ошибки и делает ли один неудачный шаг весь дальнейший запуск бесполезным.
Здесь нужно считать стоимость одного успешно завершённого результата, а не только цену миллиона токенов. Модель, которая предотвращает повторные попытки в длинном рабочем процессе, может оказаться выгодной даже при более высоком тарифе. А модель, которая расходует бюджет до достижения конечного состояния, выгодной не будет.
Что проверить в интеграции перед переходом
Документация по миграции на Fable 5.1 описывает изменения в принудительном вызове инструментов, блоках рассуждений и проверке истории диалога. Командам, использующим собственный маршрутизатор сообщений, стоит протестировать эти аспекты до смены модели по умолчанию.
| Изменение | Что может произойти | Что сделать при миграции |
|---|---|---|
| Принудительный вызов инструментов | tool_choice: {"type":"any"} или выбор именованного инструмента может привести к HTTP 400. | Использовать auto с чёткими инструкциями для инструмента либо структурированный вывод, если он подходит для задачи. |
| Переносимость блоков рассуждений | Предыдущие модели не умеют читать блоки рассуждений Fable 5.1; при резервном переключении они могут быть отброшены. | Проверить переключение моделей и сценарии резервного маршрута. |
| Редактирование диалога | Изменение предыдущего сообщения, системного промпта или списка инструментов может сделать последующие блоки рассуждений недействительными. | Считать историю доступной только для добавления новых сообщений либо использовать поддерживаемые настройки на уровне хода. |
| Настройка рассуждений | Fable 5.1 использует адаптивные рассуждения и не поддерживает их отключение тем же способом, что Opus 5. | Контролировать расходы настройками усилий и заново проверить расход токенов. |
Особенно важна работа резервного маршрута в системах со смешанными моделями. Запрос к Fable 5.1 может продолжиться с сохранённым контекстом рассуждений, но Opus 5 не умеет читать блоки рассуждений Fable 5.1. Если маршрутизатор незаметно удалит их, резервная модель может заново строить план, увеличивая задержку и расход токенов. Проверяйте и успешный, и аварийный сценарий на историях, похожих на продакшен.
Небольшое собственное тестирование полезнее громких заявлений о модели
Используйте для обеих моделей одинаковые промпты, инструменты, контекст, политику усилий и приёмочные тесты. Иначе сравнение моделей легко превратится в сравнение тестового стенда.
- Ограниченный поток: запускайте локальные исправления, извлечение данных, структурированное написание и код-ревью. Фиксируйте полезный результат, время на исправления и стоимость.
- Длительный поток: запускайте многофайловую функцию, миграцию, исследовательскую задачу или браузерный процесс. Отслеживайте успех конечного результата, восстановление после ошибок, регрессии и общее время выполнения.
- Поток с активным использованием кэша: повторяйте стабильный системный промпт, набор инструментов и префикс репозитория или документа. Фиксируйте долю попаданий в кэш и общий счёт, включая запись в кэш и вывод.
Начните с Opus 5 на том уровне усилий, который действительно планируете использовать в продакшене. Затем проверьте более высокий уровень усилий Opus, прежде чем переносить задачу на Fable 5.1. Для Fable протестируйте как минимум medium и high; не предполагайте, что одинаковое название уровня означает одинаковое поведение у разных моделей. Anthropic заявляет, что настройки усилий управляют компромиссом между глубиной рассуждений и стоимостью, а стороннее тестирование показало: более глубокие рассуждения не всегда автоматически улучшают совокупный результат код-ревью.
Fable 5.1 против Opus 5: часто задаваемые вопросы
Какая модель лучше подходит для программирования?
Fable 5.1 опережает Opus 5 в опубликованных Anthropic результатах Terminal-Bench и CursorBench, но для большинства ограниченных и чувствительных к стоимости задач начинать разумнее с Opus 5. Решение стоит принимать по результатам тестирования на репрезентативном репозитории: оно покажет, компенсирует ли более высокое качество завершения задач у Fable её цену и задержку.
Оправдывает ли Fable 5.1 двукратную цену API?
По умолчанию — нет. Тарифы на ввод и вывод у неё вдвое выше, чем у Opus 5, а чтение кэша стоит вдвое дешевле. Fable становится финансово интересной, когда нагрузка многократно переиспользует большой контекст и при этом генерирует сравнительно небольшой объём вывода.
У Fable 5.1 большее контекстное окно?
Нет. Anthropic указывает для обеих моделей контекстное окно на 1 миллион токенов и максимальный вывод в 128 000 токенов. Отличие Fable — в позиционировании для более длительных рассуждений и агентских траекторий, а не в большем заявленном окне.
Стоит ли повысить уровень усилий Opus 5 перед переходом?
Да. В рекомендациях Anthropic советует сначала оценить Opus 5 на более высоком уровне усилий, а уже затем переходить к Fable 5.1. Сопоставьте дополнительные расходы на токены с приростом качества, вместо того чтобы запускать каждый запрос на максимальном уровне.
Можно ли безопасно переключаться с Fable 5.1 на Opus 5?
Такой резервный маршрут построить можно, но не стоит считать состояние диалога полностью переносимым. Предыдущие модели не умеют читать блоки рассуждений Fable 5.1, а проверка истории в Fable 5.1 может выявить маршрутизаторы, которые изменяют предыдущие ходы. Протестируйте резервный сценарий с реальными схемами инструментов и историями сообщений.
Где разработчикам доступны Fable 5.1 и Opus 5?
Anthropic указывает обе модели среди доступных для тарифов Claude и разработчиков через собственную платформу и интеграции с облачными маркетплейсами. Конкретные идентификаторы и доступность могут различаться у разных поставщиков, поэтому проверяйте идентификатор для нужного развёртывания в документации Fable 5.1 или на странице продукта Opus 5.
Практический выбор — это правило маршрутизации, а не постоянный переход на более дорогую модель
| Сценарий | Использовать Opus 5 | Использовать Fable 5.1 |
|---|---|---|
| Модель по умолчанию для смешанной нагрузки | Да | Только после тестирования |
| Короткие разовые запросы | Да | Ценовых оснований нет |
| Генерация с большим объёмом вывода | Да | Обычно нет |
| Большие кэшированные префиксы | Тщательно сравнить | Возможна экономия |
| Длительная автономная разработка | Сначала пилот | Сильный кандидат |
| Строго ограниченный рефакторинг | Обычно | Если Opus не проходит приёмочные тесты |
| Браузерная или многоэтапная автоматизация | Сначала пилот | Сильная позиция по бенчмаркам |
| Собственный маршрутизатор с резервной моделью | Более простой базовый вариант | Требуется тестирование миграции |
Сохраняйте Opus 5 в качестве базовой модели, прогоняйте обе модели на одинаковом наборе ограниченных и длительных задач и направляйте запросы в Fable 5.1 только тогда, когда она повышает показатель завершённой работы на доллар.
Подробности о стоимости конкретной модели смотрите в материале Claude Fable 5.1 API pricing, а общий обзор модели — в статье Claude Opus 5.