 AIREITER
2 февраля 2026 года Eleven v3 вышла из альфа-тестирования. В ElevenLabs API модель вызывается по идентификатору eleven_v3. И ElevenLabs, и fal.ai берут по $0.10 за 1 000 символов, поэтому одной только ценой выбор не определить — важнее схема оплаты, лимиты параллельных запросов и доступ к голосам. В стабильном релизе исправили и заметные проблемы: согласно анонсу GA, доля ошибок со структурированным текстом в бенчмарке из 27 категорий и 8 языков снизилась с 15.3% до 4.9%. При интеграции закладывайтесь на два жёстких ограничения: не больше 5 000 символов в запросе и модель, которую сам разработчик пока не рекомендует для работы в реальном времени.
Что умеет ElevenLabs Eleven v3 API
У Eleven v3 API четыре основных интерфейса: создание речи, потоковая генерация, а также отдельные эндпоинты для создания и потоковой передачи диалогов с несколькими спикерами. Модель поддерживает более 70 языков и понимает встроенные аудиотеги, с помощью которых можно задавать эмоцию и манеру исполнения. После выхода GA она стала достаточно стабильной: в собственных тестах ElevenLabs предпочитала её альфа-версии в 72% случаев.
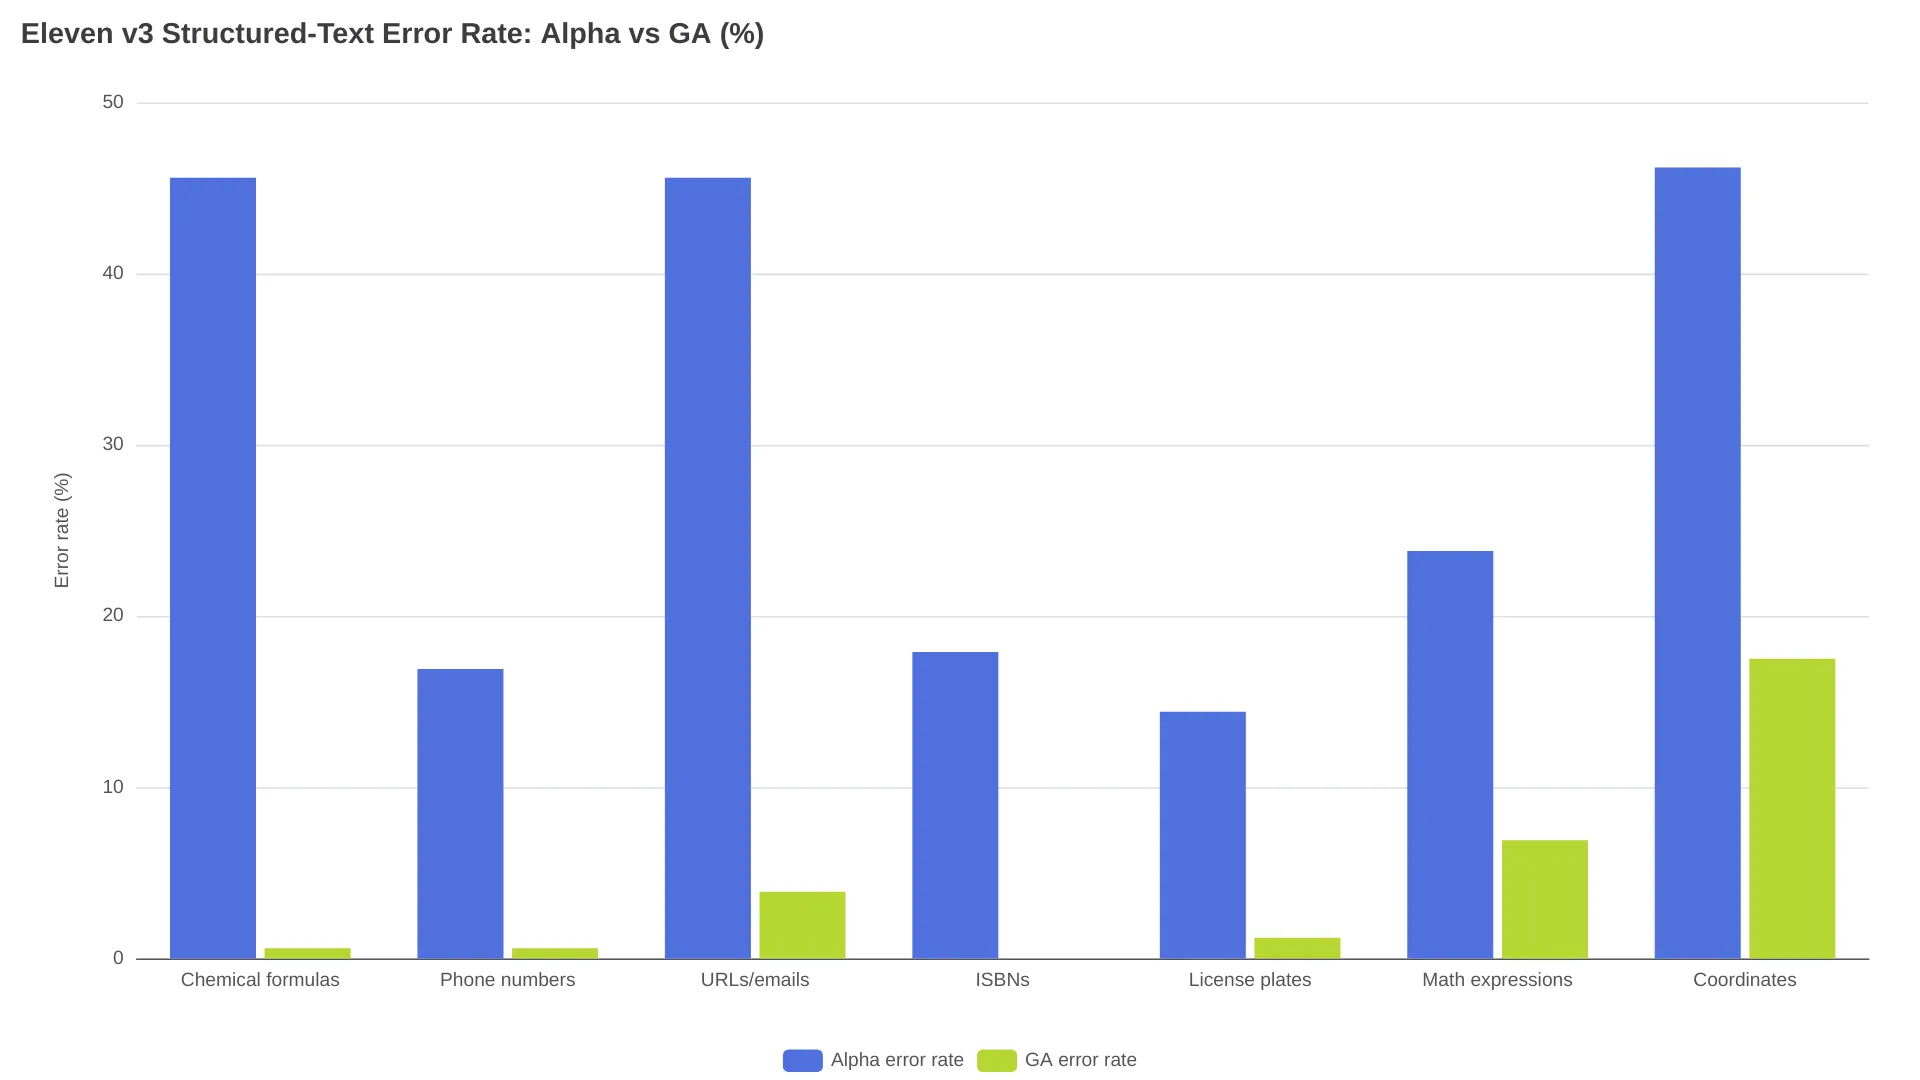
Перед тем как отдавать v3 структурированные данные, стоит посмотреть на результаты по отдельным категориям. Например, ошибки в химических формулах сократились с 45.6% до 0.6%, в телефонных номерах — с 16.9% до 0.6%, а для ISBN достигли нулевого уровня. Слабее всего модель работает с географическими координатами: здесь ошибка составляет 17.5%. Математические выражения дают 6.9% — для обычной озвучки это приемлемо, но контент с большим количеством координат лучше проверять особенно тщательно.
В таблице ниже — место v3 среди родственных моделей по данным официального справочника моделей:
| Модель | ID модели | Языки | Максимум символов в запросе | Заявленная задержка | Цена за 1 000 символов |
|---|---|---|---|---|---|
| Eleven v3 | eleven_v3 | 70+ | 5 000 (около 5 минут) | около 250–300 мс (зависит от тарифа) | $0.10 |
| Eleven v3 Conversational | через Text-to-Dialogue WebSocket | 70+ | н/д | около 280 мс | $0.10 |
| Multilingual v2 | eleven_multilingual_v2 | 29 | 10 000 (около 10 минут) | около 250–300 мс | $0.10 |
| Flash v2.5 | eleven_flash_v2_5 | 32 | 40 000 (около 40 минут) | около 75 мс | $0.05 |
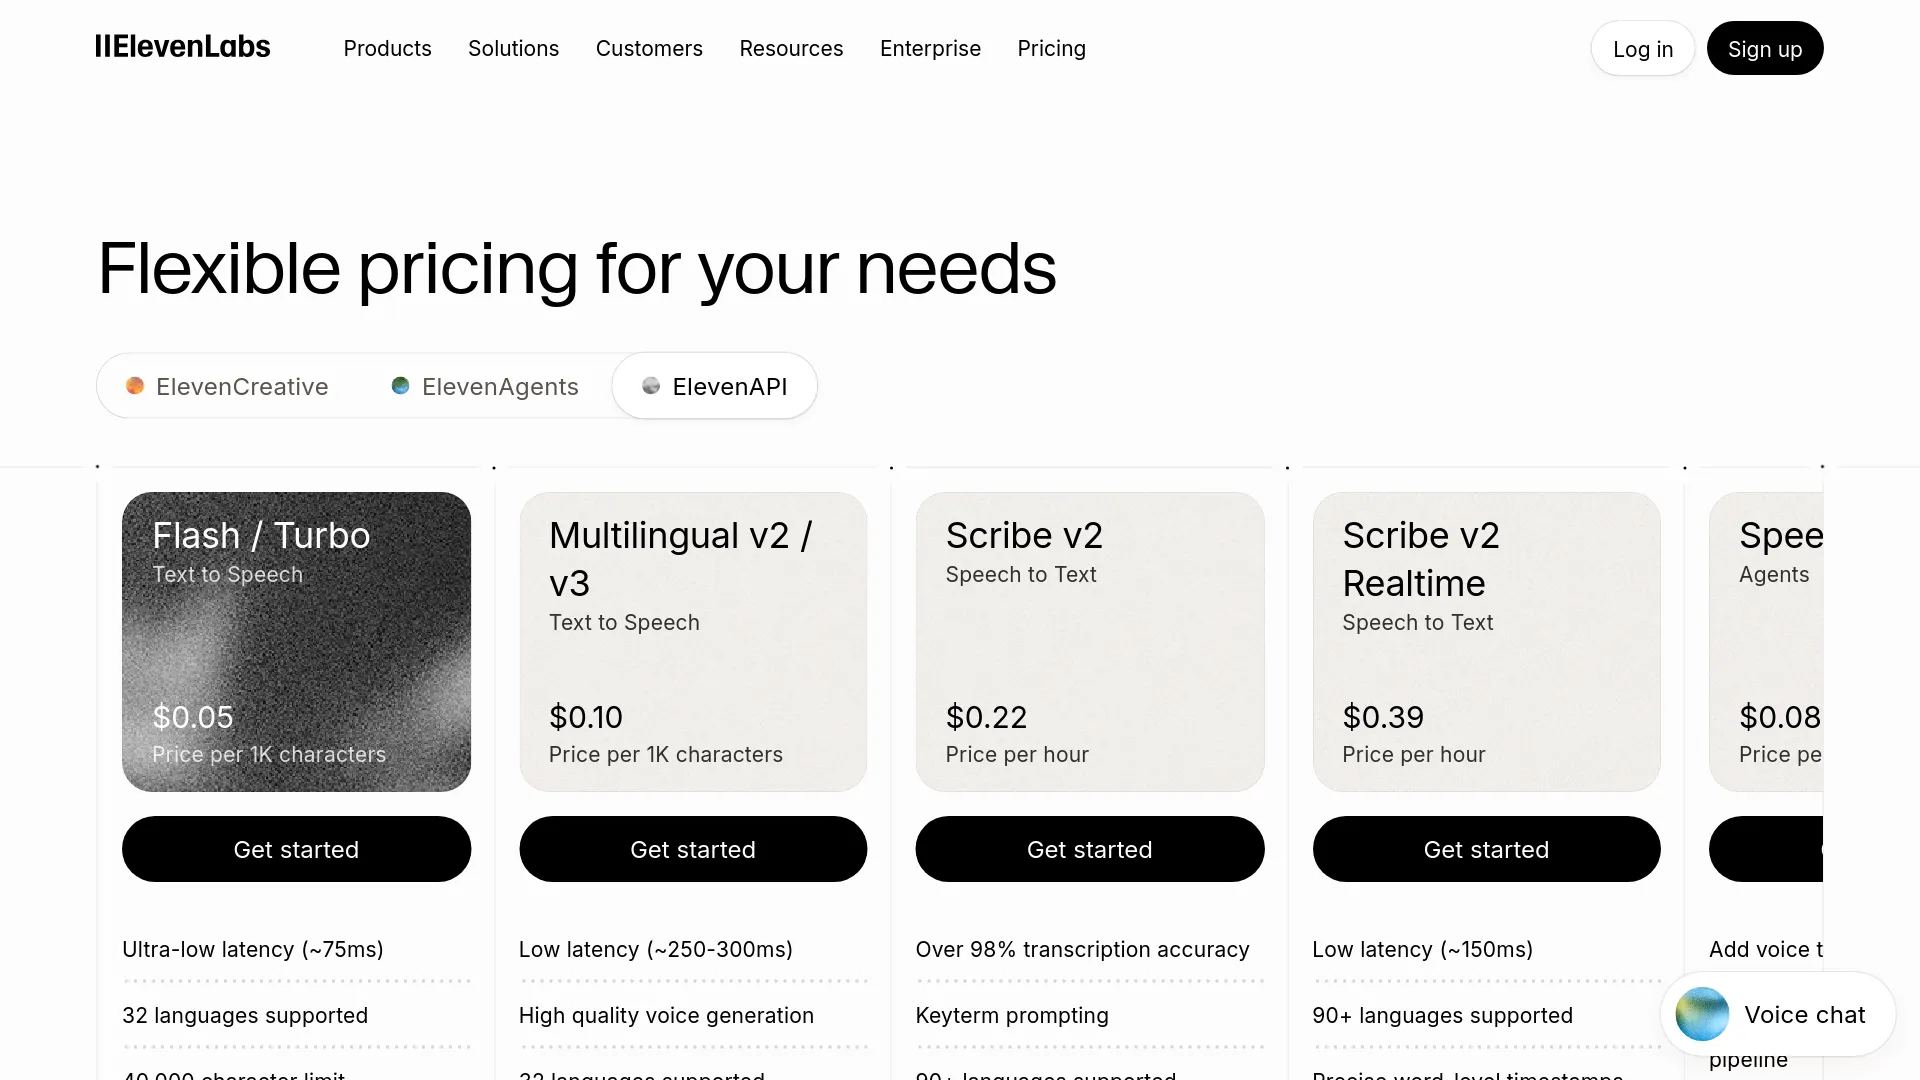
В документации есть важное расхождение. На странице с ценами модели «Multilingual v2/v3» объединены в тарифный уровень с лимитом 40 000 символов, но в справочнике моделей для Eleven v3 указано ограничение 5 000 символов на запрос. Для v3 ориентируйтесь именно на 5 000: это значение относится к конкретной модели, и длинные пайплайны, рассчитанные на 40 тысяч символов, завершатся ошибкой.
Цены: официальный ElevenLabs или fal.ai
Цена самого Eleven v3 на обеих площадках одинаковая — $0.10 за 1 000 символов. Внутри линейки дешевле только Flash v2.5: $0.05 за 1 000. Реальные различия начинаются в способе оплаты и организации параллельных запросов:
| Официальный ElevenLabs | fal.ai | |
|---|---|---|
| Цена Eleven v3 | $0.10 / 1 000 символов | $0.10 / 1 000 символов |
| Оплата | Подписка с включёнными кредитами или оплата по факту использования | Только оплата за использование: «без лицензий на места, подписок и минимальных платежей» |
| Бесплатный тариф | 10 000 символов Multilingual в месяц (20 000 Flash) | На странице модели не указан |
| Пример тарифа | Creator — $22 в месяц (первый месяц $11), 220 000 символов Multilingual | н/д |
| Максимальный тариф | Business — $990 в месяц, 9.9 млн символов Multilingual | н/д |
| Параллельность | Зависит от тарифа: 2 одновременных запроса Multilingual на Free, 15–30 на Scale/Business, индивидуальные значения на Enterprise | Бессерверная очередь; лимит на аккаунт на странице модели не задокументирован |
| Цена ожидания в очереди | При превышении лимита запросы становятся в очередь, что «обычно» добавляет около 50 мс | Queue API с вебхуками для пакетных задач |
| Параметры (официальная схема и сообщения пользователей) | Голос по ID; stability (пользователи сообщают о 3 позициях в v3) | Voice, stability, similarity_boost, speed, language_code, apply_text_normalization, seed, timestamps, output_format |
| Программа для стартапов | 12 месяцев бесплатно, 33 млн символов, повышенная параллельность | н/д |
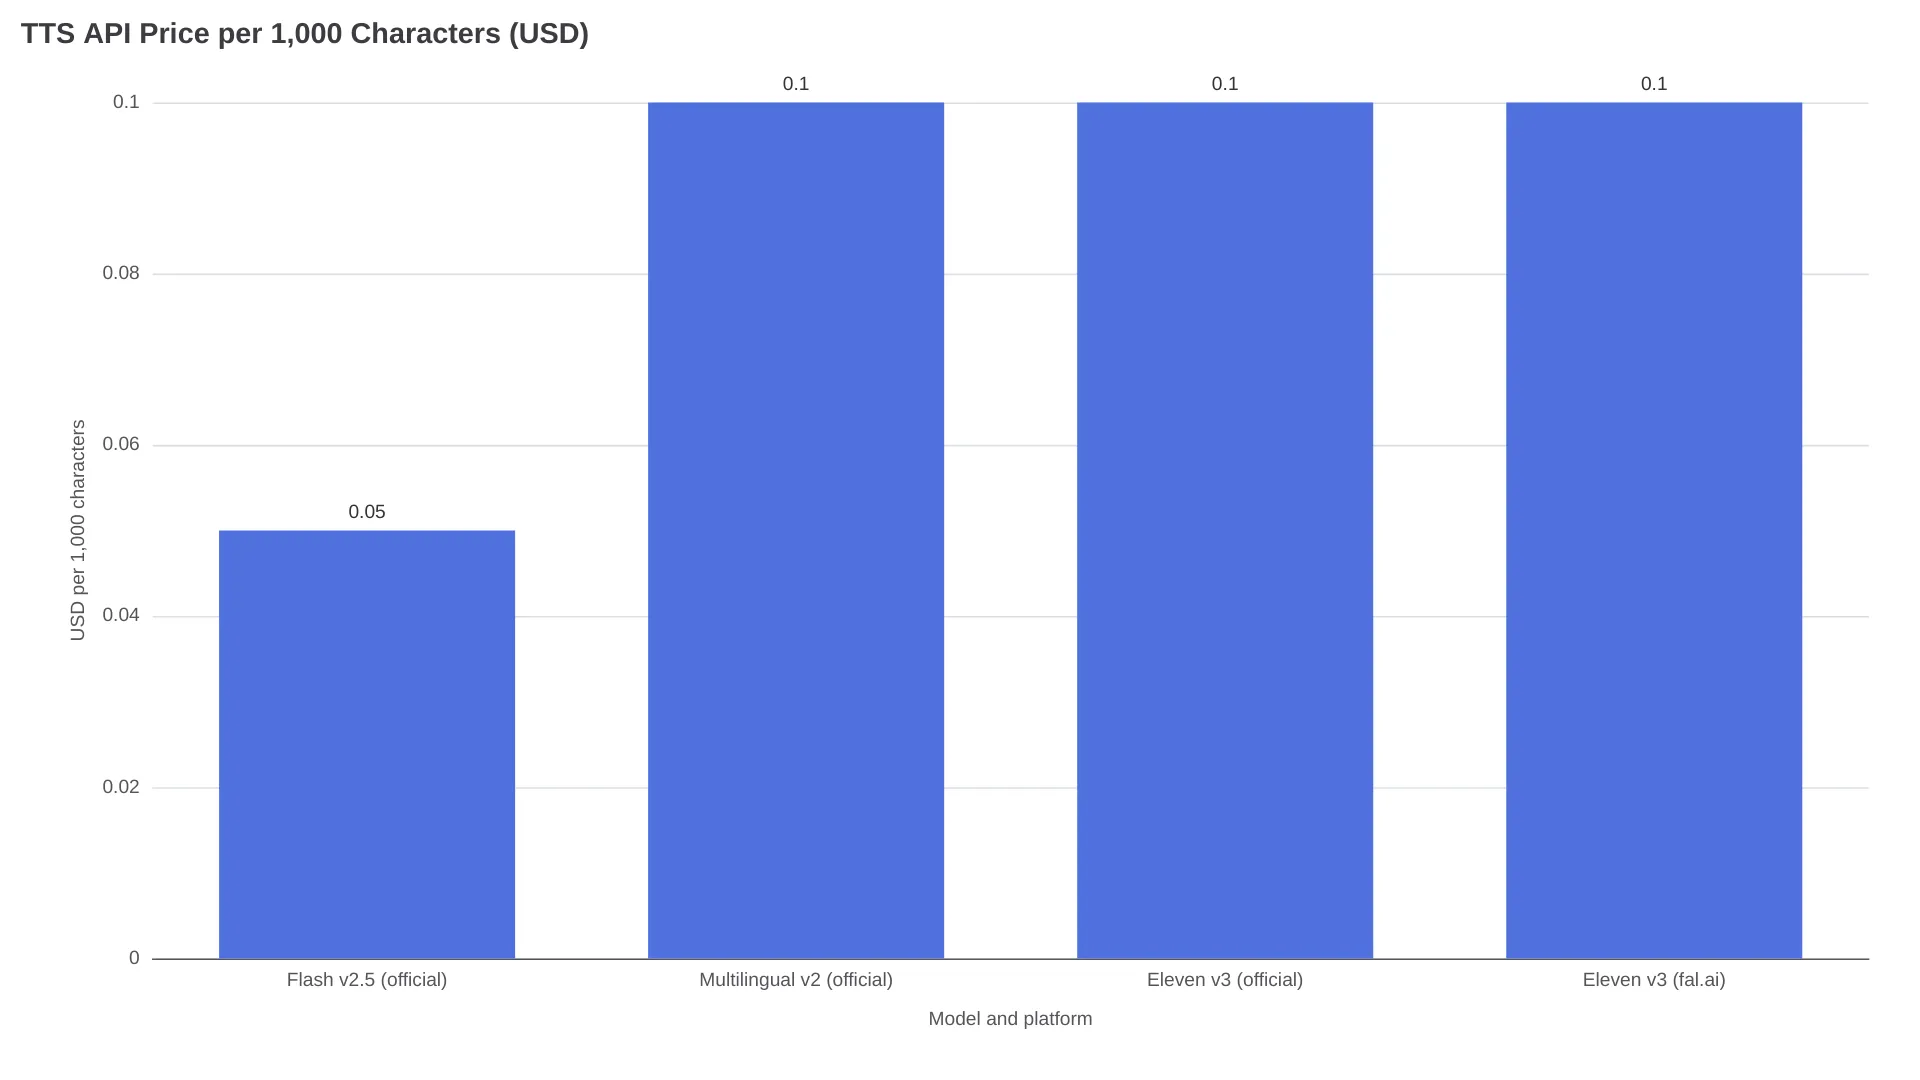
В официальном API параллельность привязана к тарифу. Ключ Free позволяет одновременно выполнять только 2 запроса v3, поэтому пакетная обработка быстро упирается в ограничение. На fal.ai все задачи проходят через бессерверную очередь с вебхуками — именно такой сценарий платформа и пытается закрыть. Ни в одной из документаций не сказано, учитываются ли пробелы и аудиотеги в квадратных скобках при расчёте стоимости. Для бюджета безопаснее считать, что учитываются.
Если v3 нужен лишь время от времени, а остальные модели вы уже запускаете через fal, полезный разбор платформы есть в нашем обзоре fal.ai.
Аудиотеги: как задавать эмоции прямо в тексте
Аудиотеги — это инструкции в квадратных скобках, встроенные непосредственно в текст. Модель воспринимает их как указания для исполнения и не произносит вслух. Минимальный пример со страницы модели fal:
[slowly] Back then... [chuckles] we had no phones.
[whispers] Just dirt roads and [coughs] big dreams.
[sad] Then it happened.| Категория | Рабочие примеры |
|---|---|
| Эмоции | [happy], [sad], [excited], [angry], [sarcastically], [nervous], [happily] |
| Манера речи | [whispers], [shouting], [shouts], [slowly], [quickly], [softly] |
| Неречевые звуки | [laughs], [chuckles], [sighs], [gasps], [coughs], [gulps], [clears throat], [applause] |
| Акценты | [british accent], [southern accent], [strong canadian accent] |
Официальная документация по промптингу выделяет три правила. Во-первых, единого канонического списка тегов нет: это инструкции на естественном языке, и ElevenLabs прямо допускает, что за пределами опубликованных примеров есть более эффективные варианты. Во-вторых, SSML-теги паузы не поддерживаются — темп задаётся знаками препинания, многоточиями и переносами строк. Наконец, результат зависит от конкретного голоса и контекста. Именно здесь чаще всего начинаются сюрпризы:
«V3 потрясающая, определённо звучит наиболее по-человечески» «для меня это всё ещё похоже на бета-релиз» — u/ConcertNeat8147, обе цитаты из одного поста, отчёт пользователей r/ElevenLabs о v3
В той же ветке u/poundingCode, инженер-программист с двадцатилетним опытом, рассказал, что эмоциональные теги иногда полностью меняют акцент говорящего. Представитель ElevenLabs ответил, что «над всеми этими проблемами мы сейчас работаем».
Авторы из той же ветки делятся следующими обходными приёмами. Это опыт сообщества, а не официальные рекомендации:
- Фраза для разогрева. Добавьте в начало лишнее предложение, задающее тон и высоту голоса, а затем вырежьте его при монтаже. Нередко голос «успокаивается» спустя несколько секунд после начала генерации.
- Финальное
end.. После основного текста добавьте перенос строки и слово «end.», чтобы избежать обрезания последних слов, а затем удалите этот фрагмент из аудио. - Заканчивайте предложения многоточием. По наблюдениям пользователей, обрывы на концах слов случаются реже, если предложение завершается на «...».
- Поставьте максимальную стабильность. У v3 три положения регулятора stability; максимальное значение уменьшает дрейф голоса в начале генерации.
Лимиты, которые влияют на интеграцию
- Главное ограничение — 5 000 символов. Один запрос даёт примерно 5 минут аудио, поэтому для аудиокниг и длинных материалов текст придётся разбивать на части. Делайте разрезы по предложениям или абзацам, а не посреди фразы, и оставляйте теги внутри того фрагмента, к которому они относятся. Multilingual v2 поддерживает 10 000 символов, если вам нужны более крупные и редкие запросы.
- В официальном API параллельность зависит от тарифа. Согласно справочнику моделей, ключи Free получают 2 одновременных запроса уровня Multilingual (4 для Flash), Scale и Business — 15–30, а Enterprise позволяет согласовать индивидуальные лимиты. Превышение лимита «обычно» добавляет к ожиданию около 50 мс. На той же странице ElevenLabs приводит ориентир по мощности: лимит параллельности 5 рассчитан примерно на 100 одновременных аудиотрансляций в разговорном сценарии. Для одного вызова задержка невелика, но в пакетной обработке недостаточный лимит быстро становится проблемой.
- fal вообще не указывает максимальный размер входных данных. На странице Eleven v3 описаны эндпоинт, параметры и форматы, но нет сведений о максимальной длине текста, времени хранения в очереди или логике повторных попыток. Отправить длинный текст можно, но никаких гарантий платформа не даёт.
- Таймстемпы зависят от выбранной платформы. Входная схема fal содержит булев параметр
timestamps, который возвращает выравнивание по словам — это удобно для субтитров и липсинка. Официальный API для диалогов v3 выдаёт аудио без таймстемпов; разработчики публично обращали внимание на этот пробел (r/ElevenLabs: «v3 API, no timestamps?»). На сегодня документированный способ получить данные для выравнивания — параметр fal.
- Для реального времени v3 пока не подходит. ElevenLabs не рекомендует модель для realtime- и разговорных сценариев из-за более высокой задержки и нестабильности результата. Официально предлагаются два варианта: Flash v2.5 примерно с 75 мс задержки для агентов или Eleven v3 Conversational примерно с 280 мс через WebSocket, если в интерактивном сценарии важна выразительность. Версия v3 для реального времени есть в планах («мы работаем над версией для реального времени»), но на момент анонса GA она ещё не вышла.
- Коммерческое использование. Во время альфа-тестирования разработчики публично спрашивали, можно ли использовать результат v3 в коммерческих проектах. Анонс GA сообщил о доступности модели на всех платформах, а fal прямо помечает свой эндпоинт как предназначенный для коммерческого использования.
Первый запрос: официальный SDK и клиент fal
Официальный способ из quickstart без изменений:
pip install elevenlabsfrom elevenlabs import ElevenLabs
client = ElevenLabs(api_key="YOUR_ELEVENLABS_API_KEY") # or ELEVENLABS_API_KEY env var
audio = client.text_to_speech.convert(
voice_id="JBFqnCBsd6RMkjVDRZzb", # "George"
text="[whispers] The first move is what sets everything in motion.",
model_id="eleven_v3",
output_format="mp3_44100_128",
)Для fal используется fal-client и эндпоинт fal.run:
pip install fal-clientimport fal_client
result = fal_client.subscribe(
"fal-ai/elevenlabs/tts/eleven-v3",
arguments={
"text": "[whispers] The first move is what sets everything in motion.",
"voice": "Rachel", # default voice
"stability": 0.5, # 0–1, lower = more expressive variation
"timestamps": True, # per-word alignment data
},
)
print(result["audio"]["url"]) # hosted MP3 URLОбе платформы отдельно предупреждают: API-ключи нельзя встраивать в клиентский код. Проксируйте запросы через собственный сервер. Для потоковой передачи у официального API есть stream-speech endpoint, а fal предоставляет fal.stream и Queue API с вебхуками для пакетных задач.
Какой эндпоинт выбрать
| Сценарий | Что использовать |
|---|---|
| Нужны собственные клонированные голоса (PVC/IVC) или созданные голоса по ID | Официальный API: пользовательские голоса доступны по ID в вашем рабочем пространстве; на странице fal документированы только имена готовых голосов |
| У вас уже есть тариф ElevenLabs с включёнными кредитами | Официальный API: включённые символы уже оплачены, а каждый вызов fal станет дополнительным расходом |
| Пакетная озвучка аудиокниг или дубляж без подписки, с вебхуками по завершении | fal: его очередь с оплатой по факту и вебхуками рассчитана именно на такой сценарий |
| Нужен один API-ключ для моделей изображений, видео и TTS в одном стеке | fal: v3 работает через тот же клиент, что и остальные модели fal |
| Голосовые агенты и любые сценарии, чувствительные к задержке | Ни один TTS-эндпоинт v3: используйте Flash v2.5 (около 75 мс) или Eleven v3 Conversational (около 280 мс) |
| Корпоративные требования (SOC 2, HIPAA BAA, индивидуальные лимиты запросов, разрешённые IP-адреса) | Официальный API: эти возможности указаны для тарифа Enterprise на странице цен; страница модели fal не уточняет, какие сертификаты распространяются на её эндпоинт |
FAQ
Какой ID у модели Eleven v3?
eleven_v3 — его нужно передать в параметре model_id стандартных TTS-эндпоинтов. Для диалогов с несколькими спикерами используются отдельные Text-to-Dialogue эндпоинты, а не параметр модели.
Поддерживает ли Eleven v3 API потоковую передачу?
Да. Официальный API предоставляет stream-speech endpoint, который возвращает аудио по мере генерации, а fal — fal.stream для той же модели. Но потоковая передача сама по себе не превращает v3 в realtime-модель: официальные рекомендации по-прежнему отправляют разговорные сценарии к Flash v2.5 или Eleven v3 Conversational.
Какой лимит символов у Eleven v3?
5 000 символов на запрос — это примерно 5 минут аудио согласно официальному справочнику моделей. Указанные на странице цен 40 000 символов относятся к группе тарифов Multilingual, а не к v3.
Сколько стоит Eleven v3 API?
На обеих платформах — $0.10 за 1 000 символов: $1.00 за историю на 10 000 символов и $100 за аудиокнигу на 1 млн символов. В официальном API расходы можно покрыть кредитами тарифа: Creator за $22 в месяц включает 220 000 символов Multilingual. У fal подписки нет.
Можно ли использовать с Eleven v3 клонированные голоса?
В официальном API — да: профессиональные, клонированные и созданные голоса вызываются по voice ID. На практике совместимость может отличаться. Пользователи r/ElevenLabs сообщают, что существующие Professional Voice Clones иногда начинают звучать как другие дикторы при работе с v3, тогда как PVC с отметкой о совместимости с V3 обычно работают стабильнее. Схема fal принимает имя или ID голоса, но документирует только готовые голоса, поэтому приватные voice ID ElevenLabs там остаются неподтверждённым сценарием.
Подходит ли Eleven v3 для голосовых агентов в реальном времени?
Нет. ElevenLabs прямо указывает, что v3 не подходит для realtime- и разговорных сценариев из-за высокой задержки и непостоянства результата. Используйте Flash v2.5 (около 75 мс, 32 языка) или Eleven v3 Conversational (около 280 мс, более 70 языков и управление через аудиотеги).
Почему Eleven v3 через API звучит иначе, чем на сайте?
Превью голосов не отражают результат с вашим собственным текстом — это регулярно отмечают в отчётах пользователей r/ElevenLabs. Кроме того, результат v3 заметно меняется от генерации к генерации. Перед выбором голоса прогоните через каждого кандидата реальный фрагмент сценария с тем же значением stability, которое будет использоваться в продакшене.
Читайте также: обзор Qwen Audio 3 TTS API · цены и альтернативы Replicate · обзор fal.ai за 2026 год