 AIREITER
Claude Sonnet 5.5 сочетает цену $2 за миллион входных токенов с заявленным результатом 70.6% в Terminal-Bench 4.0. Но в агентских запусках с максимальным уровнем усилий реальная стоимость принятого изменения может оказаться значительно выше. Для команд, которые выбирают модель для продакшен-разработки, Sonnet 5.5 — лучший кандидат на роль основного пилотного маршрута, но не безусловная замена Opus 5.5.
Итог для продакшена: Sonnet 5.5 стоит сделать основной моделью для кодинга
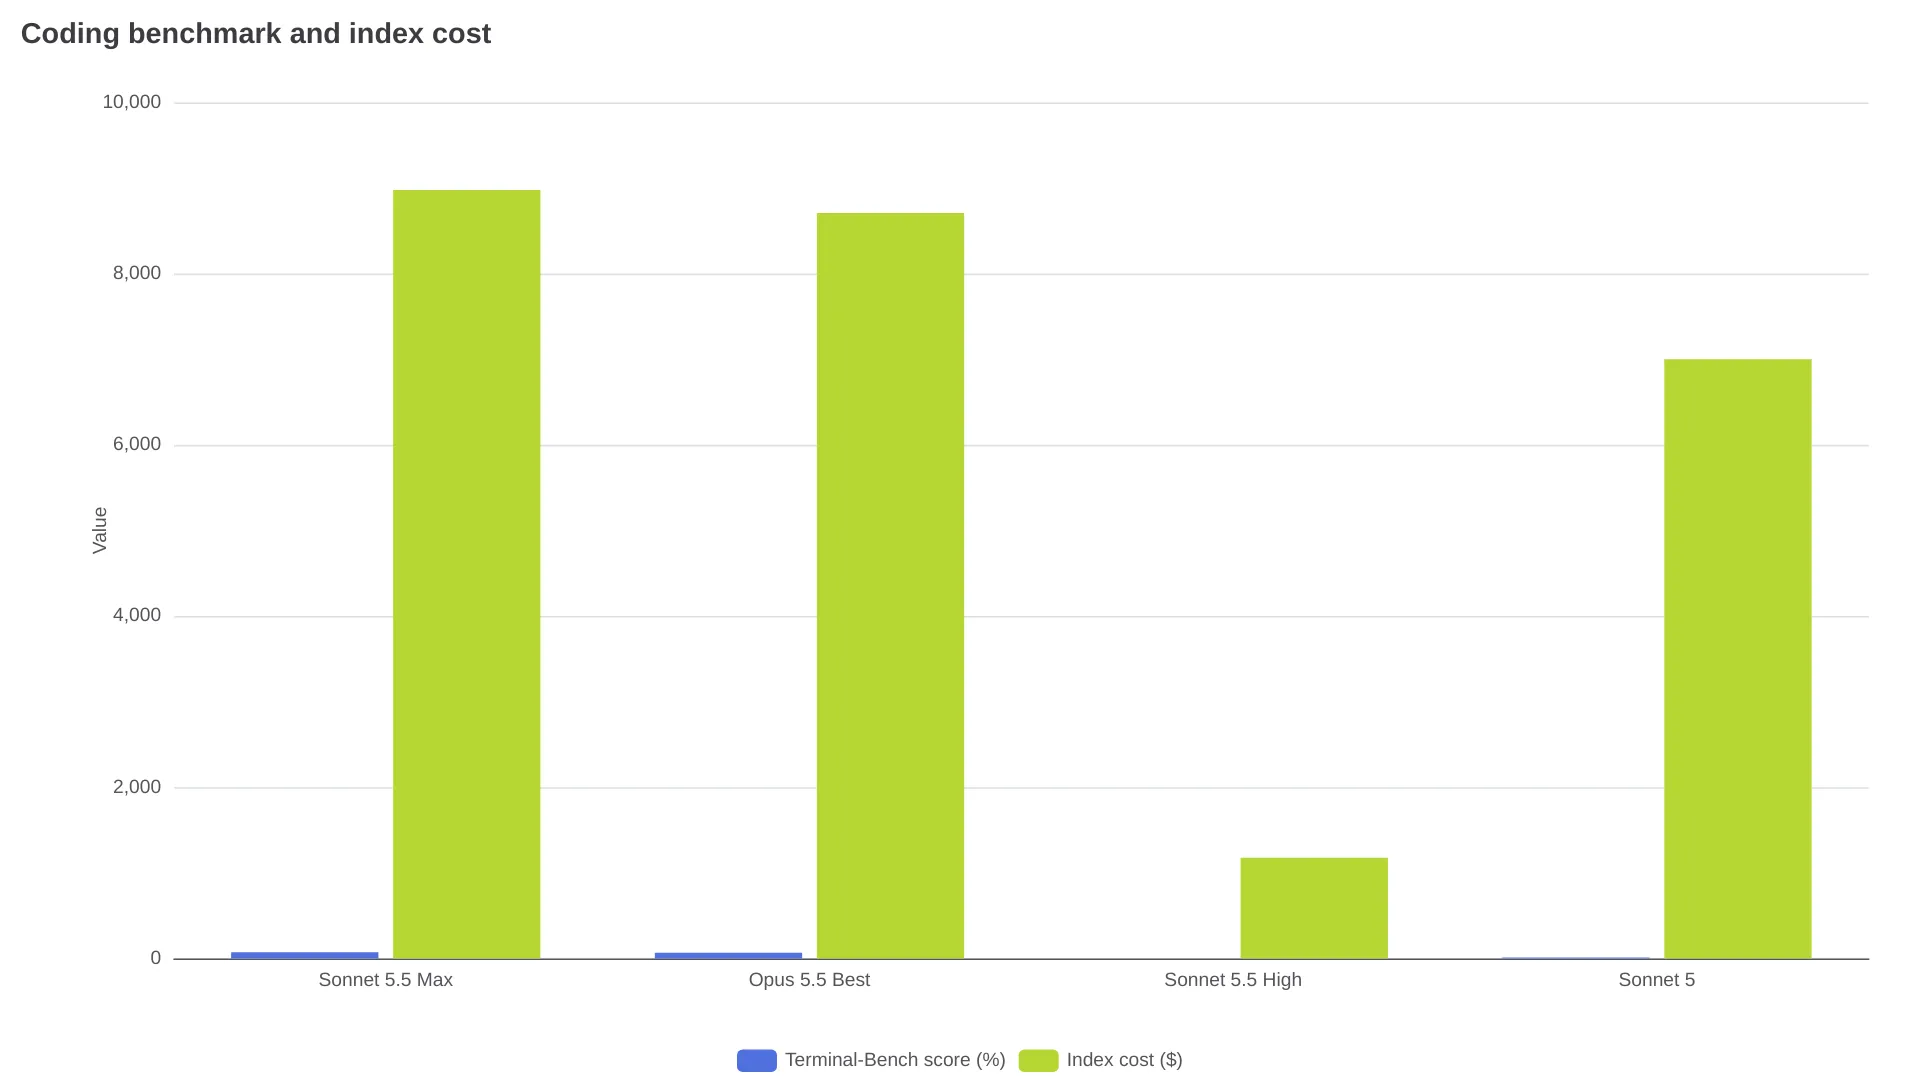
Начните с пилотирования Claude Sonnet 5.5 на ограниченных задачах: исправлении багов, рефакторинге, генерации тестов и работе с репозиториями через инструменты. Согласно опубликованным Anthropic данным, в Terminal-Bench 4.0 модель набрала 70.6% — против 66.4% у Claude Opus 5.5 и 10.3% у Claude Sonnet 5 в том же сравнении.
Но без предохранителей не обойтись: задавайте уровень усилий и лимиты вывода явно. Независимые анализы стоимости показывают, что Sonnet 5.5 на максимальном уровне усилий может обходиться дороже Opus 5.5 в расчёте на задачу бенчмарка, несмотря на более низкие заявленные тарифы Sonnet.
Что Claude Sonnet 5.5 меняет для API-команд
Claude Sonnet 5.5 вышла 28 сентября 2026 года. В официальной документации модели указаны ID модели claude-sonnet-5-5, контекстное окно на 1 миллион токенов, стандартный максимальный объём вывода 128 000 токенов, адаптивное рассуждение и высокий уровень усилий (high) по умолчанию в API.
| Параметр для продакшена | Claude Sonnet 5.5 |
|---|---|
| Дата выхода | 28 сентября 2026 года |
| ID модели | claude-sonnet-5-5 |
| Контекстное окно | 1M токенов |
| Стандартный максимальный вывод | 128K токенов |
| Максимальный вывод в Batch | 300K токенов с указанным в документации beta-заголовком |
| Уровень усилий в API по умолчанию | high |
Anthropic обязуется не выводить модель из эксплуатации раньше 28 сентября 2027 года. Это нижняя граница жизненного цикла, а не обещанная окончательная дата отключения.
Настройки API, которые напрямую влияют на счёт за кодинг
Адаптивное рассуждение включено по умолчанию. При миграции с Sonnet 5 стоит протестировать between_tools, если нужно отключить предварительное рассуждение: в официальной документации сказано, что принудительное использование инструментов теперь приводит к ошибке, а значения temperature, top_p или top_k, отличные от стандартных, возвращают ошибки HTTP 400.
Текст, который модель генерирует между вызовами инструментов, может приходить в блоках thinking. Если потоковый клиент считает, что каждое промежуточное сообщение обязано быть обычным текстовым блоком, после миграции он может выглядеть «зависшим». До подключения Sonnet 5.5 к существующему кодинг-агенту обновите парсер.
Производительность в Terminal-Bench: для основной модели вполне достаточно
Главный упомянутый здесь бенчмарк для кодинг-агентов — Terminal-Bench 4.0. Он проверяет выполнение многошаговых задач через командную строку. По данным Anthropic, Sonnet 5.5 набрала 70.6%, Opus 5.5 — 66.4%, а Sonnet 5 — 10.3%.
| Модель | Terminal-Bench 4.0 | GDPval-AA Elo | CursorBench 4.0 |
|---|---|---|---|
| Claude Sonnet 5.5 | 70.6% | 1844 | 55.5% |
| Claude Opus 5.5 | 66.4% | 1846 | 57.8% |
| Claude Sonnet 5 | 10.3% | 1449 | 34.1% |
Приведённые выше цифры опубликованы в обзоре бенчмарков DataCamp, который ссылается на материалы Anthropic, посвящённые запуску модели. В сравнении терминального кодинга лидирует Sonnet 5.5, но в CursorBench и ряде более широких тестов на рассуждение и интеллектуальную работу впереди остаётся Opus 5.5.
Проверяйте модель на воспроизведённых задачах из реальных репозиториев: учитывайте прошедшие тесты, количество ходов с инструментами и принятые изменения, а не только получившийся diff.
Цены Claude Sonnet 5.5 API на реальных нагрузках
Тарифная сетка Anthropic выглядит просто, но кодинг-агент платит не только за видимый промпт. Токены рассуждения тарифицируются как выходные, а повторяющийся контекст репозитория в разных ходах может превращаться в чтение кэша.
| Позиция в API | Цена Claude Sonnet 5.5 |
|---|---|
| Входные токены | $2 за 1M токенов |
| Выходные токены, включая рассуждение | $10 за 1M токенов |
| Запись в кэш на 5 минут | $2.50 за 1M токенов |
| Запись в кэш на 1 час | $4 за 1M токенов |
| Чтение кэша | $0.20 за 1M токенов |
| Входные токены в Batch | Скидка 50%, то есть $1 за 1M |
| Выходные токены в Batch | Скидка 50%, то есть $5 за 1M |
В официальной документации указано, что минимальный кэшируемый промпт должен содержать 512 токенов, а Sonnet 5.5 использует адаптивное рассуждение. Согласно независимому анализу цен от eesel, у Sonnet 5.5 тот же токенизатор, что и у Sonnet 5, поэтому сама миграция автоматически не уменьшит количество токенов.
Запрос на 4 000 входных и 700 выходных токенов стоит около $0.015 без учёта прочих начислений: $0.008 за вход и $0.007 за выход. Кодинг-агент, который делает 20 ходов по 3 000 новых входных и 2 000 выходных токенов за ход, израсходует примерно $0.12 на новые входные токены и $0.40 на выходные — ещё до оплаты чтения и записи кэша, инструментов и повторных попыток. Это примеры для конкретных нагрузок, а не универсальная цена задачи.
Уровень усилий — главный регулятор стоимости
В анализе TokenCost по уровням усилий, основанном на измерениях Artificial Analysis Intelligence Index, для Sonnet 5.5 приведены следующие результаты:
| Уровень усилий | Результат | Стоимость полного индекса |
|---|---|---|
| Low | 35.8 | $544 |
| Medium | 40.7 | $701 |
| High | 46.7 | $1,176 |
| Xhigh | 51.9 | $2,738 |
| Max | 56.0 | $8,977 |
Максимальный уровень — повод насторожиться. В том же анализе Opus 5.5 на максимуме получил 57.6 при стоимости $8,708, а на уровне xhigh — 56.0 при $4,057. В этом тесте Sonnet 5.5 на максимальном уровне использовала примерно 193 000 выходных токенов на задачу.
Начните со среднего или высокого уровня, ограничьте число выходных токенов, а задачи, которые не удалось выполнить или которые несут повышенный риск, отправляйте на более дорогой маршрут. Не переносите настройки максимального уровня, использовавшиеся для Sonnet 5, в Sonnet 5.5 без повторной проверки стоимости и качества.
Чек-лист миграции на продакшен-модель для кодинга
- Закрепите
claude-sonnet-5-5в staging, не меняя глобально алиас. - Прогоните на ваших репозиториях типичные исправления багов, рефакторинг, генерацию тестов и изменения в нескольких файлах.
- Задайте уровень усилий явно и фиксируйте число выходных токенов, чтений кэша, ходов с инструментами, полное время выполнения и долю принятых изменений.
- Замените
thinking: disabledна поддерживаемое поведениеbetween_tools, где это необходимо. - Уберите предположения о принудительном использовании инструментов и протестируйте новое поведение выбора инструментов.
- Обновите потоковый код, чтобы он обрабатывал блоки
thinkingмежду вызовами инструментов. - Повторно проверьте нестандартные параметры сэмплирования: в официальной документации указаны ошибки 400 для нестандартных
temperature,top_pиtop_k. - Добавьте потолок расходов и условие аварийного завершения для неконтролируемого вывода или повторяющихся циклов с инструментами.
- Сравнивайте стоимость принятого изменения, а не стоимость запроса.
- Выкатывайте модель на небольшой процент трафика. Увеличивайте долю Sonnet только в том случае, если при согласованном допуске она сохраняет показатель принятых изменений на уровне текущей модели и снижает стоимость принятого изменения.
Сотрудник Anthropic @cjav_dev сообщил, что запросы с thinking: {"type":"disabled"} начали возвращать ошибки 400 и вместо этого должны использовать between_tools (публикация в X).
Когда выбирать Sonnet 5.5, Opus 5.5 или более дешёвую модель
| Нагрузка | Что выбрать сначала | Почему |
|---|---|---|
| Локальные исправления и рефакторинг | Sonnet 5.5 на medium/high | Сильный результат в терминальном бенчмарке при более низких тарифах за токены |
| Массовая классификация кода или простые правки | Sonnet 5.5 на low/medium или более дешёвая модель | Не стоит платить за ненужное рассуждение |
| Долго работающий агент для репозитория | Sonnet 5.5 с кэшированием и жёсткими бюджетами | Итоговый счёт определяют кэш и количество ходов |
| Неоднозначная архитектура или финальное ревью | Opus 5.5 | Широта суждений важнее минимального тарифа |
| Офлайн-анализ кода без срочности | Sonnet 5.5 Batch API | API даёт скидку 50% на входные и выходные токены |
| Эксперимент с максимальным уровнем усилий в терминале | Sonnet 5.5 только после внутреннего бенчмарка | Terminal-Bench — сильная сторона модели, но максимум может быть дорогим |
Используйте Sonnet для чётко определённых задач с измеримым результатом, а неоднозначную архитектурную работу передавайте Opus.
FAQ по Claude Sonnet 5.5 API
Сколько стоит Claude Sonnet 5.5 API?
Стандартная цена составляет $2 за миллион входных токенов и $10 за миллион выходных. Чтение кэша стоит $0.20 за миллион токенов, запись — $2.50 на пять минут или $4 на один час, а Batch API снижает стоимость входных и выходных токенов на 50%.
Sonnet 5.5 лучше Opus 5.5 для кодинга?
В опубликованном сравнении Terminal-Bench 4.0 Sonnet 5.5 лидирует с результатом 70.6% против 66.4% у Opus 5.5. В ряде других тестов Opus остаётся впереди, поэтому маршрутизацию стоит строить по типу задачи, а не воспринимать результат кодингового бенчмарка как универсальный рейтинг.
Какой ID у модели Sonnet 5.5?
В Claude API используйте claude-sonnet-5-5. Идентификаторы для конкретных провайдеров перечислены в документации моделей Anthropic.
Поддерживает ли Sonnet 5.5 контекстное окно на 1M токенов?
Да. Anthropic заявляет контекстное окно на 1 миллион токенов и стандартный максимальный вывод 128 000 токенов. В бета-версии Message Batches API можно получить 300 000 выходных токенов с указанным в документации beta-заголовком.
Что изменилось при миграции с Sonnet 5?
Изменились адаптивное рассуждение и поведение блоков ответа, принудительное использование инструментов может приводить к ошибке, нестандартные параметры сэмплирования могут возвращать ошибки 400, а thinking: disabled нужно заменить на поддерживаемое поведение. Перед выкатыванием в продакшен повторно прогоните тесты агента и потоковой обработки.
Проведите недельный пилот на задачах со средним и высоким уровнем усилий: измеряйте стоимость принятого изменения, а неудачные случаи отправляйте на Opus.