 AIREITER
Uma API de $0.15 por hora pode cobrar $0.30 por uma hora de áudio, enquanto outra de $0.36 por hora cobra $0.36 pelo mesmo arquivo. Esse detalhe de faturamento pesa mais em muitos orçamentos de STT do que qualquer ranking de precisão — e costuma ficar escondido nas comparações.
A melhor API de fala para texto em 2026 depende de você transcrever arquivos ou operar um agente de voz ao vivo. Para áudio gravado com foco em custo, comece pelo AssemblyAI Universal-2, a $0.15/hora. Para agentes em tempo real, em que a alternância entre falas faz diferença, comece pelo streaming do Deepgram Flux ou Nova-3. E, para mais de 90 idiomas com suporte amplo à diarização, teste o ElevenLabs Scribe v2 a $0.22/hora no processamento em lote. Os preços abaixo são as tarifas principais no modelo pay-as-you-go, normalizadas por hora de áudio antes de descontos por volume.
Processamento em lote e streaming são produtos diferentes
Trate a transcrição em lote e o streaming em tempo real como duas compras separadas. APIs em lote cobram por hora de áudio processada, geralmente em um fluxo de enviar o arquivo e depois consultar o status. APIs de streaming cobram por minuto de sessão, incluindo o tempo ocioso enquanto o WebSocket permanece aberto, e dependem diretamente da velocidade dos resultados parciais.
As latências de resultado parcial, finalização e fim de turno medem momentos diferentes: quando as primeiras palavras aparecem, quando elas deixam de mudar e quando o sistema decide que o interlocutor terminou. Colocar fornecedores lado a lado usando essas definições misturadas pode induzir ao erro, como alertam as comparações de streaming do Dexto e do versusref.
Na prática, a divisão é esta:
- Arquivos gravados grandes, podcasts, reuniões e registros de chamadas: otimize o $/hora, a precisão da diarização, o suporte a arquivos grandes e o tempo de correção.
- Legendas ao vivo ou agentes telefônicos: priorize parciais estáveis, detecção de encerramento, tratamento de interrupções e o atraso de ponta a ponta, incluindo seu LLM e TTS.
- Chamadas de contact center na AWS ou no GCP: compras corporativas e cobrança por canal muitas vezes pesam mais do que uma diferença de $0.05/hora no preço de tabela.
"Teste essas APIs com gravações reais de clientes. Ambientes barulhentos. Sotaques indianos. Alternância entre hindi e inglês... Primeiro, precisão, latência e confiabilidade. Preço por último." — @Aditya_Chawla20
Essa publicação comparou o AssemblyAI a $0.21/hora, o ElevenLabs Scribe v2 a $0.22/hora e o Deepgram Nova-3 perto de $0.26/hora. A conclusão foi que a diferença de 5 centavos importa menos do que saber qual modelo aguenta áudio real.
Quanto custa 1 hora de áudio
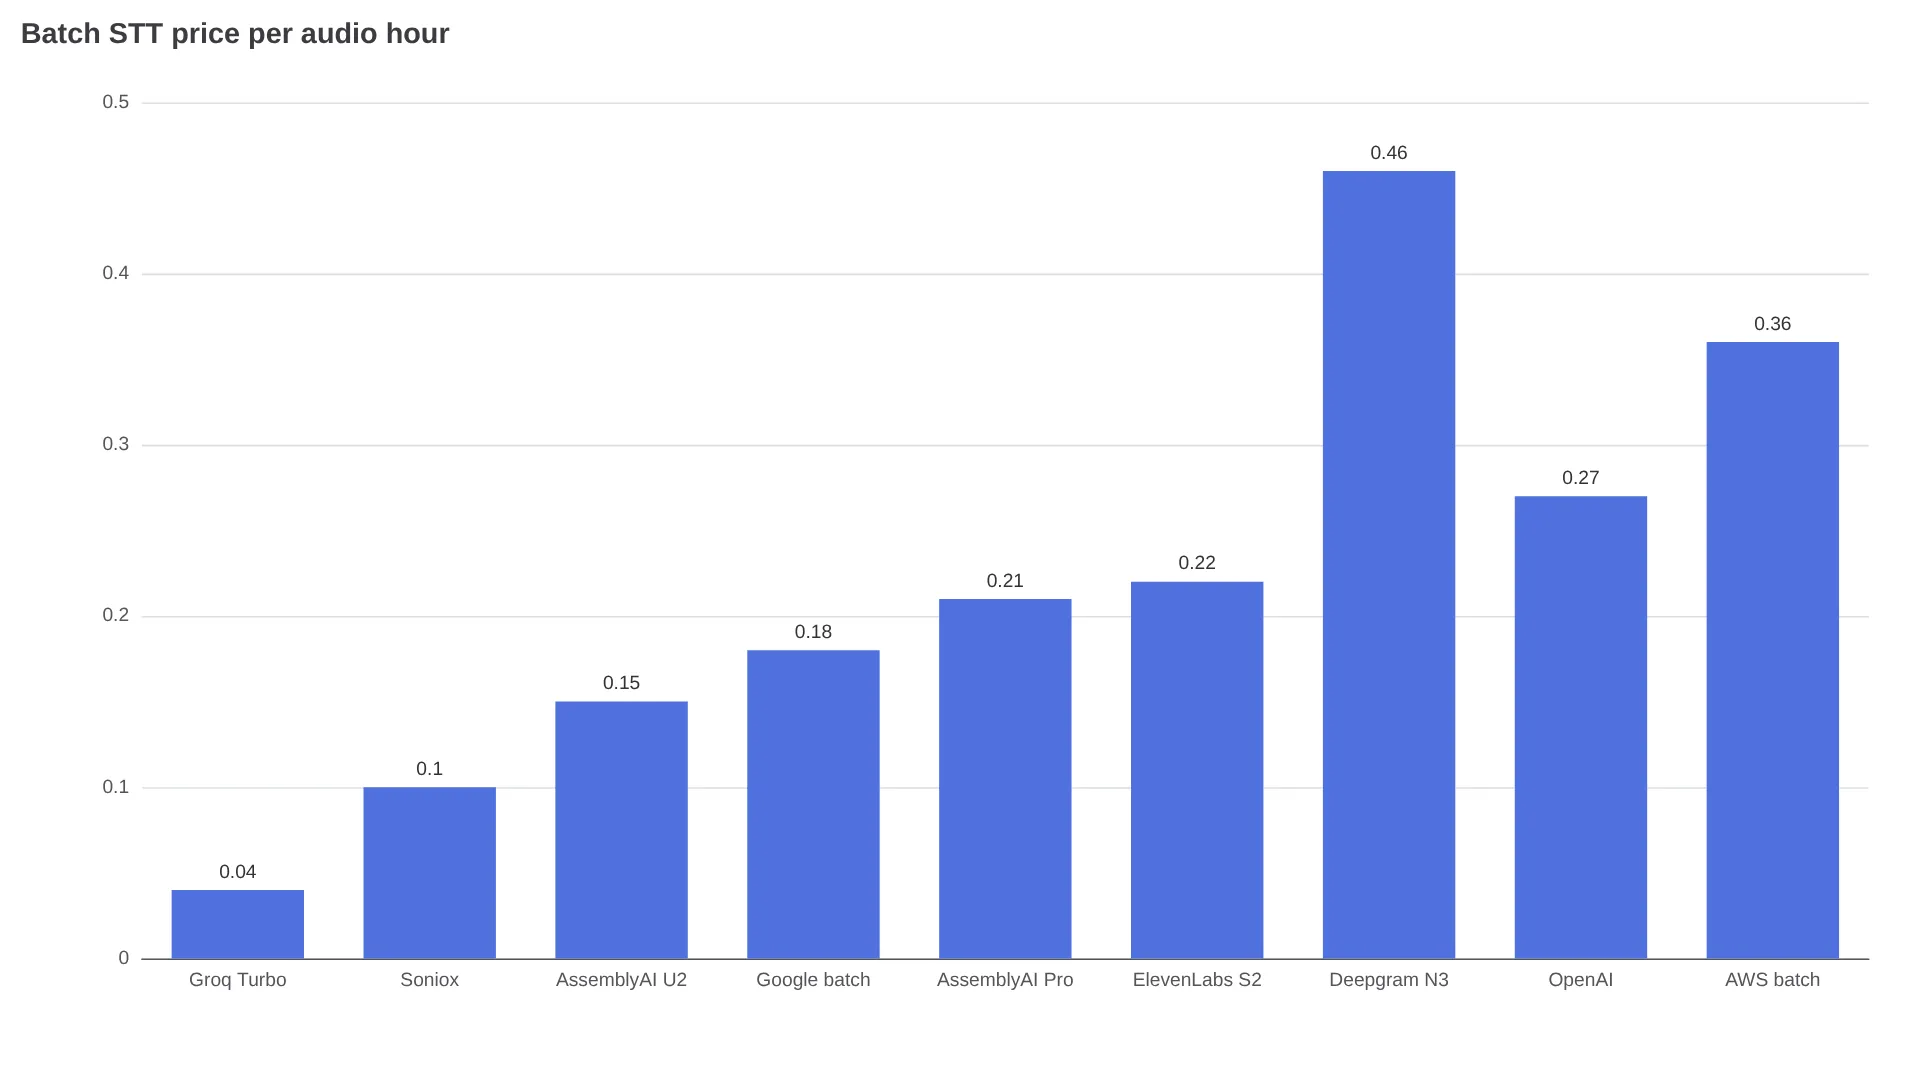
| Provedor | Em lote | Streaming / tempo real | Idiomas | Oferta inicial gratuita |
|---|---|---|---|---|
| Groq Whisper | Large v3 Turbo $0.04/h | Sem endpoint de streaming | Conjunto multilíngue do Whisper | Plano gratuito com limites |
| Soniox | ~$0.10/h assíncrono | ~$0.12/h em tempo real | 60+ em um único modelo | Nenhuma informada |
| AssemblyAI | Universal-2 $0.15/h; Universal-3.5 Pro $0.21/h | Universal-Streaming $0.15/h; Pro Realtime $0.45/h | 99 no U2; 18 no 3.5 Pro | Crédito de $50, sem cartão |
| Google Cloud | Dynamic Batch $0.18/h; Standard $0.96/h | Standard $0.96/h nos primeiros 500 mil minutos | 125+ localidades declaradas | Crédito Cloud de $300 |
| ElevenLabs Scribe | Scribe v2 $0.22/h | Scribe v2 Realtime $0.39/h | 90+ | ~4,5 h no plano gratuito |
| Deepgram | Nova-3 $0.26–$0.46/h por faixa (promocional vs. regular monolíngue) | Nova-3 promocional ~$0.29/h; Flux English $0.39/h ($0.0065/min) | 45+ | Crédito de $200 |
| OpenAI | gpt-transcribe $0.27/h ($0.0045/min) | gpt-live-transcribe $1.02/h ($0.017/min) | Declarados por modelo; Whisper 98 | Nenhuma informada |
| AWS Transcribe | $0.36/h ($0.006/min) | $0.60/h ($0.01/min) | Amplo, varia conforme o recurso | 60 min/mês por 12 meses |
| Speechmatics | Melia 1 $0.24/h base | Linden 1 $0.30/h; Enhanced $0.80/h | 55+ | Crédito de $100 |
| Gladia | Solaria-3 €0.16/h | €0.68/h | 100+ no Solaria-1; 6 no Solaria-3 | Crédito de €50, por 1 ano |
A faixa do Deepgram reflete o preço promocional e o regular para áudio pré-gravado monolíngue. Confirme a faixa vigente na página de preços do Deepgram antes de montar seu orçamento.
A armadilha do áudio multicanal
Uma hora de áudio estéreo nem sempre equivale a uma hora faturável. AssemblyAI e Google cobram cada canal separadamente. Assim, uma chamada de 60 minutos com dois canais no Universal-2 custa $0.15 x 2 = $0.30. A mesma chamada no Google Standard custa $0.96 x 2 = $1.92. O AWS Transcribe inclui até dois canais na cobrança por duração, então essa chamada estéreo fica perto de $0.36 no processamento em lote na região US East, no exemplo de alto volume citado pela CometAPI. Verifique como os canais são contabilizados antes de comparar quaisquer dois valores em $/hora.
Recursos extras que mudam o ranking
A transcrição básica é apenas o ponto de partida. No detalhamento por item da CometAPI, o Deepgram Nova-3 monolíngue para áudio pré-gravado, a $0.0077/min, passa a $0.0097/min com diarização e a $0.0117/min com diarização mais redação de dados sensíveis; o uso de keyterms acrescenta outros $0.0013/min. O AssemblyAI cobra $0.02/hora pela diarização em gravações, mas $0.12/hora pela diarização em streaming. O ElevenLabs adiciona $0.08/hora por keyterms em tempo real e $0.07/hora pela detecção de entidades.
Custo total por transcrição aceita = processamento da API + recursos pagos + novas tentativas + armazenamento/transferência + tempo de correção humana. No exemplo da CometAPI, considerando um revisor a $30/hora, uma rota de $0.15/hora que exigia 8 minutos de ajustes totalizou $4.15, enquanto uma rota de $0.60/hora que exigia 3 minutos chegou a $2.10.
Se você está criando um agente de voz, teste primeiro a alternância entre falas
Agentes de voz costumam falhar em interrupções e pausas, não no WER de um áudio limpo. Compare lado a lado o mecanismo de alternância, os controles de contexto, o preço em tempo real e a principal limitação de cada opção.
| Provedor | Alternância entre falas | Preço em tempo real | Limitação |
|---|---|---|---|
| Deepgram Flux | Eventos EndOfTurn, limiar ajustável; modo eager + TurnResumed; segundo a documentação do Deepgram citada pelo Dexto, o modo eager pode aumentar em 50–70% as chamadas ao LLM | Flux English $0.0065/min; streaming Nova-3 promocional ~$0.0048/min | Flux multilíngue em 10 idiomas; promoções expiram |
| AssemblyAI | Prompt + keyterms + 1.750 caracteres da resposta anterior do agente; detecção de encerramento baseada em pontuação | Universal-Streaming $0.15/h; Pro Realtime $0.45/h | A faixa barata de streaming é focada em inglês; o tempo de socket ocioso é cobrado |
| ElevenLabs Scribe | ~150 ms de latência do modelo, segundo o fornecedor; 90+ idiomas; diarização em lote para até 32 falantes | Scribe v2 Realtime $0.39/h + $0.08/h por keyterms em tempo real | Diarização em tempo real não listada; o número do fornecedor exclui rede e stack do agente |
| OpenAI | Deltas da transcrição via WebSocket; sem VAD no servidor; o cliente confirma o turno; sem rótulos de falante ou timestamps de palavras em tempo real | gpt-live-transcribe $0.017/min | É necessário detectar o encerramento no cliente; maior $/hora em tempo real da tabela |
Meça também o atraso das chamadas de ferramentas e do LLM. Um desenvolvedor de agente para hotéis relatou no X de 5 a 7 segundos de silêncio depois de uma chamada de ferramenta, apesar do STT rápido: @albertolco88. Essa diferença de ponta a ponta nunca aparece em tabelas que medem apenas o STT.
Se você transcreve gravações, avalie texto e diarização separadamente
Um benchmark de usuário publicado no r/speechtech testou uma reunião real em sueco, com 2 horas e 22 minutos e seis falantes, comparada ao ground truth do pyannote. O autor concluiu que o Deepgram foi o mais rápido e teve o melhor desempenho em diarização; o ElevenLabs foi melhor no texto transcrito em sueco, mas não identificou dois dos seis falantes; e o AssemblyAI ficou próximo em precisão, embora tenha sido muito mais lento naquele fluxo. Em vez de declarar um vencedor, o autor combinou provedores.
"O Deepgram é o mais forte dos três e foi muito rápido." — u/DoctorNootNoot no r/speechrecognition
Três verificações específicas para gravações ajudam a separar APIs úteis das frustrantes:
- Alternância de idioma dentro da mesma fala. Desenvolvedores no tópico sobre reuniões multilíngues relatam trechos confusos quando os falantes misturam finlandês e inglês ou espanhol e inglês no meio da frase. O Universal-3.5 Pro lista alternância entre 18 idiomas; Gladia e Speechmatics posicionam a detecção multilíngue como um diferencial. Nenhum fornecedor lida perfeitamente com todos os pares europeus de imediato, então teste os pares que você realmente usa.
- Diarização em escala. Pergunte quantos falantes são suportados — a diarização em lote do ElevenLabs lista 32, o Azure lista 35 e a diarização em tempo real do Speechmatics não informa um limite —, se a diarização em tempo real existe e quanto ela acrescenta ao preço e à latência. O mesmo autor do benchmark sueco descreveu o tempo de resposta do AssemblyAI como lento demais para seu fluxo de produção, embora a precisão do texto fosse próxima.
- Arquivos grandes. O OpenAI limita uploads de áudio a 25 MB, o que complica gravações longas. APIs voltadas para lote aceitam tarefas baseadas em URL, arquivos de várias horas e consultas assíncronas persistentes. Um usuário no tópico sobre transcrição em lote relatou que "não consegue fazer upload de arquivos grandes" e não entendia o processamento por URL — uma barreira de adoção que nenhuma tabela de WER captura.
O Whisper large-v3 hospedado por você continua sendo a opção offline. No teste da Echosaw com o mesmo áudio, realizado em 22,7 minutos de fala em inglês lida e de reuniões, as APIs hospedadas ficaram abaixo de 2,1% de WER em capítulos limpos, enquanto uma configuração do Whisper com duas vCPUs marcou 10–17%, com trechos perdidos, além de 32,7% no áudio de reunião a 0,5x do tempo real. Em produção, o self-hosting normalmente usa uma GPU com VAD e divisão em blocos para obter uma vazão prática.
Nuvem, especialista ou hospedagem própria
- Nativo de hyperscaler. O Google Dynamic Batch, a $0.18/hora, atende grandes arquivos sem urgência que já estejam no GCP; o Standard, a $0.96/hora, pesa no uso em tempo real. O AWS Transcribe se encaixa em fluxos de chamadas com S3/IAM e inclui dois canais. O Azure Speech cobra perto de $0.18/hora no lote e perto de $1.00/hora em tempo real, com uma franquia gratuita de 5 horas/mês em tempo real. Considere armazenamento, transferência e taxas de redação fora da linha de transcrição.
- Lote gerenciado barato. O Groq Whisper Turbo, a $0.04/hora, é mais barato que todas as APIs gerenciadas para transcrições simples em lote, mas não oferece streaming nem informa suporte à diarização. O Soniox, perto de $0.10/hora no modo assíncrono, é o menor valor de lote da tabela acima entre as opções que combinam 60+ idiomas com diarização e timestamps incluídos, embora tenha uma cobertura independente de benchmarks mais limitada.
- Pipeline híbrido. Use o ElevenLabs para o texto transcrito quando ele levar vantagem, o Deepgram para a diarização quando ele for melhor e o Whisper ou Groq para o excedente barato em lote. Essa divisão aumenta o custo de orquestração, mas, quando nenhum provedor lidera simultaneamente em texto e identificação de falantes no seu áudio, duas chamadas baratas podem sair melhor do que uma rodada cara de correções.
Nota sobre migração: a OpenAI marca whisper-1, gpt-4o-transcribe, gpt-4o-mini-transcribe e gpt-4o-transcribe-diarize como obsoletos, com desligamento programado para February 26, 2027. Equipes que ainda usam esses modelos devem testar substitutos antes do prazo, especialmente quando houver diferenças no comportamento de timestamps de palavras e diarização.
Faça um teste de 7 dias com seu próprio áudio
Os números de WER dos fornecedores usam conjuntos de dados, normalizadores e versões de modelo diferentes e não podem ser comparados diretamente. Separe de 30 a 50 trechos reais de chamadas ou reuniões com seus sotaques, ruídos e vocabulário, faça a transcrição de referência uma única vez e depois envie ou transmita o mesmo áudio para dois ou três provedores, mantendo o restante do pipeline inalterado.
Registre os segundos de áudio, a quantidade de canais, os recursos ativados, a versão do modelo, a latência dos resultados parciais, o atraso de finalização, o atraso de ponta a ponta do agente, a taxa de erro de diarização e os minutos de correção por transcrição aceita. Avalie separadamente os termos críticos para o negócio — nomes, e-mails, valores e termos de produto — em vez de olhar apenas para o WER genérico. A rota com o menor $/hora que dobra o trabalho de revisão geralmente perde no custo total.
Perguntas frequentes
Qual é a API de fala para texto mais barata em 2026?
Soniox, perto de $0.10/hora, e AssemblyAI Universal-2, a $0.15/hora, são os menores preços de tabela entre as opções gerenciadas de lote com suporte à diarização na tabela acima. O Groq Whisper Turbo, a $0.04/hora, é mais barato para processamento bruto em lote, mas não oferece streaming nem diarização.
Qual API tem a menor latência em streaming?
Segundo o levantamento de afirmações dos fornecedores feito pelo Dexto: ElevenLabs com ~150 ms de latência do modelo, Deepgram com ~260 ms até o fim do turno e Speechmatics com finalização média <350 ms. Teste o atraso parcial, de finalização e de ponta a ponta nas suas próprias chamadas.
Qual API de STT é melhor para agentes de voz?
Deepgram Flux para alternância nativa entre falas, AssemblyAI para prompts de contexto, ElevenLabs Realtime para ampla cobertura de idiomas em um stack de voz do ElevenLabs e transcrição ao vivo da OpenAI para stacks nativos da OpenAI que consigam implementar a detecção de encerramento.
Qual lida melhor com áudio multilíngue e alternância de idiomas?
ElevenLabs (90+), AssemblyAI U2 (99; 3.5 Pro 18 com alternância de idiomas), Gladia Solaria-1 (100+) e Speechmatics (55+). Teste o par exato que você utiliza; a alternância no meio da frase ainda pode deixar os trechos de transição confusos.
Devo usar um único fornecedor ou combinar transcrição e diarização?
Se um provedor lidera no texto, mas fica atrás na identificação dos falantes no seu áudio, como no relatório sueco com seis falantes citado acima, combinar provedores pode ser melhor do que usar qualquer um deles sozinho. Coloque na conta o custo de orquestração e da cobrança dupla em relação ao tempo de correção economizado.
O OpenAI Whisper será descontinuado?
A OpenAI marcou modelos antigos de transcrição, incluindo whisper-1 e as variantes do gpt-4o-transcribe, como obsoletos, com desligamento programado para February 26, 2027. Os caminhos atuais são gpt-transcribe para arquivos e gpt-live-transcribe para áudio ao vivo.
| Carga de trabalho | Comece com | Motivo |
|---|---|---|
| Grande arquivo de gravações | AssemblyAI U2 / Google Dynamic Batch / Groq Whisper | Menor $/hora; Groq é o mais barato quando a diarização não é necessária |
| Agente de voz ao vivo | Deepgram Flux / AssemblyAI Realtime / ElevenLabs Realtime | Alternância entre falas, prompts de contexto e baixa latência do modelo |
| Reuniões multilíngues | ElevenLabs Scribe v2 / Speechmatics / Gladia | Posicionamento para 90+/55+/100+ idiomas e recursos de alternância de idioma |
| Nativo de AWS ou GCP | Transcribe / Cloud STT | IAM, armazenamento e compras corporativas pesam mais que o preço de tabela |
| Offline ou residência de dados | Whisper hospedado por você | O áudio nunca sai do seu hardware |
Leituras relacionadas: Melhor API de texto para fala, Melhor API de clonagem de voz em 2026, Guia da API Gemini 3.5 Transcribe.