 AIREITER
Quer transformar uma gravação em texto aproveitável ou gerar legendas em tempo real a partir de um microfone? A Gemini 3.5 Transcribe merece atenção pela limpeza do texto, pelo suporte a vocabulário personalizado e pelo tratamento multilíngue. Mas os dois caminhos da API têm limites bem diferentes: a API de arquivos é mais indicada para transcrições persistentes, enquanto a Live API atende sessões curtas que exigem baixa latência.
Na prática, use a API de arquivos — a menos que precise de legendas ao vivo
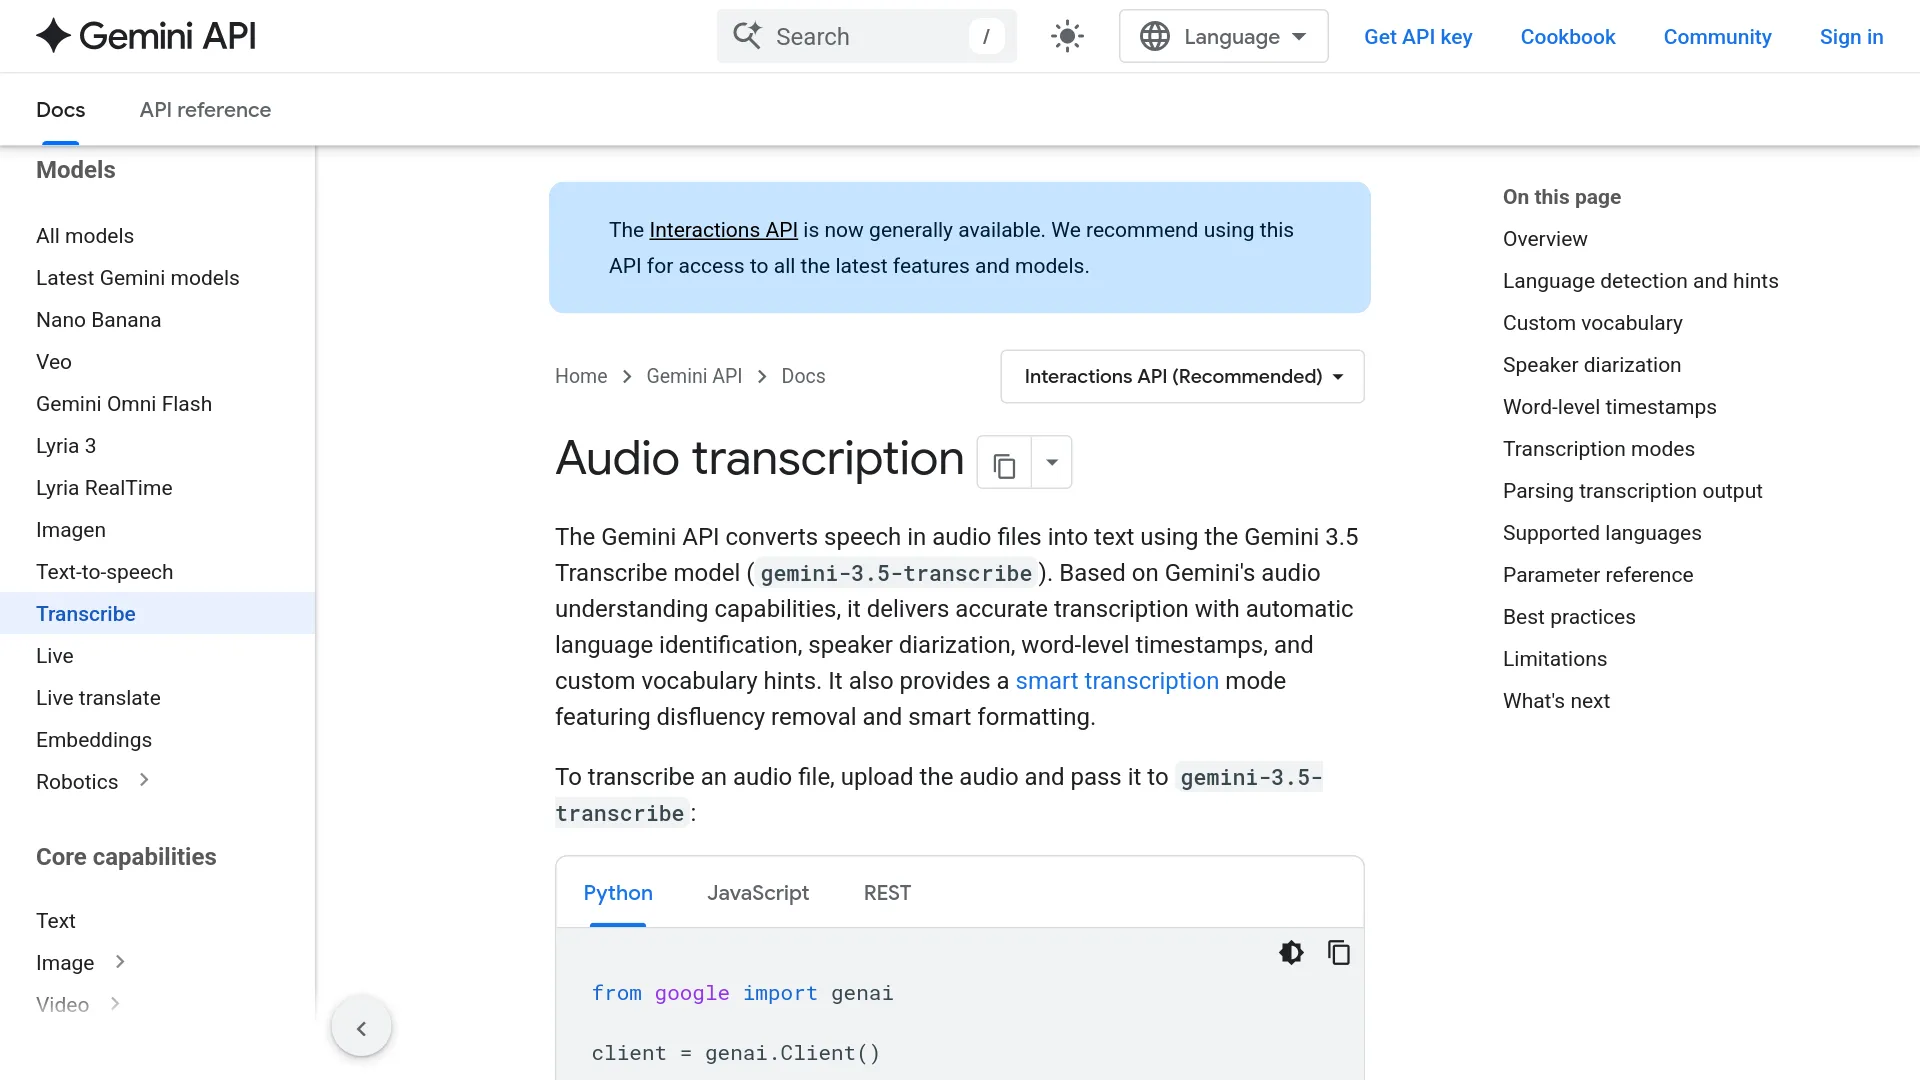
A Gemini 3.5 Transcribe é a família de modelos de conversão de fala em texto do Google, disponível em prévia pública desde 26 de agosto de 2026. A documentação separa os IDs de modelo, transportes, eventos de saída e restrições para arquivos gravados e áudio em tempo real.
| Necessidade | ID do modelo | Caminho da API | Limite importante |
|---|---|---|---|
| Reuniões, chamadas e gravações enviadas | gemini-3.5-transcribe | Interactions API | Até 1 hora em uma requisição unária padrão; 30 minutos com diarização ou timestamps por palavra |
| Legendas ao vivo, entrada de microfone e interfaces de voz | gemini-3.5-transcribe-live | Live API | Sessões contínuas de 10 minutos; sem diarização ao vivo ou timestamps por palavra |
Para arquivar reuniões, analisar chamadas ou preparar legendas, comece com gemini-3.5-transcribe. Já para uma prévia de legendas ou uma interface de comunicação por voz, escolha gemini-3.5-transcribe-live. O guia de transcrição de áudio gravado e o guia da Live API apresentam os fluxos separadamente.
Ainda é uma funcionalidade exclusiva da prévia
O Google anunciou a Gemini 3.5 Transcribe em 26 de agosto de 2026 e lista a API para desenvolvedores como prévia pública no Google AI Studio e no Google Antigravity. O acesso empresarial também aparece em prévia na Gemini Enterprise Agent Platform. Como ainda não se trata de uma versão geralmente disponível, cobertura regional, cotas e estabilidade podem variar em relação a um serviço de voz já consolidado. Por isso, teste arquivos representativos antes de transferir um volume importante para a plataforma.
Preços da Gemini 3.5 Transcribe em valores mais fáceis de planejar
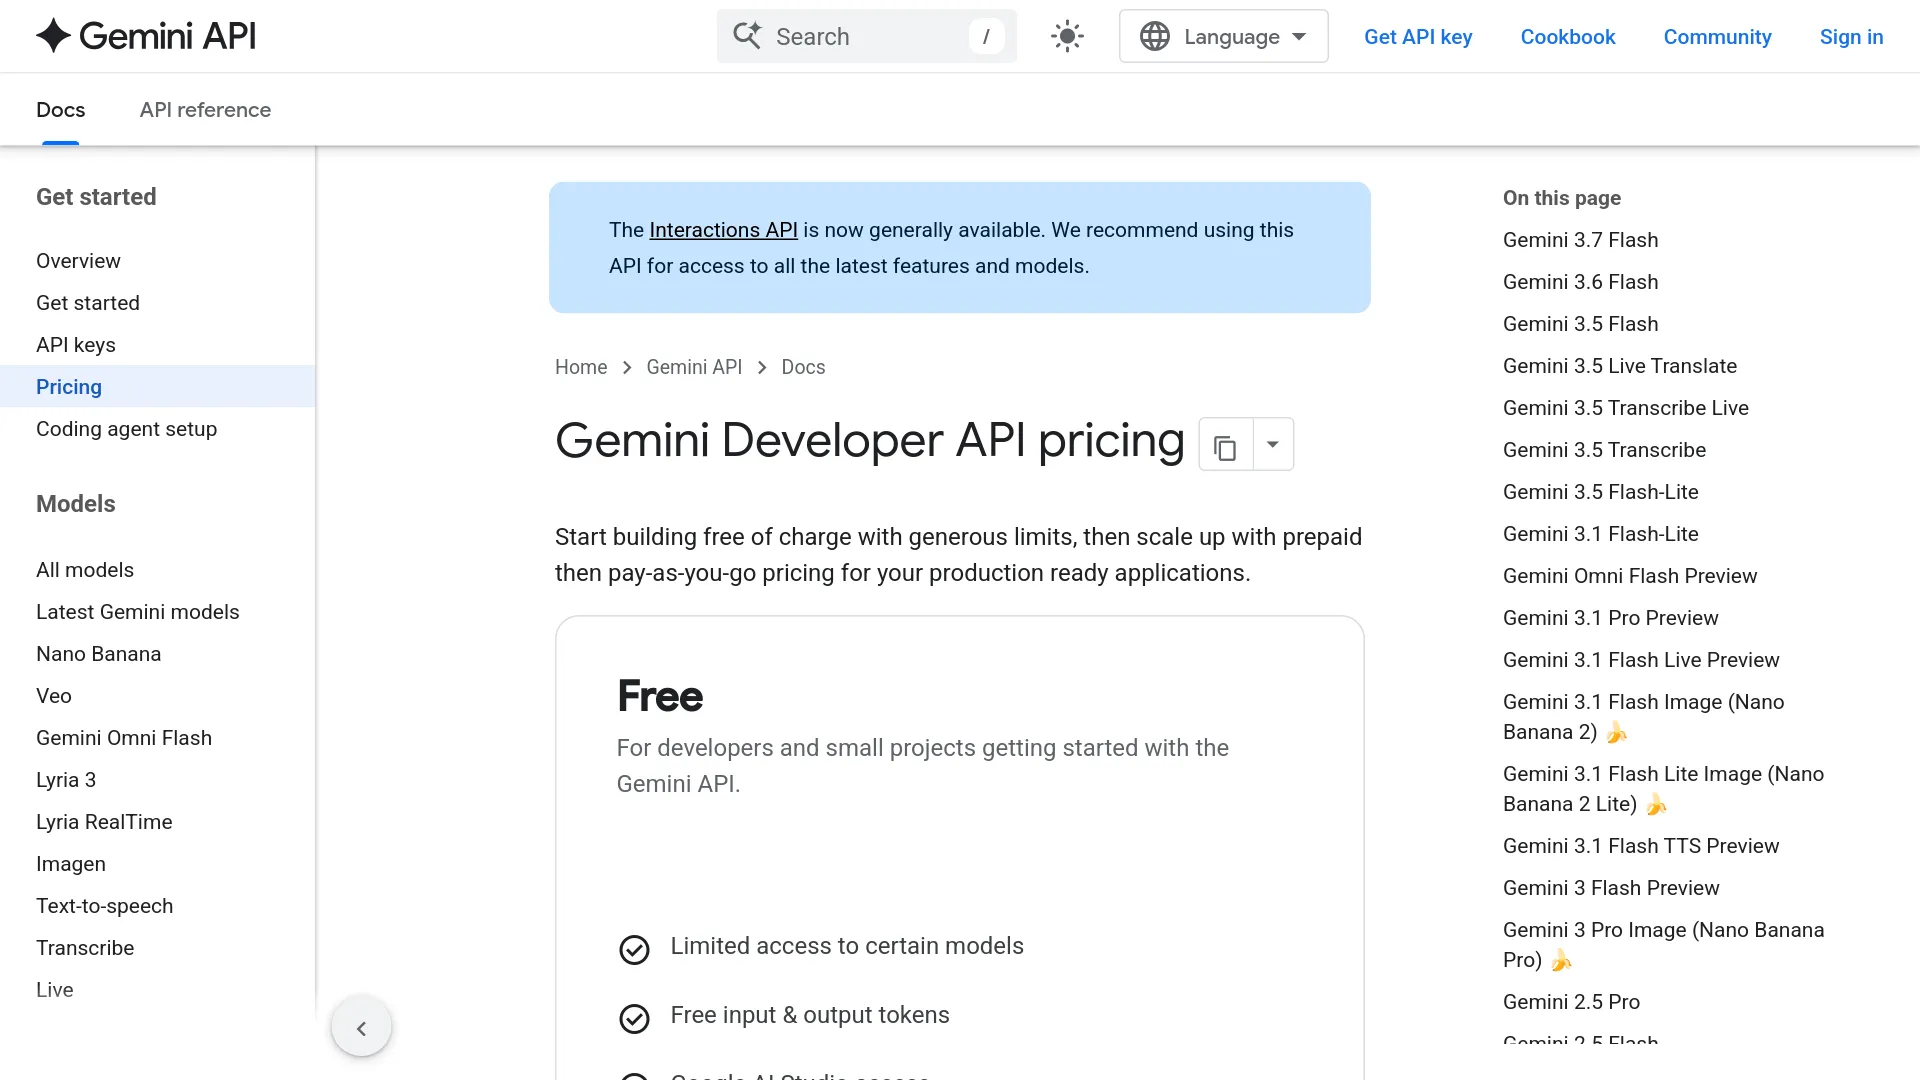
A página de preços da Gemini API trabalha com tarifas por token, e não com uma taxa fixa por transcrição. No retrato atual, o Google cobra US$ 2 por milhão de tokens de entrada de áudio e US$ 12 por milhão de tokens de saída de texto para gemini-3.5-transcribe.
Segundo a documentação de áudio do Google, o áudio é representado por 32 tokens por segundo, ou 1.920 tokens de áudio por minuto. Só a entrada de áudio, portanto, custa aproximadamente US$ 0,00384 por minuto com a tarifa de US$ 2 por milhão de tokens — antes de considerar a saída de texto e outros tokens cobrados.
| Modelo | Base de preço publicada | Estimativa combinada indicativa | Estimativa indicativa para 1 hora |
|---|---|---|---|
gemini-3.5-transcribe | US$ 2 por milhão de tokens de entrada de áudio + US$ 12 por milhão de tokens de saída de texto | Cerca de US$ 0,005/min | Cerca de US$ 0,30/hora |
gemini-3.5-transcribe-live | Processamento de áudio e texto ao vivo baseado em tokens | Cerca de US$ 0,009/min | Cerca de US$ 0,54/hora |
Os valores combinados variam conforme o volume de texto gerado. São estimativas para planejamento, não tarifas garantidas por minuto. Saídas mais densas, contexto repetido e instruções adicionais podem alterar a conta. Consulte a tabela de preços atual antes de comprometer um grande volume, já que os valores de uma versão em prévia podem mudar.
As diferenças de recursos que realmente pesam em produção
Transcrição literal ou inteligente
VERBATIM é o modo padrão na documentação de transcrição do Google. Ele preserva palavras de preenchimento, repetições, pausas, falsos começos e a correção feita pelo próprio falante. É a opção certa quando a transcrição precisa funcionar como registro, evidência, fonte de legendas ou entrada para controle de qualidade.
SMART transforma o conteúdo para facilitar a leitura. O modo remove disfluências, resolve autocorreções, acrescenta pontuação e estrutura e pode formatar datas, moedas, números, listas e parágrafos. A frase falada “terça-feira — não, quarta-feira” pode virar apenas “quarta-feira” no resultado limpo.
O modo inteligente não é compatível com diarização de falantes nem com timestamps por palavra. Se o aplicativo precisa de anotações legíveis sem abrir mão da possibilidade de auditoria, gere primeiro a saída verbatim e faça a limpeza em uma cópia separada.
Vocabulário personalizado e alternância de idiomas
O Google documenta detecção automática de idioma em mais de 85 localidades, inclusive em casos de alternância entre idiomas. Quando o idioma já é conhecido, envie um código BCP-47, como en-US ou es-ES, para direcionar o reconhecimento.
O vocabulário personalizado aceita até 1.000 termos, mas a orientação prática do Google diz que os melhores resultados costumam aparecer com 100 termos ou menos. Prefira nomes de produtos, siglas, nomes próprios, termos médicos ou palavras técnicas que sejam realmente distintivos, em vez de uma lista de palavras comuns.
Identificação de falantes e timestamps por palavra
O áudio gravado pode retornar a atribuição de cada fala e o tempo correspondente a cada palavra. A documentação da API estabelece o máximo de oito falantes, enquanto o anúncio de lançamento destaca a atribuição para até três e classifica o suporte a três ou mais falantes como experimental.
Os timestamps por palavra funcionam no modo verbatim e informam os offsets de início e fim de cada termo. O Google alerta que esse recurso pode reduzir a precisão geral da transcrição. Além disso, diarização e timestamps diminuem o limite padrão de duração do áudio de uma hora para 30 minutos.
| Requisito | Compatível? | Ressalva |
|---|---|---|
| Identificação de falantes em áudio gravado | Sim | Até 8 na documentação; a atribuição de 3 ou mais é experimental |
| Timestamps por palavra em áudio gravado | Sim | Apenas no modo verbatim; pode reduzir a precisão |
| Identificação de falantes na transcrição ao vivo | Não | Use áudio gravado quando a atribuição for importante |
| Timestamps por palavra na transcrição ao vivo | Não | A saída ao vivo é incremental e orientada por enunciados |
| Modo smart com identificação ou timestamps | Não | Escolha verbatim para obter essas anotações |
Como enviar um arquivo gravado pela Gemini 3.5 Transcribe API
O guia de áudio gravado do Google descreve três etapas: enviar o arquivo, passar a URI retornada para a Interactions API e ler a transcrição concluída em interaction.output_text.
- Envie o áudio pela Files API. Esse caminho é indicado para gravações com mais de alguns segundos ou para arquivos que serão reutilizados.
- Guarde a URI retornada e o tipo MIME, como
audio/mp3. - Envie a URI para
gemini-3.5-transcribepela Interactions API. - Leia a saída de texto e, quando solicitado, consulte as anotações
word_infopara obter dados de falante e temporização.
Com o SDK oficial, o fluxo de upload e transcrição pode ser resumido neste exemplo:
from google import genai

client = genai.Client()
file = client.files.upload(file="path/to/sample.mp3")

interaction = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[{
        "role": "user",
        "content": [{
            "type": "audio",
            "uri": file.uri,
            "mime_type": file.mime_type,
        }],
    }],
)

print(interaction.output_text)
Depois que o upload pela Files API retornar FILE_URI, uma requisição REST compacta fica assim:
curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.5-transcribe",
    "input": [{
      "role": "user",
      "content": [{
        "type": "audio",
        "uri": "FILE_URI",
        "mime_type": "audio/mp3"
      }]
    }]
  }'
Para gerar uma transcrição limpa, adicione uma configuração de transcrição com o modo smart:
{
  "generation_config": {
    "transcription_config": {
      "mode": { "type": "smart" },
      "language_codes": ["en-US"],
      "custom_vocabulary": ["Kubernetes", "BigQuery", "Acme Ledger"]
    }
  }
}
Para obter identificação de falantes e tempos por palavra, use o modo verbatim:
{
  "generation_config": {
    "transcription_config": {
      "mode": {
        "type": "verbatim",
        "diarization_mode": "speaker",
        "timestamp_granularities": ["word"]
      }
    }
  }
}
Não combine a configuração smart com diarização ou timestamps. Pelas regras documentadas para os modos da API, essa é uma decisão de arquitetura, não apenas uma preferência de formatação.
Como funciona a transcrição ao vivo
A Live API abre uma conexão bidirecional de streaming usando gemini-3.5-transcribe-live. O cliente envia áudio continuamente e recebe dois eventos de texto:
interim_input_transcription: uma hipótese mutável e de baixa latência, adequada para legendas ou prévias na interface.input_transcription: texto finalizado, pronto para ser gravado na transcrição ou no estado do aplicativo.
O guia da API ao vivo especifica áudio PCM bruto de 16 bits, 16 kHz, mono e little-endian. A recomendação é trabalhar com blocos de aproximadamente 100 milissegundos, contendo cerca de 1.024–2.048 frames. Clientes de navegador e dispositivos móveis devem usar tokens efêmeros restritos, em vez de expor uma chave de API comum. Nos exemplos do Google, o token pode ser usado uma única vez e expira em 30 minutos.
O endpoint ao vivo oferece detecção automática de idioma, dicas BCP-47, vocabulário personalizado e saída VERBATIM ou SMART. Ele não oferece diarização de falantes nem timestamps por palavra em tempo real. Cada sessão contínua é limitada a 10 minutos; transmissões mais longas exigem gerenciamento de sessões e união das transcrições no nível da aplicação.
Para detectar os limites entre turnos de fala, a Live API oferece três abordagens:
- VAD automático: o servidor detecta o início e o fim da fala.
- VAD híbrido: um detector no cliente sinaliza o fim da fala, enquanto a detecção do servidor permanece como alternativa.
- VAD manual: uma interface push-to-talk envia explicitamente os eventos de início e fim da atividade.
O que as primeiras evidências mostram — e o que ainda não mostram
O Google informa WER médio de 4,0% em streaming e 2,6% sem streaming, com base no Artificial Analysis. O anúncio de lançamento também apresenta resultados do FLEURS de 5,50% de WER em streaming e 5,04% de WER sem streaming, além de uma melhoria de 70% no tempo até a transcrição final em comparação com o Chirp 3.
Esses números são evidências divulgadas pelo fornecedor ou citadas pelo próprio fornecedor no lançamento, não um teste independente comparando a Gemini 3.5 Transcribe diretamente com outros serviços. O benchmark público de STT da koedesk mediu a Gemini 3.5 Flash e outros mecanismos, mas não avaliou diretamente a Gemini 3.5 Transcribe.
Os primeiros usuários querem saber, entre outras coisas, quais são os limites de duração para arquivos e sessões ao vivo, quais transcrições de referência foram usadas no WER e se números de telefone ou IDs de pedidos podem ser confiados em trechos silenciosos. Em vez de depender apenas do WER médio, teste nomes, IDs, números, mudanças de falante, temporização e latência com áudios representativos.
Quando escolher a Gemini 3.5 Transcribe — e quando esperar
| Situação | Adequação | Configuração inicial recomendada |
|---|---|---|
| Anotações limpas de reuniões ou ditado | Forte | API de arquivos, SMART, dica explícita de idioma quando conhecido |
| Registro jurídico, de conformidade ou arquivamento | Condicional | API de arquivos, VERBATIM; revise manualmente os trechos críticos |
| Chamadas gravadas com vários falantes | Condicional | API de arquivos, VERBATIM + diarização; mantenha as sessões em até 30 minutos |
| Legendas sincronizadas por palavra | Condicional | API de arquivos, VERBATIM + timestamps por palavra; valide a temporização e a precisão |
| Legendas ao vivo | Forte para sessões curtas | Live API, usando apenas eventos finais para o texto confirmado |
| Agente de voz de longa duração | Exige engenharia | Divida as sessões antes do limite de 10 minutos e gerencie reconexões |
| Processamento local, offline ou confidencial | Baixa adequação | O fluxo documentado envia o áudio ao serviço do Google; considere um caminho de ASR self-hosted |
A Gemini 3.5 Transcribe se encaixa melhor quando a transcrição é apenas a primeira etapa de um fluxo maior: limpar a fala, preservar o vocabulário técnico, identificar os falantes e encaminhar o texto estruturado. Ela é menos indicada quando o único requisito é uma transcrição literal barata ou o processamento obrigatoriamente offline.
FAQ da Gemini 3.5 Transcribe API
A Gemini 3.5 Transcribe é gratuita?
O Google lista um nível gratuito para o uso da Gemini API, mas as cotas e a disponibilidade dos modelos podem mudar. O uso pago é baseado em tokens; atualmente, a página de preços mostra estimativas combinadas indicativas de cerca de US$ 0,005 por minuto para transcrição gravada e US$ 0,009 por minuto para o modelo ao vivo.
Qual é a diferença entre os modelos de arquivo e ao vivo?
gemini-3.5-transcribe processa gravações enviadas pela Interactions API e oferece diarização e timestamps por palavra no áudio gravado. gemini-3.5-transcribe-live transmite PCM bruto pela Live API, retorna eventos intermediários e finais e está limitado a sessões de 10 minutos, sem diarização ao vivo ou timestamps por palavra.
Posso processar uma gravação de três horas em uma única requisição?
Não com a configuração dedicada de transcrição gravada. O limite padrão de uma requisição unária é de uma hora, e diarização ou timestamps por palavra reduzem esse limite para 30 minutos. Um fluxo mais longo precisa dividir o áudio no nível da aplicação e lidar com cuidado com a continuidade do contexto e dos falantes.
Posso usar a Gemini 3.5 Transcribe offline?
O fluxo documentado envia ou transmite o áudio para o serviço do Google. O Google não descreve uma versão offline ou self-hosted da Gemini 3.5 Transcribe.
A integração inicial mais segura
Comece com uma amostra do seu uso real, não com um clipe limpo preparado para demonstração. Execute o mesmo áudio duas vezes: primeiro no modo verbatim, para medir fidelidade, e depois no modo smart, para avaliar legibilidade. Analise separadamente nomes próprios, números, mudanças de falante, variação dos timestamps e custo.
Preserve a transcrição bruta como fonte de verdade, use a saída smart nas anotações voltadas ao usuário e inclua um fallback para falhas de upload ou mudanças no modelo em prévia. Só avance para a Live API depois que o cliente estiver preparado para lidar com blocos PCM de 100 milissegundos, eventos intermediários e finais, tokens efêmeros e o limite de 10 minutos por sessão.