 AIREITER
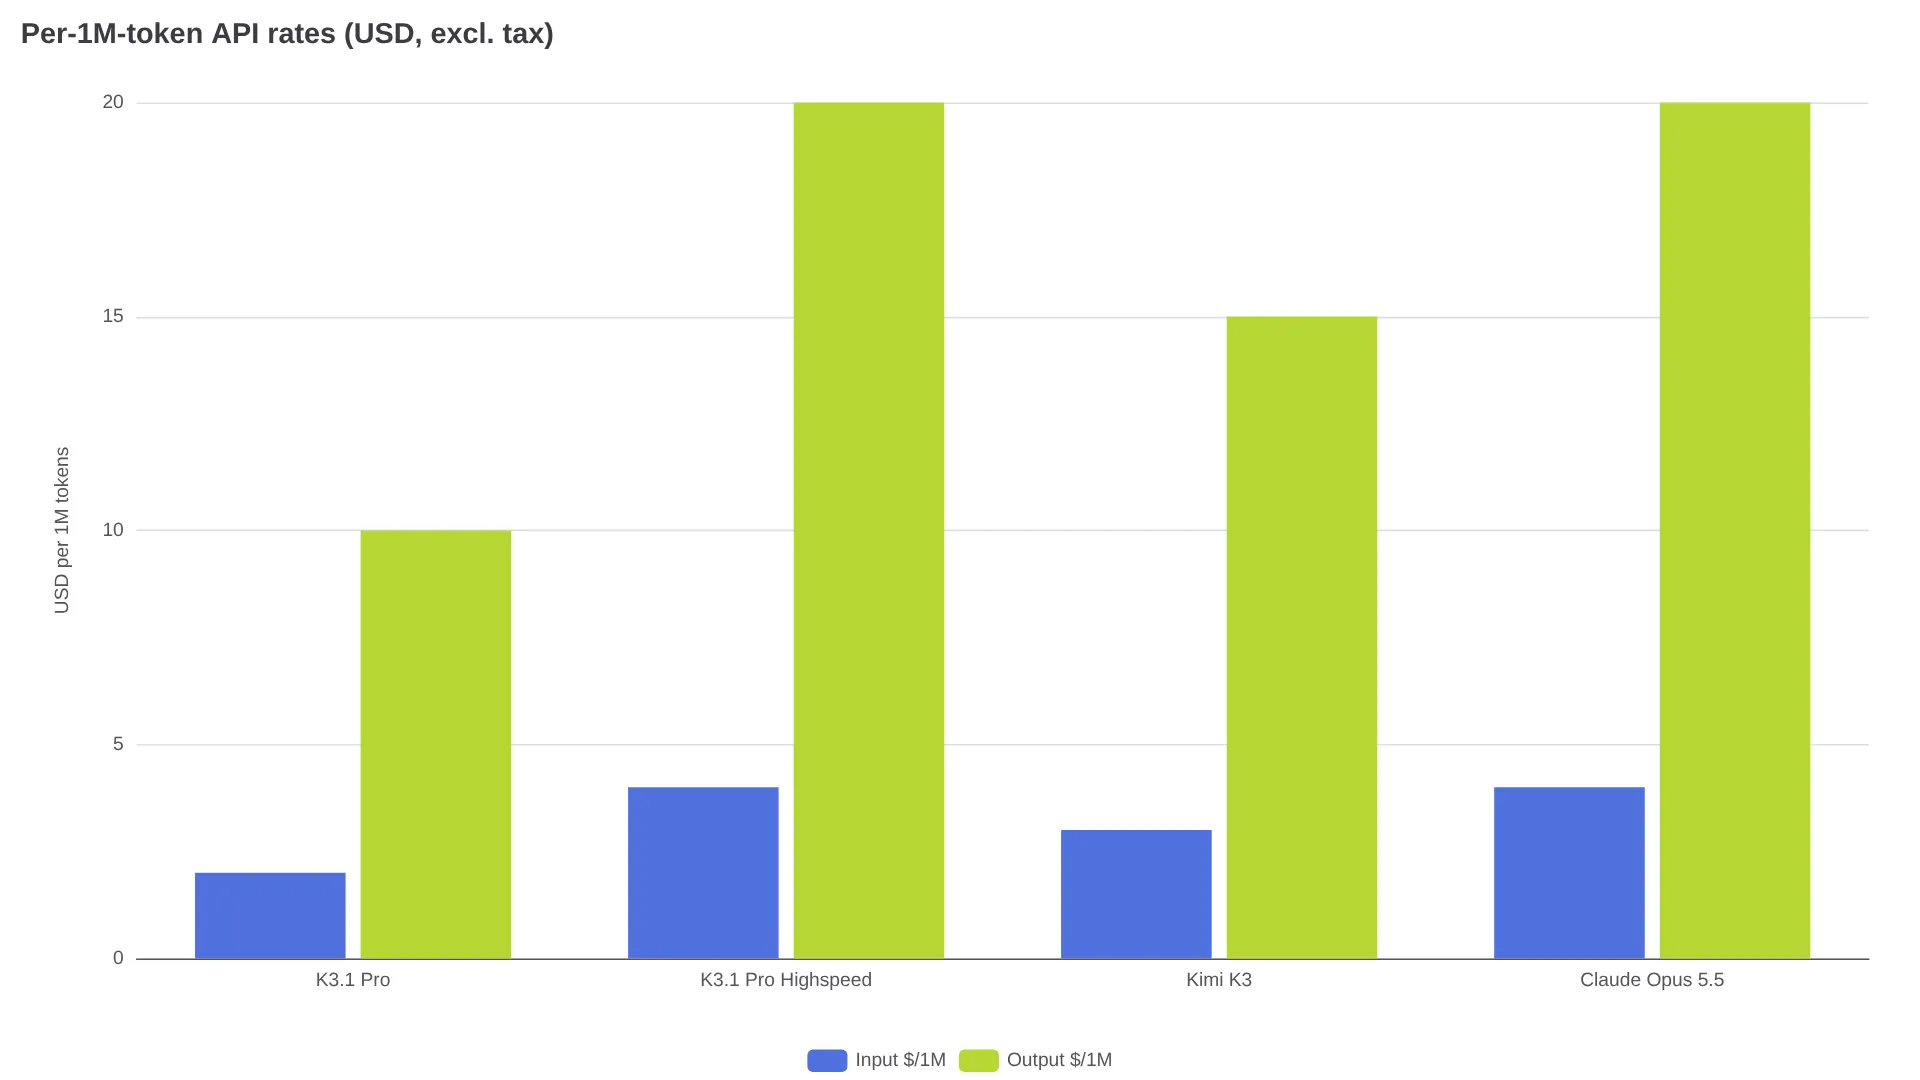
O preço da API Kimi K3.1 Pro depende menos da tabela de US$ 2/US$ 10 e mais do que o raciocínio e o cache acrescentam à fatura. No plano Standard, a entrada custa US$ 2 por 1M de tokens e a saída, US$ 10. O Highspeed dobra os dois valores para reduzir a latência, enquanto leituras com cache hit seguem em US$ 0,20 nos dois níveis (platform.kimi.ai).
| Modelo | Entrada / 1M | Saída / 1M | Leitura com cache hit / 1M | Gravação em cache de 5 min / 1M | Gravação em cache de 1 h / 1M |
|---|---|---|---|---|---|
Kimi K3.1 Pro (kimi-k3.1-pro) | US$ 2,00 | US$ 10,00 | US$ 0,20 | US$ 2,00 | US$ 4,00 |
Kimi K3.1 Pro Highspeed (kimi-k3.1-pro-highspeed) | US$ 4,00 | US$ 20,00 | US$ 0,20 | US$ 4,00 | US$ 8,00 |
| Kimi K3 (geração anterior) | US$ 3,00 | US$ 15,00 | US$ 0,30 | US$ 3,00 | US$ 6,00 |
As tarifas estão em dólares americanos por 1M de tokens, antes de impostos, e valem para toda a janela de contexto de 1M sem adicional por contexto longo, segundo o material oficial de preços da Kimi (kimi.ai).
Uma requisição com 100K de contexto sai por US$ 0,30 — até a fatura entrar na conta
No exemplo mais direto, 100.000 tokens de entrada sem cache e 10.000 tokens de saída custam US$ 0,20 mais US$ 0,10: US$ 0,30. O cálculo usa diretamente as tarifas oficiais de US$ 2/US$ 10. Para estimar uma chamada real, use a fórmula abaixo para o plano Standard; no Highspeed, dobre as tarifas de entrada, saída e gravação em cache:
Total = (uncached_in x 2 + cached_read x 0.20 + write_5m x 2
  + write_1h x 4 + (visible_out + reasoning_out) x 10) / 1M
  + searches x 0.004
A fórmula segue a divisão oficial de custos da Kimi entre entrada sem cache, hits de cache, gravações em cache por TTL e saída (kimi.ai), além dos US$ 0,004 por chamada ao Web Search. Como a cobrança é por uso e por requisição (kimi.ai), repetir uma chamada coloca o mesmo medidor para rodar novamente. O raciocínio está sempre ativo no K3.1 Pro e é cobrado pela tarifa de saída; portanto, os tokens ocultos de raciocínio consomem o mesmo orçamento de US$ 10/1M da resposta visível. Uma resposta de 10.000 tokens visíveis com 40.000 tokens ocultos de raciocínio gera cobrança de 50.000 tokens de saída, ou US$ 0,50. Um relato real de usuário, com 935 tokens de entrada e 56.097 de saída por US$ 0,5628, bate quase exatamente com a tarifa de US$ 10/1M para saída (x.com).
O comportamento do cache é a outra linha da fatura que muita gente deixa passar. Prefixos colocados no cache pela primeira vez geram cobrança de gravação; reutilizar um prefixo inalterado durante a janela reduz a leitura para US$ 0,20/1M. O tempo de vida padrão do cache é de cinco minutos, com opção de uma hora por chamada (kimi.ai). Alterar um prefixo próximo do início do contexto pode invalidar o reaproveitamento de tudo que vem depois (kimi.ai). Para confirmar se houve cache hit, verifique a divisão de uso por requisição entre tokens de leitura em cache e tokens sem cache: textos parecidos, por si só, não garantem um hit.
Standard ou Highspeed: onde muda a conta da API Kimi K3.1 Pro
O Highspeed promete a mesma inteligência e a mesma janela de contexto de 1M, mas entrega respostas cerca de 2 a 3 vezes mais rápido e cobra exatamente o dobro pelas entradas, saídas e gravações em cache (platform.kimi.ai). É assim que a Moonshot o descreve no anúncio de lançamento (kimi.ai).
Há uma exceção: a leitura com cache hit não dobra. Ela custa US$ 0,20 por 1M de tokens de entrada em cache nas duas versões. Essa diferença pesa em loops de agentes que repetem prompts de sistema extensos e definições de ferramentas: o desconto na repetição é igual, mas tokens novos e raciocínio custam o dobro no Highspeed.
Três pontos de cobrança devem guiar qualquer estimativa:
- Cobrança separada da assinatura: a API é cobrada por uso, com medição independente para entrada e saída. Ela também é separada das assinaturas Kimi e Kimi Code, então o saldo de uma assinatura não paga chamadas de API (kimi.ai).
- IDs e compatibilidade: a API é compatível com OpenAI e usa os IDs
kimi-k3.1-proekimi-k3.1-pro-highspeed, disponíveis emhttps://api.moonshot.ai/v1. Ela também aparece em gateways comomoonshotai/kimi-k3.1-prono OpenRouter e no Vercel AI Gateway. - Custos extras: chamadas opcionais de Web Search custam US$ 0,004 cada além dos tokens. Os arquivos enviados não são cobrados em si, mas o conteúdo extraído deles é tarifado como entrada. O acesso à API é liberado após uma recarga mínima de US$ 1 e tem limites de taxa por nível (kimi.ai).
Quando o Highspeed compensa pagar o dobro — e quando só encarece tudo
O Highspeed só vence quando o tempo de espera vale mais do que os tokens. Sessões interativas de programação, assistentes ao vivo e demos para usuários, em que há alguém olhando para um carregamento, justificam os US$ 4/US$ 20 porque a latência faz parte do produto. Jobs em lote, execuções noturnas de agentes e baterias de avaliação sem ninguém esperando devem ficar no Standard, a US$ 2/US$ 10, por cerca de metade das tarifas listadas. Na prática, o Highspeed só se justifica quando o valor do tempo economizado supera o custo adicional de tokens — aproximadamente mais uma conta inteira do Standard em execuções dominadas por entrada.
Ajustar o esforço de raciocínio é uma alavanca mais barata do que trocar de plano. A API aceita reasoning_effort em low, high e max; max é o padrão e foi a configuração usada nos benchmarks divulgados pela Moonshot (datacamp.com). Reduzir um teste de max para high, ou de high para low, diminui o volume de tokens de raciocínio em tarefas simples sem pagar o prêmio do Highspeed. Mantenha o mesmo nível durante toda a sessão, pois mudar a configuração no meio invalida o cache de contexto (datacamp.com).
Relatos da comunidade ajudam a dimensionar essa troca. Um usuário japonês que comparou trabalhos equivalentes registrou 14:32 para o Opus 5.5 e 27:53 para o Kimi K3.1 Pro, com qualidade de saída próxima, e concluiu que só tarefas que podem esperar devem ir para o Kimi:
Era para custar metade, mas o tempo de espera foi quase o dobro. ... O Opus 5.5 levou 14 minutos e 32 segundos; o Kimi K3.1 Pro, 27 minutos e 53 segundos. A qualidade, sinceramente, é bem parecida. Eu deixaria no Kimi apenas os trabalhos que podem esperar. — @rutinelabo (x.com)
Usuários do Reddit relatam uma diferença semelhante: cerca de 80 tok/s no Highspeed contra aproximadamente 30 tok/s no Standard, descrevendo a camada rápida como muito cara:
E, mais uma vez, o modelo tem uma versão de alta velocidade que custa os olhos da cara e roda muito mais rápido do que alguém consegue ler (80 t/s), enquanto a versão normal roda a 30 t/s quando quer. — u/Kiverty (reddit.com)
Regra prática: comece pelo K3.1 Pro Standard, reduza primeiro o reasoning_effort e pague pelo Highspeed apenas em sessões com uma pessoa esperando pela resposta.
Auto-hospedagem após 4 de novembro: a realidade de um modelo da classe 3T
A Moonshot afirma que os pesos completos do Kimi K3.1 Pro serão liberados até 4 de novembro de 2026. A empresa descreve o modelo como pertencente à classe de 3T, com janela de contexto de 1M de tokens (kimi.com). Em 2 de novembro, ainda não havia repositório oficial do K3.1 Pro na organização da Moonshot no Hugging Face, em huggingface.co/moonshotai, que continuava listando o Kimi K3 e modelos anteriores; os resultados de busca mostravam apenas forks não oficiais. Licença final, formatos de arquivos e opções de quantização também seguem sem confirmação, algo que rastreadores de terceiros classificam como desconhecido até a publicação oficial (ctrlaltorion.com).
A escala explica por que a auto-hospedagem dificilmente será mais barata do que a API neste caso. O K3.1 Pro sucede, após treinamento, o Kimi K3, um modelo mixture-of-experts de 2,8T de parâmetros, e a classificação 3T aponta na mesma direção (datacamp.com). O total de parâmetros de um MoE não equivale aos parâmetros ativos por token; por isso, ainda não dá para calcular uma estimativa confiável de VRAM para uma única workstation com as informações disponíveis.
Em vez de adivinhar o preço de GPUs, use um ponto de equilíbrio simbólico:
API_month = monthly_tokens_1M x blended_$/1M (from formula above)
Self-host wins when cluster_monthly_cost < API_month at sustained utilization
Com US$ 2/1M para entrada e US$ 10/1M para saída, um bilhão de tokens de entrada mais 100M de tokens de saída custam US$ 2.000 mais US$ 1.000, ou cerca de US$ 3.000 em cobrança de API. A auto-hospedagem faz sentido para equipes que já possuem um cluster adequado, mantêm inferência em alto volume de forma contínua ou precisam manter os dados no próprio ambiente. Para quem não tem esse cluster nem utilização sustentada, a fórmula acima normalmente favorece a API por consumo; espere o checkpoint oficial e a licença antes de planejar qualquer coisa.
Dois erros de cobrança que continuam pegando usuários
O primeiro é o raciocínio cobrado como saída, algo já contemplado pela fórmula. Para limitar esse gasto, restrinja as execuções com max_completion_tokens, comece os testes em low, suba para high apenas se falhar e deixe max para a execução final mais difícil.
O segundo é confundir o consumo de cotas de assinatura com a previsibilidade da API. Vários assinantes relatam esgotar uma franquia de 5 horas em poucos minutos durante tarefas exigentes de programação; um usuário do plano mais alto afirmou ter consumido toda a cota mensal em seis horas (reddit.com). Em 25 de outubro, a Moonshot reconheceu o problema, pediu desculpas pelos limites de taxa e pelo consumo desnecessário de cota, concedeu uma reposição única de 25% e disse que reduziria chamadas redundantes de subagentes e o tamanho das respostas (x.com). Para raciocínio pesado e programação, o uso medido da API, a US$ 0,30 por unidade de 100K de entrada e 10K de saída, é mais previsível do que franquias de assinatura que podem desaparecer em uma única tarefa.
Perguntas frequentes sobre o preço da API Kimi K3.1 Pro
Quanto custa a API Kimi K3.1 Pro por 1M de tokens?
O Standard custa US$ 2,00 para entrada, US$ 10,00 para saída, US$ 0,20 para leitura de entrada em cache, US$ 2,00 para gravação em cache de 5 minutos e US$ 4,00 para gravação em cache de 1 hora por 1M de tokens, antes de impostos (kimi.ai).
Qual é a diferença entre K3.1 Pro e Highspeed?
O Highspeed oferece a mesma inteligência declarada e contexto de 1M, mas responde cerca de 2 a 3 vezes mais rápido, cobrando US$ 4,00 de entrada e US$ 20,00 de saída por 1M de tokens. As gravações em cache também dobram, enquanto a leitura com cache hit continua em US$ 0,20 (platform.kimi.ai).
Quais são os IDs de modelo da API?
Use kimi-k3.1-pro no plano Standard e kimi-k3.1-pro-highspeed na camada rápida no endpoint compatível com OpenAI da Moonshot. Em gateways, o modelo aparece como moonshotai/kimi-k3.1-pro (openrouter.ai).
O uso da API está incluído em uma assinatura Kimi?
Não. A cobrança da API é separada das assinaturas Kimi e dos planos Kimi Code, com chaves e saldos próprios; portanto, créditos de assinatura não pagam chamadas de API (kimi.ai).
É possível desativar o raciocínio para reduzir custos?
Não. O K3.1 Pro sempre raciocina; o controle de custos vem de reasoning_effort (low, high, max, sendo max o padrão) e de max_completion_tokens, não da desativação do pensamento (datacamp.com).
Quando os pesos abertos serão lançados e vale a pena esperar?
A meta da Moonshot é liberar até 4 de novembro de 2026, mas em 2 de novembro ainda não havia repositório oficial no Hugging Face nem licença final publicada. Por enquanto, planeje usar a API; só reavalie a auto-hospedagem quando o checkpoint e a licença oficiais forem disponibilizados.
Leitura relacionada: Kimi K3.1 Pro API: Pricing, Benchmarks and Highspeed Guide para o detalhamento completo dos benchmarks, Kimi K3 Pricing para as tarifas da geração anterior e a página da API Kimi K3 para chamar modelos Kimi com uma única chave.