 AIREITER
O Opus 5.5 vence em qualidade; o GPT-6.1 Sol leva vantagem no preço de tabela — mas só enquanto cada solicitação ficar abaixo de 272K tokens de entrada. Acima desse limite, a sobretaxa de contexto longo praticamente elimina a diferença, e vários usuários do Codex dizem que o Sol também parece mais lento no tempo total de execução.
Os dois modelos já estão disponíveis. A Anthropic lançou o Claude Opus 5.5 em 22 de setembro de 2026, como o primeiro modelo Claude 5.5, e a OpenAI lançou o GPT-6.1 Sol em 29 de setembro de 2026, com o ID de API gpt-6.1-sol. As tabelas de especificações não mostram os três fatores que realmente decidem a conta: o precipício do contexto longo, o nível de esforço e o comportamento das cotas nas assinaturas.
A resposta em 30 segundos
Escolha o Claude Opus 5.5 quando o custo de um patch errado ou inchado superar o preço dos tokens: migrações longas, auditorias em vários repositórios e agentes sem supervisão. Escolha o GPT-6.1 Sol para tarefas bem definidas e de alto volume, com menos de 272K tokens de entrada por solicitação: automação de chamados, extração de PDFs e fluxos de trabalho empresariais.
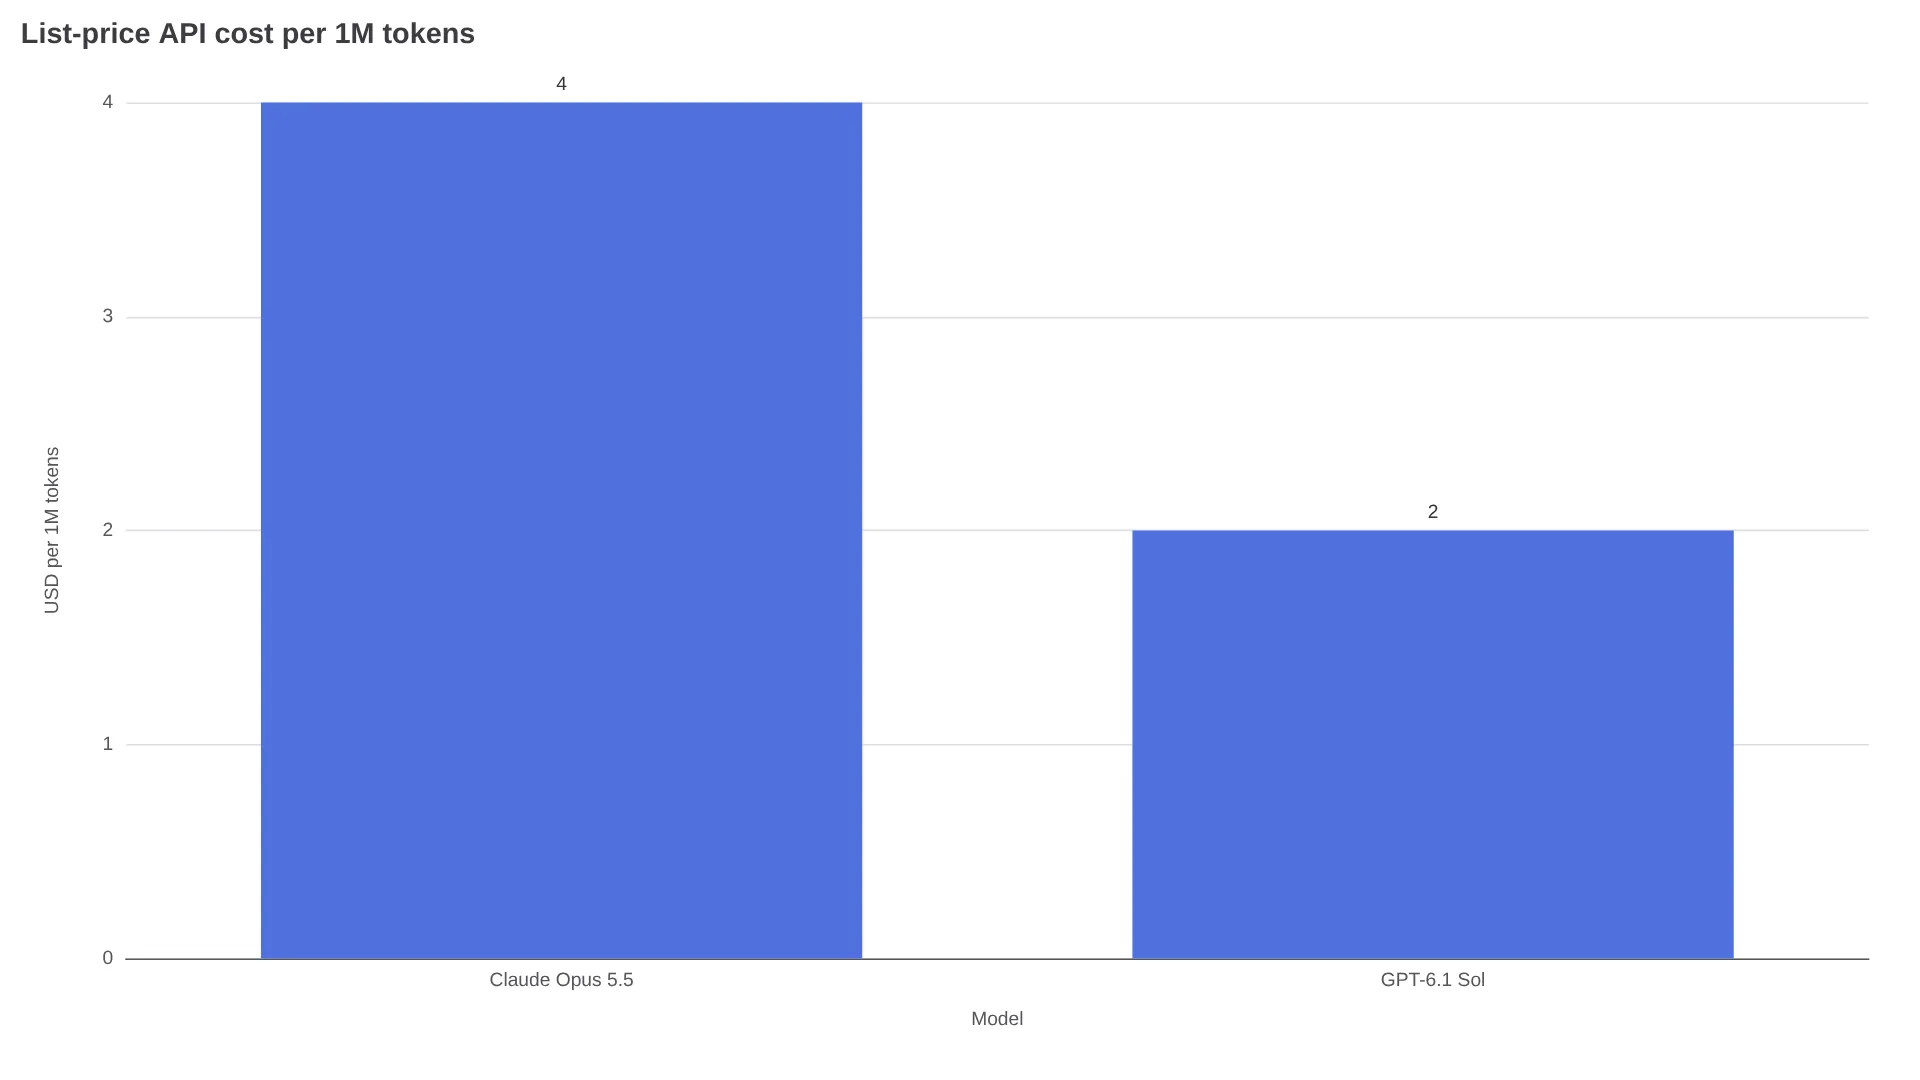
No papel, a diferença técnica é pequena: janela de contexto de 1M contra 1,05M, saída máxima de 128K nos dois e preços de $4/$20 contra $2/$10 por milhão de tokens de entrada/saída. Na prática, a diferença de comportamento é maior: o Opus 5.5 registra números superiores em programação agentiva (66.4% no Terminal-Bench 4.0, 54.4% no FrontierCode v1.1 e 57.8% no CursorBench 4.0), enquanto o Sol responde com aproximadamente metade do preço de tabela e uma vitória documentada no AutomationBench por um terço do custo da tarefa. Para quem usa assinatura, há uma complicação: testes de cota no Reddit indicam que o Sol consome a franquia mais rápido do que o preço da API faria supor.
Preço, contexto e onde usar cada modelo
| Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|
| Provedor | Anthropic | OpenAI |
| Lançamento | 22 de setembro de 2026 | 29 de setembro de 2026 |
| ID de API | Família claude-opus-5-5 na maioria dos gateways | gpt-6.1-sol |
| Entrada / saída por 1M | $4.00 / $20.00 | $2.00 / $10.00 |
| Leitura de entrada em cache por 1M | $0.20 | $0.10 |
| Janela de contexto | 1,000,000 tokens | 1,050,000 tokens |
| Saída máxima | 128K tokens | 128K tokens |
| Camada rápida | Modo Fast por $8 / $40, até 2,5x mais velocidade | Ultrafast de até 8x no Codex, a aproximadamente 2x as tarifas de tabela |
| Disponível via | Claude Code, API, Bedrock, Vertex, Foundry, OpenRouter | Codex, ChatGPT Work, API, Azure, Bedrock, OpenRouter |
| Não disponível em | — | Chat para consumidores em geral no lançamento |
Para alternar entre eles, basta mudar a string do modelo. O AIReiter encaminha os dois modelos a partir de um único console, sem exigir o gerenciamento de duas chaves de fornecedores diferentes.
Quanto você realmente paga em cargas de trabalho reais
As tarifas de tabela fazem o Sol parecer 50% mais barato. Nas cargas reais, o tamanho de cada solicitação e o uso de cache mudam a conta.
A sobretaxa da OpenAI vale para cada solicitação acima de 272K tokens de entrada: são aplicadas tarifas 2x maiores para entrada e cache, além de 1,5x para saída, em toda a solicitação. A Anthropic anuncia a janela completa de 1M com as mesmas tarifas, sem divulgar uma sobretaxa por solicitação. As leituras em cache custam $0.20 contra $0.10, portanto loops que dependem bastante de cache preservam parte da vantagem do Sol.
| Carga de trabalho | Opus 5.5 | GPT-6.1 Sol | Diferença |
|---|---|---|---|
| Assistente equilibrado: 1M de entrada / 250K de saída, solicitações abaixo de 272K cada | $9.00 | $4.50 | Sol 50% mais barato |
| RAG, solicitações abaixo de 272K: 10M de entrada / 1M de saída | $60 | $30 | Sol 50% mais barato |
| RAG, todas as solicitações acima de 272K: 10M de entrada / 1M de saída | $60 | ~$55 | Sol apenas ~8% mais barato |
| Loop com muito cache: prefixo de 100K escrito uma vez, depois 1.000x (5K novos + 100K lidos do cache + 1K de saída) | ~$60.50 | ~$30.25 | Sol ~50% mais barato |
Os totais usam as tarifas de tabela e não consideram diferenças entre tokenizadores. A vantagem do Sol é maior em solicitações curtas e de alto volume, e menor em buscas gigantes feitas em uma única chamada.
A conta da assinatura não acompanha a da API. Uma comparação feita por um usuário com 128 prompts, colocando GPT-6.1 Sol, GPT-6 Sol e Opus 5.5 diante dos mesmos prompts, encontrou um consumo maior da assinatura da família Sol do que o preço por token indicaria. Um comentário posterior resumiu assim:
"meu chatgpt acabou de citar isso. enfim, talvez eles estejam empatados em uso, mas o opus é muito mais rápido no tempo real e eu me arrependo de ter trocado este mês." — u/ebrbrbr, tópico de teste de cota do r/ChatGPT
Outro usuário do Codex relatou o mesmo consumo acelerado:
"Eu não me importaria de usar o GPT 6.1 Sol se o uso fosse razoável, mas, cara, mesmo sendo mais 'eficiente', ainda estou ficando sem cota. É inacreditável." — u/Longjumping_Stop6269, r/codex
Regra para o orçamento: se sua solicitação mediana passa de 272K, faça as contas da sobretaxa antes de migrar. Se você paga um plano de $20 ou $100 por assento, acompanhe a parcela da cota por pull request integrado, e não os tokens por dólar.
Programação e agentes: benchmarks e dois testes práticos
Os testes de terceiros abaixo servem como referência, já que os harnesses e níveis de esforço variam. Fontes: Anthropic, OpenAI, teste de build da DataCamp, throughput do OpenRouter, compilação de benchmarks da SpringPrompt.
| Benchmark | Opus 5.5 | GPT-6.1 Sol | Observação |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | não publicado | Executado pela Anthropic, xhigh |
| FrontierCode v1.1 Main | 54.4% | empatado com o Fable 5.1, sem número divulgado | Relatos de fontes diferentes |
| CursorBench 4.0 | 57.8% | não publicado | Executado pela Anthropic |
| DeepSWE v1.1 | não publicado | empatado com o Astra, +6.4pp sobre o GPT-6 Sol | Executado pela OpenAI, esforço máximo |
| AutomationBench (47 ferramentas) | 40.0% | +2.2pp sobre o Opus no nível médio, ~1/3 do custo | Executado de forma independente, sem alternativas, segundo o relato da Anthropic sobre o teste da Zapier |
| OSWorld 2.0 parcial | 81.8% | ~60.5% no conjunto offline | Subconjuntos diferentes, executado pelos fornecedores |
| GDPval-AA v2.1 | 1,846 Elo | Sol supera o Opus-com-alternativas no GDP.pdf por <1/2 do custo | Afirmação entre fornecedores feita pela OpenAI |
O Opus 5.5 apresenta o conjunto publicado mais completo em programação agentiva; as melhores vitórias documentadas do Sol aparecem em fluxos empresariais e análise de documentos, com menor custo por tarefa. A Anthropic afirma que seus resultados foram obtidos com as proteções de produção ativadas.
Dois testes de tarefas realizados por terceiros ajudam a completar o quadro:
- Construção de um Tetris em arquivo único (DataCamp, OpenCode, mesmo prompt, esforço alto, uma tentativa). Os dois modelos acertaram a lógica difícil de inversão da gravidade. O Sol marcou 5.0 contra 4.3 em mecânica, completude e sensação de uso; o Opus terminou em 3 turnos e 2 chamadas de ferramenta, contra 6 turnos e 9 chamadas, mas custou $0.87 contra $0.26 depois de gastar 22.5K tokens de raciocínio, enquanto o Sol usou 8.1K.
- Teste de cota com 128 prompts (Reddit, prompts fixos, cota e tempo registrados). O Sol consumiu mais cota da assinatura do que o GPT-6 Sol na mesma carga, enquanto o Opus terminou mais rápido no tempo total.
Um relato recorrente de usuários destaca a contenção:
"Para mim, o maior ganho do Opus 5.5 nem é a velocidade bruta de programação, mas o fato de ele não transformar correções simples em projetos gigantes. Os modelos anteriores reescreviam quatro arquivos quando você pedia um patch de três linhas; o 5.5 respeita a arquitetura existente" — u/food_fatherr, r/ClaudeAI
Um relato extremo de geração excessiva aponta na direção oposta: um desenvolvedor disse que o Sol escreveu 30.000 testes para uma solicitação de reprodução pixel perfect e depois apagou apenas 25 quando recebeu o pedido para reduzir o volume.
A velocidade que você sente contra a velocidade da ficha técnica
As fichas técnicas favorecem o Opus na decodificação: ~96 contra ~53 tokens/s no Artificial Analysis via SpringPrompt, e throughput mediano de 74 contra 29 no OpenRouter. Segundo a SpringPrompt, o Sol leva uma ligeira vantagem no tempo até o primeiro token (1.71s contra 6.89s em esforço baixo). Já os relatos citados de usuários do Codex descrevem o oposto nas esperas de ponta a ponta, incluindo tarefas simples que levam vários minutos e trabalhos longos com documentos.
As duas coisas podem ser verdade: tokens por segundo mede a decodificação depois do primeiro trecho; o tempo total também inclui raciocínio, fila e a sobrecarga do harness.
- O modo Fast do Opus custa $8/$40 (2x) e oferece até 2,5x mais velocidade; o Sol Ultrafast promete até 8x no Codex, com tarifas de aproximadamente 2x.
- Os relatos citados do Codex e do Work se concentram na latência, não na decodificação da API. Um trabalho de PDF de 40 minutos usou apenas 6% de uma janela de 5 horas em um único relato, e não representa uma taxa típica.
- Se o seu loop for interativo (Cursor, Claude Code, Codex CLI), teste três chamados reais em cada modelo antes de decidir.
As configurações que definem a conta
Os padrões importam mais do que o selo do modelo:
- Comece o Opus no nível Medium ou High. Os relatos de usuários citados sugerem que Extra High e Max consomem cota sem trazer grande ganho em patches comuns.
- Os controles de raciocínio são diferentes. Não é possível desligar o raciocínio do Opus, o uso forçado de ferramentas é rejeitado e o contexto editado em contas mais novas pode gerar um erro 400 (notas da API da DataCamp). O Sol vai de
noneamaxe permite mudar o esforço no meio da conversa sem invalidar o cache (controles de raciocínio da DataCamp), o que facilita loops com custo limitado. - As proteções podem redirecionar o trabalho. A maioria das tarefas de cibersegurança no Opus é redirecionada para o Opus 4.8 fora do Cyber Verification Program; trabalhos de biologia exigem o programa Life Sciences (Anthropic). Espere surpresas de qualidade e cota relacionadas a alternativas nessas tarefas.
Qual escolher para cada carga de trabalho
| Se você está fazendo… | Escolha… | Por quê |
|---|---|---|
| Migração com 200 mil linhas, auditoria em vários repositórios, execução de agente por 9 horas | Opus 5.5 | Maiores resultados agentivos, menos reescritas indesejadas e preço estável para 1M |
| 10 mil chamados por dia, cada um abaixo de 272K, RAG com trechos pequenos | GPT-6.1 Sol | Metade do preço de tabela, bom desempenho no AutomationBench e no GDP.pdf por dólar |
| Busca gigante em uma única chamada, acima de 272K por solicitação | Opus 5.5 ou dividir o conteúdo para usar o Sol | A sobretaxa do Sol reduz sua vantagem para ~8% |
| Perguntas e respostas financeiras e jurídicas baseadas em muitos PDFs | Teste o Sol primeiro | Vitória alegada sobre o Opus-com-alternativas por <1/2 do custo da tarefa; valide com seus documentos |
| Assinante de plano de $20, CLI interativo | Teste os dois; os relatos citados favorecem o Opus | Usuários dizem que o Sol consome a cota mais rápido do que a conta de tokens prevê e parece mais lento |
Não há um vencedor universal. O Sol é a opção da eficiência; o Opus, da contenção e da autonomia. Uma divisão prática é usar o Opus para planejamento e revisão, deixando a execução em massa para o Sol.
Claude Opus 5.5 vs GPT-6.1 Sol: perguntas frequentes
Qual é mais barato pela API?
O Sol na tarifa de tabela ($2/$10 contra $4/$20, e $0.10 contra $0.20 para dados em cache). A diferença cai para ~8% quando todas as solicitações passam de 272K tokens de entrada.
Qual é melhor para agentes de programação?
O Opus 5.5 lidera os resultados publicados de Terminal-Bench, FrontierCode e CursorBench; o Sol responde com empate com o Astra no DeepSWE e uma vitória no AutomationBench por um terço do custo.
Qual é mais rápido no uso real?
A decodificação favorece o Opus (~74–96 tok/s contra ~29–53); o primeiro token favorece ligeiramente o Sol. Os relatos do Codex de outubro de 2026 apontam para uma experiência mais lenta com o Sol.
Quais são os IDs dos modelos na API?
gpt-6.1-sol e os slugs claude-opus-5-5 na maioria dos gateways.
O GPT-6.1 Sol está no ChatGPT comum?
Não no lançamento de 29 de setembro: primeiro no Work, no Codex e na API. Confira novamente o seu plano se o acesso for importante.
Qual nível de esforço devo usar?
Comece o Opus 5.5 em Medium ou High, não em Max; comece o Sol em medium e aumente apenas quando a quantidade de tentativas subir. Os tokens de raciocínio entram na mesma cobrança por token nos dois modelos (notas de cobrança da DataCamp).
A troca de que nenhum prompt dá conta
O Opus 5.5 respeita o repositório, mas cobra pelo raciocínio; o Sol reduz o preço dos tokens, mas pode inundar você com trabalho para revisar e com esperas. Se uma falha silenciosa puder colocar um bug em produção, pague pelo Opus. Se os erros forem baratos e o volume for prioridade, aproveite a economia do Sol enquanto ficar abaixo de 272K.
Leia também: análise e preços do Claude Opus 5.5, análise dos preços da API do GPT-6.1 Sol.