 AIREITER
Em projetos de alto volume em inglês, Fish Audio tem a menor tarifa pública fixa em 2026; com volume contratado, a Inworld pode custar menos. Isso não faz de nenhuma das duas a melhor API de clonagem de voz para agentes telefônicos em tempo real ou vozes de marca com governança. Quando o primeiro áudio em menos de 100 ms determina se a pessoa interrompe o bot, a Cartesia leva vantagem. Já para preservar a voz de um fundador ou narrador por meses de conteúdo, a opção mais segura é ElevenLabs — desde que o orçamento cubra as regravações e o lock-in da plataforma. Este guia compara oito provedores por similaridade da clonagem, custo efetivo, latência, requisitos de amostra e controles de consentimento, com base na documentação dos fornecedores, no benchmark de replicação da Hume e em relatos de desenvolvedores em produção. Em identidade vocal, Fish Audio S2-Pro liderou o benchmark citado com 4.03; para manter a identidade ao longo de meses de conteúdo extenso, ElevenLabs Professional Voice Cloning é a alternativa mais bem documentada.
É na produção que a clonagem de voz é testada
Uma voz de catálogo só precisa soar bem. Uma voz clonada precisa parecer a mesma pessoa em roteiros longos, trocas de turno com agentes, sotaques e áudio telefônico. Por isso, as demonstrações escondem regravações e latência de cauda, problemas que só aparecem em escala. Similaridade com o locutor e naturalidade da voz são métricas diferentes. O benchmark de replicação de voz de setembro de 2026 divulgado pelo MarkTechPost deixa essa diferença clara: Cartesia Sonic 3.6 Beta marcou 4.36 em naturalidade, mas apenas 3.63 em identidade do locutor, enquanto Fish Audio S2-Pro liderou em identidade, com 4.03.
Há outra separação importante em implementações reais: a latência do modelo não é o atraso de ponta a ponta. As notas de benchmark do DIY AI citam latência de modelo próxima de 75 ms para ElevenLabs Flash, cerca de 90 ms até o primeiro áudio para Cartesia Sonic e aproximadamente 200–400 ms até o primeiro byte para Fish Audio. Mas detecção de turno, STT, tempo até o primeiro token da LLM, buffering e reprodução podem acrescentar centenas de milissegundos. Meça do fim da fala do usuário até o áudio audível no dispositivo, e não pelo número exibido no dashboard do fornecedor.
"Eleven labs is the best in terms of speech… Highest cost. Cartesia really good latency but voices are a step behind eleven." — u/jtsaint333 no r/ElevenLabs
Custo por minuto aproveitável importa mais que custo por caractere
Preços de tabela enganam porque as unidades de cobrança variam, e até saídas descartadas continuam sendo cobradas. Fish Audio cobra $15 por 1 milhão de bytes UTF-8, o que o Fish Audio estima em cerca de 12 horas de fala em inglês. Em inglês, cada caractere ocupa em média um byte; em chinês, japonês e coreano, a média é de cerca de três bytes. Na prática, o mesmo plano custa aproximadamente três vezes mais para roteiros em CJK. Planos por caracteres também escondem uma segunda cobrança: as regravações. Um criador de audiobooks relatou consumir 20–30% mais caracteres que o texto do livro por falhas de pronúncia:
"I have probably used 20-30% more characters than the book actually has because their models struggle with pronunciations." — u/gowner_graphics no r/ElevenLabs
Calcule o custo efetivo de produção como custo de tabela x multiplicador de bytes do idioma x (1 + taxa de regravação), somando taxas de plano ou de clonagem quando houver. Para narração longa, simule um cenário com 20–30% de regravações. Não baseie custos de produção em níveis gratuitos temporários sem SLA. Clones que não podem ser exportados criam custo de lock-in: mantenha fora do provedor os áudios originais, as evidências de consentimento e os logs de ID da voz.
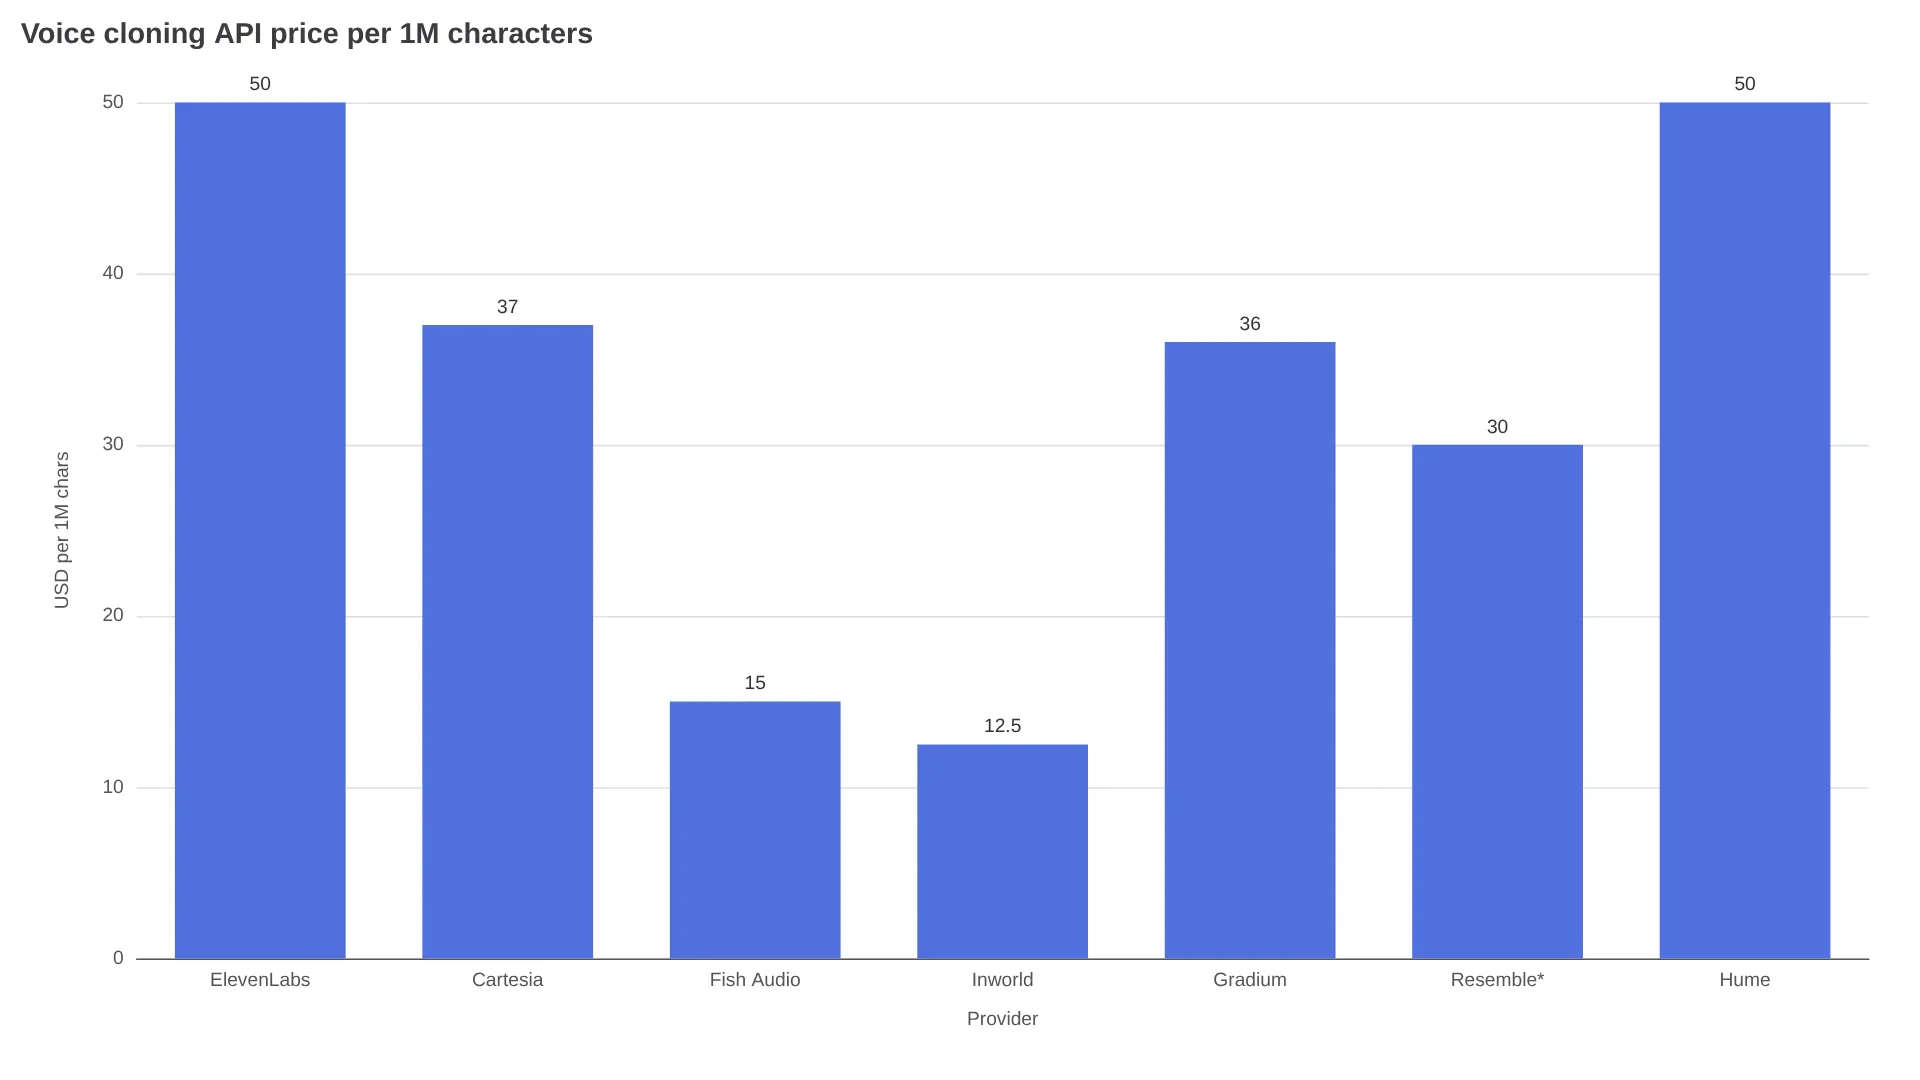
| Provedor | Preço aproximado por 1M de caracteres | Observação sobre cobrança |
|---|---|---|
| Fish Audio | $15 | Por 1M de bytes UTF-8; CJK ~3x o inglês |
| Inworld | $12.50–$25 TTS-2; Flash a partir de $7 em volume | A clonagem em si é gratuita; faixas de volume reduzem o preço unitário |
| Resemble AI | ~$30 estimados | O MarkTechPost converte um rastreador de $0.0005/segundo usando ~1,000 caracteres/minuto; a exigência do plano Business pesa mais para apps pequenos |
| Cartesia | $37–$50 | $5 por 100K créditos a $299 por 8M; 1 crédito por caractere |
| Gradium | ~$58 no XS, menos em pacotes maiores | 1 crédito por caractere; XS custa $13 por 225K créditos |
| ElevenLabs | $50 Flash/Turbo a $100 Multilingual v3 | $0.05 por 1K no Flash/Turbo; $0.10 por 1K no v3 |
| Hume | $50–$150 conforme o plano | $0.15 por 1K no Creator, caindo para $0.05 por 1K no Business |
| MiniMax | Sem tarifa pública por caractere | Planos a partir de $5/mês; consulte o preço oficial para volume |
Os preços são tarifas de varejo das faixas iniciais, verificadas entre setembro e outubro de 2026. Como as unidades variam entre bytes, caracteres, créditos e segundos, considere o ranking apenas indicativo.
O melhor provedor muda conforme o trabalho
Nenhum fornecedor lidera simultaneamente em similaridade, latência, preço, idiomas e governança. OpenAI TTS e Deepgram Aura-2 ficaram fora porque a comparação de 2026 da Gradium observa que nenhum dos dois oferece clonagem de voz pública e amplamente disponível.
| Provedor | Amostra instantânea | Clone profissional | Idiomas | Streaming | Consentimento / principal controle |
|---|---|---|---|---|---|
| ElevenLabs | 1–2 min recomendados | 30 min no mínimo, 2–3 h no ideal | 70+ | REST + WebSocket | Verificação de locutor por Voice Captcha; sem exportação do clone |
| Cartesia | 10 seg, até 60 seg no Sonic 3.6+ | 30+ min de treinamento | 44 | REST + WebSocket, <100 ms até o primeiro byte | Permissão exigida pelos termos; amostras maiores preservam sotaques |
| Fish Audio | ~10 seg | 10–180 min + verificação de propriedade ao vivo | 83 (S2.1 Pro) | WebSocket, 200–400 ms | Verificação de propriedade ao vivo para clones profissionais; auto-hospedagem Apache-2.0 |
| MiniMax | 10 seg | Nível profissional disponível | 50+ | API em tempo real | Confirmação de autorização no upload; fidelidade em idiomas asiáticos |
| Inworld | 3–30 seg | 10 min em beta, somente inglês | 200+ localidades (15 de alta qualidade) | TTS com streaming | Confirmação de direitos; menor custo em volume |
| Gradium | 10 seg | 30 min no mínimo, 2 h recomendadas; plano M $340/mês | 5 (EN/FR/DE/ES/PT) | WebSocket multiplexado | Consentimento do proprietário exigido pela política; 5 clones gratuitos |
| Resemble AI | 10 seg no Rapid, <1 min | 10–25+ min, ~40 min de treinamento | 23 | HTTP + WebSocket | Consentimento verificável; marca d'água por saída, opção on-prem |
| Hume | 15 seg no mínimo | Não documentado | 11 | API no Enterprise | Upload por locutor que consente; entrega orientada por emoção |
Coqui XTTS, Bark e os pesos do Fish S2 são uma alternativa separada para auto-hospedagem, fora destas oito APIs gerenciadas.
ElevenLabs: consistência de identidade em conteúdo longo
É a escolha documentada para casos em que a identidade precisa resistir a audiobooks, dublagem ou narração de marca. Instant Voice Cloning usa uma amostra curta; Professional Voice Cloning acrescenta fine-tuning e um Voice Captcha, no qual o locutor lê um texto exibido na tela. O custo dessa opção está no preço, nos recursos profissionais restritos por plano e no lock-in da plataforma.
Cartesia: agentes telefônicos em tempo real
Um primeiro byte em menos de 100 ms faz diferença quando clientes interrompem a fala, e ampliar a amostra para perto de 60 segundos no Sonic 3.6+ ajuda a manter sotaques. O catálogo é mais limitado, com 44 idiomas, e há relatos mistos para vozes personalizadas fora do inglês, incluindo problemas com vozes personalizadas em hindi em uma discussão de comparação em produção.
Fish Audio: alto volume e auto-hospedagem
S2-Pro liderou o benchmark citado em identidade, o TTS pago mantém uma cobrança fixa por byte e os pesos S2 sob Apache-2.0 rodam em uma única GPU da classe RTX 4090 para implementações isoladas da rede. Reserve orçamento separado para bytes CJK e revisão de consentimento, pois o provedor publica menos detalhes de governança que ElevenLabs ou Resemble.
MiniMax, Inworld e Gradium: melhor relação custo-benefício
MiniMax Speech 2.6 atende bem a pipelines de vídeo multilíngues, com forte fidelidade em mandarim/japonês/coreano. Inworld é a opção mais barata com volume contratado para agentes: a clonagem instantânea é gratuita, e o Flash se aproxima de $7 por milhão nas faixas maiores. Gradium se encaixa em protótipos de agentes para idiomas europeus que precisam de uma faixa gratuita de clonagem e multiplexação WebSocket em tempo real.
Resemble AI e Hume: governança e controle emocional
Resemble atende sistemas empresariais governados que exigem consentimento verificável, marca d'água por saída e controle de implantação, mas a API de clonagem requer acesso Business ou superior. Hume é voltada a entregas direcionadas por emoção, porém o acesso à API de clonagem é exclusivo do Enterprise e o mínimo de 15 segundos não atende fluxos rígidos de 10 segundos.
Evite iniciar novos projetos de clonagem no PlayHT. Benchmarks antigos com boas pontuações ainda aparecem, mas a verificação de disponibilidade de agosto de 2026 do DIY AI informou que o serviço PlayAI foi encerrado, embora a documentação antiga siga indexada. Trate qualquer preço de PlayHT encontrado em buscas como referência de migração, não como prova de disponibilidade.
Checklist de integração antes de fechar com um fornecedor
Qualidade de áudio não garante uma API completa. Antes de direcionar tráfego de produção para um clone, confirme estes sete pontos na documentação e em um projeto de teste.
- A criação e o uso do clone estão disponíveis por API no seu nível de plano, inclusive os fluxos instantâneo, profissional e de fala para fala, se necessários.
- A semântica de streaming corresponde à carga de trabalho: WebSocket persistente, fragmentação por palavra ou oração, interrupção e cancelamento, além de p50/p95 documentados para tempo até o primeiro áudio.
- Slots de voz, cotas de caracteres, concorrência e limites de taxa suportam uma escala de vozes geradas por usuários; cobranças por clone podem dominar os custos quando cada usuário traz uma voz.
- Os registros de consentimento podem ser armazenados e auditados: quem autorizou o clone, quando e para quais usos monetizados.
- Direitos comerciais, marca d'água e prevenção de abuso estão explícitos; marca d'água no estilo Resemble e verificação de locutor no estilo ElevenLabs são os padrões mais robustos.
- A exclusão e a retenção foram testadas: o que acontece com as gravações-fonte e os clones treinados após a exclusão.
- A portabilidade está planejada: mantenha os áudios limpos originais com você, pois alguns clones não podem ser exportados.
Uma rota de voz unificada por uma única chave de API normaliza IDs de voz, eventos de streaming e cancelamento, comportamento de fallback e cobrança. Isso reduz o custo de troca quando promoções acabam ou quando a conta entre bytes e caracteres muda.
Como testar duas APIs com a sua própria voz em uma tarde
Em vez de confiar em rankings entre fornecedores, aplique o mesmo protocolo cego aos seus dois finalistas. Grave um WAV limpo de 10 segundos em um ambiente silencioso e outro de 60 segundos para testar sotaque. Sintetize as mesmas duas frases em todos os serviços: uma linha conversacional e outra com números e um nome próprio. Oculte os nomes dos provedores, peça a dois ouvintes que classifiquem a semelhança de identidade e, então, teste novamente o vencedor com um roteiro de 500 palavras e um clipe telefônico simulado a 16 kHz. Registre o tempo de criação do clone, o tempo até o primeiro áudio, o tempo da frase completa e o atraso conversacional de ponta a ponta com concorrência de pelo menos cinco streams; observe o p95, não a média. O vencedor de produção é o que suporta entrada ruidosa, desvio em conteúdo longo e tratamento de interrupções, mesmo que perca o concurso de beleza de uma frase isolada.
Perguntas frequentes
Qual é a API de clonagem de voz mais barata em 2026?
A menor tarifa pública fixa é a do Fish Audio, com $15 por 1M de bytes UTF-8; com volume contratado, a opção mais barata é Inworld Flash, aproximando-se de $7 por milhão. Inclua uma margem para regravações e verifique multiplicadores CJK e restrições de plano.
Qual API oferece a menor latência para agentes telefônicos?
Cartesia Sonic, com streaming de primeiro byte abaixo de 100 ms. Confirme o atraso de todo o pipeline com STT e LLM no fluxo.
Quanto áudio é necessário para clonar uma voz?
A maioria dos fluxos instantâneos começa em 10 segundos (Inworld usa 3–30, Hume 15). Os fluxos profissionais variam de ~10 minutos a várias horas conforme o provedor; ElevenLabs, Cartesia e Gradium exigem no mínimo 30 minutos.
Qual é a diferença entre clonagem de voz instantânea e profissional?
A clonagem instantânea se adapta na hora a partir de segundos de áudio, sendo indicada para protótipos e vozes geradas por usuários. A clonagem profissional faz fine-tuning de um modelo dedicado para vozes principais que precisam manter consistência por meses.
Uma voz clonada pode ser usada comercialmente?
Depende da permissão do locutor e do plano do provedor. O uso comercial do Fish Audio começa no Plus, clones profissionais da ElevenLabs exigem verificação do locutor, e a Resemble exige consentimento verificável. Confira os termos do plano: Gradium e Hume classificam os níveis gratuitos como não comerciais.
Recomendação final por carga de trabalho
| Carga de trabalho | Escolha | Motivo |
|---|---|---|
| Audiobooks, dublagem, narração de marca | ElevenLabs ou Fish Audio | Consistência de identidade e expressividade; Fish quando volume é o fator principal |
| Agentes telefônicos em tempo real | Cartesia | Primeiro byte abaixo de 100 ms e tratamento de interrupções |
| Agentes multilíngues de alto volume | Fish Audio ou Inworld | Preço fixo por byte ou preço do Flash por faixa de volume |
| Localização de vídeo para mercados asiáticos | MiniMax | Clonagem em 10 segundos e fidelidade CJK com entrada de $5 |
| Voz empresarial governada | Resemble AI | Registros de consentimento, marca d'água e controle on-prem |
| Protótipo europeu em 5 idiomas | Gradium | Faixa gratuita de clonagem e WebSocket em tempo real |
| Personagens orientados por emoção | Hume | Controles de direção do Octave; confirme primeiro o acesso à API Enterprise |