 AIREITER
Para tarefas curtas e repetíveis via API, o Claude Haiku 5.5 normalmente dá conta do recado por uma fração do custo. Mas há um detalhe importante: ele custa um vigésimo do Sonnet 5.5 apenas até o prompt ultrapassar 100.000 tokens. Depois disso, a diferença cai para 4x — e loops de agentes chegam a esse limite bem antes do que muitas equipes imaginam. Para depuração e programação em várias etapas, o Sonnet 5.5 ainda justifica o preço maior.
O preço do Haiku é 20x menor — até cruzar os 100K tokens
Claude Haiku 5.5 e Claude Sonnet 5.5 têm as mesmas capacidades anunciadas de contexto, mas a conta é bem diferente. Ambos oferecem janela de contexto de 1M de tokens e saída máxima de 128K tokens, com os IDs de modelo claude-haiku-5-5 e claude-sonnet-5-5. O Sonnet 5.5 foi lançado em 28 de setembro de 2026, e o Haiku 5.5, em 7 de outubro de 2026, segundo o anúncio do Haiku 5.5 da Anthropic e o anúncio do Sonnet 5.5 da Anthropic. A documentação da plataforma Claude para o Sonnet 5.5 informa os mesmos limites de 1M de contexto e 128K de saída.
| Especificação | Claude Haiku 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| ID do modelo | claude-haiku-5-5 | claude-sonnet-5-5 |
| Lançamento | 7 de out. de 2026 | 28 de set. de 2026 |
| Contexto / saída máxima | 1M / 128K | 1M / 128K |
| Entrada / saída abaixo de 100K | US$ 0,10 / US$ 0,50 por 1M | US$ 2 / US$ 10 por 1M |
| Entrada / saída com prompt acima de 100K | US$ 0,50 / US$ 2,50 por 1M | US$ 2 / US$ 10 por 1M (sem faixa) |
| Leitura de cache | US$ 0,01 por 1M | US$ 0,10 por 1M |
| Esforço padrão | medium | high |
Os valores são os preços de tabela da Anthropic. Quando os tokens do prompt passam de 100.000, o Haiku 5.5 aplica a faixa mais cara à solicitação inteira, incluindo leituras e gravações de cache, segundo o resumo de preços da Anthropic feito pela APIKO.
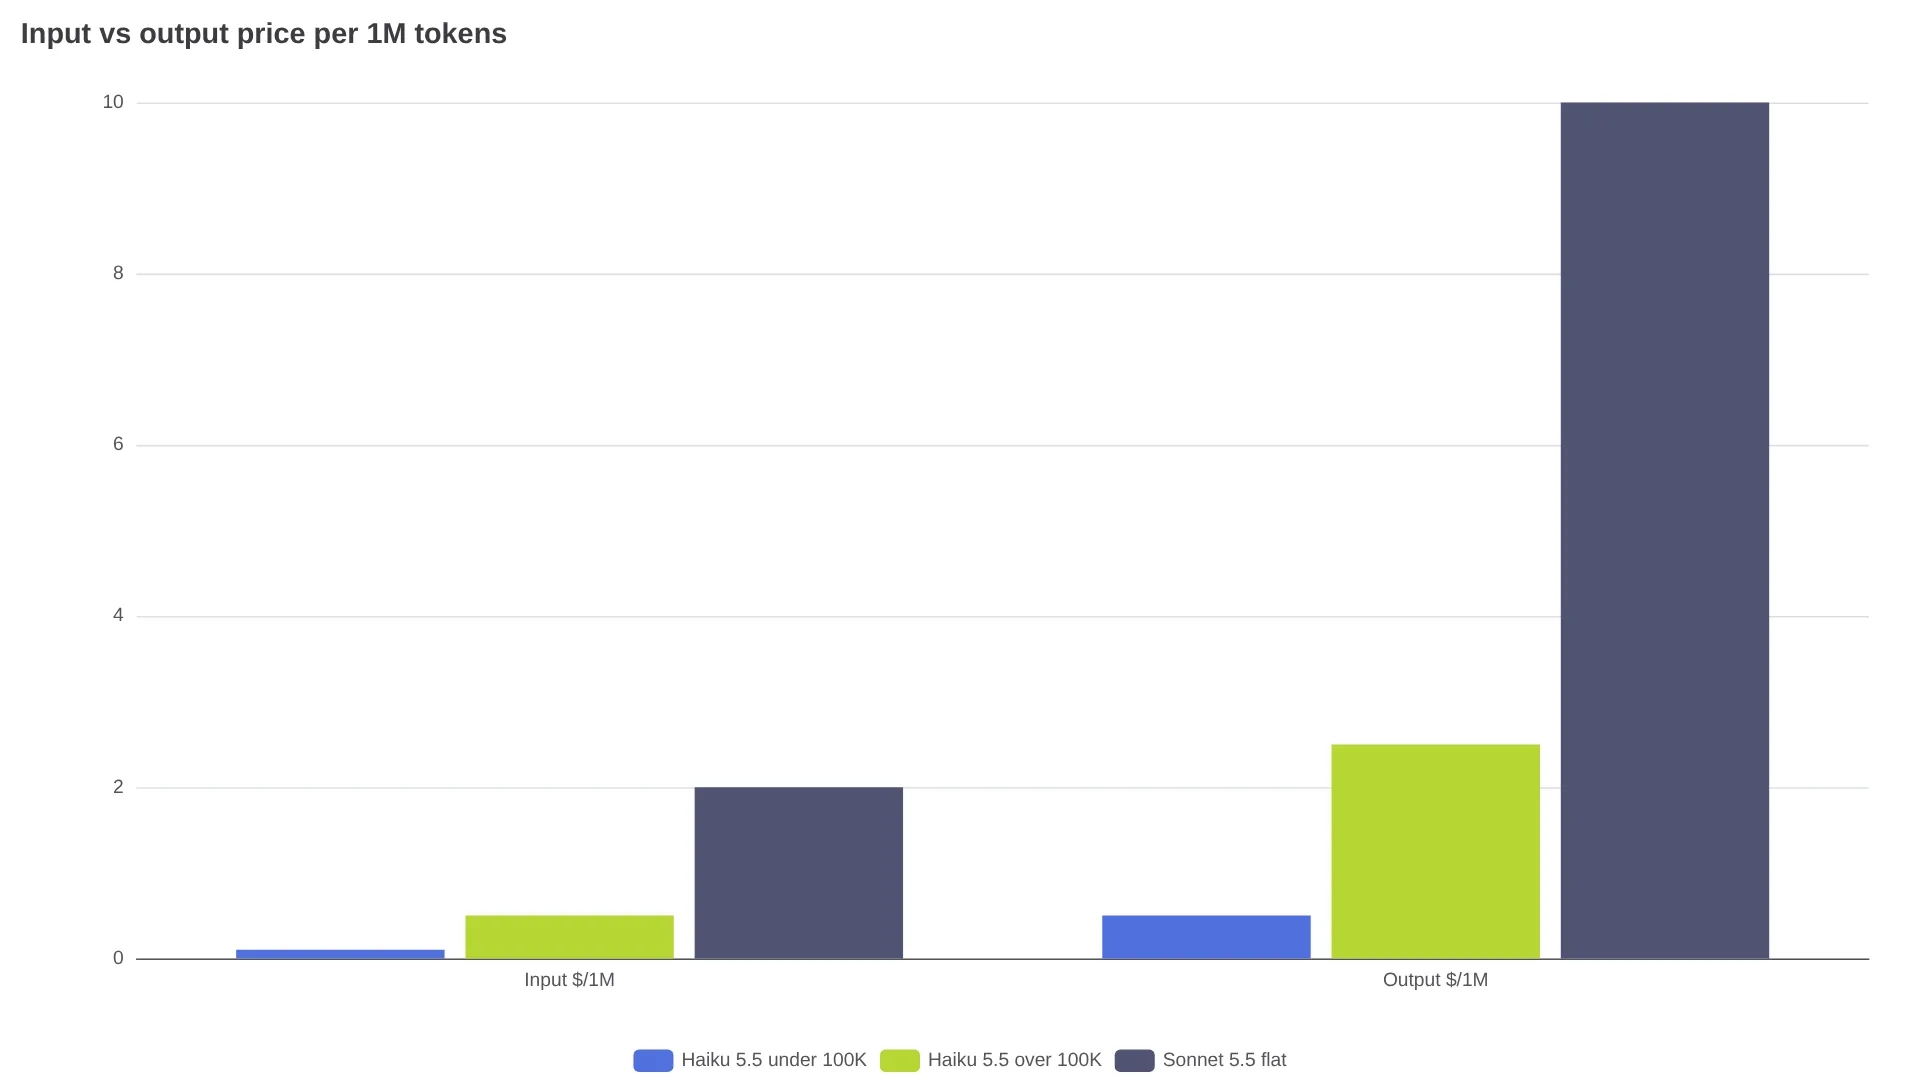
Em um lote de 1.000 documentos idênticos com 99K tokens cada e saída de 1K token, o custo fica em cerca de US$ 10,40 pela tabela (a APIKO calcula US$ 4,54 para o mesmo lote em suas tarifas). Já 1.000 documentos de 101K tokens custam cerca de US$ 53,00 pela tabela: cinco vezes mais por apenas 2.000 tokens extras por documento. No mesmo lote de 101K, o Sonnet 5.5 sairia por aproximadamente US$ 212,00. A conta é uma aplicação direta dos preços de tabela relatados no teste Haiku 5.5 vs Sonnet 5.5 da APIKO. Em um lote modelado de 1.000 chamadas, cada uma com 10K de entrada e 1K de saída, o total seria de US$ 30,00 com Sonnet 5.5 contra US$ 1,50 com Haiku 5.5: redução de 95%, segundo a comparação de preços do Sonnet 5.5 e Haiku 5.5 da Sim.
Loops reais de agentes atingem esse limite sem grande esforço. Em uma discussão no r/ClaudeAI sobre o uso de tokens do Haiku 5.5, um usuário observou que as execuções passavam de 100K por volta da vigésima chamada ao modelo. Das 164 chamadas seguintes, 145 foram cobradas na faixa superior, porque histórico e saída de ferramentas vão se acumulando. Entre as sugestões da discussão estavam dividir melhor os tickets, limitar os arquivos envolvidos, silenciar saídas verbosas de testes e criar subagentes novos em vez de manter uma conversa longa. Trabalhos curtos continuam baratos no Haiku; pipelines de contexto longo precisam prever Sonnet no orçamento.
"O preço baixo do Haiku 5.5 só se mantém abaixo de 100K de contexto. Acima de 100K de entrada, o preço sobe 5x; tarefas pequenas, como tradução e resumos, economizam dinheiro, enquanto trabalhos de contexto longo deveriam usar Sonnet." — @zookmas1314
Veja também os aprofundamentos sobre preços da API do Claude Haiku 5.5 e análise e preços da API do Claude Sonnet 5.5.
O que os benchmarks realmente separam entre Haiku e Sonnet
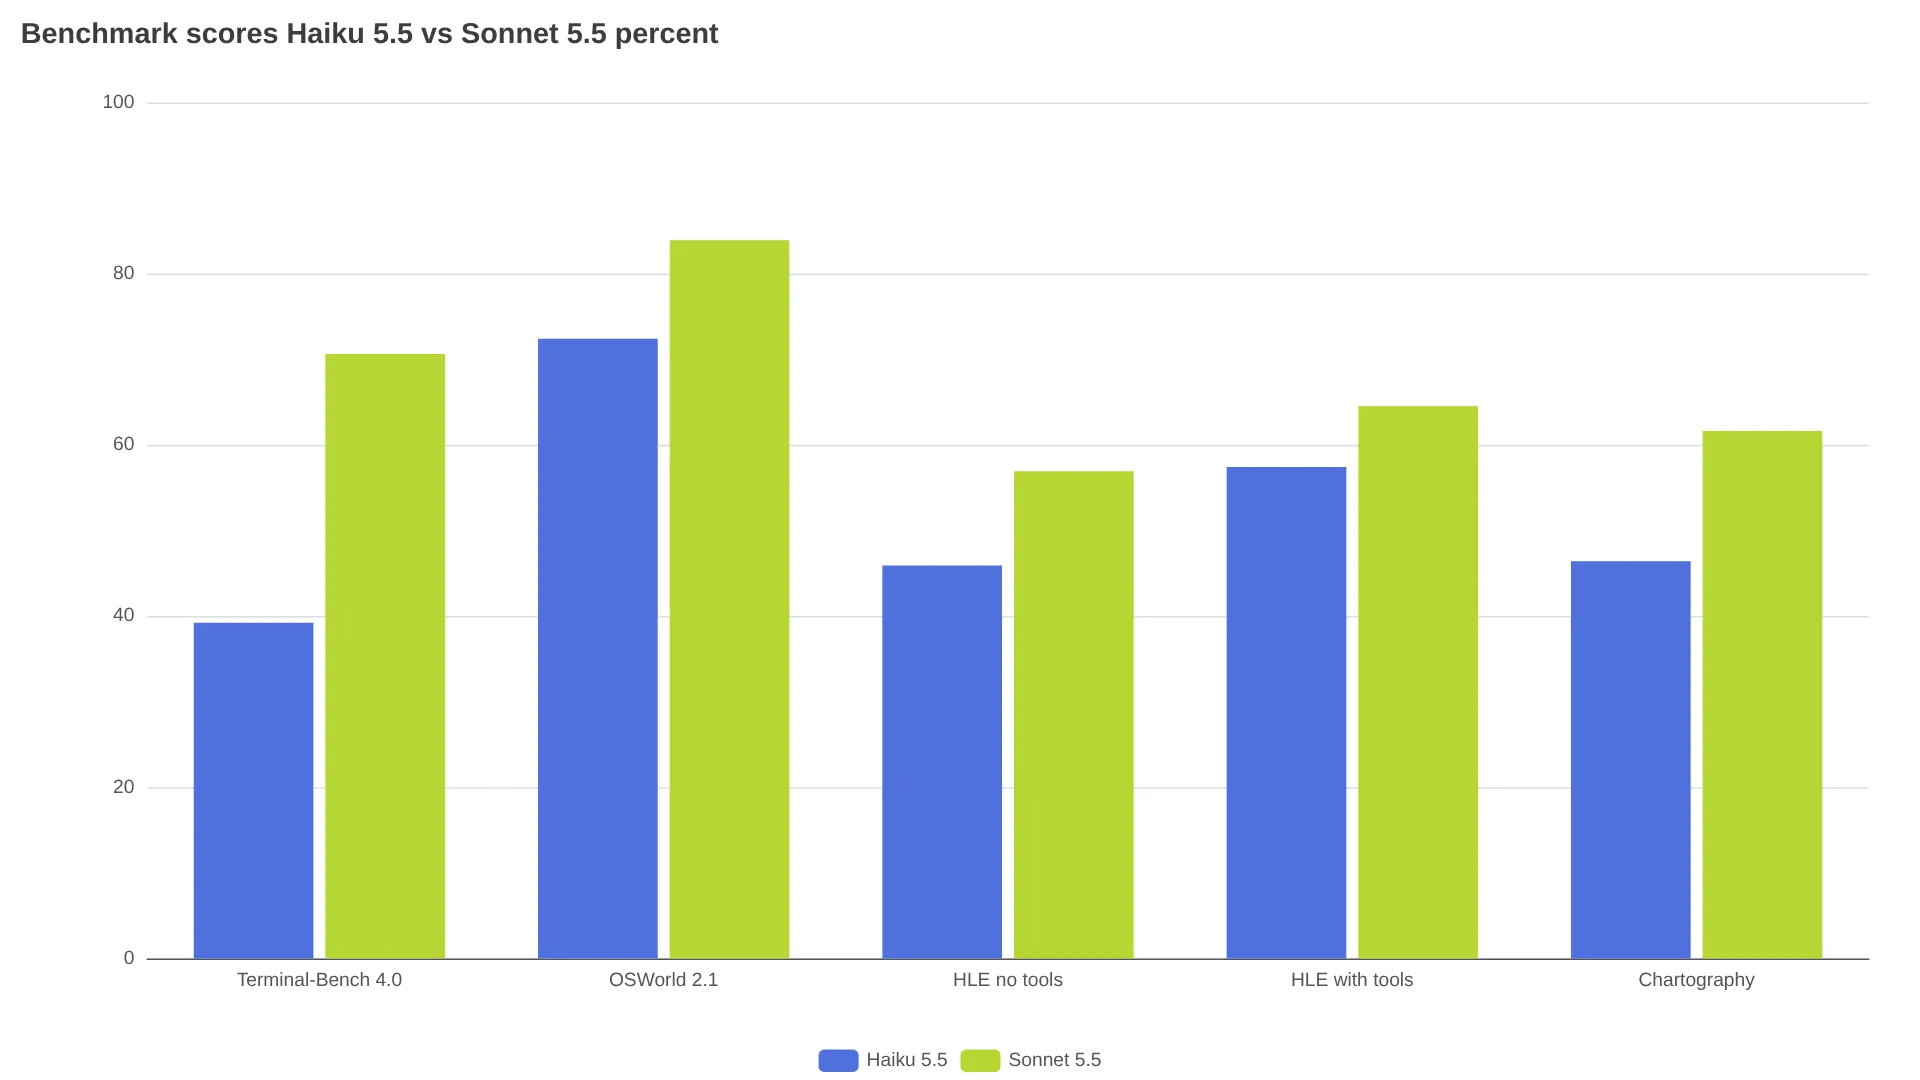
Nos benchmarks publicados, o Sonnet 5.5 lidera todos os confrontos diretos divulgados pela Anthropic. A maior distância aparece justamente onde agentes precisam escrever e executar código. No Terminal-Bench 4.0 para programação agentiva, o Haiku 5.5 marcou 39,2%, contra 70,6% do Sonnet 5.5. No uso de computador do OSWorld 2.1, a diferença é menor: 72,4% versus 83,9%. No Humanity's Last Exam sem ferramentas, os resultados são 45,9% e 56,9%; com ferramentas, 57,4% e 64,5%, conforme a tabela de benchmarks reunida na comparação da APIKO.
As configurações de esforço podem reduzir ou ampliar essas diferenças. Resultados da Artificial Analysis citados na mesma comparação colocam o Haiku em xhigh e o Sonnet em medium ambos com 41 no Intelligence Index, com notas quase iguais no Terminal-Bench (29,3% contra 29,8%). Ainda assim, o Haiku xhigh custou US$ 0,12 por tarefa, contra US$ 0,48 do Sonnet medium, mas levou 295 segundos em vez de 122 segundos. Nenhuma configuração do Haiku alcançou a nota 47 do Sonnet em high, o padrão, nesse conjunto de dados. Esses custos não incluem a faixa acima de 100K do Haiku; em trabalhos de contexto longo, devem ser tratados como um piso.
Extração e classificação específicas não precisam da margem que o Sonnet abre em código. Já o agente principal de programação, loops longos de ferramentas e raciocínio visual precisam — no Chartography, por exemplo, foram 46,4% contra 61,6%. Um único Elo ou índice não deve ser interpretado como um ranking universal de qualidade. Em um teste no Reddit, o Haiku-medium acompanhou o Sonnet em uma base de código mista, com Rust e código legado, por US$ 0,08 contra US$ 1,68. No mesmo fluxo, o Haiku-high fez 385 solicitações sem ganho de qualidade, segundo o teste controlado de programação com Haiku 5.5 no r/ClaudeCode.
O nível de esforço pesa mais que o nome do modelo
A configuração padrão de esforço explica muitas reclamações de que o Haiku seria verboso. O Haiku 5.5 usa medium por padrão, enquanto o Sonnet 5.5 usa high; a configuração de thinking também varia por modelo. No Haiku, o thinking é desativado com {"type": "disabled"}. Já o Sonnet usa {"type": "between_tools"} em esforço high ou menor, e adaptive ou thinking omitido em xhigh/max, como documentado na documentação da plataforma Claude e nas notas de comportamento da APIKO.
Na avaliação da APIKO pelo endpoint Messages, realizada em 10 de outubro de 2026 com 22 tarefas e 528 solicitações, o Haiku em low passou em 65 de 66 execuções. O Sonnet passou entre 64 e 66, dependendo da configuração, a cerca de um dezoito avos do custo de gateway nas tarefas curtas. Desativar totalmente o thinking derrubou o Haiku para 56 de 66, concentrando falhas de raciocínio e formato estrito, como soma de CSV e rastreamento de código. O Haiku no padrão medium passou em 66 de 66, mas emitiu 4,4x mais tokens de saída do que em low, principalmente tokens de thinking.
Regras práticas com base nesses dados e nos relatos de usuários:
- Comece tarefas delimitadas no Haiku
low: classificação, roteamento, extração e JSON curto não precisam do padrãomedium. - Teste Haiku
highouxhighantes de Sonnetlow: quando a meta for elevar a qualidade sem sair da faixa de preço do Haiku. Nos números da Artificial Analysis citados na comparação da APIKO, o Haikumaxmarcou 43, contra 36 do Sonnetlow, por cerca de 60% do custo. - Deixe Sonnet
mediume acima para o trabalho crítico: depuração, implementação em várias etapas e sequências longas de ferramentas, em que a latência extra do Haiku-high não traz mais qualidade. - Defina thinking explicitamente para cada modelo: em código compartilhado, um template que envie
between_toolsao Haiku oudisabledao Sonnet recebe erro 400 upstream, conforme o teste de gateway da APIKO.
"Opus/Sonnet como orquestrador e revisor principal, e Haiku como o trabalhador braçal, com uma nova instância de Haiku para cada recurso." — u/ohrajaaa no r/ClaudeAI
Roteie pelo impacto de um erro silencioso, não pela dificuldade
A pergunta útil para roteamento não é “esta tarefa é difícil?”, mas “o que acontece se o Haiku errar de forma plausível e ninguém perceber?”. Vários testes de usuários citados chegam à mesma conclusão: o Haiku pode falhar silenciosamente em tarefas que exigem julgamento, enquanto o Sonnet vale o custo quando verificar o resultado é caro.
| Se a tarefa se parece com | Modelo principal |
|---|---|
| Classificação de sentimento, roteamento de tickets, licença para JSON, resumos de logs, OCR e anotação, seleção de SQL, subagentes de compactação | Haiku 5.5 |
| Busca na base de código, edições em um arquivo, processamento de documentos em um único turno | Haiku 5.5 |
| Agente principal de programação, depuração de verdade, refatorações em várias etapas, checagem de fatos, atribuição de documentos | Sonnet 5.5 |
Usuários relatam velocidade 3x maior e grandes reduções de uso em padrões de alto volume e turno único com Haiku, incluindo um caso de processamento de vários megabytes de documentos por poucos dólares, segundo o tópico “What is Haiku 5.5 best suited for?” do r/ClaudeAI.
Uma comparação de subagentes em seis tarefas concluiu que o Haiku era barato, mas significativamente menos confiável em pesquisa e julgamento factual, deixando passar arquivos que “parecem um resultado limpo”, conforme o teste de subagentes Haiku vs Sonnet vs Opus do r/ClaudeCode. A regra de proteção daquela discussão é direta:
"Se a saída dispara uma ação… ela vai para um modelo maior ou um modelo maior a verifica." — u/vladgladi no r/ClaudeCode
Há uma ressalva de produção: cumprir formato estruturado não sai de graça no Haiku. A avaliação da APIKO registrou uma falha de formato estrito em low — rótulos corretos foram entregues dentro de um objeto JSON em vez de um array simples. Usuários do r/ClaudeCode também relatam verificações puladas e restrições ignoradas em baixo esforço, segundo o mesmo teste controlado de programação.
Uma arquitetura Haiku-first que aguenta produção
O código de integração precisa considerar thinking, escolha de ferramentas e histórico específicos de cada modelo, conforme o teste de gateway da APIKO em 10 de outubro com padrões documentados. O Haiku aceita tool_choice forçado, enquanto o Sonnet rejeita isso upstream — use auto ou saídas estruturadas. Além disso, o Haiku não consegue ler blocos de thinking do Sonnet. O Sonnet consegue ler os do Haiku se o histórico continuar somente com anexos; repetir blocos editados do Sonnet pode retornar erro 400.
O padrão Haiku-first ao qual usuários vêm chegando de forma independente é este:
- Faça a primeira passagem com Haiku 5.5 em esforço
lowpara classificar, extrair ou redigir. Para desativar thinking completamente, usethinking: {"type": "disabled"}. - Aceite apenas rótulos em uma lista permitida ou JSON válido contra o schema. Escale qualquer resultado incerto, inválido ou relevante para Sonnet 5.5 em
medium. - Mantenha subagentes novos e descartáveis: uma instância de Haiku por arquivo ou recurso, em vez de deixar uma conversa crescer além de 100K.
- Use Sonnet ou Opus como revisor sempre que a saída acionar uma ação, enviar uma mensagem ou editar código de produção.
"O Haiku é muito bom se você sabe o que fazer e como revisar a qualidade dele." — u/Awric no r/ClaudeCode
A Anthropic posiciona o Haiku 5.5 como subagente para tarefas de alto volume, como resumos, ao lado de Sonnet ou Opus, segundo @ClaudeDevs. Em uma configuração compartilhada, enxames de Haiku fazem buscas no repositório enquanto o Sonnet mantém os diffs e testes, segundo @mirku21.
Perguntas frequentes sobre Haiku 5.5 vs Sonnet 5.5
Quanto o Haiku 5.5 é mais barato que o Sonnet 5.5?
Pelo preço de tabela, 20x abaixo de 100K tokens de prompt (US$ 0,10/US$ 0,50 contra US$ 2/US$ 10 por 1M) e 4x acima de 100K (US$ 0,50/US$ 2,50 contra US$ 2/US$ 10). Leituras de cache custam US$ 0,01 contra US$ 0,10 por 1M.
Haiku 5.5 e Sonnet 5.5 têm a mesma janela de contexto?
Sim. Ambos informam janela de contexto de 1M de tokens e saída máxima de 128K, segundo a Anthropic e a documentação da plataforma.
O Haiku 5.5 é bom o bastante para uso de API em produção?
Para tarefas específicas, auditáveis e de alto volume, sim — normalmente em esforço low e com validação de schema. Em programação como agente principal e pesquisa que exige muito julgamento, usuários relatam mais erros e falsos positivos que no Sonnet 5.5.
Qual modelo é melhor para agentes de programação?
Sonnet 5.5 para o agente principal e para depuração, com 70,6% contra 39,2% no Terminal-Bench. Haiku 5.5 para tarefas de busca, digitação e subagentes de um arquivo, com revisão de Sonnet ou Opus.
Como ficar abaixo do limite de preço de 100K do Haiku?
Divida documentos antes do limite, restrinja subagentes aos arquivos relevantes, silencie saídas verbosas de testes e crie subagentes novos para cada tarefa. O histórico agentivo passa de 100K em aproximadamente 20 chamadas.
Posso mover uma conversa do Sonnet 5.5 para o Haiku 5.5 no meio do caminho?
Não de forma limpa. O Haiku não consegue ler blocos de thinking do Sonnet, então é preciso continuar no Sonnet ou reiniciar no Haiku. Mover o histórico do Haiku para o Sonnet preserva o raciocínio se ele permanecer somente com anexos.
O trade-off que nenhum roteamento elimina
| Se sua carga de trabalho parece com | Escolha | Motivo |
|---|---|---|
| Centenas de classificações, extrações, resumos e normalizações de JSON | Haiku 5.5 em low | Taxas de acerto próximas às do Sonnet em tarefas curtas, por cerca de 1/18 do custo quando há validação |
| Uma grande base de código, loops longos de ferramentas, depuração que precisa acertar | Sonnet 5.5 | Vantagem de 31 pontos no Terminal-Bench e menos falhas silenciosas |
| Documentos próximos de 100K | Calcule os dois preços | A faixa 5x do Haiku elimina boa parte da diferença; acima do limite, o Sonnet custa apenas 4x mais |
| Qualquer cenário em que um erro silencioso chega à produção | Rascunho com Haiku e revisão com Sonnet | O custo por sucesso verificado supera o preço nominal por token |
O Haiku 5.5 vence no preço por tentativa. O Sonnet pode sair mais barato quando revisões e novas execuções passam a dominar o custo de tokens. Construa o roteador em torno dessa diferença, e nenhum dos dois modelos precisará ser uma aposta.