 AIREITER
O Claude Sonnet 5.5 combina preço de US$ 2 por milhão de tokens de entrada com uma pontuação divulgada de 70,6% no Terminal-Bench 4.0. Mas agentes configurados para trabalhar no nível máximo de esforço podem elevar bastante o custo real por alteração aceita. Para equipes escolhendo um modelo de programação para produção, o Sonnet 5.5 é a opção padrão que vale testar primeiro — não um substituto automático para o Opus 5.5.
Veredito para produção: use o Sonnet 5.5 como modelo padrão de programação
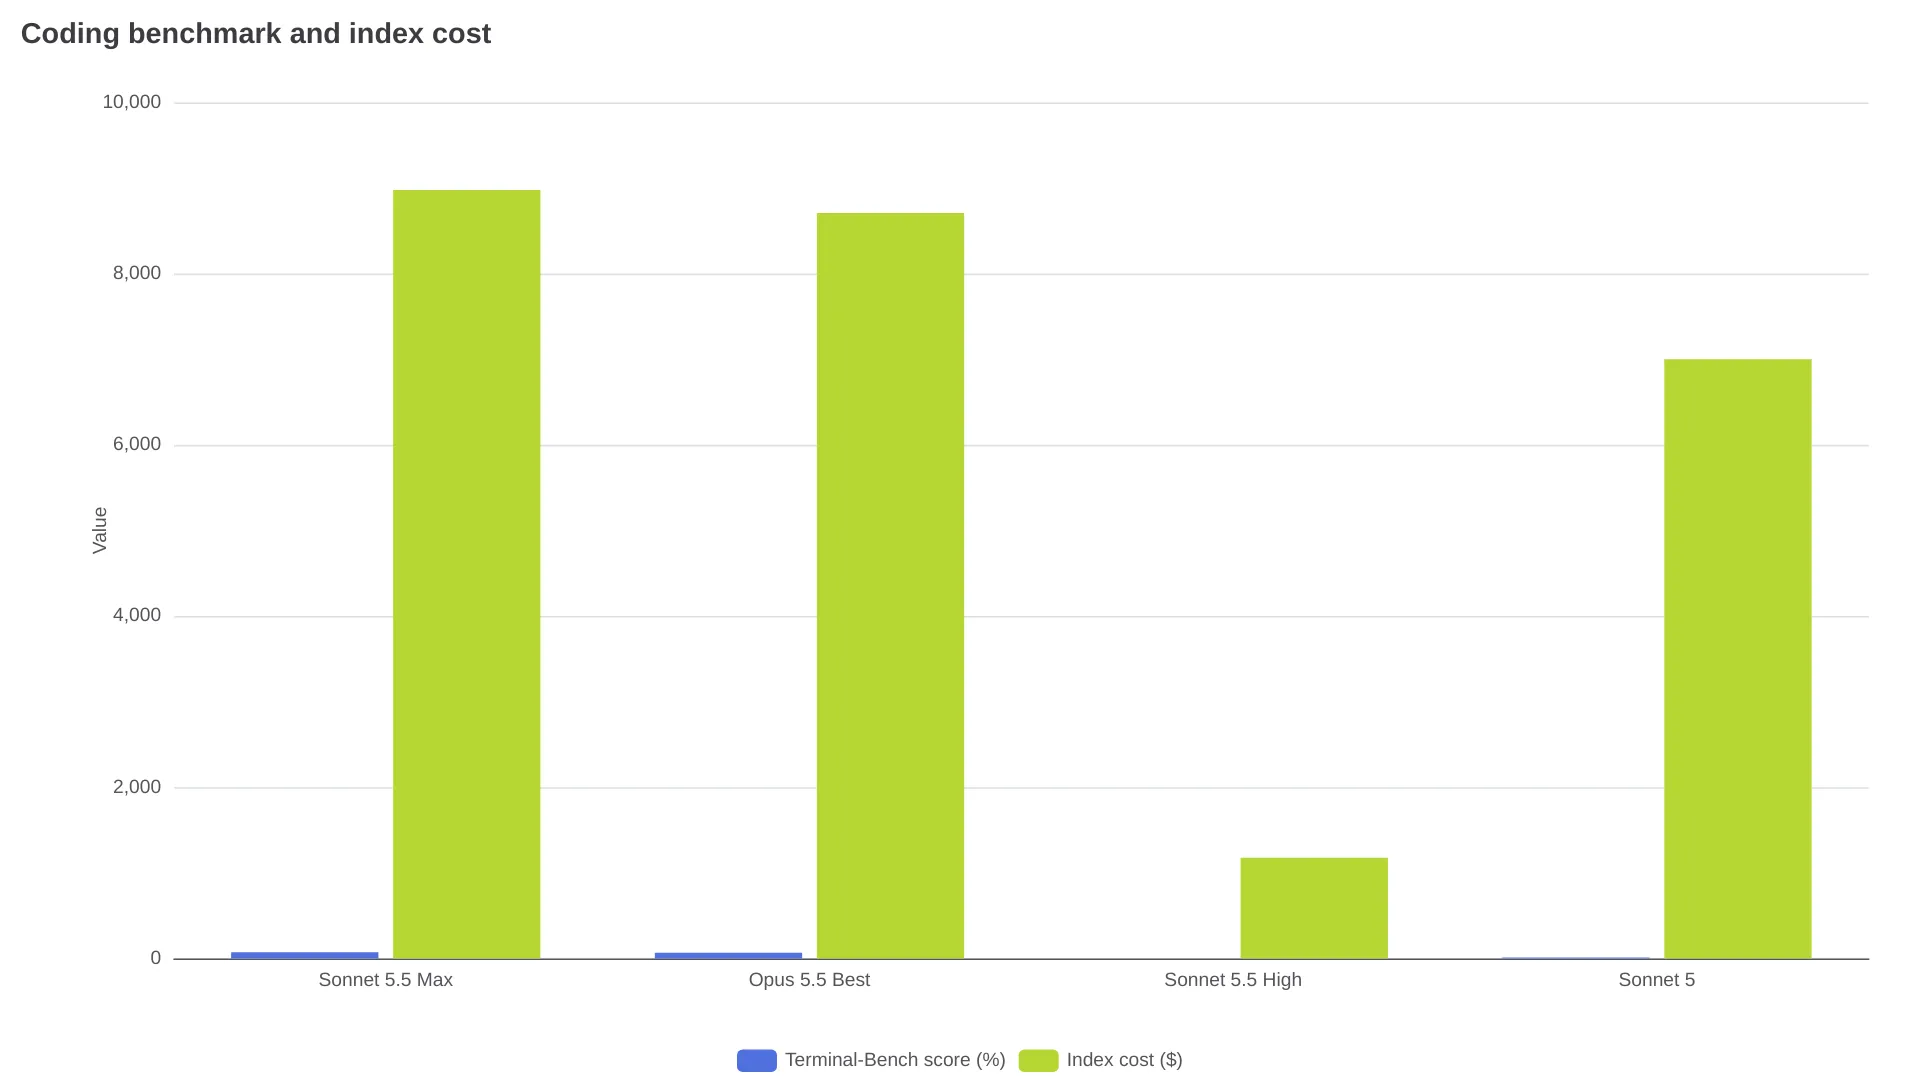
Comece o piloto do Claude Sonnet 5.5 com correções de bugs bem delimitadas, refatorações, geração de testes e tarefas de repositório que usam ferramentas. O resultado divulgado pela Anthropic no Terminal-Bench 4.0 foi de 70,6%, acima dos 66,4% do Claude Opus 5.5 e dos 10,3% do Claude Sonnet 5 na mesma comparação.
A principal proteção é definir explicitamente o nível de esforço e os limites de saída. Análises independentes de custo indicam que o Sonnet 5.5, no esforço máximo, pode custar mais por tarefa de benchmark do que o Opus 5.5, apesar das tarifas de tabela menores do Sonnet.
O que o Claude Sonnet 5.5 muda para equipes que usam a API
O Claude Sonnet 5.5 foi lançado em 28 de setembro de 2026. A documentação oficial do modelo lista o ID claude-sonnet-5-5, janela de contexto de 1 milhão de tokens, saída máxima padrão de 128.000 tokens, raciocínio adaptativo e nível de esforço padrão da API definido como high.
| Detalhe de produção | Claude Sonnet 5.5 |
|---|---|
| Data de lançamento | 28 de setembro de 2026 |
| ID do modelo | claude-sonnet-5-5 |
| Janela de contexto | 1 milhão de tokens |
| Saída máxima padrão | 128 mil tokens |
| Saída máxima em lotes | 300 mil tokens com o cabeçalho beta documentado |
| Esforço padrão da API | high |
A documentação da Anthropic se compromete a não retirar o modelo de circulação antes de 28 de setembro de 2027. Isso estabelece um prazo mínimo de disponibilidade, não uma data final garantida para a aposentadoria do modelo.
Os padrões da API que afetam a conta de programação
O raciocínio adaptativo vem ativado por padrão. Equipes que migrarem do Sonnet 5 devem testar between_tools caso precisem desativar o raciocínio antecipado. Segundo a documentação oficial, o uso forçado de ferramentas agora retorna um erro, e valores não padrão para temperature, top_p ou top_k retornam erros HTTP 400.
O texto gerado entre chamadas de ferramentas pode chegar em blocos thinking. Um cliente de streaming que presume que toda mensagem intermediária é um bloco de texto comum pode parecer travado depois da migração. Atualize o parser antes de colocar o Sonnet 5.5 em um agente de programação já existente.
Desempenho no Terminal-Bench: forte o bastante para ser a opção padrão
O principal benchmark de agentes de programação citado aqui é o Terminal-Bench 4.0, que avalia tarefas de linha de comando com várias etapas. Os resultados divulgados pela Anthropic colocam o Sonnet 5.5 em 70,6%, contra 66,4% do Opus 5.5 e 10,3% do Sonnet 5.
| Modelo | Terminal-Bench 4.0 | GDPval-AA Elo | CursorBench 4.0 |
|---|---|---|---|
| Claude Sonnet 5.5 | 70,6% | 1844 | 55,5% |
| Claude Opus 5.5 | 66,4% | 1846 | 57,8% |
| Claude Sonnet 5 | 10,3% | 1449 | 34,1% |
Os números acima aparecem no resumo de benchmarks da DataCamp, que atribui os resultados da avaliação ao material de lançamento da Anthropic. O Sonnet 5.5 lidera a comparação em tarefas de terminal, mas o Opus 5.5 continua à frente no CursorBench e em várias avaliações mais amplas de raciocínio e trabalho de conhecimento.
Valide o modelo com replays de repositórios, usando testes aprovados, número de turnos com ferramentas e alterações aceitas — não apenas os diffs.
Preços da API do Claude Sonnet 5.5 em cargas reais
A tabela de preços da Anthropic é simples, mas um agente de programação pode pagar por mais do que o prompt visível. Os tokens de raciocínio são cobrados como saída, e o contexto repetido do repositório pode virar leitura de cache ao longo dos turnos.
| Item da API | Preço do Claude Sonnet 5.5 |
|---|---|
| Entrada | US$ 2 por 1 milhão de tokens |
| Saída, incluindo raciocínio | US$ 10 por 1 milhão de tokens |
| Gravação de cache por 5 minutos | US$ 2,50 por 1 milhão de tokens |
| Gravação de cache por 1 hora | US$ 4 por 1 milhão de tokens |
| Leitura de cache | US$ 0,20 por 1 milhão de tokens |
| Entrada em lotes | Desconto de 50%, equivalente a US$ 1 por 1 milhão |
| Saída em lotes | Desconto de 50%, equivalente a US$ 5 por 1 milhão |
A documentação oficial informa um mínimo de 512 tokens para prompts armazenáveis em cache e explica que o Sonnet 5.5 usa raciocínio adaptativo. Segundo a análise independente de preços da eesel, o Sonnet 5.5 usa o mesmo tokenizador do Sonnet 5; portanto, a migração não reduz automaticamente a contagem de tokens.
Uma solicitação com 4.000 tokens de entrada e 700 tokens de saída custa cerca de US$ 0,015 antes de outras cobranças: US$ 0,008 pela entrada mais US$ 0,007 pela saída. Um agente de programação que execute 20 turnos, com 3.000 tokens novos de entrada e 2.000 tokens de saída por turno, consumiria aproximadamente US$ 0,12 em entrada nova e US$ 0,40 em saída, antes de leituras e gravações de cache, ferramentas ou novas tentativas. São exemplos de carga de trabalho, não preços universais por tarefa.
O nível de esforço é o controle de preço
A análise de esforço da TokenCost, baseada nas medições do Artificial Analysis Intelligence Index, registrou estes resultados para o Sonnet 5.5:
| Esforço | Pontuação | Custo do índice completo |
|---|---|---|
| Low | 35,8 | US$ 544 |
| Medium | 40,7 | US$ 701 |
| High | 46,7 | US$ 1.176 |
| Xhigh | 51,9 | US$ 2.738 |
| Max | 56,0 | US$ 8.977 |
O resultado no nível máximo é o alerta principal. A mesma análise colocou o Opus 5.5 no nível máximo em 57,6 por US$ 8.708, enquanto o Opus 5.5 em xhigh chegou a 56,0 por US$ 4.057. Nesse teste, o Sonnet 5.5 no nível máximo usou aproximadamente 193.000 tokens de saída por tarefa.
Comece com esforço médio ou alto, limite o número de tokens de saída e encaminhe apenas tarefas malsucedidas ou de alto risco para uma rota mais cara. Não replique uma configuração antiga de esforço máximo do Sonnet 5 no Sonnet 5.5 sem refazer as avaliações de custo e qualidade.
Checklist de migração para um modelo de programação em produção
- Fixe o
claude-sonnet-5-5no ambiente de staging, em vez de alterar um alias globalmente. - Reexecute correções de bugs, refatorações, testes e mudanças em vários arquivos representativas dos seus repositórios.
- Defina o nível de esforço explicitamente e registre tokens de saída, leituras de cache, turnos com ferramentas, tempo total e taxa de alterações aceitas.
- Substitua
thinking: disabledpelo comportamento compatívelbetween_toolsquando apropriado. - Remova as suposições sobre uso forçado de ferramentas e teste o novo comportamento de escolha de ferramentas.
- Atualize o código de streaming para lidar com blocos
thinkingentre chamadas de ferramentas. - Revise os parâmetros de amostragem não padrão; a documentação oficial lista erros 400 para
temperature,top_petop_knão padrão. - Adicione um teto de gastos e uma condição de interrupção para saídas descontroladas ou loops repetidos de ferramentas.
- Compare o custo por alteração aceita, não o custo por solicitação.
- Faça o rollout para uma pequena porcentagem do tráfego. Aumente a participação do Sonnet apenas se ele alcançar a taxa de alterações aceitas do modelo atual dentro da tolerância definida pela equipe e reduzir o custo por alteração aceita.
O funcionário da Anthropic @cjav_dev relatou que solicitações usando thinking: {"type":"disabled"} começaram a retornar erros 400 e deveriam migrar para between_tools (post no X).
Quando escolher Sonnet 5.5, Opus 5.5 ou um modelo mais barato
| Carga de trabalho | Primeira escolha recomendada | Motivo |
|---|---|---|
| Correções de bugs e refatorações bem delimitadas | Sonnet 5.5 em medium/high | Boa pontuação em terminal com tarifas menores por token |
| Classificação de código em alto volume ou edições simples | Sonnet 5.5 em low/medium ou um modelo mais barato | Evita pagar por raciocínio desnecessário |
| Agente de repositório de longa duração | Sonnet 5.5 com cache e orçamentos rígidos | Cache e quantidade de turnos definem a conta real |
| Arquitetura ambígua ou revisão final | Opus 5.5 | Uma avaliação mais ampla importa mais do que a menor tarifa |
| Análise de código offline e sem urgência | Claude Sonnet 5.5 Batch API | A API oferece desconto de 50% na entrada e na saída |
| Experimento de terminal com esforço máximo | Sonnet 5.5 somente após um benchmark interno | O Terminal-Bench é um ponto forte, mas o nível máximo pode custar caro |
Use o Sonnet para tarefas bem definidas e mensuráveis; encaminhe trabalhos arquiteturais ambíguos para o Opus.
FAQ da API do Claude Sonnet 5.5
Quanto custa a API do Claude Sonnet 5.5?
A tarifa padrão é de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída. Leituras de cache custam US$ 0,20 por milhão de tokens, enquanto gravações de cache custam US$ 2,50 por cinco minutos ou US$ 4 por uma hora. A Batch API oferece desconto de 50% na entrada e na saída.
O Sonnet 5.5 é melhor que o Opus 5.5 para programação?
O Sonnet 5.5 lidera a comparação publicada do Terminal-Bench 4.0, com 70,6%, contra 66,4% do Opus 5.5. O Opus continua à frente em várias outras avaliações, então as equipes devem fazer o roteamento por tipo de tarefa, em vez de tratar o resultado de programação como um ranking universal.
Qual é o ID do modelo Sonnet 5.5?
Use claude-sonnet-5-5 na Claude API. Os identificadores específicos de cada provedor estão listados na documentação de modelos da Anthropic.
O Sonnet 5.5 oferece janela de contexto de 1 milhão de tokens?
Sim. A Anthropic lista uma janela de contexto de 1 milhão de tokens e saída máxima padrão de 128.000 tokens. A versão beta da Message Batches API pode oferecer 300.000 tokens de saída com o cabeçalho beta documentado.
O que mudou na migração do Sonnet 5?
O raciocínio adaptativo e o comportamento dos blocos de resposta mudaram, o uso forçado de ferramentas pode gerar erros, parâmetros de amostragem não padrão podem retornar erros 400 e thinking: disabled precisa ser substituído pelo comportamento compatível. Reexecute os testes do agente e do streaming antes do rollout em produção.
Faça um piloto de replay de uma semana com esforço médio/alto, medindo o custo por alteração aceita e encaminhando os casos malsucedidos para o Opus.