 AIREITER
리더보드만 보면 두 음성 인식 모델의 성능이 거의 비슷해 보일 수 있습니다. 하지만 실제로 알고 싶은 건 따로 있습니다. 어떤 화자와 지역, 기기, 표기 방식에서 비슷한 성능을 냈는가? 새롭게 추가된 en-IN 및 hi-IN 평가 세트는 Open ASR Leaderboard를 다국어 ASR 평가에 더 유용하게 만들어줍니다. 다만 공개 음성이 짧은 편인 만큼, 결과를 해석할 때는 여전히 주의가 필요합니다.
핵심 요약: Monsoon은 리더보드가 설명할 수 있는 범위를 넓힌다
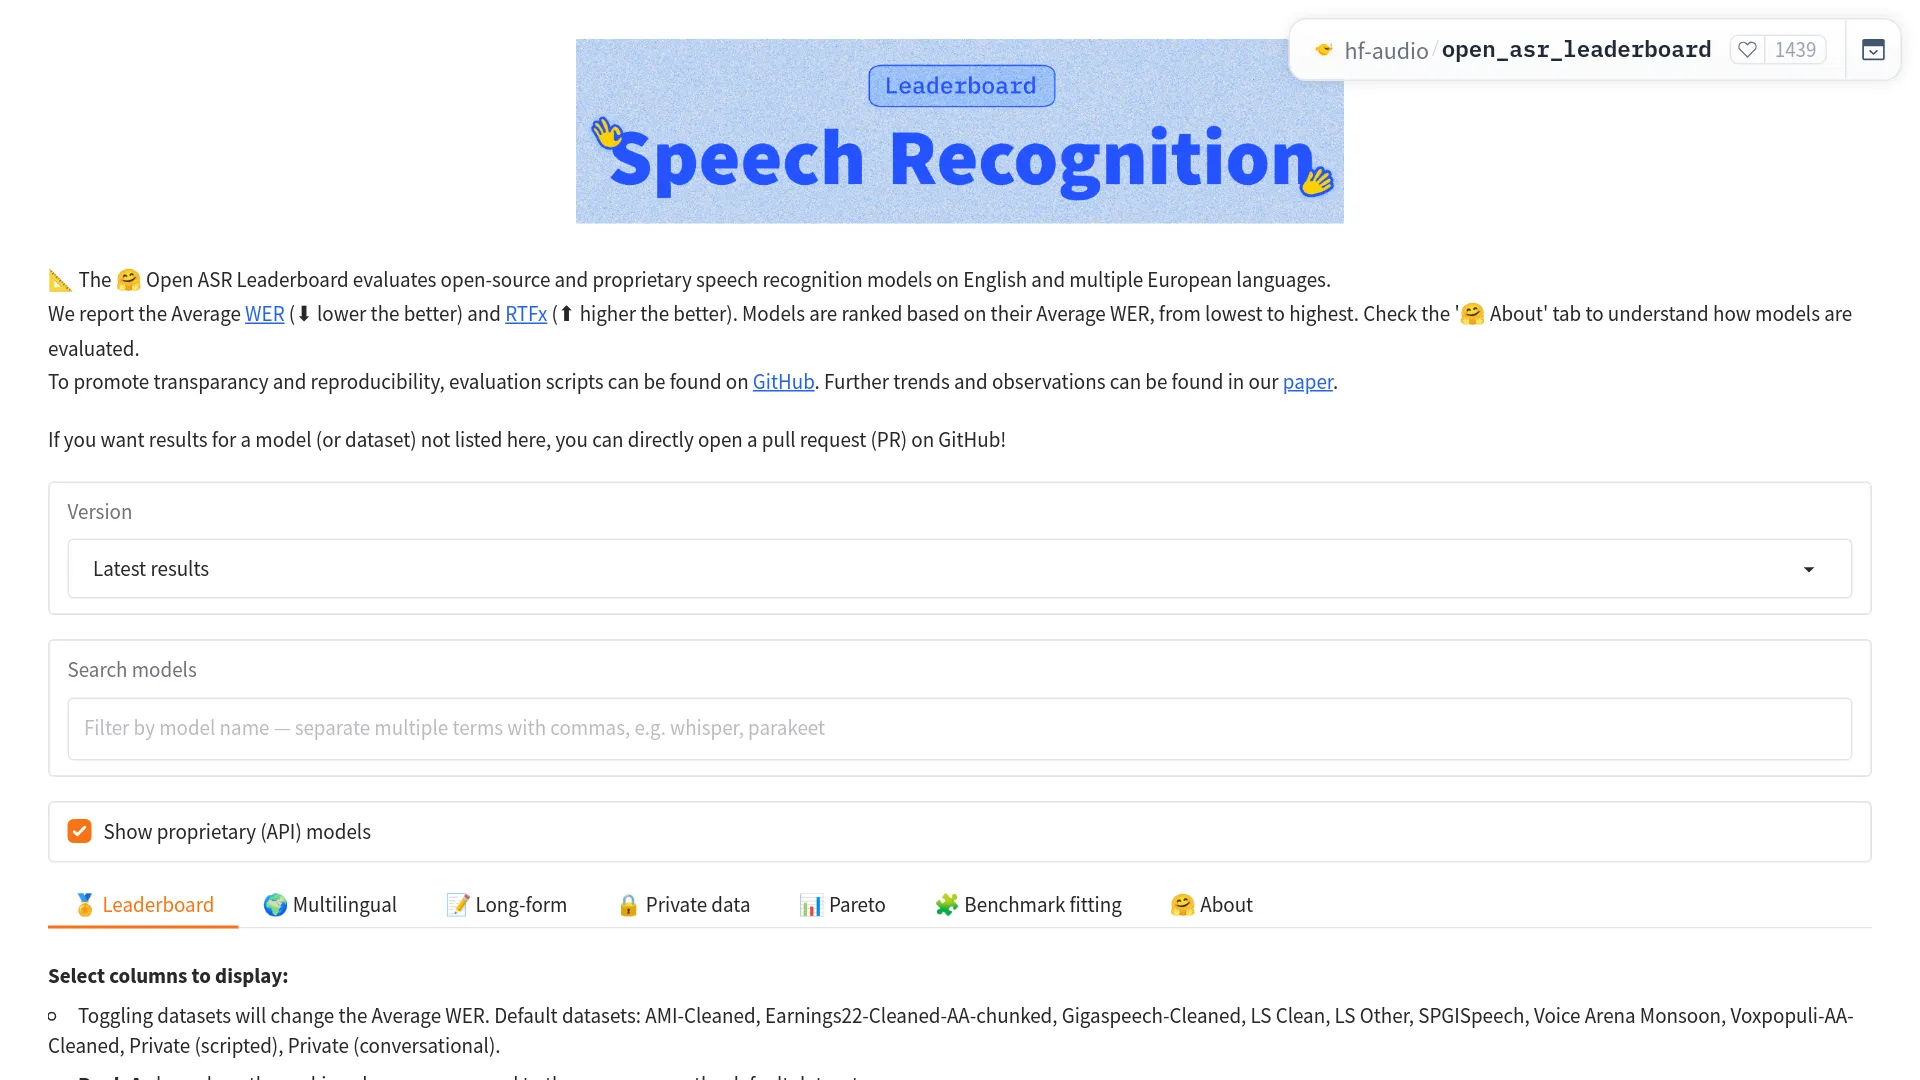
Open ASR Leaderboard에 이제 두 개의 Voice Arena 평가 세트가 추가됐습니다. 인도 영어를 위한 Monsoon en-IN과 힌디어를 위한 Monsoon hi-IN입니다. 인도 영어는 메인 리더보드 열에 포함되며, 대표 지표인 Average WER에도 반영됩니다. 힌디어는 다국어 평가 화면에서 확인할 수 있고, 선택한 모든 언어를 지원하는 모델만 다국어 순위를 받을 수 있습니다.
공개·비공개 네 개 분할 세트에는 서로 겹치지 않는 4,888명의 화자가 포함되어 있으며, 인구통계, 배경, 지역, 휴대전화 등 화자 관련 속성 12개가 기록돼 있습니다. 따라서 연구자는 “평균 WER이 가장 낮은 모델은 무엇인가?”에서 한발 더 나아가 모델별로 어떤 조건에서 성능이 흔들리는지도 살펴볼 수 있습니다. Monsoon은 지역별 강건성과 힌디어 전사 점수 평가를 개선하는 의미 있는 업데이트입니다. 다만 이를 곧바로 프로덕션 성능 보증이나 인도의 모든 언어를 대표하는 전국 단위 지표로 받아들여서는 안 됩니다.
Open ASR Leaderboard에 추가된 Monsoon의 구성
Monsoon은 대화형 자연 발화 수집 파이프라인을 통해 마련된 네 개의 테스트 분할 세트를 추가합니다. 각 언어에는 직접 점수를 계산할 수 있는 공개 세트와, 벤치마크에 맞춘 튜닝을 어렵게 만드는 비공개 세트가 하나씩 있습니다. 공식 발표에 따르면 이번 공개는 이 리더보드의 다국어 평가 맥락에 인도 언어가 추가된 첫 사례입니다.
분할 세트별 구성
| 분할 세트 | 음성 | 화자 | 클립 | 출신 지역 | 주 / 연방 직할지 | 기기 | 참조 형식 |
|---|---|---|---|---|---|---|---|
| Monsoon en-IN public | 5.62시간 | 1,444 | 2,102 | 428 | 24 / 6 | 556 | 비유창성을 포함한 정규화 텍스트 |
| Monsoon en-IN private | 5.58시간 | 1,405 | 공개되지 않음 | 420 | 24 / 6 | 560 | 비유창성을 포함한 정규화 텍스트 |
| Monsoon hi-IN public | 1.33시간 | 468 | 753 | 202 | 11 / 3 | 315 | 허용된 변형 표기의 lattice |
| Monsoon hi-IN private | 4.47시간 | 1,571 | 공개되지 않음 | 295 | 12 / 3 | 582 | 허용된 변형 표기의 lattice |
공개 Monsoon en-IN 데이터셋 카드에 따르면 오디오는 16kHz이며, 평균 클립 길이는 9.6초, 중앙값은 10.4초입니다. Monsoon hi-IN 카드는 공개 세트의 평균 클립 길이를 6.4초, 중앙값을 5.0초로 제시합니다. 네 개 분할 세트의 총 길이는 17.00시간입니다. 긴 통화 녹음보다는 짧은 대화형 구간을 폭넓게 담는 데 초점을 둔 벤치마크라고 볼 수 있습니다.
재현은 공개 세트에서, 일반화 평가는 비공개 세트에서
연구자는 Hugging Face에서 공개 세트를 불러온 뒤 인식기를 실행하고, 출력을 정규화해 코퍼스 단위 점수를 계산할 수 있습니다. en-IN의 경우 데이터셋 카드는 클립별 WER 평균이 아니라 전체 참조 단어 수를 기준으로 삽입·삭제·대체 오류의 총합을 나누도록 요구합니다.
힌디어 공개 카드에는 lattice를 고려하는 voi-oiwer 스코어러가 제공됩니다. 기본적인 로딩 방식은 다음과 같습니다.
from datasets import load_dataset
from voi_oiwer import oiwer

hi = load_dataset(
    "VoiceArena/MonsoonASR-Open-ASR-leaderboard-hi-IN",
    split="test",
)
hypothesis = "replace with your model output for hi[0]"
result = oiwer(hypothesis, hi[0]["lattice"], "hindi")
score, (ins, dele, sub), ref_words = result[0], result[4], result[5]
비공개 세트는 각 평가 예시에 맞춰 모델을 튜닝할 수 없도록 화자 중복 없이 분리해 보관됩니다. 비공개 데이터 설계에 따라 결과는 공개 기본 순위를 다시 정의하는 대신 별도의 집계 화면으로 제공됩니다.
이번 업데이트의 핵심은 화자 범위 확대다
공개 en-IN 세트에는 1,444명의 화자와 2,102개 클립이, 공개 hi-IN 세트에는 468명의 화자와 753개 클립이 포함됩니다. 공식 발표의 커버리지 표에 따르면 네 개 분할 세트 전체에서 기여도가 가장 큰 10명의 화자가 차지하는 총 녹음 시간은 2.8%에서 6.8%에 불과합니다.
특정 화자 한 명이나 마이크, 녹음 스타일이 전체 점수를 좌우할 가능성은 줄어듭니다. 그렇다고 표본이 대표성을 갖는다는 뜻은 아닙니다. 기록된 12개 속성에는 성별, 생년월일, 직업, 교육 수준, 결혼 여부, 소득, 출신 지역과 주, 현재 도시, 현재 지역 거주 기간, 기기 제조사, 기기 모델이 포함됩니다.
인도 영어는 하나의 억양이 아니라 지역별 분포다
공개 en-IN 세트는 출신 지역 428곳, 30개 주 및 연방 직할지, 현재 거주 도시 641곳, 휴대전화 모델 556종을 아우릅니다. 세그먼트 구성은 남부 35%, 동부 18%, 중부 18%, 북부 16%, 서부 11%입니다. Hugging Face 발표에 따르면 화자 비중이 13%를 넘는 단일 주는 없습니다.
native_district, native_state, current_city, years_spent_in_current_district, device_manufacturer, device_model 필드를 활용하면 지역별·기기별 세부 그룹을 비교할 수 있습니다. 즉, “인도 영어”는 특정 마이크 환경이나 하나의 억양을 뜻하지 않습니다. 전체 WER은 경쟁력 있어도 특정 지역의 음성 분포에서는 성능이 불안정할 수 있습니다.
힌디어는 커버리지도, 점수 계산 방식도 다르다
공개 힌디어 세트는 상대적으로 작습니다. 1.33시간, 468명의 화자, 202개 지역, 315종의 휴대전화 모델로 구성됩니다. 힌디어 커버리지는 힌디어 벨트에 집중되어 있으며, 발표에 따르면 수집된 힌디어 화자 중 우타르프라데시 출신이 약 40%를 차지합니다. 힌디어 평가 결과를 해석할 때 유용한 정보지만, 모든 힌디어 사용 공동체가 균등하게 포함됐다는 의미는 아닙니다.
힌디어에는 영어에서 유래한 단어, 코드 스위칭, 붙여 쓰거나 띄어 쓰는 합성어, 데바나가리 표기 변형, 로마자 표기 대안이 함께 나타납니다. 그래서 hi-IN 데이터셋 카드는 각 전사 구간에 여러 허용 표기를 담을 수 있도록 lattice를 사용합니다.
지역별 오류 분석은 전체 WER에 가려진 차이를 드러낸다
공식 지역별 분석 사례는 공개 인도 영어 세트를 기준으로 합니다. 여덟 개 모델의 WER은 4.81에서 4.99 사이에 몰려 있으며, 차이는 고작 0.18포인트입니다. 발표에서는 테스트 세트가 약 5시간 규모인 만큼 이 정도로 작은 차이를 구분하기 어려울 수 있다고 설명합니다.
같은 결과를 다섯 개 지리적 권역으로 나눠 보면 안정성의 양상이 달라집니다.
| 모델 | 전체 결과 관찰 | 지역별 편차 | 구체적인 지역 결과 |
|---|---|---|---|
openai/whisper-large-v3-turbo | 전체 점수는 경쟁력 있음 | 0.46 WER 포인트 | 사례에서는 가장 약한 지역을 공개하지 않음 |
mistralai/Voxtral-Mini-3B-2507 | 전체적으로 Whisper보다 0.14포인트 낮음 | 1.68 WER 포인트 | 중부 4.38, 동부 6.06 |
ibm-granite/granite-speech-3.3-2b | 지역별 분석에 포함 | 보고되지 않음 | 북부가 가장 약한 지역 |
microsoft/VibeVoice-ASR-HF | 지역별 분석에 포함 | 보고되지 않음 | 남부가 가장 약한 지역 |
편차가 더 크다고 해서 Voxtral이 오류를 네 배 더 많이 냈다는 뜻은 아닙니다. Voxtral에서 지역별 변동성이 더 크게 나타났다는 의미입니다. 모델마다 취약한 지역도 달랐지만, 그 원인이 무엇인지는 이 결과만으로 입증할 수 없습니다.
실제 사용자 @FoucqueThomas도 출시 후 같은 차이를 지적했습니다.
“⚡ L'Open ASR Leaderboard ajoute l'hindi et l'anglais indien (4 888 locuteurs, 12 attributs/clip). Résultat : deux modèles quasi identiques sur le WER global affichent jusqu'à ~4x d'écart selon la région du locuteur. Un benchmark enfin honnête sur la diversité vocale.” — @FoucqueThomas on X
사용자가 특정 지역에 집중되어 있다면 전체 점수가 비슷하다는 사실만으로 모델을 선택하기는 어렵습니다. 이 사례는 특정 지역별 패턴이 훈련 데이터 불균형 때문에 발생했다고 증명하지도 않습니다.
다국어 ASR 평가에서 힌디어 lattice scoring이 중요한 이유
일반적인 WER은 하나의 표준 참조 문장을 전제로 합니다. 대소문자나 철자 정규화에는 잘 맞지만, 코드 스위칭이 발생하는 힌디어에서는 한계가 분명합니다. 올바른 출력이라도 데바나가리 표기, 로마자 표기, 영어 유래 단어의 표기, 합성어의 띄어쓰기 방식이 서로 다를 수 있기 때문입니다.
Monsoon hi-IN은 이를 참조 lattice로 해결합니다. 공식 릴리스에 따르면 후보 변형을 확장한 뒤 모국어 화자인 언어 전문가가 검토하고, 실제 발화와 일치하는 표기만 남깁니다. 따라서 한 명의 어노테이터가 선택한 표기와 다르다는 이유만으로 유효한 대안이 오답 처리되지 않습니다.
리더보드는 힌디어 평가에 Orthographically-Informed Word Error Rate (OIWER)를 사용합니다. 허용된 변형은 정답으로 인정하면서도 실제 인식 오류에는 정상적으로 페널티를 부과합니다. 리더보드 통합 커밋을 보면 힌디어 데이터와 언어별 다국어 화면이 애플리케이션에 연결된 과정을 확인할 수 있습니다.
이 점수 계산 방식은 모델 순위를 바꿀 수 있습니다. 공식 발표에 따르면 힌디어 lattice를 하나의 참조 문장으로 단순화하면 모든 테스트 시스템의 오류율이 올라가며, 상승 폭도 모델마다 같지 않습니다. 다국어 리더보드는 모든 결과를 하나의 보편적인 숫자로 뭉개지 않고도 언어적으로 더 공정한 평가를 제공할 수 있습니다.
업데이트된 리더보드로 모델을 고르는 방법
Monsoon으로 후보를 좁히고 약점을 진단한 다음, 최종 후보는 실제 서비스 환경의 오디오로 검증하는 방식이 좋습니다.
- 대표 지표인 Average WER으로 후보를 줄이세요. 이제 인도 영어가 메인 리더보드 평균에 반영되므로, 읽기 음성이나 인도 영어가 아닌 영어에서만 강한 모델은 대화형 인도 억양 테스트에서 유리함을 유지하기 어렵습니다.
- 다국어 평균을 비교하기 전에 언어 지원 범위를 확인하세요. 리더보드 소스는 선택한 언어를 지원하지 않는 경우
NA로 표시하고,3/5같은Coverage값을 제공합니다. 선택한 모든 언어를 지원해야 다국어 순위를 받을 수 있습니다. 자세한 내용은 통합 코드에서 확인할 수 있습니다. - 공개 Monsoon 데이터를 문서화된 필드별로 나눠 보세요. 출신 지역, 주, 도시, 기기 등 제공되는 메타데이터를 기준으로 비교하세요. 특정 하위 그룹에서 가장 좋은 점수만 보지 말고, 편차와 오류 집중 현상을 함께 살펴야 합니다.
- 대표성을 갖춘 실제 서비스 오디오로 검증하세요. 사용하는 휴대전화 구성, 소음 환경, 코드 스위칭 패턴, VAD, 발화 길이를 반영해 테스트해야 합니다. 공개 Monsoon 클립의 평균 길이는 10초 미만이므로 모든 콜센터, 회의, 음성 에이전트 작업을 대표할 수 없습니다.
X에서 실무자 @PlimmApp은 평가가 음성이 포함된 구간에서 시작될 때 VAD가 무음 환각을 가릴 수 있다고 경고했습니다. “the vad step in your pipeline is also the blind spot… a model that emits fluent text over silence never gets charged for it.” 전체 댓글을 확인해 보세요. 온디바이스 팀이라면 VAD, 발화 종료 감지, 환각 대응을 별도로 평가해야 합니다.
Monsoon으로도 알 수 없는 것
- 규모와 장문 음성으로의 전이: 공개 en-IN 세트는 5.62시간, 공개 hi-IN 세트는 1.33시간이며 평균 클립 길이는 각각 9.6초와 6.4초입니다. 작은 점수 차이와 긴 오디오에서의 동작은 별도로 검증해야 합니다.
- 전국 단위 대표성: 폭넓은 지역, 주, 기기 커버리지가 인도 영어 또는 힌디어 사용자를 인구 비례로 조사한 결과를 의미하지는 않습니다.
- 인과관계에 대한 설명: 지역별 연관성만으로는 원인이 훈련 데이터인지, 음향인지, 음성학인지, 디코딩인지 또는 다른 요인인지 알 수 없습니다.
- 비공개 세트의 예측력: 화자 중복이 없는 비공개 세트는 일반화 성능을 평가하기 위한 것이지만, 그 안의 예시는 독립적으로 확인할 수 없습니다.
- 후속 텍스트 작업과의 적합성: 검색, 자막, 분석, 법률 전사 작업은 서로 다른 문자 체계, 정규화, 구두점, 코드 스위칭 표기 방식을 요구할 수 있습니다.
Open ASR Leaderboard Monsoon FAQ
인도 영어가 메인 리더보드 평균에 영향을 주나요?
네. Monsoon en-IN은 영어 리더보드의 기본 입력으로 사용되며 Average WER에 반영됩니다. 공개·비공개 세트의 규모는 분할 세트 구성에서 확인할 수 있습니다.
힌디어도 메인 리더보드 순위에 포함되나요?
힌디어는 다국어 화면에 표시됩니다. 선택한 언어를 지원하지 않는 경우 NA로 표시되며, 선택한 모든 언어를 지원하는 모델만 다국어 순위를 받습니다.
공개 세트를 내려받아 직접 점수를 계산할 수 있나요?
네. en-IN 및 hi-IN 카드에 로딩 예제가 있습니다. 코퍼스 단위로 집계하고, 힌디어 lattice에는 OIWER을 사용하세요.
힌디어를 일반적인 WER으로 평가하지 않는 이유는 무엇인가요?
하나의 고정된 힌디어 참조 문장만 사용하면 올바른 데바나가리, 로마자, 코드 스위칭, 합성어 표기 변형이 오답으로 처리될 수 있습니다. lattice는 각 전사 구간에 허용되는 표기들을 기록합니다.
전체 WER이 낮으면 모든 인도 지역에서 더 좋은 모델인가요?
아닙니다. 공식 en-IN 사례에서는 전체 WER이 거의 같아도 지역별 편차가 다르게 나타났습니다. 배포 전에 하위 그룹별 동작을 확인하고 대표성을 갖춘 오디오로 테스트해야 합니다.
실무적인 결론
대표 지표를 통한 1차 선별에는 en-IN을, 힌디어 또는 다국어 비교에는 hi-IN과 OIWER을 사용하세요. 지역별 편차가 크다면 이를 위험 신호로 보고, 최종 후보는 실제 사용자가 생성하는 오디오와 소음 환경, VAD 동작, 텍스트 표기 방식으로 검증해야 합니다.