 AIREITER
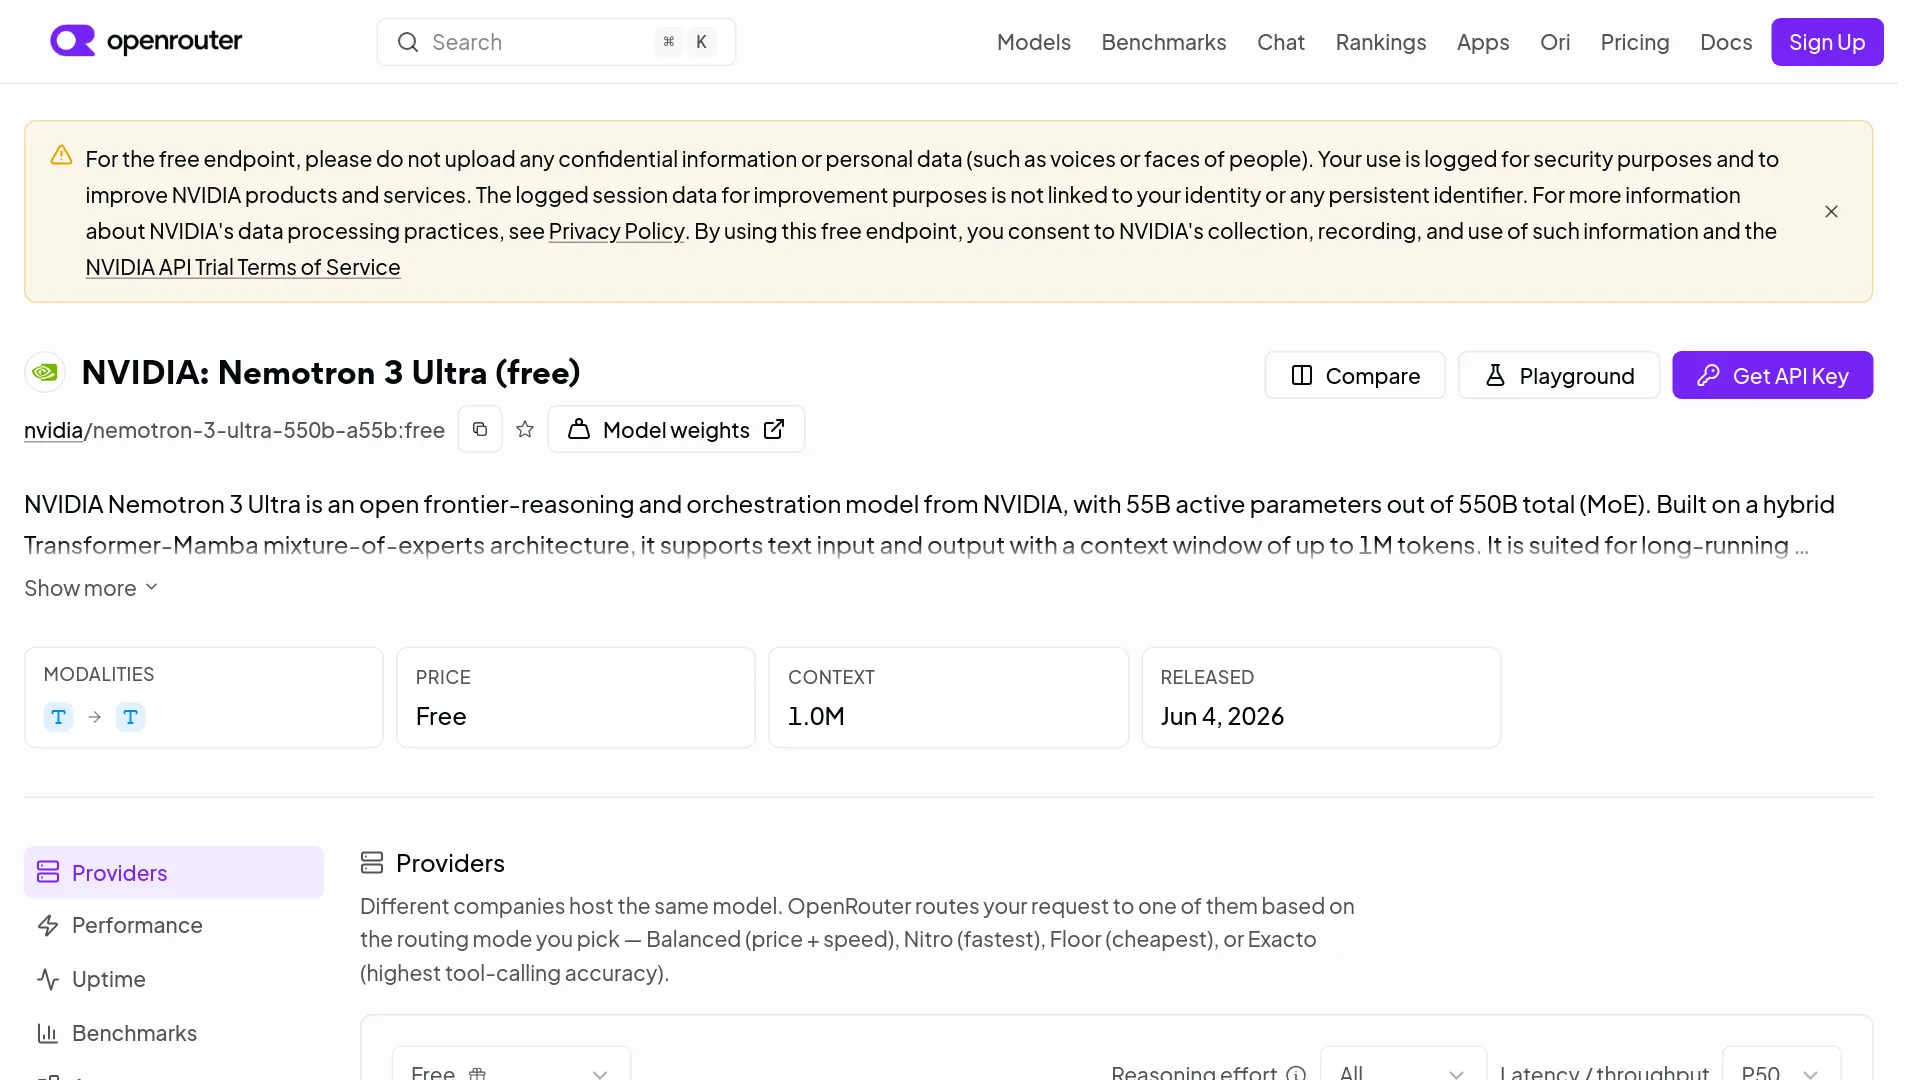
100만 토큰 컨텍스트와 $0 엔드포인트만 보면 Nemotron 3 Ultra API를 기본 선택으로 쓰고 싶어집니다. 하지만 무료 경로는 평가용으로 보는 편이 맞습니다. 실제 운영에서는 프로바이더의 안정성, 데이터 처리 방식, 유료 대체 경로까지 함께 고려해야 합니다.
Nemotron 3 Ultra API, 써볼 만할까?
장시간 실행되는 텍스트 에이전트, 대규모 문서 분석, 매우 긴 컨텍스트를 활용하는 코딩 워크플로라면 Nemotron 3 Ultra API를 테스트해볼 가치가 있습니다. 반대로 지연 시간이 짧아야 하는 일반적인 채팅, 로그인이 필요한 무료 엔드포인트에 기밀 프롬프트를 보내는 작업, 대체 경로 없이 운영하는 프로덕션 서비스에는 적합하지 않습니다.
NVIDIA는 2026년 6월 4일 Nemotron 3 Ultra를 공개했습니다. 공식 모델 카드에 따르면 NVFP4 체크포인트는 버전 1.0 GA이며, OpenMDW 1.1에 따라 상업적·비상업적 사용이 허용됩니다.
| 판단에 필요한 사실 | 확인된 값 | 중요한 이유 |
|---|---|---|
| 모델 규모 | 전체 550B, 활성 55B | 희소 연산을 사용해도 전체 가중치가 작아지는 것은 아님 |
| 최대 컨텍스트 | 최대 1M 토큰 | 경로에 따라 프로바이더 제한이 더 낮을 수 있음 |
| 모달리티 | 텍스트 입력 및 출력 | 이미지나 동영상 이해는 지원하지 않음 |
| 공식 NVFP4 SWE-Bench Verified | 69.7 | 코딩 에이전트 평가에 참고할 만한 지표 |
| 공식 NVFP4 RULER 1M | 94.0 | 긴 컨텍스트 활용 사례를 뒷받침함 |
| OpenRouter 무료 요금 | 입력 $0, 출력 $0 | 시험용으로 적합하지만 SLA는 아님 |
| OpenRouter 무료 가용성 스냅샷 | 3일 동안 84.07% 성공 | 접속 가능하다고 항상 정상 사용 가능한 것은 아님 |
| 공식 셀프 호스팅 최소 구성 | B200급 4개 또는 H100 8개 | 일반 워크스테이션 배포 방식이 아님 |
위 벤치마크 수치는 NVIDIA 모델 카드에서 가져온 것으로, 퍼스트파티 결과로 봐야 합니다. OpenRouter의 가용성은 프로바이더의 동적 측정값이며 영구적인 보장이 아닙니다.
5분 만에 무료 Nemotron 3 Ultra API 호출하기
가장 빠른 무료 경로는 OpenAI 호환 chat-completions 엔드포인트와 정확한 모델 ID nvidia/nemotron-3-ultra-550b-a55b:free를 사용하는 방법입니다. OpenRouter 키를 만든 뒤 환경 변수에 보관하고, 긴 컨텍스트 작업을 시작하기 전에 작은 테스트 요청부터 보내세요.
- OpenRouter에서 API 키를 만듭니다.
- 키를
OPENROUTER_API_KEY로 내보냅니다. - 무료 모델 ID를 사용해
/api/v1/chat/completions를 호출합니다. - 평가 중 HTTP 상태 코드, 지연 시간, 빈 응답을 기록합니다.
- 프로덕션에서 워크플로를 사용하기 전에 유료 경로나 다른 모델을 추가합니다.
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nvidia/nemotron-3-ultra-550b-a55b:free",
    "messages": [
      {
        "role": "user",
        "content": "Return three risks in this migration plan as a numbered list."
      }
    ],
    "max_tokens": 500
  }'
OpenAI Python 클라이언트에서도 base_url과 model만 바꾸면 같은 경로를 사용할 수 있습니다.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENROUTER_API_KEY"],
    base_url="https://openrouter.ai/api/v1",
)

response = client.chat.completions.create(
    model="nvidia/nemotron-3-ultra-550b-a55b:free",
    messages=[
        {
            "role": "user",
            "content": "Inspect this plan and list the three highest-impact risks.",
        }
    ],
    max_tokens=500,
)

print(response.choices[0].message.content)
무료 경로가 실제로 보장하는 것
무료 Nemotron 3 Ultra 경로는 무제한 처리량이나 프로덕션 수준의 가용성을 보장하지 않습니다. OpenRouter 등록 페이지는 무료 엔드포인트에 속도 제한이 있다고 표시하지만, 모델 페이지에 정확한 할당량을 공개하지는 않습니다. 9월 19일 스냅샷에서는 3일 동안 접속 가능성이 100%였지만 성공 가용성은 84.07%에 그쳤습니다. 오류와 빈 응답은 실패로 집계됐습니다.
해당 스냅샷에서 OpenRouter는 1M 토큰 컨텍스트, 최대 65,536 토큰 완성 길이, 툴 호출, 2.28초의 중앙값 지연 시간, 초당 29토큰의 중앙값 처리량을 표시했습니다.
프로바이더에 따라 지원 기능의 경계도 달라집니다. OpenRouter 무료 목록은 tools와 tool_choice를 지원했지만 response_format을 강제하지는 않았습니다. Segmind의 유료 경로는 입력 100만 토큰당 $0.625, 출력 100만 토큰당 $2.75에 JSON Schema 출력을 제공한다고 안내합니다. 엄격한 JSON 형식에 의존하는 코드는 기본 모델만 보고 지원 여부를 추정하지 말고, 실제로 선택한 프로바이더에서 테스트해야 합니다.
기밀 정보나 개인정보를 OpenRouter 무료 경로로 보내지 마세요. 해당 목록에는 보안을 위해 사용량이 기록되며 NVIDIA 제품과 서비스 개선에 활용될 수 있다고 적혀 있습니다. 429, 타임아웃 또는 빈 응답이 발생하면 제한된 지수 백오프를 적용한 뒤 유료 경로로 전환하세요. 에이전트 작업을 무기한 재시도해서는 안 됩니다.
550B A55B가 실제 사용에서 바꾸는 것
Nemotron 3 Ultra의 550B-A55B 표기는 전체 파라미터가 5500억 개이고 토큰마다 약 550억 개가 활성화된다는 뜻입니다. NVIDIA는 LatentMoE 라우팅, Mamba-2, 일부 어텐션 레이어, Multi-Token Prediction을 결합했습니다. 희소 활성화 덕분에 토큰당 연산량은 줄지만, 전체 가중치는 여전히 저장·분산하거나 오프로딩해야 합니다. A55B가 55B 규모의 배포 모델이라는 의미는 아닙니다.
NVIDIA의 연구 공개 자료는 최대 1M 토큰 컨텍스트를 제시하며, 입력 8,000토큰과 출력 64,000토큰을 사용하는 특수한 작업에서 처리량을 비교합니다. NVIDIA는 GLM-5.1-754B-A40B보다 5.9배, Kimi-K2.6-1T-A32B보다 4.8배, Qwen-3.5-397B-17B보다 1.6배 높은 처리량을 주장합니다. 다만 절대 처리량과 하드웨어 세부 정보는 공개하지 않았으므로, 이 배수를 API 지연 시간으로 그대로 해석해서는 안 됩니다.
배포 선택에는 공식 BF16/NVFP4 표가 더 유용합니다.
| 벤치마크 | BF16 | NVFP4 | 실무적으로 읽는 법 |
|---|---|---|---|
| SWE-Bench Verified | 71.9 | 69.7 | 이 코딩 테스트에서 양자화로 2.2포인트 하락 |
| Terminal Bench 2.1 | 56.4 | 53.9 | 에이전트 기반 터미널 작업에서도 하락 |
| TauBench V3 평균 | 70.9 | 70.3 | 툴 사용 평균은 큰 차이 없이 유지 |
| GPQA, 툴 미사용 | 87.0 | 87.9 | NVFP4가 모든 항목에서 약한 것은 아님 |
| RULER 1M | 94.7 | 94.0 | 긴 컨텍스트 검색 성능은 비슷한 수준 |
| OmniScience 비환각성 | 78.7 | 75.5 | 사실성 검증은 여전히 중요 |
변화 폭은 작업에 따라 다릅니다. 비환각성에서는 NVFP4가 3.2포인트 하락했지만, GPQA에서는 0.9포인트 상승했습니다.
파라미터 수가 아니라 작업으로 선택하기
Nemotron 3 Ultra는 모델 크기가 아니라 실제 출시할 워크로드를 기준으로 DeepSeek V4, GLM 5.2, Qwen 3.8 Max와 비교해야 합니다. 이 가이드에서 동일한 하니스로 수집한 결과만으로는 모두에게 적용되는 승자를 정할 수 없습니다. 따라서 검증 가능한 경계를 포함한 테스트 계획을 세우는 것이 가장 타당합니다.
| 작업 | 우선 테스트할 모델 | 선택 전 확인할 근거와 테스트 |
|---|---|---|
| 100만 토큰 검색 또는 문서 종합 | Nemotron 3 Ultra | 공식 NVFP4 RULER 1M은 94.0입니다. 실제 프롬프트 길이에서 검색 정확도와 프리필 지연 시간을 테스트하세요. |
| 장시간 실행되는 코딩 에이전트 | Nemotron 3 Ultra 또는 DeepSeek V4 | Nemotron은 SWE-Bench Verified 69.7, Terminal Bench 2.1 53.9를 기록했습니다. 하나의 하니스에서 저장소 작업 성공률과 툴 호출 유효성을 비교하세요. |
| 구조화된 출력 자동화 | GLM 5.2, Qwen 3.8 Max 또는 스키마를 지원하는 Nemotron 프로바이더 | OpenRouter 무료 경로는 response_format을 강제하지 않습니다. 정확히 사용할 경로에서 스키마 준수율과 재시도 횟수를 측정하세요. |
| 대량의 짧은 요청 | DeepSeek V4, GLM 5.2 또는 Qwen 3.8 Max | 성공한 작업당 비용과 p95 지연 시간을 비교하세요. Ultra의 규모가 항상 도움이 되는 것은 아닙니다. |
| NVIDIA 하드웨어를 활용한 오픈 웨이트 배포 | Nemotron 3 Ultra | 대상 작업에서 BF16과 NVFP4를 비교한 뒤 지속 사용률을 계산하세요. |
DeepSeek V4와 GLM 5.2는 AIReiter에서 전용 API를 제공하며, Qwen 3.8 Max는 호스팅 채팅 모델로 이용할 수 있습니다. 자세한 내용은 DeepSeek V4 Pro API 가이드, GLM 5.2 API 리뷰, Qwen 3.8 Max API 요금을 참고하세요. 이는 평가를 위한 대안이지, 모든 작업에서 특정 모델이 이긴다는 뜻은 아닙니다.
Nemotron 3 Ultra를 로컬에서 실행할 수 있을까?
Nemotron 3 Ultra는 셀프 호스팅할 수 있지만, 여기서 말하는 ‘로컬’은 노트북이 아니라 데이터센터급 하드웨어나 DGX Station을 의미합니다. NVIDIA는 일반적인 배포 경로의 최소 구성으로 GB200 4개, B200 4개, GB300 4개, B300 4개 또는 H100 8개를 제시합니다.
NVIDIA 모델 카드의 공식 vLLM 예제는 4-way 텐서 및 전문가 병렬 처리, FP8 KV 캐시, 청크 프리필, MTP 추측 디코딩을 사용합니다. 표준 예제의 기본값은 262,144토큰입니다. 1,048,576토큰을 사용하려면 명시적으로 값을 덮어써야 하므로, 소개되는 최대 컨텍스트가 기본 서빙 설정인 것은 아닙니다.
NVIDIA는 별도로 단일 DGX Station 배포 방식도 안내합니다. 이 구성은 하나의 통합 GB300 GPU에서 NVFP4 체크포인트를 실행하며, 최대 150 GiB의 일관된 CPU 메모리를 사용할 수 있도록 하고 전문가 가중치를 오프로딩합니다. 이 방식에는 vLLM 0.22.0, Blackwell 전용 NVFP4 백엔드, DGX Station의 메모리 아키텍처가 필요합니다. 일반적인 단일 GPU PC에 그대로 적용할 수 있는 방법은 아닙니다.
| 배포 방식 | 선택할 상황 | 주요 제약 |
|---|---|---|
| OpenRouter 무료 API | 프롬프트와 툴 동작을 평가할 때 | 속도 제한, 로깅, 변동하는 가용성 |
| 호스팅 유료 API | 하드웨어를 구매할 만큼 사용량이 늘기 전에 출시할 때 | 프로바이더별 요금, 정밀도, 컨텍스트, 기능 차이 |
| B200급 4개 / H100 8개 셀프 호스팅 | 지속적인 처리량, 데이터 통제 또는 모델 커스터마이징이 중요할 때 | 자본 비용과 분산 추론 운영 |
| 오프로딩을 사용하는 단일 GB300 DGX Station | 정확히 해당하는 일관된 메모리 시스템을 보유했을 때 | 오프로딩 지연 시간과 하드웨어 종속성 |
Nemotron 3 Ultra API FAQ
Nemotron 3 Ultra API는 무료인가요?
네. OpenRouter는 nvidia/nemotron-3-ultra-550b-a55b:free를 입력 및 출력 토큰 모두 $0으로 표시합니다. 다만 엔드포인트에는 속도 제한이 있고 사용량이 기록됩니다.
Nemotron 3 Ultra가 정말 100만 토큰을 지원하나요?
NVIDIA가 명시한 최대치는 1M 토큰입니다. 하지만 프로바이더 경로에서는 기본값이 더 낮을 수 있습니다. NVIDIA의 vLLM 예제도 운영자가 1,048,576토큰을 활성화하지 않으면 기본값은 262,144토큰입니다.
API에서 툴과 구조화된 JSON을 지원하나요?
모델은 툴을 지원하지만 강제 방식은 프로바이더에 따라 다릅니다. OpenRouter 무료 경로는 response_format을 강제하지 않는 반면, Segmind는 엄격한 JSON Schema를 문서화하고 있습니다.
Nemotron 3 Ultra를 상업적으로 사용할 수 있나요?
NVIDIA는 OpenMDW 1.1 라이선스가 상업적·비상업적 사용을 허용한다고 밝히고 있습니다. 재배포와 배포 의무에 관한 내용은 공식 모델 카드에 연결된 라이선스 조건을 확인하세요.
추론 기능을 끌 수 있나요?
NVIDIA API 문서에는 enable_thinking=True/False가 노출되어 있습니다. 호스팅 프로바이더는 이 제어 항목을 다르게 매핑할 수 있으므로, 선택한 경로에서 허용되는 파라미터와 토큰 계산 방식을 확인해야 합니다.
550B A55B는 밀집형 55B 모델과 같은 의미인가요?
아닙니다. 토큰마다 약 55B 파라미터가 활성화되지만, 550B 전체 파라미터는 여전히 저장·분산하거나 오프로딩해야 합니다.
벤치마크 우승보다 중요한 배포 판단
가장 좋은 첫 단계는 민감하지 않은 프롬프트와 작은 평가 세트를 사용해 무료 Nemotron 3 Ultra API를 시험하는 것입니다. 오류, 스키마 강제, 예측 가능한 처리 용량이 중요해지면 유료 엔드포인트로 옮기세요. 셀프 호스팅은 측정된 사용률, 개인정보 보호 또는 커스터마이징이 현재 고메모리 GPU 최소 4개 이상이나 문서화된 DGX Station 경로를 정당화할 때만 고려하는 편이 좋습니다.
| 테스트 후 나온 결과 | 다음 단계 |
|---|---|
| 품질은 좋지만 무료 호출이 실패하거나 대기함 | 유료 Nemotron 경로와 재시도 정책을 추가 |
| 긴 컨텍스트 검색이 차별점임 | 실제 가장 큰 문서를 테스트하고 프리필 시간을 측정 |
| JSON 오류가 대부분을 차지함 | 스키마를 강제하는 프로바이더를 사용하거나 GLM/Qwen 경로를 비교 |
| 짧은 작업의 비용이나 지연 시간이 중요함 | 더 작은 모델을 우선 사용하고 Ultra는 상위 작업에만 활용 |
| 데이터가 네트워크 밖으로 나가면 안 됨 | 도입을 결정하기 전에 공식 멀티 GPU 배포 비용을 산정 |