 AIREITER
GLM-5.2는 어느 경로로 접속하든 OpenAI 스타일의 요청을 받는다. 하지만 그 뒤에서 같은 방식으로 움직이는 경로는 거의 없다. 6월 16일 출시 이후 GLM-5.2 API는 비용에 민감한 코딩과 에이전트 작업에 충분히 검토할 만한 선택지였다. 단, 툴 호출 의미론, 재시도 폭주, 캐시 과금이라는 세 가지 실패 지점은 직접 감싸야 한다. 입력/출력 100만 토큰당 $1.40/$4.40이라는 정가는 사실이지만, 작업 하나를 끝내는 데 실제로 드는 비용은 전혀 다른 숫자일 수 있다. 이 리뷰는 바로 그 차이를 짚는다.
OpenAI 호환은 어디까지인가
공식 GLM-5.2 문서는 OpenAI Python SDK 사용을 지원한다. base URL은 https://api.z.ai/api/paas/v4/, 모델 ID는 glm-5.2다. 기본 채팅 연동만 놓고 보면 실제로 세 줄 정도만 바꾸면 된다. 다만 호환되는 것은 요청 형식까지다. 응답의 의미론, OpenAI의 선택적 제어 필드, 최신 Responses API 영역까지 호환된다는 뜻은 아니다.
| 문서화된 사양 | 값 |
|---|---|
| 입출력 방식 | 텍스트 입력, 텍스트 출력(비전 미지원) |
| 컨텍스트 윈도우 | 100만 토큰 |
| 최대 출력 | 128K 토큰 |
| 문서화된 기능 | Thinking 모드, 스트리밍, 함수 호출, 컨텍스트 캐싱, 구조화된 출력, MCP |
| 종량제 엔드포인트 | https://api.z.ai/api/paas/v4/ |
| Coding Plan 엔드포인트 | https://api.z.ai/api/coding/paas/v4 |
| Anthropic 호환 엔드포인트 | https://api.z.ai/api/anthropic |
| 공식 SDK | zai-sdk (Python), Java, OpenAI SDK |
첫 번째 경계는 Responses API다. Z.ai에는 Responses API가 아예 없다. "Codex는 Responses API 형식만 지원하는데, Z.ai에서는 이 형식을 제공하지 않는다"고 u/quinncom은 설명했고, 일부 사용자는 ZenMux를 변환 레이어로 우회하고 있다. 두 번째는 Claude Code 경로다. Anthropic 호환 엔드포인트로 연결할 수는 있지만, @armor_rust의 설정 메모는 두 가지 함정을 지적한다. API_KEY가 아니라 AUTH_TOKEN을 써야 하며, 전자는 신뢰 확인을 유발해 한 번 거절하면 이후 영구적으로 거부될 수 있다. 또 구독형과 종량제의 base URL도 서로 다르다. 전체 설정 과정은 Claude Code 설정 가이드에서 확인할 수 있다.
한 개발자의 표현이 핵심을 잘 짚는다. "API 호환성은 요청 형식에서 끝난다. 툴 호출은 여전히 공급자별 평가가 필요하다." — @sebuzdugan
툴 호출: 짧은 테스트는 통과하지만 긴 루프에서는 꼬인다
짧고 통제된 툴 루프에서는 GLM-5.2 API가 문서대로 동작한다. 반면 장시간 실행되는 에이전트 루프에서는 호출 시퀀스가 손상되고, 자체 제한 장치가 멈출 때까지 반복된다는 보고가 있다. 둘 다 사실이며, 어떤 종류의 루프를 만드는지에 따라 리스크가 갈린다.
Z.ai 문서를 바탕으로 GLM52.ai의 27회 Docker 테스트가 검증한 계약은 이렇다. 함수 정의는 최대 128개, 함수명은 ^[a-zA-Z0-9_-]+$에 맞는 최대 64자, 파라미터는 JSON Schema를 사용한다. 인수는 애플리케이션이 검증해야 하는 JSON 문자열로 반환되며, 문서상 지원되는 tool_choice 값은 "auto"뿐이다. 이 테스트 스위트는 Coding Plan 경로에서 27/27 요청을 통과했다. 도구와 인수가 정확히 일치한 경우는 4/4, 도구를 쓰지 않은 올바른 거부는 3/3, 두 개 주문을 최상위 호출 두 번으로 처리한 경우는 4/4였고, 중앙값 지연 시간은 5.3초였다.
문제는 OpenAI 사용자가 당연히 있을 것이라 기대하는 제어 필드다. GLM52.ai가 상충하는 조건으로 테스트했을 때, 엔드포인트는 HTTP 200을 반환한 뒤 해당 지시를 무시했다.
| 전송한 OpenAI 스타일 제어값 | 관찰된 동작 |
|---|---|
tool_choice: "required" + "어떤 도구도 사용하지 말 것" | 도구 호출 없이 종료 |
| 강제 함수 객체 + "이 도구를 절대 사용하지 말 것" | 도구 호출 없이 종료 |
parallel_tool_calls: false + 두 개 주문 프롬프트 | 그래도 호출 두 개를 반환 |
strict: true | 한 번은 수용됐지만 스키마 강제의 근거는 없음 |
HTTP 요청을 받아들였다고 해서 동작 계약까지 보장되는 것은 아니다. 그리고 이 틈은 긴 루프에서 본격적으로 드러난다.
약 40억 토큰을 모델에 투입한 한 개발자는 이렇게 요약했다. "GLM 5.2를 40억 토큰쯤 쓰면서 가장 큰 문제는 비전 부재, 일부 툴 호출 혼선, 그리고 툴 호출 손상으로 인한 죽음이었다. 그냥 끝없이 꼬인다." — @RasputinKaiser. 또한 첫 번째 툴 호출의 인수 안에 두 번째 툴 호출을 인코딩했다는 보고도 하나 있다. 답변이 달리지 않은 단일 사례지만, 클라이언트 측 루프 방어가 겨냥해야 할 실패 유형과 정확히 일치한다.
실전에서 통하는 방어책은 오케스트레이션을 모델에 맡기지 않는 것이다. 한 개발자는 NVIDIA NIM을 사용하면서 tool_call: false로 두고, 전체 루프는 에이전트 프레임워크가 관리하도록 구성했다. 제한된 참조 루프는 모델 스텝을 4회로, 턴당 호출 수를 최대 4회로 제한하며 실행 전에 모든 인수 JSON을 검증한다.
스트리밍과 지연 시간: 홍보에서 빠지는 숫자
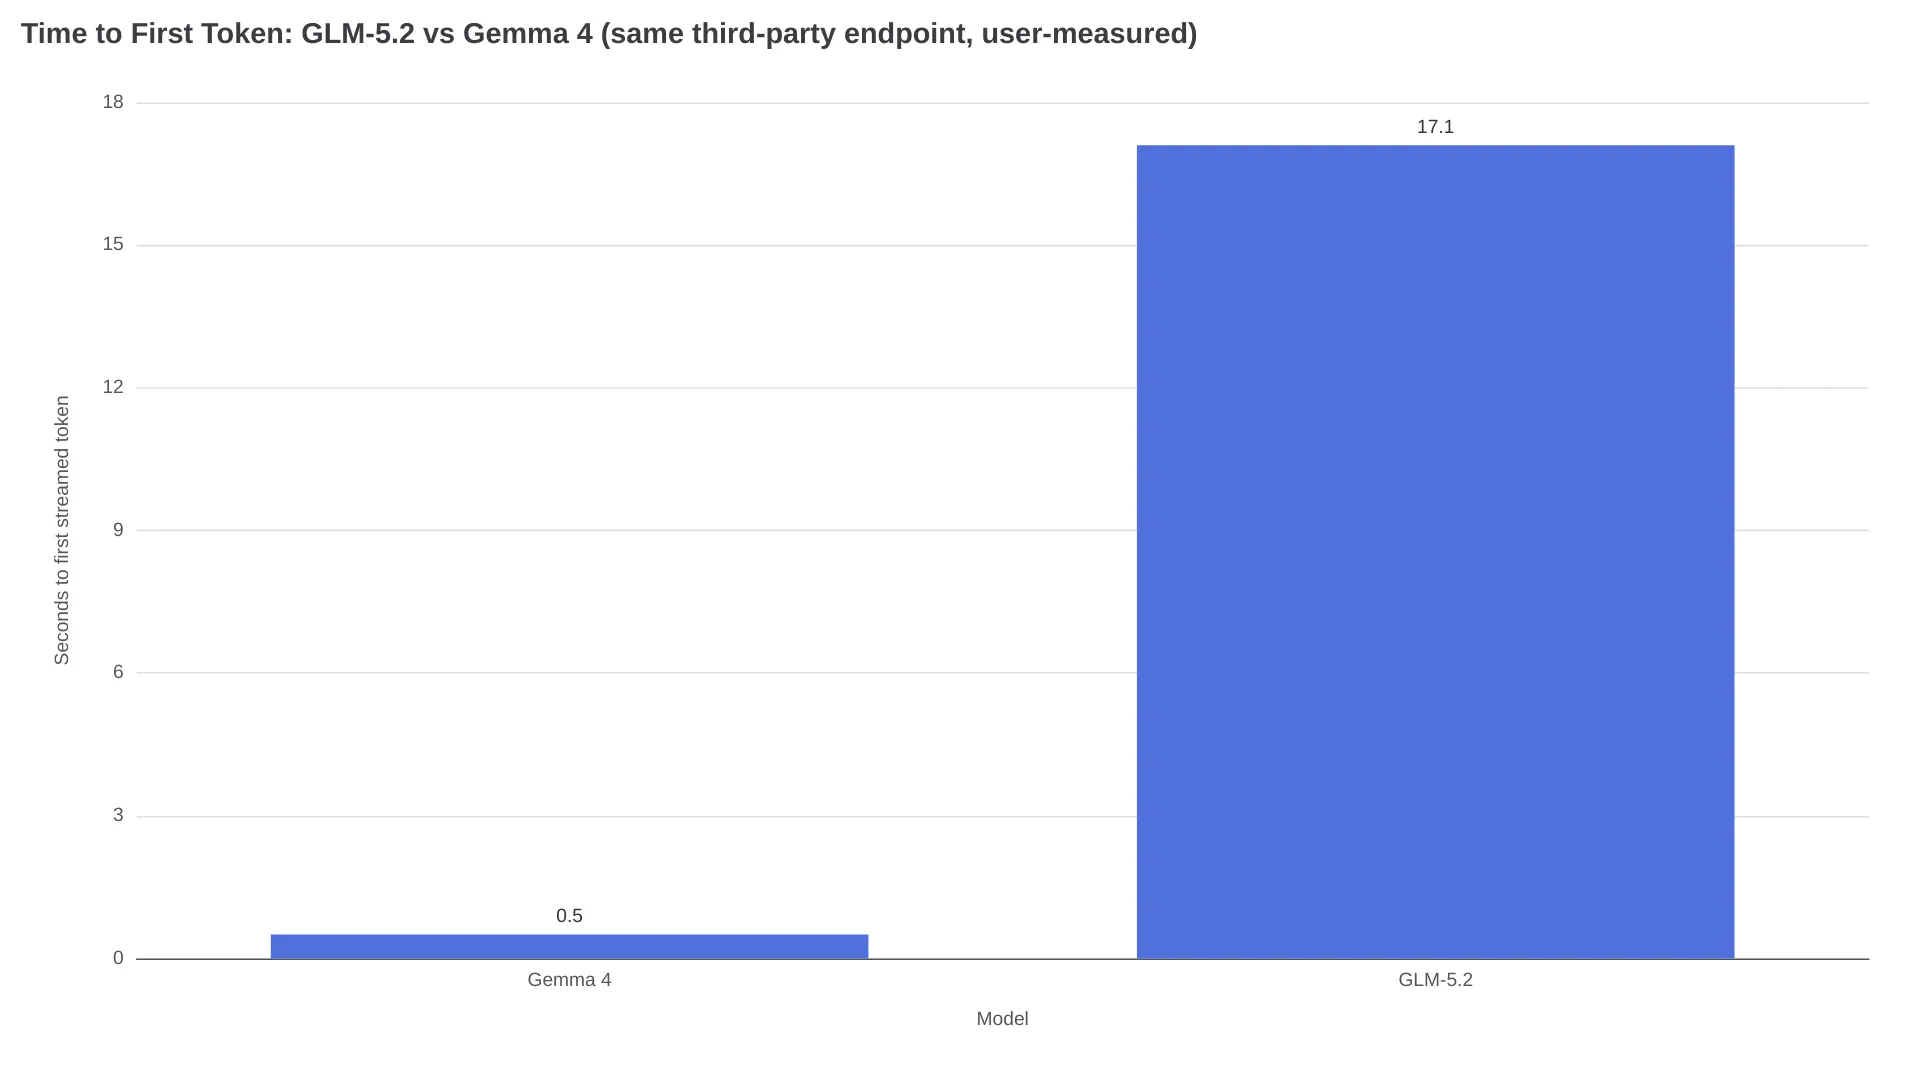
측정된 수치 중 API의 가장 약한 고리는 첫 토큰 지연 시간이다. Sarvam에서 같은 엔드포인트를 비교한 테스트에서는 GLM-5.2의 스트리밍 속도가 초당 148토큰, Gemma 4는 260토큰이었다. 첫 토큰까지 걸린 시간은 GLM-5.2가 17.1초, Gemma 4가 0.5초로 차이가 컸다. "생성을 33배 더 빨리 시작한다"는 표현이 나온 이유다. — @noctus91
광고되는 처리량도 비슷한 문제를 안고 있다.
"GLM 5.2 공급자들은 전부 200 tok/s 이상을 광고한다. 그런데 막상 써보면 50 tok/s가 나온다." — @tomgreenwald. 그는 이를 "공급자판 benchmaxxing"이라고 불렀다.
구독형 경로에서는 두 가지 실패 양상도 추가로 보고됐다. 스트리밍이 세션 도중 끊기는 경우다. "스트리밍이 그냥... 멈췄다"는 경험 뒤, 한 GLM Pro Coding Plan 사용자는 완전히 포기했다. 규모가 커질수록 성능이 떨어진다는 보고도 있다. "300k+ 컨텍스트에 도달하면 모델이 느려진다"는 것이다(@mosh_Ontong). 비교를 위해 보면, DataLLM Lab이 자체 게이트웨이에서 실행한 9개 작업 벤치마크는 완료 작업당 평균 12.3초였다. 지연 시간의 대부분은 모델보다 엔드포인트가 결정한다.
레이트 리밋과 429: 재시도가 기본 동작인 환경
Z.ai 모델 문서에는 레이트 리밋 표가 공개되어 있지 않다. 개발자는 429를 맞으며 한도를 경험적으로 파악하게 된다. Coding Plan 경로에서 커뮤니티가 공유하는 모습은 분명하다. 재시도는 예외 처리 경로가 아니라 정상 동작에 가깝다. 아래 사례들은 발생 비율이 아니라 실패 유형을 보여주지만, 반복적으로 같은 패턴이 나타난다.
r/ZaiGLM의 레이트 리밋 스레드에서는 다음과 같은 경험담이 나왔다.
- "현재 Coding Max Plan에서 거의 매 요청 두 번째마다 429/529가 뜬다. 동시성도 없는데..." — u/A-B-user
- "거의 모든 요청을 재시도하지만 결과는 아주 좋다." — u/hyeluoh
- "glm52를 동시성 1로 쓰면 잘 된다. 아주 느리지만 오류는 없다." — u/evia89
오류 양상은 클라이언트에 따라 달라진다. 같은 API 키가 ZCode에서는 작동하지만 OpenClaw에서는 429를 낼 수 있으며, 다른 사용자는 이를 "너무 바쁨" 메시지로 풀이했다. 구독 계층까지 겹치면 더 복잡해진다. 중국 사용자들은 Coding Plan이 5.2 워크로드를 자동으로 GLM-5.3으로 전환해 쿼터를 더 빨리 소모한다고 보고했고, 서드파티 Coding Plan 리셀러가 몇 차례 호출 뒤 레이트 리밋을 건다는 사례도 있다.
버틸 수 있는 엔지니어링 해법은 지수 백오프와 지터, 쓰기 작업에 대한 멱등성 키, 요청별이 아닌 작업별 재시도 예산, 그리고 자동으로 켤 수 있는 concurrency=1 저하 모드다. OpenRouter 429 해결 가이드의 재시도 패턴은 여기에도 그대로 적용된다.
Z.ai가 답하지 않은 캐시 과금 문제
컨텍스트 캐싱은 문서화된 기능이다. 7월 13일 공급자 페이지를 확인했을 때, 캐시된 입력은 100만 토큰당 약 $0.26으로 표시됐고 신규 입력은 $1.40이었다. 하지만 검토한 커뮤니티 스레드에서 API 관련 불만 중 가장 높은 반응을 얻은 쟁점은 해결되지 않았다. 일부 경로에서는 반복 컨텍스트가 캐시 입력이 아니라 신규 입력으로 과금되는 것으로 보이며, 긴 시스템 프롬프트를 매번 다시 보내는 에이전트 루프의 비용을 크게 늘릴 수 있다.
"GLM 5.2에서 캐시 토큰이 제대로 작동하지 않는다. 반복 컨텍스트가 캐시 토큰이 아니라 일반 입력으로 계산된다." — @Da7_Tech. 그는 이를 "심각한 과금/캐시 정산 문제"라고 불렀다.
해당 스레드에 따르면 Claude Opus 4.8은 같은 작업을 150만 토큰 미만으로 완료했지만, GLM-5.2는 5시간 쿼터를 100% 소진하고도 5,300만 토큰 뒤에 작업을 완료하지 못했다. 앱 자체 카운터에는 약 167만 토큰으로 표시됐다.
두 달 뒤에도 같은 개발자는 이렇게 정리했다. "캐시 히트가 사용량으로 계산되는 것 같다는 불만이 많다. 이 문제가 발생하면 플랜의 가치는 무너진다." 8월 말까지 해당 스레드에는 공식 답변이 나타나지 않았다.
수정이 확인되기 전까지는 캐시 입력 가격을 최선의 경우로만 봐야 한다. 매 응답의 usage 객체에서 cached_tokens를 기록하고, 매주 청구서와 대조하자.
Reasoning effort: 하나의 설정, 세 가지 이름
공식 API 표면에서는 thinking.type으로 활성화/비활성화를 설정하고, reasoning_effort에는 high와 max 값을 쓴다. 문서의 예시도 reasoning_effort: "max"를 사용한다. Z.ai의 출시 안내는 max가 성능을 최대한 끌어올리고 high는 성능과 토큰 효율의 균형을 맞춘다고 설명했으며, 코드 작업에는 max를 권장했다.
통합할 때는 두 가지를 알아야 한다. 첫째, 코딩 경로의 기본값은 max다. "기본값이 max라서 낮추고 싶지 않다면 따로 지정할 필요가 없다"(r/ZaiGLM)는 설명이 있다. 추론 토큰은 출력 요금으로 과금되므로, 이 기본값은 비용을 조용히 키운다. Coding Plan에서는 플랜 과금을 정리한 사용자들의 보고에 따르면 max-effort 호출이 베이징 시간 평일 14:00–18:00 구간에 3배 쿼터를 소모하며, 이는 5시간 윈도우와 주간 크레딧에 중첩된다.
둘째, 이 설정이 백엔드까지 전달되지 않는 경우가 많다. OpenCode 사용자는 커스텀 공급자에서 "현재 reasoning effort를 조정할 수 없다"고 보고했다. 일부 클라이언트는 같은 설정을 xhigh라는 세 번째 이름으로 노출하지만, 아예 전달하지 않을 수도 있다(r/opencodeCLI). 장황함도 같은 설정의 영향을 받는다. 매일 모델을 비교하는 한 개발자는 경쟁 모델이 "Opus-4.8이나 GLM-5.2만큼 장황하지는 않다"고 평가했다.
같은 모델명, 다른 배포 환경: 엔드포인트 드리프트
glm-5.2라는 하나의 모델 문자열은 실질적으로 서로 다른 배포 환경을 가리킨다. 8월 초 엔드포인트 정확도 결과가 돌았을 때, Z.ai 측 리드는 커뮤니티에 "추가 기준점으로 공식 GLM-5.2 API도 테스트해 달라. 100%를 넘는 점수가 나올 수도 있다"고 요청했다. — @ZixuanLi_. 그가 말한 기준점은 보고서가 측정한 서드파티 엔드포인트가 아니라 공식 API였다.
실전에서 드리프트는 이렇게 나타난다. 출력 토큰 상한이 너무 낮아 스트리밍 도중 추론이 잘리거나, 출시 초반의 처리량이 시간이 지나며 사라지는 현상, 즉 앞서 말한 "benchmaxxing" 패턴이 나타날 수 있다. 호스트마다 컨텍스트 한도도 다르다. Together AI는 GLM-5.2를 256K로 제공하지만, 공식 API는 문서상 100만 토큰이며 7월 비교에서 살펴본 애그리게이터도 전체 윈도우를 제공한다.
가격 차이는 동작 차이보다 더 크다. Z.ai 정가가 $1.40/$4.40인 데 비해, 7월 공급자 비교에서 OpenRouter는 $0.42/$1.32로 표시됐다. 캐시 입력 가격도 Fireworks의 $0.14부터 $0.26까지 분포했다. 워크로드에 맞춰 엔드포인트를 고른 뒤, 반드시 그 정확한 엔드포인트에서 다시 테스트해야 한다. 한 경로에서의 동작 통과가 다른 경로로 이전되지는 않는다.
배포 전 30분 사전 점검 체크리스트
위의 실패 유형은 모두 프로덕션 워크로드를 맡기기 전 30분 안에 확인할 수 있다. 실제로 배포할 엔드포인트, 모델 문자열, SDK 조합을 대상으로 다음 테스트를 실행하자.
- 상충 조건으로 툴 계약을 검증한다.
tool_choice: "required"와 도구를 쓰지 말라는 지시를 함께 보내고,parallel_tool_calls: false와 두 개 주문 프롬프트도 함께 보낸다. 둘 다 무시될 것으로 예상해야 한다. 오케스트레이션이 둘 중 하나에 의존한다면 여기서 멈춰야 한다. - 재시도 내구성을 확인한다. 목표 동시성으로 요청 50개를 보내고 429/529 비율과 재시도 성공 비율을 기록한다. 재시도가 전체 요청의 약 3분의 1을 넘는다면, 보수적인 운영 기준으로 동시성을 1로 낮추고 다시 측정한다.
- 캐시 과금을 확인한다. 동일한 10K 토큰 접두사를 다섯 번 재전송한다. usage 응답의
cached_tokens를 합산하고 대시보드에서 입력으로 청구된 수치와 대조한다. 여기서 불일치가 나면 비용 모델은 성립하지 않는다. - 실제 컨텍스트 크기로 지연 시간을 측정한다. 1K 토큰 스모크 테스트가 아니라 대표적인 컨텍스트 크기에서 첫 토큰 시간과 스트림 중간 정지를 측정한다. 그렇지 않으면 300K 초과 구간의 느려짐은 보이지 않는다.
- 경로를 결정한다. Coding Plan은 대화형 코딩 도구를 위한 플랜이다. 플랜 과금 정리 글에 따르면 웹사이트, 봇, SaaS 트래픽 제공 용도로는 라이선스가 허용되지 않는다. 제품 백엔드에는 종량제 API를 써야 한다.
결국 해소되지 않는 트레이드오프가 있다. GLM-5.2는 시장에서 가장 저렴한 축에 드는 유능한 코딩 토큰을 제공한다. 대신 프런티어 API가 토큰 단가에 녹여 둔 래퍼 엔지니어링 비용을 직접 부담해야 한다.
GLM-5.2 API 리뷰 FAQ
GLM-5.2에서 OpenAI SDK를 쓸 수 있나?
가능하다. 채팅 완료 API에서는 base_url을 https://api.z.ai/api/paas/v4/로 지정하고 모델에 glm-5.2를 사용하면 된다. 다만 Responses API는 없으므로 OpenAI의 최신 API 표면과 Codex에는 변환 레이어가 필요하다.
GLM-5.2 API는 스트리밍, 함수 호출, 구조화된 출력을 지원하나?
세 기능 모두 컨텍스트 캐싱 및 MCP와 함께 문서화되어 있다. 주의할 부분은 실제 동작이다. 스트리밍 안정성은 엔드포인트마다 다르며, auto 외의 tool_choice, parallel_tool_calls, strict 같은 OpenAI 툴 제어 필드는 지켜지지 않는다.
어떤 모델 문자열과 base URL을 사용해야 하나?
공식 종량제 경로는 https://api.z.ai/api/paas/v4/의 glm-5.2다. Coding Plan은 다른 base URL을 사용하며, OpenRouter에서는 모델이 z-ai/glm-5.2로 등록되어 있다.
GLM-5.2가 느리거나 유난히 장황한 이유는?
코딩 경로는 출력 토큰으로 과금되는 max reasoning effort를 기본값으로 사용한다. 커뮤니티 보고에서는 지속 처리량이 광고된 200+ tok/s보다 50 tok/s에 가깝다. 지연 시간과 장황함은 대체로 모델 자체의 한계보다 설정과 엔드포인트의 영향이 먼저다.
GLM Coding Plan으로 애플리케이션 API를 운영할 수 있나?
안 된다. 플랜 과금 정리 글에 따르면 이 구독은 대화형 코딩 도구용이며, 웹사이트·봇·SaaS 제품 제공은 제외된다. 베이징 피크 시간의 쿼터 배수도 안정적인 트래픽에는 맞지 않는다.
모든 공급자에서 100만 토큰 컨텍스트 윈도우를 쓸 수 있나?
아니다. 공식 API와 대부분의 애그리게이터는 100만 토큰을 제공하지만, Together AI의 GLM-5.2 상한은 256K다. 리포지터리 규모 워크플로의 아키텍처가 달라질 만큼 큰 차이다.
함께 읽기
- GLM-5.2 Review: Two Months After the Hype — 모델 품질, 벤치마크, 그리고 적합한 사용자
- GLM 5.2 API: Cheapest Access, Pricing & Free Keys — 전체 공급자 가격 매트릭스
- GLM-5.2 vs GLM-5.3 — 8월 후속 모델이 판단을 바꾸는지 살펴보기