 AIREITER
NVIDIA의 자체 벤치마크만 놓고 보면 Nemotron 3.5 Lightning은 Qwen 3.6 35B-A3B에 12개 테스트 중 11개에서 뒤처진다. 그럼에도 최대 4배 빠른 토큰 생성 속도를 내세운다. 이것이 이 모델의 설계 의도다. 토큰당 활성화되는 파라미터는 3B뿐인 30B mixture-of-experts 모델로, 최고 수준의 추론력보다 속도와 비용이 중요한 에이전트 파이프라인의 반복 실행 단계를 겨냥했다. 단, 전체 정밀도 BF16 가중치를 쓰려면 80 GB GPU가 필요하며, NVIDIA는 프로덕션 환경에는 NVFP4 체크포인트를 권장한다.
일반적인 30B 모델과 다른 Lightning의 설계
Nemotron 3.5 Lightning은 Mamba-2 상태 공간 레이어와 MoE 라우팅, 선택적 attention 레이어를 교차 배치한 하이브리드 아키텍처를 사용한다. NVIDIA는 이 조합에 nemotron_h라는 태그를 붙였다. Mamba-2 레이어는 긴 컨텍스트에서 attention이 요구하는 메모리와 연산 오버헤드를 낮춘다. 덕분에 순수 attention 모델이 감당해야 하는 제곱 비용 없이 1M-token context window를 지원한다. 다만 model card 기준 단일 H100 80GB 환경에서는 실질적으로 256K로 제한된다.
| 사양 | 값 |
|---|---|
| 전체 파라미터 | 30B |
| 토큰당 활성 파라미터 | 3B |
| 아키텍처 | Mamba-2 + MoE + Attention 하이브리드 |
| 컨텍스트 길이 | 최대 1M 토큰(단일 H100에서는 256K) |
| 정밀도 옵션 | BF16, NVFP4 |
| 라이선스 | OpenMDW v1.1(상업적 사용 가능) |
| 지원 언어 | 영어, 스페인어, 프랑스어, 독일어, 이탈리아어, 일본어 + 코딩 |
| 사전 학습 코퍼스 | 20T+ 토큰 |
| 추론 모드 | 채팅 템플릿의 enable_thinking으로 전환 가능 |
| 권장 샘플링 | Temperature 1.0, top-p 0.95 |
NVIDIA는 Lightning을 Nemotron 3 제품군 중 가장 작은 모델로 소개하며, 에이전트 하니스 동작에 맞춰 별도로 학습했다고 설명한다. 도구 호출, 출력 검증, 결과 포맷팅, 하위 에이전트 위임이 대표적인 대상이다. Nemotron 3 Ultra 같은 프런티어 추론 모델이 복잡한 계획을 맡고, Lightning은 고가 모델의 토큰 예산을 소모할 필요가 없는 일상적 실행 단계를 처리하는 구도다.
벤치마크 성적표: 강점과 한계가 뚜렷하다
HuggingFace model card에는 Lightning과 Qwen 3.6 35B-A3B, Gemma 4 26B-A4B, Nemotron 3 Nano/Super, GPT-OSS 20B를 비교한 벤치마크 14개 항목이 공개돼 있다. 이 가운데 모델 선택에 특히 중요한 10개 항목을 아래에 정리했다.
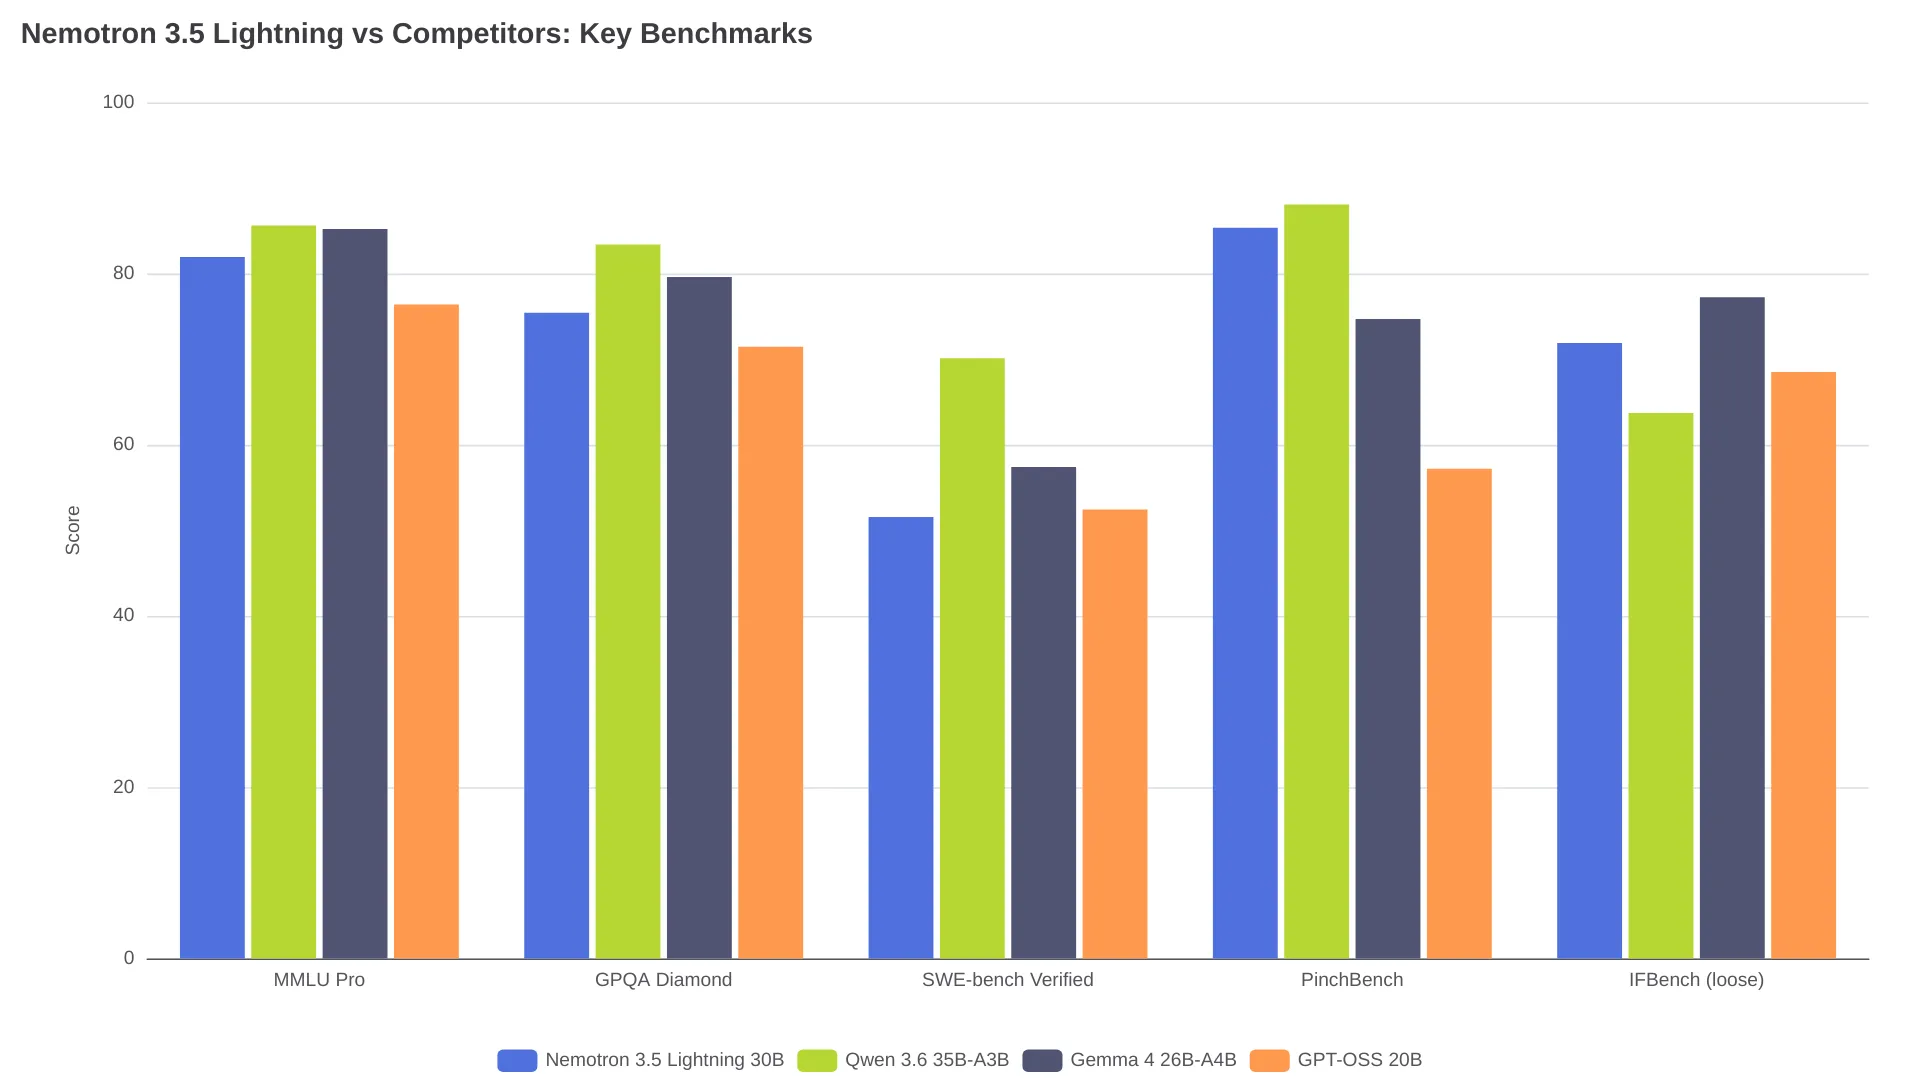
| 벤치마크 | Nemotron 3.5 Lightning | Qwen 3.6 35B-A3B | Gemma 4 26B-A4B | GPT-OSS 20B |
|---|---|---|---|---|
| MMLU Pro | 81.94 | 85.63 | 85.20 | 76.40 |
| GPQA Diamond (도구 미사용) | 75.44 | 83.40 | 79.61 | 71.46 |
| SWE-bench Verified | 51.56 | 70.12 | 57.40 | 52.44 |
| SWE-bench Multilingual | 39.33 | 63.40 | 43.40 | 41.93 |
| Terminal-Bench 2.1 | 24.58 | 44.38 | 37.22 | 15.17 |
| PinchBench | 85.37 | 88.07 | 74.70 | 57.20 |
| BrowseComp | 36.97 | 48.74 | 26.30 | - |
| IFBench (loose) | 71.88 | 63.71 | 77.25 | 68.50 |
| AA-LCR | 52.00 | 61.06 | 57.56 | 32.88 |
| SciCode | 32.60 | 35.33 | 40.28 | 38.63 |
비교 가능한 12개 항목 가운데 Lightning이 Qwen 3.6 35B-A3B를 앞선 것은 11개가 아니라 단 하나다. 바로 IFBench(느슨한 모드의 지시 이행)로, Lightning은 71.88점, Qwen은 63.71점으로 8점 차이가 난다. 도구 호출 형식과 출력 검증을 다루는 상황에서는 순수 추론력보다 지시를 정확히 따르는 능력이 중요하다는, 이 모델의 에이전트 실행 지향성과 맞아떨어지는 결과다.
Lightning의 차별점은 속도에 있다. NVIDIA의 PinchBench 평가에서는 10,000개 에이전트 작업을 H100 GPU 시간으로 측정했다. Lightning은 정확도 86%에서 약 16.5 GPU-hours로 작업을 마쳤다. 반면 Qwen 3.6 35B는 정확도 87%에서 23.5~24 GPU-hours, Gemma 4 26B는 정확도 73%에서 25~26 GPU-hours가 걸렸다.
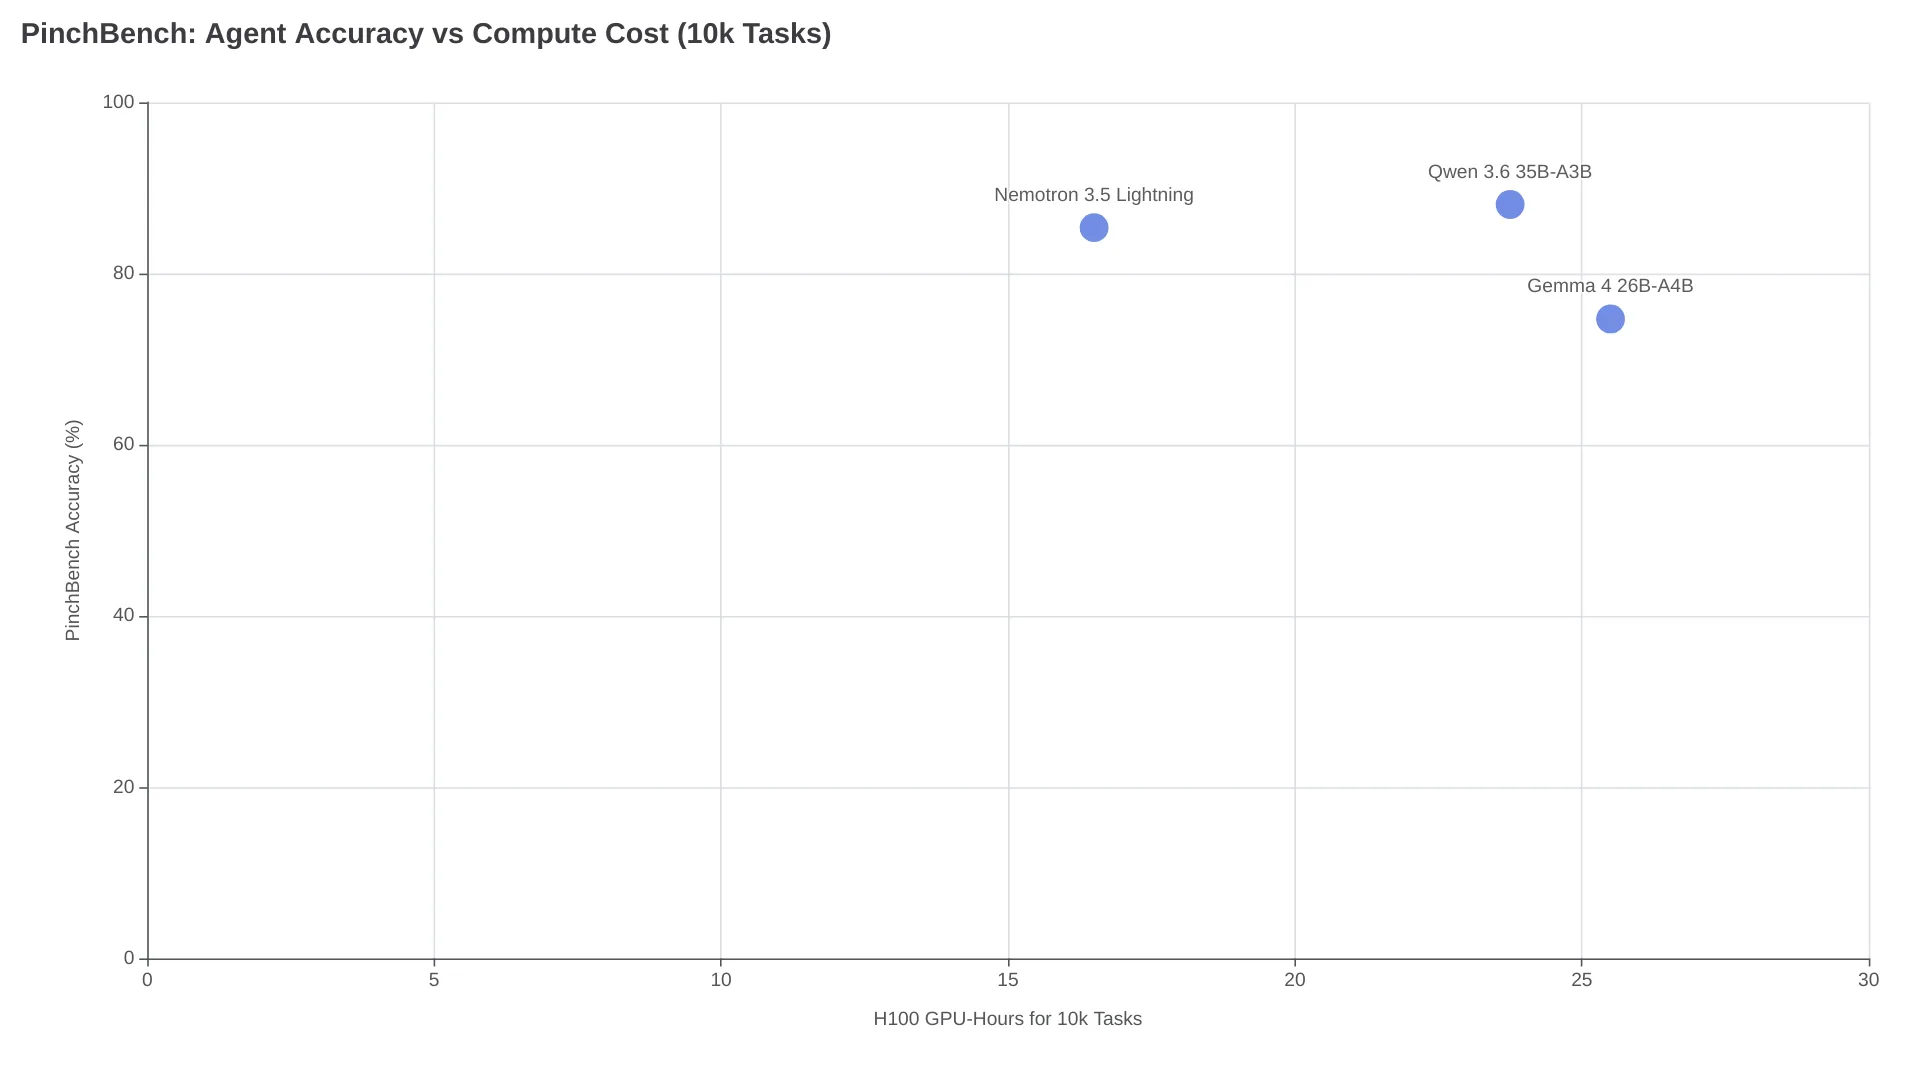
정확도가 거의 같은데도 연산량은 약 30% 적다. GPU 시간 단위로 비용을 내며 10,000개 에이전트 단계를 실행한다면 무시하기 어려운 차이다. NVIDIA는 또 Artificial Analysis leaderboard에서 Lightning이 약 670 output tokens/second와 약 23~24 Intelligence Index 포인트를 기록했다고 밝혔다. 전체 파라미터 40B 미만의 오픈 웨이트 모델 중 파레토 프런티어에 위치한다는 평가다.
r/LocalLLaMA 커뮤니티 테스트에서도 비슷한 속도 결과가 나왔다. DGX Spark 사용자는 NVFP4 체크포인트에서 타깃 전용으로 78.5 tokens/second, speculative decoding 적용 시 90.7 tokens/second를 보고했다. 메인 토론 스레드의 다른 사용자는 Lightning의 품질을 "Gemma 4 26B와 31B 사이이며, 26B에 훨씬 가깝다"고 평가했다. Gemma 31B보다 약 2배 빠르지만 thinking token을 많이 생성해 실제 체감에서는 속도 이점이 상쇄될 수 있다는 의견도 덧붙였다. 초기 GGUF Q4 변환본은 파일 크기가 25 GB였고 unused-tensor 경고가 보고됐다. 하이브리드 Mamba-2 아키텍처를 아직 모든 GGUF 기반 도구가 완전히 지원하지 못할 가능성을 시사한다.
필요한 하드웨어와 로컬 배포 선택지
전체 정밀도 기준 가중치인 BF16 체크포인트는 단일 GPU 배포에 1x H100 80GB 또는 1x A100 80GB가 필요하다. 분할된 safetensors 파일 크기는 65.8 GB다. NVIDIA는 추론 프로덕션 환경에는 별도 배포된 NVFP4 릴리스를 명시적으로 권장한다.
| 체크포인트 | 파일 크기(약) | 최소 GPU | 적합한 용도 |
|---|---|---|---|
| BF16 | 65.8 GB | 1x H100/A100 80GB | 파인튜닝, 연구, 양자화 변형 제작 |
| NVFP4 | ~16 GB | RTX 5090, DGX Spark, Jetson (Blackwell/Hopper/Ampere) | 프로덕션 추론, 에이전트 배포 |
| GGUF Q4 | ~25 GB | 16 GB+ VRAM (커뮤니티 제작) | llama.cpp, Ollama, LM Studio |
NVIDIA는 Day-0 지원을 위해 4개 로컬 서빙 프로젝트와 협력했다. 대상은 vLLM, SGLang, Ollama, llama.cpp이며, LM Studio와 Unsloth도 함께 언급됐다. 모델은 speculative decoding 전략 3가지를 지원한다.
- DSpark - DGX Spark 및 낮은 동시성의 데이터센터 추론에 권장
- DFlash - 워크로드에 따라 선택할 수 있는 대체 draft 모델
- MTP (Multi-Token Prediction) - 모델에 내장돼 있으며 중간~높은 동시성에 적합
로컬 하드웨어 없이 호스팅 방식으로 쓰려면 build.nvidia.com에서 NIM 마이크로서비스로, 또는 OpenRouter에서 Lightning을 이용할 수 있다. NVFP4 체크포인트는 GeForce RTX 5090, DGX Spark, OEM GB10 시스템, NVIDIA Jetson에서 실행된다.
Lightning이 빛나는 에이전트 라우팅 구조
NVIDIA의 오픈소스 라우팅 라이브러리 NeMo Switchyard는 정확도, 속도, 비용을 기준으로 에이전트 워크플로의 각 단계를 가장 적합한 모델로 보낸다. 계획 수립은 프런티어 추론 모델로 올리고, 실행은 Lightning으로 내리는 방식이다. NVIDIA의 내부 벤치마크에 따르면 Switchyard는 "프런티어 수준"의 작업 완료 성능을 유지하면서 비용을 Opus 4.8만 단독으로 쓸 때의 약 3분의 1까지 낮췄다. Lightning에 배정되는 실행 작업에는 git pull, 도구 출력 검증, 결과 포맷팅, 일상적인 API 호출 등이 포함된다.
실제 활용 사례도 있다. CodeRabbit은 Reddit의 실제 사례를 통해, 타깃 SFT와 RLVR(검증 가능한 보상을 활용한 강화학습)로 Nemotron 3.5 Lightning을 코드 리뷰 라우팅에 맞게 후학습했다고 공개했다. 그 결과 $100 미만의 학습 비용으로 고정된 1,000개 작업 평가에서 기존 베이스라인을 앞섰다. NVIDIA는 NeMo Automodel과 NeMo Megatron Bridge(LoRA/SFT), NeMo RL과 NeMo Gym(강화학습), 그리고 Nemotron-RL Agentic Terminal Pivot이라는 오픈 데이터셋으로 이 워크플로를 지원한다.
에이전트 파이프라인을 만드는 팀이 던져야 할 실질적인 질문은 이것이다. 전체 에이전트 단계 대부분을 활성 파라미터 3B 비용으로 처리하도록 Lightning을 파인튜닝하고, 정말 필요한 일부 단계에만 프런티어 모델을 투입할 수 있는가?
Nemotron 3.5 Lightning, 어떤 경우에 선택할까
| 사용 사례 | 권장 모델 | 이유 |
|---|---|---|
| 대량 에이전트 라우팅(도구 호출, 검증, 포맷팅) | Lightning NVFP4 | 활성 파라미터 3B, 4배 토큰 속도, 유사한 정확도에서 약 30% 적은 연산 |
| 일반 코딩 지원 | Qwen 3.6 35B-A3B | SWE-bench Verified에서 70.12 대 51.56, 19점 차이 |
| 복잡한 추론 / 계획 수립 | Nemotron 3 Ultra 또는 프런티어 모델 | Lightning은 명시적으로 계획 수립용 모델이 아니다 |
| 소비자 하드웨어의 단일 GPU 로컬 채팅 | RTX 5090의 Lightning NVFP4 | 실행은 가능하지만 GGUF 변환은 아직 거칠며, vLLM/SGLang이 더 안정적 |
| 좁은 범위의 에이전트 작업 파인튜닝 | Lightning BF16 | 활성 파라미터 3B = 더 저렴한 파인튜닝, OpenMDW v1.1은 상업적 사용 허용 |
| 대규모 지시 이행 | Lightning | IFBench에서 71.88 대 Qwen 63.71, 8점 우위 |
Lightning은 대량 실행 환경에서 최고 정확도를 속도와 맞바꾼 모델이다. 세션당 수백 개의 에이전트 단계를 실행하면 30% 연산 절감 효과가 누적된다. 다만 이 모델은 2026년 8월 11일 출시됐고, 생태계 성숙도는 아직 발전 중이다. Mamba-2 하이브리드 아키텍처 탓에 GGUF 기반 도구가 완전히 지원하지 못할 수 있다. 현재 NVIDIA 하드웨어에서라면 vLLM 또는 SGLang과 NVFP4 체크포인트 조합이 가장 안전한 배포 경로다. Apple Silicon 환경이나 GGUF 전용 구성이라면 커뮤니티 변환본이 안정화될 때까지 기다리는 편이 낫다.
자주 묻는 질문
Nemotron 3.5 Lightning은 소비자 하드웨어에서 실행할 수 있나?
NVIDIA가 소비자 하드웨어용으로 지원하는 것은 NVFP4 체크포인트뿐이다. BF16 가중치는 80GB GPU(H100 또는 A100)가 필요하다. NVFP4는 GeForce RTX 5090, DGX Spark, NVIDIA Jetson에서 실행된다. llama.cpp와 Ollama용 커뮤니티 GGUF Q4 변환본도 존재하며 16 GB+ VRAM 시스템에서 쓸 수 있지만, 초기 빌드에서는 Mamba-2 하이브리드 아키텍처와 관련된 unused-tensor 문제가 보고됐다.
Nemotron 3.5 Lightning은 Qwen 3.6 35B와 비교해 어떤가?
Qwen 3.6 35B-A3B는 공개된 12개 벤치마크 중 11개에서 Lightning보다 뛰어나다. 특히 SWE-bench Verified와 Terminal-Bench에서 차이가 크다. 반면 Lightning은 IFBench 지시 이행에서 앞서며, 에이전트 워크로드에서는 유사한 정확도로 작업 완료 속도가 약 30% 빠르다. 범용 모델로는 Qwen이 더 강하고, 에이전트 실행 모델로는 Lightning이 더 빠르다.
Nemotron 3.5 Lightning은 코딩에 적합한가?
순수 코딩 벤치마크 기준으로는 아니다. SWE-bench Verified 점수는 51.56으로 Qwen 3.6의 70.12보다 낮다. 하지만 CodeRabbit은 $100 미만의 비용으로 Lightning을 코드 리뷰 라우팅에 맞게 파인튜닝해 베이스라인을 앞섰다. 이 모델은 커스터마이징을 염두에 두고 설계됐다. 코드베이스의 규칙에 맞춰 파인튜닝하면 활성 파라미터 3B 비용으로 일상적인 코드 작업을 처리할 수 있다.
Nemotron 3.5 Lightning의 라이선스는 무엇인가?
이 모델은 OpenMDW v1.1(Open Model Data Weight)로 공개됐다. NVIDIA는 이를 "가능한 한 허용적인 방식"으로 배포했다고 설명한다. 이 라이선스는 가중치, 학습 데이터, 레시피를 포함해 상업적 사용을 허용한다. 전체 라이선스 조건은 HuggingFace model card에서 확인할 수 있다.