 AIREITER
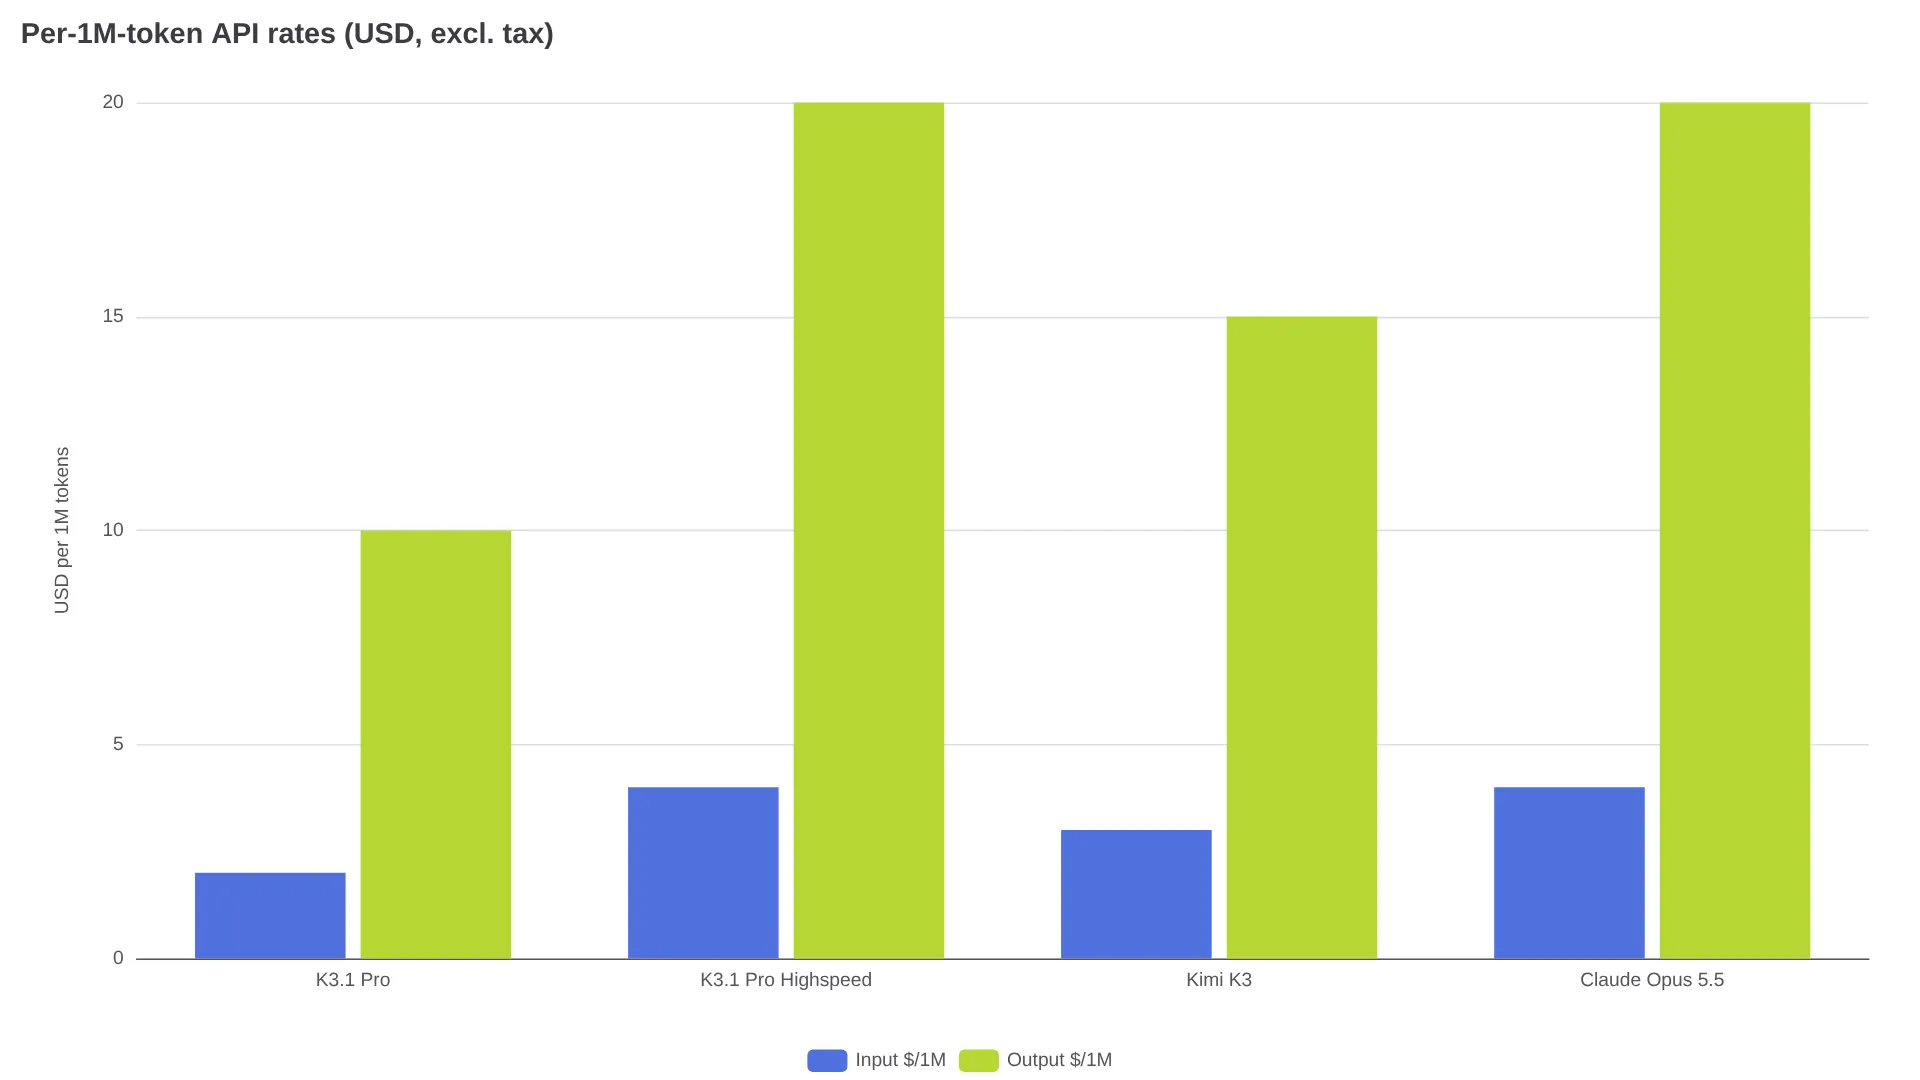
Kimi K3.1 Pro API 비용을 가르는 핵심은 단순한 $2/$10 요금표가 아닙니다. 실제 청구서에는 추론 토큰과 캐시 사용량이 함께 반영됩니다. 기본 요금은 입력 토큰 100만 개당 $2, 출력 토큰 100만 개당 $10이고, Highspeed는 속도를 높이는 대신 두 요금이 모두 2배입니다. 다만 캐시 적중 읽기는 어느 쪽이든 토큰 100만 개당 $0.20으로 동일합니다(platform.kimi.ai).
| 모델 | 입력 / 100만 토큰 | 출력 / 100만 토큰 | 캐시 적중 읽기 / 100만 토큰 | 캐시 쓰기 5분 / 100만 토큰 | 캐시 쓰기 1시간 / 100만 토큰 |
|---|---|---|---|---|---|
Kimi K3.1 Pro (kimi-k3.1-pro) | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
Kimi K3.1 Pro Highspeed (kimi-k3.1-pro-highspeed) | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3 (이전 세대) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
요금은 세금이 적용되기 전 기준이며, 토큰 100만 개당 미국 달러로 계산됩니다. 전체 100만 토큰 컨텍스트에 장문 컨텍스트 추가 요금은 없습니다. 이는 Kimi 공식 요금표에 따른 내용입니다(kimi.ai).
컨텍스트 10만 토큰 요청은 $0.30, 실제 청구액은 캐시와 추론에 달렸다
캐시되지 않은 입력 10만 토큰과 출력 1만 토큰을 사용하는 단순한 예를 보겠습니다. 공식 입력·출력 요금인 $2/$10을 적용하면 입력 $0.20에 출력 $0.10을 더해 총 $0.30입니다. 실제 요청은 다음 공식을 사용하면 됩니다. 기본 요금 기준이며, Highspeed에서는 입력·출력·캐시 쓰기 요금을 모두 2배로 적용합니다.
Total = (uncached_in x 2 + cached_read x 0.20 + write_5m x 2
  + write_1h x 4 + (visible_out + reasoning_out) x 10) / 1M
  + searches x 0.004
이 계산식은 캐시되지 않은 입력, 캐시 적중, TTL별 캐시 쓰기, 출력을 나눠 계산하는 Kimi 공식 비용 구조를 따른 것입니다(kimi.ai). 여기에 웹 검색 호출당 $0.004가 추가됩니다. API는 요청 단위 종량제로 청구되므로(kimi.ai), 같은 요청을 재시도하면 비용도 다시 발생합니다. K3.1 Pro는 추론이 항상 활성화되어 있고 추론 토큰도 출력 요금으로 계산됩니다. 즉, 숨겨진 추론 과정 역시 출력 토큰 100만 개당 $10이라는 동일한 예산을 사용합니다. 예를 들어 화면에 표시되는 답변이 1만 토큰이고 내부 추론이 4만 토큰이라면, 총 출력 5만 토큰으로 계산되어 $0.50이 청구됩니다. 실제로 입력 935토큰과 출력 56,097토큰을 사용하고 $0.5628을 지불했다는 사용자 보고도 출력 100만 토큰당 $10 요금과 거의 정확히 일치합니다(x.com).
캐시도 청구액을 크게 좌우하지만 자주 간과되는 부분입니다. 새로 캐시되는 접두부에는 캐시 쓰기 요금이 붙고, 같은 접두부를 유효 시간 안에 재사용하면 읽기 비용이 토큰 100만 개당 $0.20으로 낮아집니다. 기본 캐시 유지 시간은 5분이며, 호출마다 1시간 옵션을 선택할 수 있습니다(kimi.ai). 컨텍스트 앞부분에 가까운 접두부가 바뀌면 그 뒤의 전체 내용이 재사용되지 않을 수도 있습니다(kimi.ai). 캐시 적중 여부는 문장이 비슷한지만 보고 판단할 수 없습니다. 요청별 사용량 내역에서 cached-read와 uncached 토큰이 실제로 어떻게 집계됐는지 확인해야 합니다.
Kimi K3.1 Pro API 요금 상세 비교: Standard와 Highspeed
Highspeed는 같은 수준의 성능과 100만 토큰 컨텍스트를 제공하면서, 입력·출력·캐시 쓰기 요금은 정확히 2배로 받습니다. 대신 속도는 대략 2~3배 빠르다고 안내합니다(platform.kimi.ai). Moonshot의 출시 글도 같은 내용을 설명합니다(kimi.ai).
두 제품에서 유일하게 2배가 되지 않는 항목은 캐시 적중 읽기입니다. 두 모델 모두 캐시된 입력 토큰 100만 개당 $0.20을 냅니다. 긴 시스템 프롬프트와 도구 정의를 반복 재생하는 에이전트 루프에서는 이 차이가 중요합니다. 캐시 재사용 할인은 동일하지만, 새로 처리하는 토큰과 추론 비용은 Highspeed에서 2배가 되기 때문입니다.
비용을 계산할 때 기준으로 삼을 만한 사실은 세 가지입니다.
- API 요금은 별도 종량제입니다. 입력과 출력을 따로 측정하며, Kimi 멤버십이나 Kimi Code 구독과 분리되어 있습니다. 따라서 멤버십 잔액으로 API 호출 비용을 결제할 수 없습니다(kimi.ai).
- 모델 ID와 엔드포인트가 따로 있습니다. API는 OpenAI 호환 방식이며 모델 ID는
kimi-k3.1-pro와kimi-k3.1-pro-highspeed입니다.https://api.moonshot.ai/v1에서 사용할 수 있고, OpenRouter와 Vercel AI Gateway에서는moonshotai/kimi-k3.1-pro로도 제공됩니다. - 부가 기능에도 별도 비용이 붙습니다. 웹 검색은 토큰 요금과 별도로 호출당 $0.004이며, 업로드한 파일 자체에는 요금이 없지만 파싱된 내용은 입력 토큰으로 청구됩니다. API 이용은 최소 $1 충전 후 활성화되고, 사용량에 따른 단계별 속도 제한이 적용됩니다(kimi.ai).
Highspeed의 2배 요금이 아깝지 않은 경우와 돈만 새는 경우
Highspeed가 유리한 조건은 기다리는 시간이 토큰 비용보다 비쌀 때입니다. 대화형 코딩 세션, 실시간 어시스턴트, 사용자가 로딩 화면을 직접 보고 있는 데모라면 지연 시간이 곧 제품 경험이므로 $4/$20 요금이 의미 있을 수 있습니다. 반면 배치 작업, 야간 에이전트 실행, 평가 작업처럼 사용자가 기다리지 않는 작업은 기본 $2/$10 모델이 적합합니다. 표시된 토큰 요금이 대략 절반이기 때문입니다. 결국 Highspeed를 선택할 기준은 줄어든 대기 시간의 가치가 추가 토큰 비용을 넘어서는지입니다. 입력 중심 작업에서는 추가 비용이 기본 요금 전체를 한 번 더 내는 수준에 가깝습니다.
비용을 줄일 때는 모델 tier를 바꾸기보다 먼저 추론 수준을 조정하는 편이 낫습니다. API는 reasoning_effort에 low, high, max를 지원하며, 기본값은 max입니다. Moonshot이 공개한 벤치마크 점수도 이 설정을 기준으로 합니다(datacamp.com). 쉬운 작업에서 max를 high로, 또는 high를 low로 낮추면 Highspeed 프리미엄을 지불하지 않고도 추론 토큰을 줄일 수 있습니다. 한 세션에서는 설정을 하나로 유지하는 것이 좋습니다. 세션 중간에 수준을 바꾸면 컨텍스트 캐시가 무효화되기 때문입니다(datacamp.com).
커뮤니티의 사용 후기를 보면 속도와 비용의 차이가 더 분명합니다. 한 일본 사용자는 비슷한 작업을 비교한 결과 Opus 5.5가 14분 32초, Kimi K3.1 Pro가 27분 53초에 작업을 끝냈고 결과 품질은 상당히 비슷했다고 전했습니다. 결론은 기다려도 되는 작업만 Kimi로 보내겠다는 것이었습니다.
반값인 줄 알았는데 기다리는 시간은 거의 두 배였다. ... Opus 5.5는 14분 32초, Kimi K3.1 Pro는 27분 53초였다. 결과는 솔직히 꽤 비슷했다. 나라면 기다려도 되는 작업만 Kimi에 맡기겠다. — @rutinelabo (x.com)
Reddit 사용자들도 비슷한 차이를 이야기합니다. Highspeed는 초당 약 80토큰, 기본 버전은 초당 약 30토큰 수준이지만, 빠른 tier는 매우 비싸다는 평가입니다.
이번에도 이 모델에는 팔 하나를 내놓아야 할 만큼 비싸지만 눈으로 읽기 힘들 정도로 빠른 고속 버전이 있다. 약 80t/s로 작동하는 반면, 일반 버전은 내키면 30t/s 정도로 실행된다. — u/Kiverty (reddit.com)
간단한 원칙은 이렇습니다. 기본값은 standard K3.1 Pro로 두고, 비용이 걱정되면 먼저 reasoning_effort를 낮추세요. Highspeed는 사람이 결과를 기다리고 있는 세션에만 사용하는 편이 좋습니다.
11월 4일 이후 셀프 호스팅: 3T급 모델의 현실적인 계산
Moonshot은 전체 Kimi K3.1 Pro 가중치를 2026년 11월 4일까지 공개하겠다고 밝혔습니다. 모델은 3T급이며 컨텍스트 윈도우는 100만 토큰으로 설명되고 있습니다(kimi.com). 11월 2일 기준으로 Moonshot의 Hugging Face 조직(huggingface.co/moonshotai)에는 공식 K3.1 Pro 저장소가 아직 보이지 않습니다. 현재는 Kimi K3와 이전 모델이 등록되어 있고, 검색 결과에는 비공식 포크만 확인됩니다. 최종 라이선스, 파일 형식, 양자화 옵션도 아직 확정되지 않았습니다. 서드파티 추적 사이트 역시 공식 공개 전까지 이 정보들을 미정 상태로 표시하고 있습니다(ctrlaltorion.com).
이 모델에서 셀프 호스팅이 API보다 항상 저렴하다고 보기 어려운 이유는 규모입니다. K3.1 Pro는 2.8T 파라미터 Mixture-of-Experts 모델인 Kimi K3의 post-trained 후속 모델이며, 3T급이라는 설명도 같은 방향을 가리킵니다(datacamp.com). 다만 MoE의 전체 파라미터 수와 토큰당 활성 파라미터 수는 다르므로, 현재 공개된 정보만으로는 단일 워크스테이션에 필요한 VRAM을 신뢰성 있게 계산할 수 없습니다.
추측으로 GPU 가격을 넣기보다 손익분기점을 기호로 계산하는 편이 낫습니다.
API_month = monthly_tokens_1M x blended_$/1M (from formula above)
Self-host wins when cluster_monthly_cost < API_month at sustained utilization
입력 토큰 100만 개당 $2, 출력 토큰 100만 개당 $10을 적용하면 입력 10억 토큰과 출력 1억 토큰의 비용은 입력 $2,000에 출력 $1,000을 더한 약 $3,000입니다. 이미 적합한 클러스터를 보유하고 있거나, 높은 사용량으로 지속적인 추론을 실행해야 하거나, 데이터를 온프레미스에 보관해야 하는 팀이라면 셀프 호스팅이 유리할 수 있습니다. 그런 클러스터와 지속적인 사용량이 없는 팀이라면 위 공식은 대체로 종량제 API 쪽에 유리합니다. 공식 체크포인트와 라이선스가 공개되기 전에는 셀프 호스팅 계획을 확정하지 않는 것이 좋습니다.
사용자가 반복해서 빠지는 두 가지 청구 함정
첫 번째 함정은 추론 토큰도 출력으로 청구된다는 점입니다. 앞서 소개한 공식에 이미 반영되어 있습니다. max_completion_tokens으로 실행 상한을 설정하고, 테스트 요청은 low에서 시작하세요. 실패했을 때만 high로 올리고, max는 정말 어려운 최종 실행에 남겨두는 방식이 비용 관리에 유리합니다.
두 번째는 구독형 quota가 소진되는 속도와 API 종량제의 예측 가능성을 혼동하는 것입니다. 여러 유료 사용자는 까다로운 코딩 작업에서 5시간 제공량이 몇 분 만에 바닥났다고 보고했고, 한 최고 tier 사용자는 월간 quota가 6시간 만에 모두 소진됐다고 전했습니다(reddit.com). Moonshot은 10월 25일 속도 제한과 불필요한 quota 소모 문제를 인정하고 사과했습니다. 동시에 중복 subagent 호출과 출력 길이를 줄이면서 일회성으로 quota를 25% 복구했습니다(x.com). 고강도 추론과 코딩 작업에서는 입력 10만 토큰과 출력 1만 토큰 단위당 $0.30이 드는 종량제 API가, 한 작업만으로 사라질 수 있는 구독 allowance보다 비용을 예측하기 쉽습니다.
Kimi K3.1 Pro API 가격 FAQ
Kimi K3.1 Pro API는 토큰 100만 개당 얼마인가요?
Standard 요금은 세전 기준으로 입력 토큰 100만 개당 $2.00, 출력 $10.00, 캐시된 입력 읽기 $0.20, 5분 캐시 쓰기 $2.00, 1시간 캐시 쓰기 $4.00입니다(kimi.ai).
K3.1 Pro와 Highspeed의 차이는 무엇인가요?
Highspeed는 같은 수준의 성능과 100만 토큰 컨텍스트를 제공하지만, 대략 2~3배 빠른 대신 입력 토큰 100만 개당 $4.00, 출력 $20.00을 받습니다. 캐시 쓰기 요금도 2배가 되지만 캐시 적중 읽기는 $0.20으로 동일합니다(platform.kimi.ai).
API 모델 ID는 무엇인가요?
Moonshot의 OpenAI 호환 엔드포인트에서 기본 tier는 kimi-k3.1-pro, 고속 tier는 kimi-k3.1-pro-highspeed를 사용합니다. 게이트웨이에서는 moonshotai/kimi-k3.1-pro로 표시됩니다(openrouter.ai).
Kimi 멤버십에 API 사용량이 포함되나요?
아닙니다. API 청구는 Kimi 멤버십 및 Kimi Code 요금제와 분리되어 있으며, 키와 잔액도 별도로 관리됩니다. 따라서 멤버십 크레딧으로 API 호출 비용을 낼 수 없습니다(kimi.ai).
비용을 줄이기 위해 추론을 끌 수 있나요?
아니요. K3.1 Pro는 항상 추론을 수행합니다. 비용은 추론을 끄는 방식이 아니라 reasoning_effort(low, high, max, 기본값 max)와 max_completion_tokens를 조정해 관리해야 합니다(datacamp.com).
오픈 가중치는 언제 공개되며, 기다려야 할까요?
Moonshot은 2026년 11월 4일까지 공개하는 것을 목표로 하고 있습니다. 하지만 11월 2일 기준으로 공식 Hugging Face 저장소와 최종 라이선스는 아직 공개되지 않았습니다. 당장은 API를 사용하고, 공식 체크포인트와 라이선스가 공개된 뒤에 셀프 호스팅을 다시 검토하는 편이 좋습니다.
관련 글: 전체 벤치마크 분석은 Kimi K3.1 Pro API: Pricing, Benchmarks and Highspeed Guide, 이전 세대 요금은 Kimi K3 Pricing, 하나의 키로 Kimi 모델을 호출하는 방법은 Kimi K3 API page에서 확인할 수 있습니다.