 AIREITER
시간당 $0.15인 API를 한 시간 사용했는데 $0.30이 청구되고, 시간당 $0.36인 API는 같은 파일에 $0.36만 청구될 수 있습니다. 오디오 채널을 어떻게 과금하는지에 따라 비용이 두 배가 되기 때문입니다. 정확도 순위표보다 이런 과금 방식이 STT 예산을 더 크게 좌우하지만, 대부분의 비교 글에서는 이 차이를 제대로 다루지 않습니다.
2026년에 어떤 음성-텍스트 API가 최선인지는 파일을 변환하는지, 실시간 음성 에이전트를 운영하는지에 따라 달라집니다. 녹음 파일을 저렴하게 처리하려면 시간당 $0.15인 AssemblyAI Universal-2부터 살펴보세요. 대화의 끼어들기와 발화 전환이 중요한 라이브 에이전트라면 Deepgram Flux 또는 Nova-3 스트리밍이 출발점입니다. 90개 이상의 언어와 폭넓은 화자 분리가 필요하다면 배치 기준 시간당 $0.22인 ElevenLabs Scribe v2를 테스트할 만합니다. 아래 가격은 대량 사용 할인 전, 오디오 1시간 기준으로 환산한 종량제 대표 요금입니다.
배치와 스트리밍은 아예 다른 제품이다
배치 변환과 실시간 스트리밍은 서로 다른 구매 항목으로 봐야 합니다. 배치 API는 처리한 오디오 시간에 따라 과금하며, 파일을 업로드한 뒤 결과를 조회하는 방식이 일반적입니다. 스트리밍 API는 WebSocket이 열려 있는 동안의 유휴 시간까지 포함해 세션 분 단위로 과금합니다. 따라서 부분 결과가 얼마나 빨리 나오는지가 성패를 가릅니다.
부분 결과 지연, 최종 결과 확정 지연, 발화 종료 감지는 서로 다른 시점을 측정합니다. 첫 단어가 화면에 나타나는 순간, 단어가 더 이상 바뀌지 않는 순간, 시스템이 사용자의 발화가 끝났다고 판단하는 순간이 각각 다릅니다. Dexto와 versusref의 스트리밍 비교가 지적하듯, 서로 다른 기준을 한 순위표에 섞으면 결과가 왜곡됩니다.
실무에서는 다음처럼 나누면 됩니다.
- 대규모 녹음 아카이브, 팟캐스트, 회의, 통화 기록: 시간당 비용, 화자 분리 정확도, 대용량 파일 처리, 수정에 드는 시간을 우선하세요.
- 실시간 자막이나 전화 에이전트: 안정적인 부분 결과, 발화 종료 감지, 끼어들기 처리, LLM과 TTS를 포함한 종단 간 지연 시간을 봐야 합니다.
- AWS나 GCP에서 컨택센터 통화를 처리한다면: 조달 조건과 채널별 과금이 시간당 $0.05의 요금 차이보다 더 큰 변수가 되는 경우가 많습니다.
"이 API들을 실제 고객 녹음으로 테스트하세요. 시끄러운 방, 인도 억양, 힌디어-영어 코드 스위칭까지요… 정확도와 지연 시간, 안정성이 먼저입니다. 가격은 마지막에 보세요." — @Aditya_Chawla20
이 게시물은 AssemblyAI 시간당 $0.21, ElevenLabs Scribe v2 시간당 $0.22, Deepgram Nova-3 약 시간당 $0.26을 비교했습니다. 결론은 5센트의 차이보다 실제 오디오를 얼마나 안정적으로 처리하는지가 중요하다는 것이었습니다.
오디오 1시간을 처리하는 실제 비용
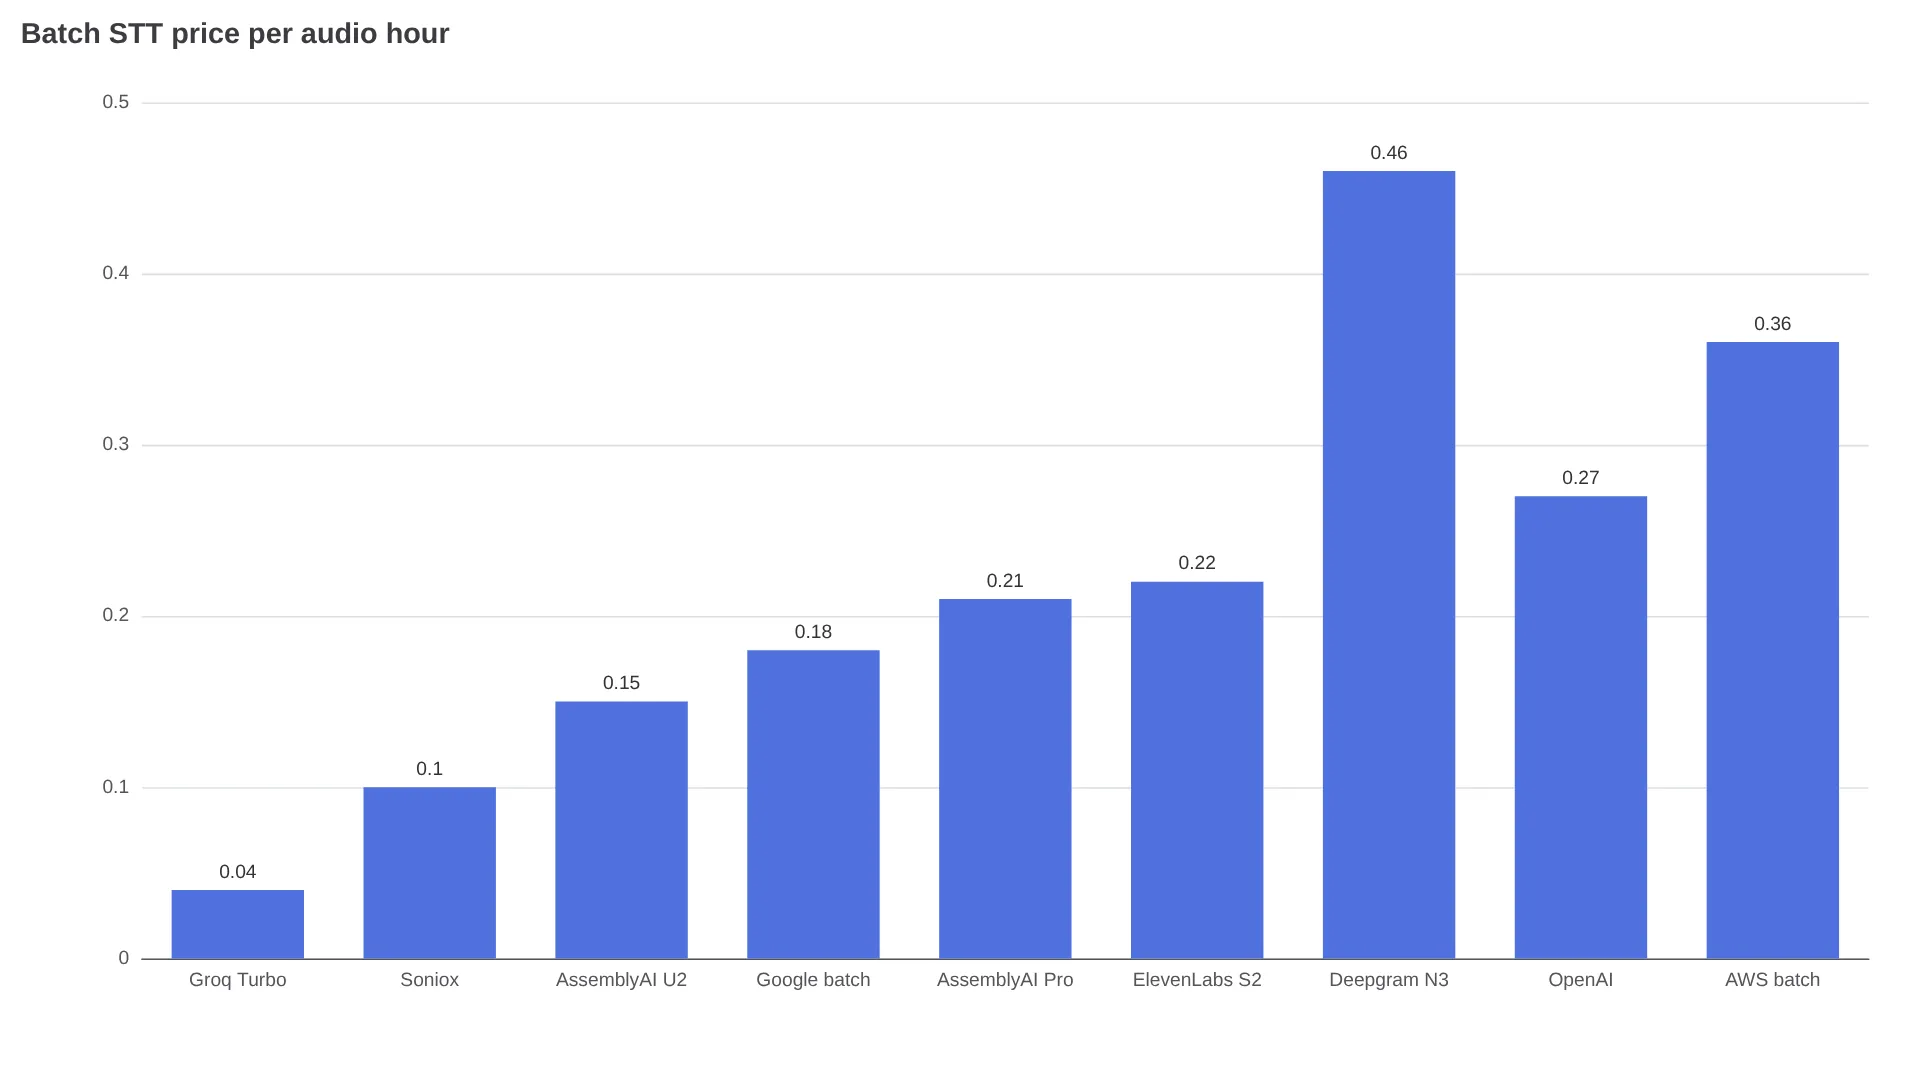
| 제공업체 | 배치 | 스트리밍 / 실시간 | 언어 | 무료 시작 혜택 |
|---|---|---|---|---|
| Groq Whisper | Large v3 Turbo 시간당 $0.04 | 스트리밍 엔드포인트 없음 | Whisper 다국어 지원 언어군 | 제한이 있는 무료 티어 |
| Soniox | 비동기 약 시간당 $0.10 | 실시간 약 시간당 $0.12 | 하나의 모델에서 60개 이상 | 명시된 혜택 없음 |
| AssemblyAI | Universal-2 시간당 $0.15; Universal-3.5 Pro 시간당 $0.21 | Universal-Streaming 시간당 $0.15; Pro Realtime 시간당 $0.45 | U2 99개; 3.5 Pro 18개 | 카드 없이 $50 크레딧 |
| Google Cloud | Dynamic Batch 시간당 $0.18; Standard 시간당 $0.96 | 첫 500,000분까지 Standard 시간당 $0.96 | 125개 이상의 로케일을 지원한다고 명시 | $300 Cloud 크레딧 |
| ElevenLabs Scribe | Scribe v2 시간당 $0.22 | Scribe v2 Realtime 시간당 $0.39 | 90개 이상 | 무료 플랜 약 4.5시간 |
| Deepgram | Nova-3 티어별 시간당 $0.26–$0.46 (프로모션 및 정규 단일 언어 요금) | Nova-3 프로모션 약 시간당 $0.29; Flux 영어 시간당 $0.39 ($0.0065/분) | 45개 이상 | $200 크레딧 |
| OpenAI | gpt-transcribe 시간당 $0.27 ($0.0045/분) | gpt-live-transcribe 시간당 $1.02 ($0.017/분) | 모델별로 명시, Whisper는 98개 | 명시된 혜택 없음 |
| AWS Transcribe | 시간당 $0.36 ($0.006/분) | 시간당 $0.60 ($0.01/분) | 폭넓은 지원, 기능에 따라 다름 | 12개월 동안 월 60분 |
| Speechmatics | Melia 1 기본 시간당 $0.24 | Linden 1 시간당 $0.30; Enhanced 시간당 $0.80 | 55개 이상 | $100 크레딧 |
| Gladia | Solaria-3 시간당 €0.16 | 시간당 €0.68 | Solaria-1 100개 이상; Solaria-3 6개 | 1년 동안 €50 크레딧 |
Deepgram의 가격 범위는 프로모션과 정규 단일 언어 사전 녹음 요금의 차이를 반영합니다. 예산을 잡기 전에는 Deepgram 가격 페이지에서 현재 적용되는 티어를 확인하세요.
멀티채널 과금에 주의할 것
스테레오 오디오 한 시간이 항상 과금 대상 한 시간인 것은 아닙니다. AssemblyAI와 Google은 채널마다 별도로 과금합니다. 따라서 60분짜리 2채널 통화를 Universal-2로 처리하면 $0.15 x 2 = $0.30이 됩니다. Google Standard에서는 $0.96 x 2 = $1.92입니다. 반면 AWS Transcribe는 최대 2개 채널을 재생 시간 요금에 포함하므로, CometAPI가 인용한 미국 동부 고용량 사례에서는 같은 스테레오 통화가 배치 기준 약 $0.36으로 처리됩니다. 시간당 요금을 비교하기 전에 채널을 어떻게 계산하는지부터 확인하세요.
순위를 뒤집는 추가 기능 비용
기본 음성 변환 요금은 전체 비용의 첫 줄에 불과합니다. CometAPI의 항목별 분석을 보면 Deepgram Nova-3 단일 언어 사전 녹음 요금은 분당 $0.0077에서 화자 분리를 추가하면 $0.0097, 화자 분리와 비식별화까지 추가하면 $0.0117로 올라갑니다. 핵심 용어 프롬프트를 쓰면 분당 $0.0013이 더해집니다. AssemblyAI는 녹음 파일 화자 분리에 시간당 $0.02를 부과하지만 스트리밍 화자 분리에는 시간당 $0.12를 부과합니다. ElevenLabs는 실시간 핵심 용어에 시간당 $0.08, 엔티티 감지에 시간당 $0.07을 추가합니다.
최종적으로 승인된 텍스트 하나의 총비용은 API 처리비 + 유료 기능 + 재시도 + 저장 및 전송 + 사람의 수정 시간입니다. CometAPI의 계산 사례에서는 검수 인건비를 시간당 $30으로 잡았을 때, 시간당 $0.15인 경로가 8분의 수정 작업을 필요로 하면 총 $4.15가 들었습니다. 반면 시간당 $0.60인 경로는 수정에 3분만 필요해 총 $2.10이었습니다.
음성 에이전트라면 먼저 대화 전환을 테스트하라
음성 에이전트는 깨끗한 오디오의 WER보다 끼어들기와 침묵 처리에서 더 자주 실패합니다. 대화 전환 방식, 컨텍스트 제어, 실시간 가격, 핵심 제약을 나란히 비교해야 합니다.
| 제공업체 | 대화 전환 | 실시간 가격 | 제약 |
|---|---|---|---|
| Deepgram Flux | EndOfTurn 이벤트와 조정 가능한 임계값; eager 모드와 TurnResumed; Dexto가 인용한 Deepgram 문서에 따르면 eager 모드는 LLM 호출을 50–70% 늘릴 수 있음 | Flux 영어 분당 $0.0065; Nova-3 스트리밍 프로모션 약 분당 $0.0048 | 다국어 Flux는 10개 언어; 프로모션은 종료될 수 있음 |
| AssemblyAI | 프롬프트 + 핵심 용어 + 에이전트의 이전 응답 1,750자; 구두점 기반 발화 종료 감지 | Universal-Streaming 시간당 $0.15; Pro Realtime 시간당 $0.45 | 저렴한 스트리밍 티어는 영어 중심; 유휴 소켓 시간도 과금 |
| ElevenLabs Scribe | 제공업체 모델 지연 약 150ms; 90개 이상 언어; 배치 화자 분리는 최대 32명 | Scribe v2 Realtime 시간당 $0.39 + 실시간 핵심 용어 시간당 $0.08 | 실시간 화자 분리는 명시되지 않음; 제공업체 수치에 네트워크 및 에이전트 스택 제외 |
| OpenAI | WebSocket을 통한 transcript delta; 서버 측 VAD 없음; 클라이언트가 발화 확정; 실시간 화자 라벨과 단어 타임스탬프 없음 | gpt-live-transcribe 분당 $0.017 | 클라이언트 측 발화 종료 감지 필요; 여기서 실시간 시간당 비용이 가장 높음 |
도구 호출과 LLM 지연도 함께 측정하세요. X의 한 호텔 에이전트 제작자는 STT가 빨랐는데도 도구 호출 뒤 5–7초의 침묵이 발생했다고 보고했습니다: @albertolco88. 이런 종단 간 지연은 STT만 비교하는 표에는 나타나지 않습니다.
녹음 파일이라면 텍스트와 화자 분리를 따로 평가하라
r/speechtech에 공유된 사용자 벤치마크는 실제 스웨덴어 회의 녹음 2시간 22분을 대상으로, 6명의 화자를 pyannote 정답 데이터와 비교했습니다. 작성자는 Deepgram이 가장 빠르고 화자 분리 성능도 가장 좋았으며, ElevenLabs는 스웨덴어 텍스트 변환이 더 나았지만 6명 중 2명의 화자를 놓쳤다고 평가했습니다. AssemblyAI는 정확도는 비슷했지만 해당 파이프라인에서는 훨씬 느렸습니다. 결국 작성자는 단일 승자를 고르지 않고 여러 제공업체를 조합했습니다.
"세 곳 중에서는 Deepgram이 가장 강력했고, 처리도 매우 빨랐습니다." — r/speechrecognition의 u/DoctorNootNoot
녹음 파일을 실제 서비스에 투입할 수 있는 API인지 확인하려면 다음 세 가지를 따로 점검해야 합니다.
- 한 발화 안에서의 코드 스위칭. 다국어 회의 스레드의 제작자들은 한 문장 중간에 핀란드어와 영어 또는 스페인어와 영어를 섞으면 언어가 전환되는 구간이 깨진다고 보고했습니다. Universal-3.5 Pro는 18개 언어에 걸친 코드 스위칭을 지원한다고 명시합니다. Gladia와 Speechmatics는 다국어 감지를 강점으로 내세웁니다. 그래도 모든 유럽 언어 조합을 기본 설정만으로 깔끔하게 처리하는 업체는 없으므로 실제 언어 조합으로 테스트해야 합니다.
- 대규모 화자 분리. 지원 화자 수를 확인하세요. ElevenLabs 배치는 32명, Azure는 35명을 명시하고 있으며 Speechmatics 실시간은 상한을 명시하지 않았습니다. 실시간 화자 분리를 지원하는지, 추가 비용과 지연 시간이 어떻게 되는지도 함께 봐야 합니다. 같은 스웨덴어 벤치마크 작성자는 텍스트 정확도가 비슷했음에도 AssemblyAI의 처리 시간이 프로덕션 파이프라인에는 너무 느렸다고 설명했습니다.
- 대용량 파일. OpenAI는 오디오 업로드를 25MB로 제한하기 때문에 긴 녹음을 처리할 때 제약이 생깁니다. 배치 중심 API는 URL 기반 작업, 여러 시간 길이의 파일, 안정적인 비동기 조회를 지원하는 경우가 많습니다. 배치 변환 스레드의 한 사용자는 "대용량 파일을 업로드할 수 없고" URL 처리 방식도 이해하지 못했다고 말했습니다. WER 표로는 드러나지 않는 도입 장벽입니다.
오프라인 환경에서는 직접 호스팅하는 Whisper large-v3가 여전히 선택지입니다. Echosaw의 동일 오디오 테스트는 영어 낭독과 회의 발화 22.7분을 비교했습니다. 호스팅 API는 깨끗한 챕터에서 2.1% 미만의 WER을 기록했지만, 2-vCPU Whisper 구성은 구간 누락과 함께 10–17%를 기록했고 회의 오디오는 실시간의 0.5배 속도에서 32.7%였습니다. 프로덕션에서 직접 호스팅하려면 일반적으로 GPU와 VAD, 청크 분할을 함께 사용해야 실용적인 처리량을 확보할 수 있습니다.
클라우드, 전문 API, 직접 호스팅 중 무엇을 고를까
- 클라우드 서비스 연동. Google Dynamic Batch는 시간당 $0.18로 GCP에 이미 있는 대규모 비긴급 아카이브에 적합합니다. 반면 Standard는 시간당 $0.96으로 실시간 사용 시 부담이 큽니다. AWS Transcribe는 S3/IAM 기반 통화 처리 흐름에 잘 맞고 두 채널이 포함됩니다. Azure Speech는 배치가 약 시간당 $0.18, 실시간이 약 시간당 $1.00이며 월 5시간의 실시간 무료 티어를 제공합니다. 저장, 전송, 비식별화 비용은 음성 변환 요금과 별도로 계산하세요.
- 저렴한 관리형 배치. Groq Whisper Turbo는 시간당 $0.04로 일반 배치 처리에서는 모든 관리형 API보다 저렴하지만 스트리밍이나 명시된 화자 분리를 제공하지 않습니다. Soniox는 비동기 기준 약 시간당 $0.10으로, 위 표에서 화자 분리와 타임스탬프를 포함한 60개 이상 언어를 제공하는 배치 가격 중 가장 낮은 수준입니다. 다만 독립적인 벤치마크 자료는 상대적으로 적습니다.
- 하이브리드 파이프라인. 텍스트 변환은 강점이 있는 ElevenLabs, 화자 분리는 강점이 있는 Deepgram, 저렴한 초과 배치 물량은 Whisper나 Groq에 맡기는 방식입니다. 오케스트레이션 비용이 추가되지만, 실제 오디오에서 텍스트와 화자 라벨을 모두 가장 잘 처리하는 단일 업체가 없다면 저렴한 두 번의 호출이 비싼 수정 작업 한 번보다 나을 수 있습니다.
마이그레이션 관련해서는 주의가 필요합니다. OpenAI는 whisper-1, gpt-4o-transcribe, gpt-4o-mini-transcribe, gpt-4o-transcribe-diarize를 지원 중단 예정으로 표시했으며, 종료 일정은 2027년 2월 26일입니다. 아직 이 모델을 사용하는 팀이라면 종료 전에 대체 모델을 테스트해야 합니다. 특히 단어 타임스탬프와 화자 분리 동작이 달라지는지 확인하세요.
내 오디오로 7일 테스트하기
제공업체가 공개하는 WER 수치는 데이터셋, 정규화 방식, 모델 버전이 서로 달라 직접 비교할 수 없습니다. 실제 발신자 발화나 회의 구간 30–50개를 모으고, 사용하는 억양과 소음, 전문 용어를 반영한 정답 스크립트를 한 번 작성하세요. 그런 다음 나머지 파이프라인은 그대로 둔 채 동일한 오디오를 2~3개 제공업체에 스트리밍하거나 업로드해 비교합니다.
오디오 초, 채널 수, 활성화한 기능, 모델 버전, 부분 결과 지연, 최종 결과 확정 지연, 에이전트 종단 간 지연, 화자 분리 오류율, 최종 transcript 하나당 수정 시간을 기록하세요. 일반적인 WER과 별도로 이름, 이메일, 금액, 제품 용어처럼 비즈니스에 중요한 토큰의 정확도를 따로 평가해야 합니다. 시간당 요금은 가장 싸지만 사람의 검수 시간을 두 배로 늘리는 경로라면 총비용에서는 오히려 불리합니다.
FAQ
2026년에 가장 저렴한 음성-텍스트 API는 무엇인가?
위 표에서 화자 분리를 지원하는 관리형 배치 API 중 가장 낮은 가격대는 Soniox 약 시간당 $0.10과 AssemblyAI Universal-2 시간당 $0.15입니다. 화자 분리나 스트리밍이 필요 없는 단순 배치라면 Groq Whisper Turbo가 시간당 $0.04로 더 저렴합니다.
스트리밍 지연 시간이 가장 짧은 API는 무엇인가?
Dexto가 정리한 제공업체 주장에 따르면 ElevenLabs는 모델 지연 약 150ms, Deepgram은 발화 종료까지 약 260ms, Speechmatics는 평균 최종 결과 확정 시간이 350ms 미만입니다. 다만 부분 결과, 최종 확정, 종단 간 지연은 직접 통화 환경에서 테스트해야 합니다.
음성 에이전트에 가장 적합한 STT API는?
대화 전환 기능이 중요하면 Deepgram Flux, 컨텍스트 프롬프트가 중요하면 AssemblyAI, ElevenLabs 음성 스택에서 폭넓은 언어 지원이 필요하면 ElevenLabs Realtime, 엔드포인트 감지를 직접 구현할 수 있는 OpenAI 중심 스택이라면 OpenAI 실시간 전사를 우선 검토할 만합니다.
다국어와 코드 스위칭 오디오를 가장 잘 처리하는 서비스는?
ElevenLabs(90개 이상), AssemblyAI U2(99개; 3.5 Pro는 코드 스위칭을 포함해 18개), Gladia Solaria-1(100개 이상), Speechmatics(55개 이상)입니다. 다만 실제로 사용하는 언어 조합을 반드시 테스트하세요. 문장 중간의 언어 전환은 여전히 깨질 수 있습니다.
한 업체를 써야 할까, 변환과 화자 분리를 조합해야 할까?
위에서 언급한 스웨덴어 6인 회의 사례처럼 한 업체가 텍스트는 잘 처리하지만 화자 라벨은 약하다면, 여러 업체를 조합하는 편이 어느 한 곳만 사용하는 것보다 나을 수 있습니다. 오케스트레이션 비용과 이중 과금이 줄어드는 수정 시간을 상쇄하는지 계산하세요.
OpenAI Whisper는 종료되나?
OpenAI는 whisper-1과 gpt-4o-transcribe 계열을 포함한 기존 전사 모델을 지원 중단 예정으로 표시했으며, 종료 일정은 2027년 2월 26일입니다. 현재 선택지는 파일 처리용 gpt-transcribe와 실시간 오디오용 gpt-live-transcribe입니다.
| 용도 | 우선 테스트할 서비스 | 이유 |
|---|---|---|
| 대규모 녹음 아카이브 | AssemblyAI U2 / Google Dynamic Batch / Groq Whisper | 낮은 시간당 비용; 화자 분리가 필요 없으면 Groq가 가장 저렴 |
| 라이브 음성 에이전트 | Deepgram Flux / AssemblyAI Realtime / ElevenLabs Realtime | 대화 전환, 컨텍스트 프롬프트, 낮은 모델 지연 |
| 다국어 회의 | ElevenLabs Scribe v2 / Speechmatics / Gladia | 90+/55+/100+ 언어 지원 포지셔닝과 코드 스위칭 설계 |
| AWS 또는 GCP 중심 환경 | Transcribe / Cloud STT | IAM, 스토리지, 조달 조건이 정가보다 중요 |
| 오프라인 또는 데이터 레지던시 | 직접 호스팅하는 Whisper | 오디오가 자체 하드웨어 밖으로 나가지 않음 |
함께 읽을 글: 최고의 텍스트-음성 변환 API, 2026년 최고의 음성 복제 API, Gemini 3.5 Transcribe API 가이드.