 AIREITER
품질은 Opus 5.5가, 표시 가격은 GPT-6.1 Sol이 앞섭니다. 다만 요청 하나당 입력 토큰이 272K 이하일 때만 그렇습니다. 이 선을 넘으면 Sol의 긴 컨텍스트 surcharge가 가격 우위를 대부분 지워버립니다. 게다가 여러 Codex 사용자는 실제 시계로 측정했을 때 Sol이 더 느리게 느껴진다고 말합니다.
두 모델 모두 현재 사용할 수 있습니다. Anthropic은 2026년 9월 22일 첫 Claude 5.5 모델인 Claude Opus 5.5를 출시했고, OpenAI는 2026년 9월 29일 API ID gpt-6.1-sol인 GPT-6.1 Sol을 공개했습니다. 하지만 스펙표만 봐서는 실제 비용을 좌우하는 세 가지를 놓치기 쉽습니다. 긴 컨텍스트 surcharge, effort 설정, 그리고 구독 요금제의 할당량 동작입니다.
30초 결론
잘못된 패치나 불필요하게 커진 코드가 토큰 비용보다 더 큰 손실로 이어진다면 Claude Opus 5.5를 고르세요. 장시간 마이그레이션, 여러 저장소를 아우르는 감사, 무인 에이전트 작업에 잘 맞습니다. 반대로 요청 하나당 입력 토큰을 272K 이하로 유지하면서 대량 처리를 한다면 GPT-6.1 Sol이 유리합니다. 티켓 자동화, PDF 추출, 비즈니스 워크플로가 대표적인 예입니다.
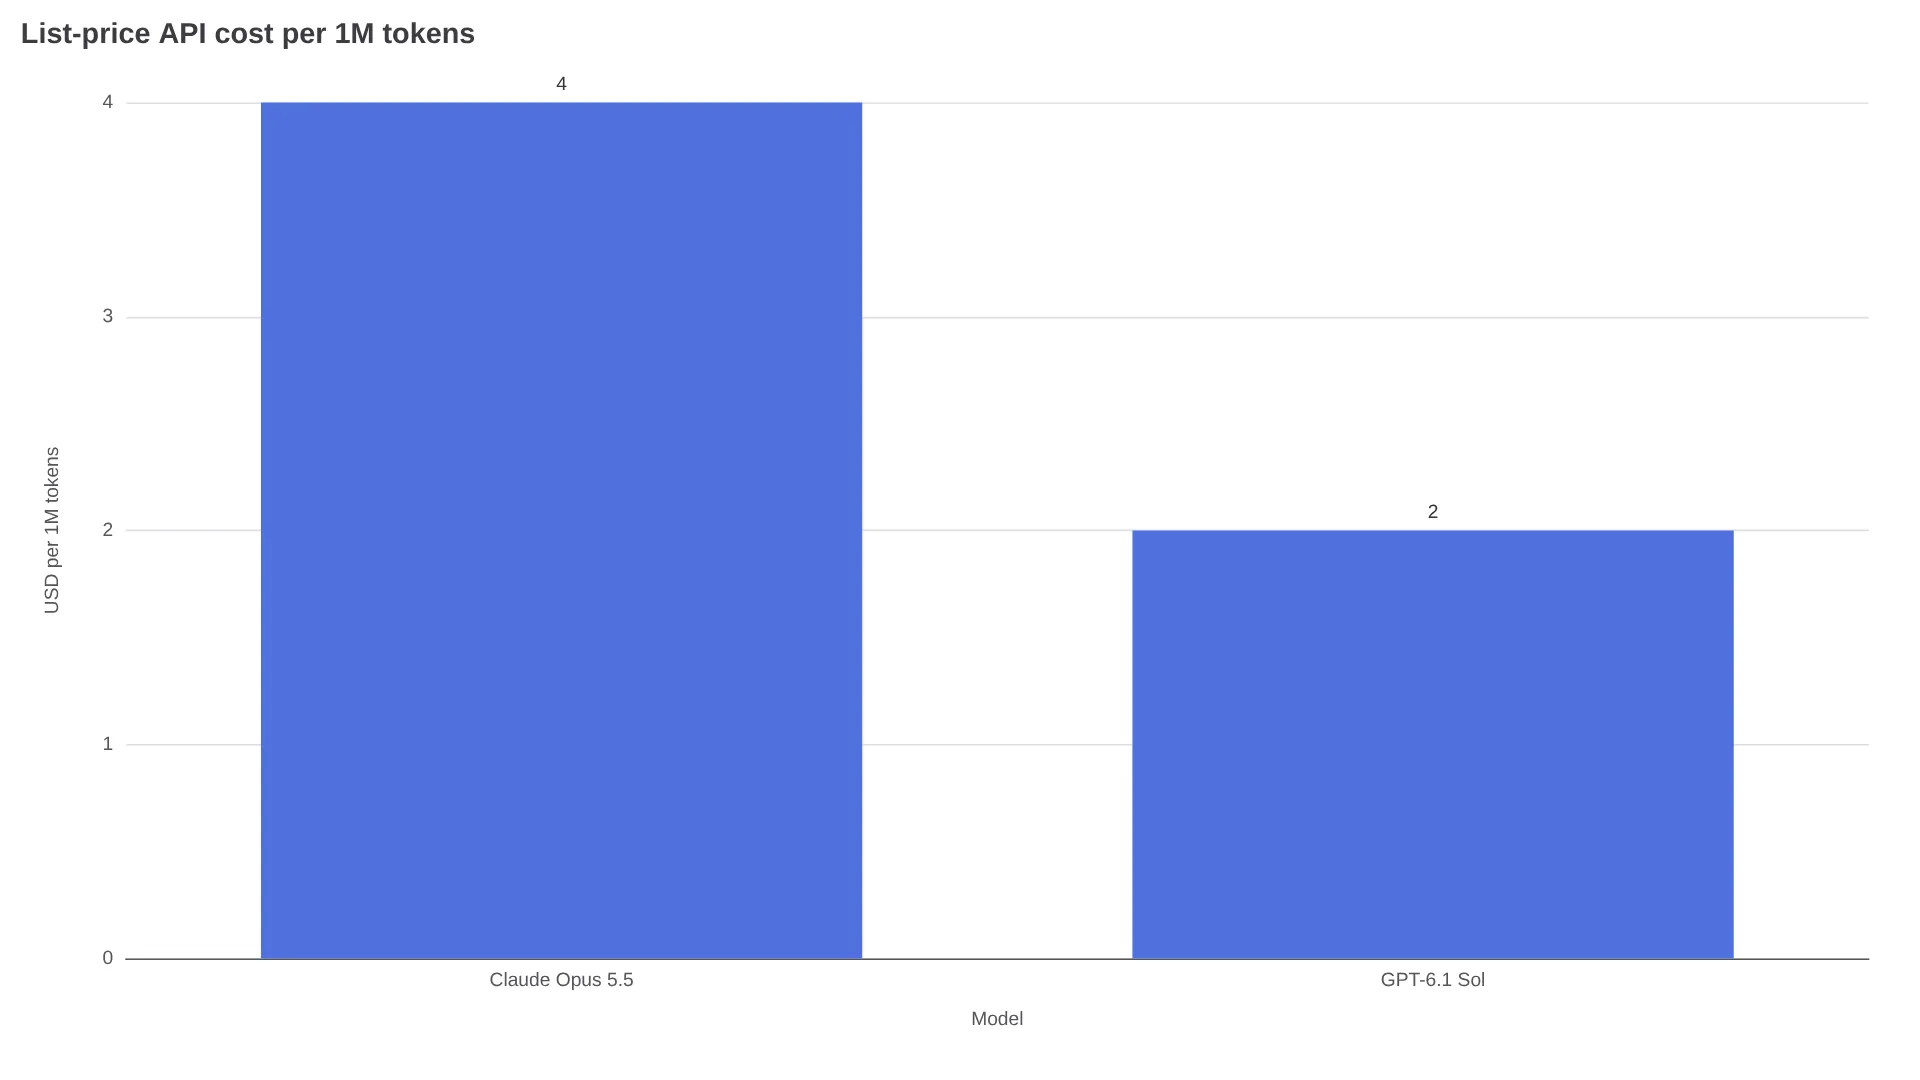
문서상 스펙 차이는 크지 않습니다. 컨텍스트는 1M 대 1.05M, 최대 출력은 양쪽 모두 128K, 입력/출력 가격은 100만 토큰당 $4/$20 대 $2/$10입니다. 하지만 실제 동작에서는 차이가 더 벌어집니다. Opus 5.5는 에이전트 코딩 지표에서 더 높은 점수( Terminal-Bench 4.0 66.4%, FrontierCode v1.1 54.4%, CursorBench 4.0 57.8%)를 기록했습니다. Sol은 절반 수준의 표시 가격과, 작업 비용을 3분의 1로 낮춘 AutomationBench 성과로 맞섭니다. 구독 사용자는 또 다른 변수를 고려해야 합니다. Reddit의 할당량 테스트에서는 API 가격만 보고 예상한 것보다 Sol의 사용량 차감이 더 빠른 것으로 나타났습니다.
가격과 컨텍스트, 어디서 쓸 수 있나
| Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|
| 제공사 | Anthropic | OpenAI |
| 출시일 | September 22, 2026 | September 29, 2026 |
| API ID | 대부분의 게이트웨이에서 claude-opus-5-5 제품군 | gpt-6.1-sol |
| 입력 / 출력 100만 토큰당 | $4.00 / $20.00 | $2.00 / $10.00 |
| 캐시 입력 읽기 100만 토큰당 | $0.20 | $0.10 |
| 컨텍스트 윈도우 | 1,000,000 tokens | 1,050,000 tokens |
| 최대 출력 | 128K tokens | 128K tokens |
| 고속 티어 | Fast mode $8 / $40, 최대 2.5배 속도 | Codex에서 최대 8배인 Ultrafast, 표시 가격 약 2배 |
| 사용 가능 경로 | Claude Code, API, Bedrock, Vertex, Foundry, OpenRouter | Codex, ChatGPT Work, API, Azure, Bedrock, OpenRouter |
| 제공되지 않는 곳 | — | 출시 시점의 일반 소비자용 Chat |
두 모델 모두 모델 문자열만 바꾸면 전환할 수 있습니다. AIReiter에서는 공급업체별 키를 따로 관리하지 않고 하나의 콘솔에서 두 모델을 모두 연결할 수 있습니다.
실제 워크로드에서 지불하는 비용
표면적인 가격만 보면 Sol이 50% 저렴합니다. 하지만 실제 비용은 요청 크기와 캐시 사용량에 따라 달라집니다.
OpenAI는 요청당 입력 토큰이 272K를 넘으면 surcharge를 적용합니다. 해당 요청 전체에 입력 및 캐시 요금은 2배, 출력 요금은 1.5배가 붙습니다. 반면 Anthropic은 1M 컨텍스트 전체에 동일한 요금을 적용한다고 안내하며, 요청 단위 surcharge는 공개하지 않았습니다. 캐시 읽기 가격은 $0.20 대 $0.10이므로 캐시를 많이 쓰는 반복 작업에서는 Sol의 가격 우위가 일부 유지됩니다.
| 워크로드 | Opus 5.5 | GPT-6.1 Sol | 차이 |
|---|---|---|---|
| 균형형 어시스턴트: 입력 1M / 출력 250K, 요청당 272K 미만 | $9.00 | $4.50 | Sol이 50% 저렴 |
| 검색·생성, 요청당 272K 미만: 입력 10M / 출력 1M | $60 | $30 | Sol이 50% 저렴 |
| 검색·생성, 모든 요청이 272K 초과: 입력 10M / 출력 1M | $60 | ~$55 | Sol이 약 8%만 저렴 |
| 캐시 중심 반복 작업: 100K 접두부를 한 번 기록한 뒤 1,000회 반복(신규 5K + 캐시 읽기 100K + 출력 1K) | ~$60.50 | ~$30.25 | Sol이 약 50% 저렴 |
총액은 토크나이저 차이를 제외한 표시 가격 기준 계산입니다. Sol의 장점은 짧은 요청을 대량으로 처리할 때 가장 크고, 한 번에 거대한 검색 요청을 보낼 때 가장 작습니다.
구독 요금제의 계산법은 API와 다릅니다. 한 사용자가 고정 프롬프트 128개로 GPT-6.1 Sol, GPT-6 Sol, Opus 5.5를 비교한 결과 Sol 계열의 구독 사용량은 토큰 가격만으로 예상한 수준보다 높았습니다. 후속 댓글에는 다음과 같은 평가가 올라왔습니다.
"my chatgpt just cited this. anyways they may be a match usage-wise but opus is way faster on the wall clock and i regret swapping this month." — u/ebrbrbr, r/ChatGPT 할당량 테스트 스레드
또 다른 Codex 사용자도 비슷한 사용량 차감을 경험했다고 말했습니다.
"I wouldn't mind using GPT 6.1 Sol if the usage was decent, but man, even though it's more 'efficient' I'm still getting drained on usage. It's unbelievable." — u/Longjumping_Stop6269, r/codex
예산을 잡을 때는 이렇게 접근하면 됩니다. 평균 요청이 272K를 넘는다면 마이그레이션 전에 surcharge를 포함해 계산하세요. $20 또는 $100 좌석을 쓰는 구독자라면 토큰당 비용이 아니라 병합된 PR 하나당 할당량 사용 비중을 추적하는 편이 낫습니다.
코딩과 에이전트: 벤치마크와 두 가지 작업 테스트
아래의 외부 테스트는 방향성을 보여주는 자료입니다. 테스트 하네스와 effort 수준이 서로 다릅니다. 출처는 Anthropic, OpenAI, DataCamp 빌드 테스트, OpenRouter 처리량, SpringPrompt 벤치마크 종합입니다.
| 벤치마크 | Opus 5.5 | GPT-6.1 Sol | 비고 |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 공개 수치 없음 | Anthropic 자체 테스트, xhigh |
| FrontierCode v1.1 Main | 54.4% | Fable 5.1과 동일, 수치 없음 | 보고 주체가 다름 |
| CursorBench 4.0 | 57.8% | 공개 수치 없음 | Anthropic 자체 테스트 |
| DeepSWE v1.1 | 공개 수치 없음 | Astra와 동일, GPT-6 Sol보다 +6.4pp | OpenAI 자체 테스트, 최대 effort |
| AutomationBench (도구 47개) | 40.0% | medium에서 Opus보다 +2.2pp, 비용 약 3분의 1 | 독립 테스트, fallback 없음, Anthropic의 Zapier 테스트 설명 기준 |
| OSWorld 2.0 일부 | 81.8% | 오프라인 세트 약 60.5% | 서로 다른 부분집합, 공급업체 자체 테스트 |
| GDPval-AA v2.1 | 1,846 Elo | GDP.pdf에서 fallback을 사용한 Opus를 절반 이하 비용으로 앞섬 | OpenAI가 제시한 업체 간 비교 주장 |
Opus 5.5는 공개된 에이전트 코딩 지표가 더 풍부합니다. Sol이 문서화된 성과로 앞서는 영역은 비즈니스 워크플로와 문서 분석이며, 작업 비용도 더 낮습니다. Anthropic은 해당 점수가 실제 운영 환경의 안전장치를 켠 상태에서 측정됐다고 밝혔습니다.
외부 작업 테스트 두 가지를 보면 차이가 더 선명해집니다.
- 단일 파일 Tetris 빌드(DataCamp, OpenCode, 동일 프롬프트, high effort, 1회 시도). 두 모델 모두 어려운 중력 반전 로직을 통과했습니다. 조작감, 완성도, 플레이 감각을 합친 점수는 Sol이 5.0, Opus가 4.3이었습니다. 다만 Opus는 3턴과 도구 호출 2회로 끝냈고 Sol은 6턴과 호출 9회가 필요했습니다. 비용은 Sol의 8.1K보다 많은 22.5K 추론 토큰을 사용한 Opus가 $0.87, Sol이 $0.26이었습니다.
- 프롬프트 128개 할당량 테스트(Reddit, 고정 프롬프트, 할당량과 시간 기록). 같은 작업에서 Sol은 GPT-6 Sol보다 구독 할당량을 더 많이 소모했습니다. Opus는 실제 경과 시간 기준으로 더 빨리 작업을 마쳤습니다.
사용자들이 반복적으로 언급하는 Opus의 장점은 과도하게 일을 벌이지 않는다는 점입니다.
"The biggest win with Opus 5.5 for me isn't even raw coding speed, it's that it doesn't over-engineer simple fixes. Previous models would rewrite 4 files when you asked for a 3-line patch; 5.5 respects the existing architecture" — u/food_fatherr, r/ClaudeAI
반대 사례도 있습니다. 한 개발자는 픽셀 단위로 정확한 결과를 요구했을 때 Sol이 테스트를 30,000개 작성했고, 줄여 달라고 하자 그중 25개만 삭제했다고 보고했습니다.
체감 속도와 스펙표의 속도는 다르다
스펙표의 디코딩 속도는 Opus에 유리합니다. SpringPrompt가 Artificial Analysis를 통해 집계한 수치는 초당 약 96 대 53토큰이고, OpenRouter의 중앙 처리량은 74 대 29입니다. 반면 SpringPrompt 기준 첫 토큰까지 걸리는 시간은 낮은 effort에서 Sol이 1.71초, Opus가 6.89초로 Sol이 약간 앞섭니다. 하지만 인용된 Codex 사용자 보고에서는 간단한 작업도 수분씩 걸리고 문서 작업도 오래 걸리는 등, 전체 대기 시간은 정반대로 묘사됩니다.
두 결과는 동시에 성립할 수 있습니다. 초당 토큰 수는 첫 응답이 나온 뒤의 디코딩 속도만 측정합니다. 실제 소요 시간에는 추론, 대기열, 하네스 오버헤드가 모두 포함됩니다.
- Opus Fast mode는 $8/$40(2배)이며 최대 2.5배 속도를 제공합니다. Sol Ultrafast는 약 2배 요금으로 Codex에서 최대 8배 속도를 약속합니다.
- 인용된 Codex와 Work 보고서는 API 디코딩 속도가 아니라 지연 시간을 중심으로 합니다. 한 40분짜리 PDF 작업은 단일 사례에서 5시간 창의 6%만 사용했을 뿐이며, 일반적인 처리 속도를 의미하지는 않습니다.
- 사용 환경이 대화형 루프(Cursor, Claude Code, Codex CLI)라면 최종 선택 전에 실제 티켓 세 개를 각각 처리해 보세요.
청구액을 좌우하는 설정
모델 이름보다 기본 설정이 더 중요할 때가 많습니다.
- Opus는 Medium 또는 High에서 시작하세요. 인용된 사용자 보고에 따르면 일반적인 패치에서는 Extra High와 Max가 성능 향상은 크지 않은데 할당량만 빠르게 소모할 수 있습니다.
- Thinking 잠금 방식이 다릅니다. Opus의 thinking은 끌 수 없고, 강제 도구 사용은 거부됩니다. 신규 계정에서는 편집된 컨텍스트가 400 오류를 일으킬 수도 있습니다(DataCamp API 노트). Sol은
none부터max까지 조절할 수 있으며, 캐시를 무효화하지 않고 대화 중간에 effort를 바꿀 수 있습니다(DataCamp 추론 제어). 비용 상한이 있는 반복 작업에는 Sol 쪽이 다루기 편합니다. - 안전장치가 작업을 다른 모델로 보낼 수 있습니다. Cyber Verification Program 밖의 Opus 사이버보안 작업 대부분은 Opus 4.8로 재라우팅됩니다. 생물학 작업에는 Life Sciences 프로그램이 필요합니다(Anthropic). 이런 작업에서는 fallback으로 인해 품질과 할당량이 예상과 달라질 수 있습니다.
워크로드별 추천
| 하려는 작업 | 추천 모델 | 이유 |
|---|---|---|
| 20만 줄 마이그레이션, 여러 저장소 감사, 9시간 에이전트 실행 | Opus 5.5 | 더 높은 에이전트 점수, 원치 않는 재작성 감소, 1M까지 동일한 가격 |
| 하루 10K 티켓, 각 요청 272K 미만, 작은 청크를 사용하는 RAG | GPT-6.1 Sol | 절반 수준의 표시 가격, AutomationBench와 GDP.pdf의 높은 비용 대비 성능 |
| 요청당 272K를 넘는 거대한 단일 검색 | Opus 5.5 또는 Sol을 청크 단위로 사용 | Sol의 surcharge 적용 후 가격 우위가 약 8%까지 줄어듦 |
| PDF 중심 금융·법률 Q&A | Sol부터 테스트 | fallback을 사용한 Opus보다 절반 이하 작업 비용으로 앞선다는 주장. 실제 문서로 검증 필요 |
| $20 좌석 구독자, 대화형 CLI | 둘 다 테스트하되 인용된 보고 기준으로는 Opus | 사용자들은 토큰 계산보다 Sol의 차감이 빠르고 체감 속도도 느리다고 보고 |
모든 상황에 통하는 승자는 없습니다. Sol은 효율을 중시하는 선택이고, Opus는 절제와 자율성을 중시하는 선택입니다. 실용적으로는 계획과 검토를 Opus에 맡기고, 대량 실행은 Sol로 처리하는 구성이 가능합니다.
Opus 5.5 vs GPT-6.1 Sol FAQ
API에서 어느 쪽이 더 저렴한가요?
표시 가격 기준으로는 Sol입니다($2/$10 대 $4/$20, 캐시 읽기 $0.10 대 $0.20). 모든 요청의 입력이 272K를 넘으면 격차는 약 8%까지 줄어듭니다.
코딩 에이전트에는 어느 쪽이 더 좋은가요?
Opus 5.5는 공개된 Terminal-Bench, FrontierCode, CursorBench에서 앞섭니다. Sol은 DeepSWE에서 Astra와 같은 수준을 기록하고, 작업 비용이 3분의 1인 AutomationBench 성과로 맞섭니다.
실제 사용에서는 어느 쪽이 더 빠른가요?
디코딩 속도는 Opus가 우세합니다(약 74~96 tok/s 대 약 29~53). 첫 토큰은 Sol이 약간 빠릅니다. 2026년 10월 Codex 보고에서는 Sol의 전체 작업 속도가 더 느리다는 의견이 많았습니다.
API 모델 ID는 무엇인가요?
gpt-6.1-sol이며, 대부분의 게이트웨이에서 Opus는 claude-opus-5-5 슬러그를 사용합니다.
GPT-6.1 Sol은 일반 ChatGPT에서 사용할 수 있나요?
9월 29일 출시 시점에는 일반 ChatGPT에 제공되지 않았습니다. Work, Codex, API부터 지원됩니다. 접근 권한이 중요하다면 사용 중인 좌석을 다시 확인하세요.
어떤 effort 설정을 써야 하나요?
Opus 5.5는 Max가 아니라 Medium 또는 High에서 시작하세요. Sol은 medium에서 시작한 뒤 재시도가 늘어날 때만 높이는 편이 좋습니다. 두 모델 모두 추론 토큰에는 동일한 토큰당 요금이 적용됩니다(DataCamp 과금 노트).
프롬프트로 해결할 수 없는 트레이드오프
Opus 5.5는 저장소의 기존 구조를 존중하는 대신 생각하는 데 비용을 청구합니다. Sol은 토큰 비용을 낮추지만 검토해야 할 작업과 기다리는 시간을 크게 늘릴 수 있습니다. 조용한 누락 하나가 버그로 배포될 수 있다면 Opus에 비용을 지불하는 편이 낫습니다. 반대로 실패 비용이 낮고 처리량이 가장 중요하다면 272K 이하 요청에서는 Sol의 절약 효과를 활용하세요.