 AIREITER
코딩과 에이전트 작업을 대량으로 돌린다면 Kimi K3.1 Pro는 꽤 공격적인 가격표를 내놨다. 100만 토큰 컨텍스트를 제공하면서 입력 토큰은 100만 개당 $2, 출력 토큰은 $10이다. 아래에서 다룬 출시 첫 주 사용 사례 기준으로는 $39 구독보다 종량제 API가 훨씬 저렴했다.
Kimi K3.1 Pro는 어떤 모델인가
Kimi K3.1 Pro는 Moonshot AI가 2026년 10월 23일 공개한 첫 K3.1 시리즈 모델이다. Kimi K3를 후속 학습한 모델이며, Moonshot은 장기 코딩 작업, 3D·CAD 도구 워크플로, 금융 문서 분석, 여러 단계로 이어지는 에이전트 작업을 겨냥한 3T급 MoE 모델이라고 설명한다.
컨텍스트 윈도우는 1,048,576토큰이다. 입력에 1M, 출력에 별도 1M이 주어지는 구조가 아니라 입력·추론 토큰·출력이 이 한도를 함께 사용한다. Moonshot 제품에서는 텍스트와 이미지, 비디오를 입력할 수 있고, API는 텍스트·코드·도구 호출을 반환한다. 시각 결과물은 Blender, 게임 엔진, PDF 도구 같은 외부 소프트웨어가 만든다. 추론은 항상 활성화되며 reasoning_effort는 low, high, max를 지원하고 기본값은 max다.
Moonshot은 11월 4일까지 가중치를 공개하겠다고 약속했다. 다만 TheQuery가 10월 24일 확인한 시점에는 내려받을 수 있는 체크포인트나 최종 라이선스가 검증되지 않았고, ArtificialWatch 역시 라이선스를 미확인으로 표기했다. 체크포인트와 라이선스가 나올 때까지는 호스팅 API 사용을 전제로 잡는 편이 안전하다.
표준과 Highspeed, 실제 API 과금 방식
Kimi API 플랫폼에서 표준 Kimi K3.1 Pro는 캐시되지 않은 입력 100만 토큰당 $2, 출력 100만 토큰당 $10이다. Kimi K3.1 Pro Highspeed는 사용량 기준 요금이 두 배로 올라 입력 $4, 출력 $20이지만 캐시 입력 읽기 요금은 똑같이 $0.20이다. ArtificialWatch와 AI/ML API 요금표도 동일하게 $2/$10, $4/$20 구성을 제시한다.
| 작업(100만 토큰당) | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| 캐시 미적용 입력 | $2.00 | $4.00 |
| 출력(추론 포함) | $10.00 | $20.00 |
| 캐시 입력 읽기 | $0.20 | $0.20 |
| 캐시 쓰기, 5분 유지 | $2.00 | $4.00 |
| 캐시 쓰기, 1시간 유지 | $4.00 | $8.00 |
표면적인 단가보다 중요한 과금 포인트는 세 가지다. 첫째, 컨텍스트 길이와 무관하게 가격은 동일하며 기본 캐시 유지 시간은 5분이다. 이 시간 안에 프롬프트 접두사를 재사용하면 $2.00 대신 $0.20을 낸다. 둘째, 추론 토큰은 출력 요금으로 청구된다. 따라서 긴 에이전트 실행 기록에 max를 쓰면 비용 대부분이 추론에서 나올 수 있다. 셋째, API 비용은 Kimi 멤버십 및 Kimi Code 구독과 별도다. 또한 TheQuery가 Batch API 가이드를 확인한 결과 K3.1 Pro는 목록에 없었으므로, 배치 할인 적용을 당연하게 가정하면 안 된다.
토큰 수를 고정한 예시로 계산하면 비용은 낮다. 캐시 미적용 입력 100,000토큰($0.20)에 출력 10,000토큰($0.10)을 더하면, 캐시 쓰기·도구·재시도·세금 전 기준 총 $0.30이다.
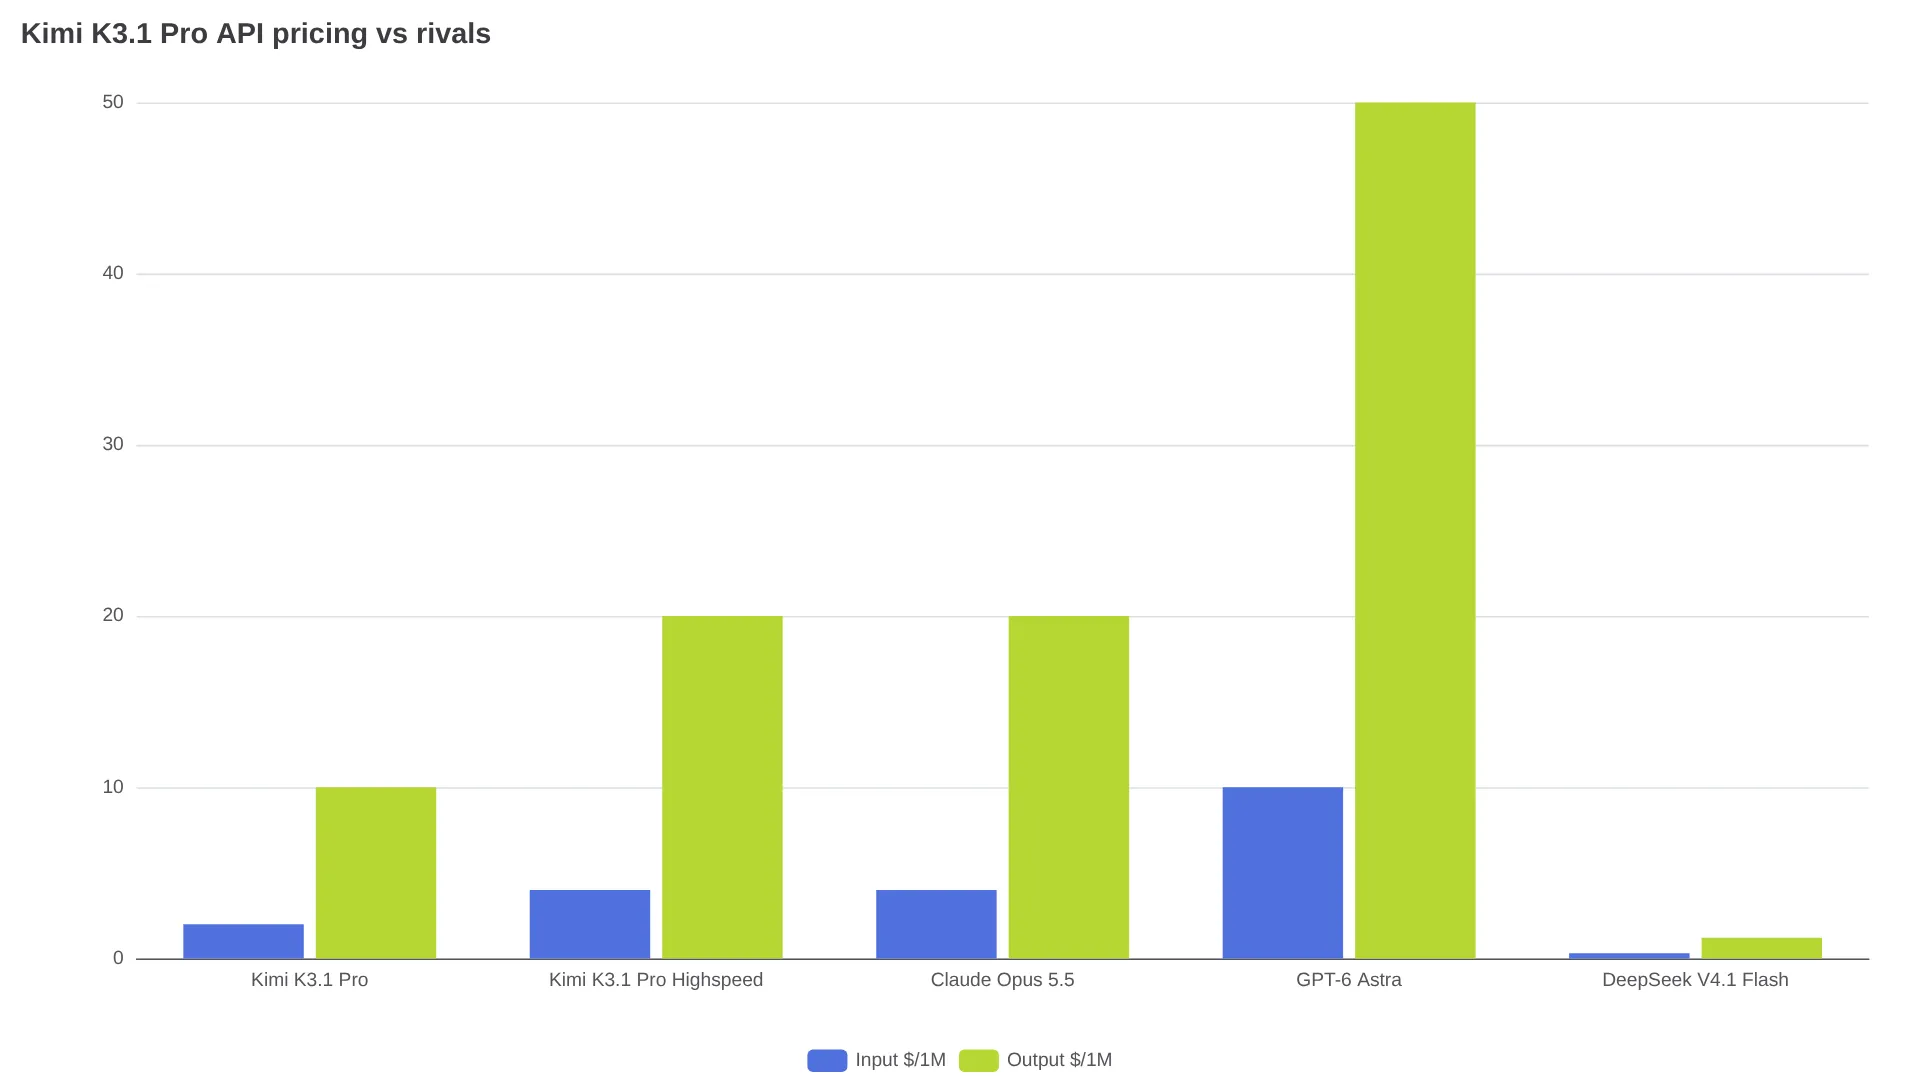
경쟁 모델과 비교하면 표준 K3.1 Pro는 Kimi K3 가격($3/$15)보다 33% 저렴하고, Claude Opus 5.5($4/$20)의 절반 가격이며, ArtificialWatch 비교 기준 GPT-6 Astra($10/$50)의 5분의 1이다. AI/ML API 요금표 기준 DeepSeek V4.1 Flash는 $0.30/$1.20으로 여기 나온 모델 중 가장 저렴하지만, 다음 섹션의 벤치마크 점수는 큰 차이로 뒤처진다. Highspeed는 Opus 5.5와 가격이 정확히 같으므로, 2~3배라는 주장된 속도 향상이 지연 시간에 묶인 작업을 충분히 단축해 두 배 토큰 비용을 상쇄할 때만 의미가 있다.
$39 구독은 빨리 소진되고 API는 다른 이유
출시 당일 API 가격은 합리적으로 보였지만 구독은 그렇지 않았다. 유료 이용자 여러 명은 프롬프트 한두 번 만에 5시간 쿼터가 사라졌고, 코딩 작업 하나로 월간 쿼터가 소진됐다고 보고했다.
"Kimi K3.1 Pro는 지금 세계 최고의 오픈 모델이다. 경쟁 상대가 없다. 하지만 자체 구독으로는 사실상 쓸 수 없다. 나는 $39 플랜을 썼다. ship 테스트를 만들었는데... 월간 쿼터의 11.6%를 먹었다. 즉 이런 건 한 달에 8번 정도만 만들 수 있다는 뜻이다... 최악의 구독 서비스다... 병목은 품질이 아니라 컴퓨트다." — @Da7_Tech, 사용자 보고 쿼터 소모량
"Kimi K3.1 Pro의 사용량 제한은 정말 역겹고 부끄러운 수준이다. 프롬프트를 시작한 지 정확히 1분 만에 내 5시간 한도가 끝났고, 만들어진 것도 없었다!" — @MiaAI_lab, $39 플랜 구독자
한 사용자는 프롬프트 네 번에 구독료로 $400을 썼다고 보고하며 같은 작업을 API로 하면 $29로 추정했다. 또 다른 사용자는 애니메이션 작업 하나가 5시간 쿼터 대부분을 소모했다고 전했다. 개발자에게 시사점은 명확하다. Moonshot, OpenRouter, Vercel AI Gateway의 종량제 API로 K3.1 Pro를 평가하는 편이 낫다. 입력 100k와 출력 10k는 재시도와 도구 비용 전 기준 $0.30이지만, 같은 추론을 훨씬 더 강하게 제한하는 구독 쿼터에서는 그렇지 않다.
벤치마크 수치, 공급사 발표라는 전제
별도 표기가 없는 아래 주요 점수는 모두 Moonshot 발표치다. 최대 추론 강도, temperature 1.0, top-p 0.95에서 실행됐다. AI/ML API가 문서화한 것처럼 경쟁 모델 점수는 서로 다른 하네스에서 수집됐다. Kimi는 Kimi Code, 다른 모델은 Claude Code, OfficeQA의 GPT-6 Astra는 Codex를 사용했으므로 작은 점수 차이는 설정에 따라 달라질 수 있다.
| 평가 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek V4.1 Flash 1017 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | 51.7% | 46.3% | 42.5% | 40.0% |
| Agents' Last Exam v1.1 | 43.2% | 42.6% | 32.8% | 37.7% |
| OfficeQA Pro v2 | 64.4% | 62.2% | 54.4% | 40.4% |
| BenchCAD with tools | 92.7% | 96.2% | 95.9% | 81.6% |
Kimi는 5개 중 3개 평가에서 앞섰다. Terminal-Bench에서는 0.7포인트 뒤지는데, TheQuery가 지적했듯 이는 Anthropic이 Opus에 대해 보고한 2.6포인트 표준오차보다 작은 차이다. BenchCAD의 92.7%는 1,000개 사례로 구성된 오픈 모델 부분집합의 복셀 중첩도다. 또한 AI/ML API의 방법론 메모에 따르면 Claude 수치는 동일 조건 재실행 결과가 아니라 시스템 카드에서 가져온 값이다.
사실성 측면에서 Moonshot의 내부 Kimi Hallu Bench는 표준 세트의 주장 단위 오류율을 K3.1 Pro 5.4%, GPT-6 Astra 4.2%로 보고했다. 도구를 사용한 Hard 세트에서는 각각 8.3%, 5.5%였다. AI/ML API Hallu 표 기준이다. K3의 Hard 오류율 23.4%에서 65% 상대 감소한 수치지만, 두 구간 모두 Astra가 앞선다. 단 하나의 잘못된 주장도 결과물을 망칠 수 있는 작업이라면 Astra를 후보에서 빼지 않는 편이 좋다. 이 수치는 모두 일상적인 오류 확률이 아니라 적대적 스트레스 테스트 결과다.
출시 시점에 나온 유일한 독립 데이터 포인트는 Artificial Analysis의 평가였다. K3.1 Pro는 Intelligence Index에서 55점을 받았고, Claude Opus 5.5, Sonnet 5.5, Muse Wonder Full에 이어 종합 4위에 올랐다. 이는 공급사 자체 측정에만 기대지 않고도 '절반 가격의 프런티어급'이라는 주장을 뒷받침한다.
과금 낭비 없이 API 호출하기
Kimi K3.1 Pro는 OpenAI 호환 API라서 마이그레이션은 base URL과 모델 ID를 바꾸는 수준이다. 공식 base URL은 https://api.moonshot.ai/v1이고 모델 ID는 kimi-k3.1-pro, kimi-k3.1-pro-highspeed다. 이는 TheQuery의 엔드포인트 확인과 AI/ML API 설정 가이드에 따른 것이다. 서드파티 게이트웨이는 Requesty의 moonshot/kimi-k3.1-pro, Vercel의 moonshotai/kimi-k3.1-pro처럼 네임스페이스가 붙은 ID를 쓴다.
TheQuery의 API 동작 메모에 따르면 퀵스타트는 temperature 1.0과 top-p 0.95를 고정하고, 조정하지 말고 아예 생략하라고 안내한다. 비용은 대신 reasoning_effort로 제어하면 된다. 탐색 실행은 low로 시작하고, 작업이 실패할 때 high로 올리며, 최종 실행에만 기본값인 max를 쓰는 방식이다. max_completion_tokens를 8,192토큰으로 잡아도 숨겨진 추론이 같은 예산을 $10/100만 토큰 요금으로 소비하므로, 실제 보이는 답변은 훨씬 짧게 돌아올 수 있다.
AI/ML API의 도구 사용 및 토큰 가이드를 바탕으로 정리한 비용 제어 체크리스트는 다음과 같다.
- 도구 호출 단계 사이에 보조 모델의 메시지 전체를 유지한다. 스트리밍 시에는
reasoning_content도 포함하고, 다음 호출 전에 도구 결과를 반환한다. - 5분 캐시 윈도우 안에서 프롬프트 접두사를 재사용해 반복 입력 비용을 100만 토큰당 $0.20으로 낮춘다.
- 토큰당 비용이 아니라 수용된 결과 하나당 비용을 측정한다.
- 토큰 단가가 낮아도 두 번 재시도해야 한다면 더 저렴한 모델이 아니다.
from openai import OpenAI
client = OpenAI(
    base_url="https://api.moonshot.ai/v1",
    api_key="YOUR_KIMI_KEY",
)
resp = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Refactor this module with tests"}],
    extra_body={"reasoning_effort": "low"},
    max_completion_tokens=8192,
)
print(resp.choices[0].message.content)
TheQuery의 API 동작 확인에 따르면 $1 충전으로 등급별 속도 제한이 적용되는 API 접근 권한을 얻을 수 있으며, 엔터프라이즈 접근은 관리자가 활성화하기 전까지 기본적으로 꺼져 있다. 개인정보 측면에서는 Opper가 Moonshot 경로를 감사한 결과, 해당 경로는 기본적으로 콘텐츠를 보관하고 고객 데이터를 학습에 사용하며 zero-data-retention 옵션도 제공하지 않는다고 보고했다. 계약상 보호 장치 없이 기밀 데이터나 규제 대상 데이터를 이 경로로 보내서는 안 된다.
어떤 경우에 써야 하나: 가격에 반영할 한 가지 트레이드오프
| 필요한 것 | 선택 | 이유 |
|---|---|---|
| 가장 저렴한 프런티어급 코딩 실행 | Kimi K3.1 Pro API | Opus 절반 가격에 SWE-Marathon 선두, 1M 공유 컨텍스트 |
| 최저 지연 시간 | Kimi K3.1 Pro Highspeed | 2~3배 속도 향상 주장, 단 토큰 비용은 정확히 2배 |
| 가장 적은 사실 오류 | GPT-6 Astra | 표준 Hallu 4.2% 대 5.4%, 가격은 5배 |
| 가장 저렴한 토큰, 낮은 점수 | DeepSeek V4.1 Flash | $0.30/$1.20이지만 제시된 5개 벤치마크 중 4개에서 최저점 |
| 셀프 호스팅 | 기다리기 | 11월 4일 가중치 공개 약속, 라이선스는 미확인 |
Moonshot이 11월 4일까지 허용적인 라이선스로 전체 가중치를 공개한다면 셀프 호스팅은 쿼터와 API 비용의 계산법을 바꿀 수 있다. 장문 컨텍스트 코딩 모델을 비교하는 개발자라면 도입을 결정하기 전에 best LLM for coding agents in 2026도 확인할 만하다.
Kimi K3.1 Pro API FAQ
Kimi K3.1 Pro API 가격은 얼마인가?
표준 Kimi K3.1 Pro는 캐시 미적용 입력 100만 토큰당 $2, 출력 100만 토큰당 $10이며, 캐시 입력 읽기는 100만 토큰당 $0.20이다. Highspeed는 입력·출력·캐시 쓰기 요금을 두 배로 적용하지만 캐시 읽기 가격은 $0.20으로 동일하다.
K3.1 Pro와 Highspeed의 차이는 무엇인가?
Highspeed는 동일한 지능을 입력·출력 가격 두 배($2/$10 대비 $4/$20)에 2~3배의 서빙 속도로 제공한다고 홍보한다. Vercel의 실시간 공급자 표는 Highspeed의 낮은 지연 시간과 높은 처리량을 제시하지만, Moonshot의 속도 향상 주장을 뒷받침하는 독립적인 작업 완료 시간 비교는 없다.
API 모델 ID는 무엇인가?
공식 Kimi API에서는 kimi-k3.1-pro와 kimi-k3.1-pro-highspeed를 사용한다. 서드파티 게이트웨이에서는 moonshot/kimi-k3.1-pro 같은 네임스페이스 ID를 쓴다. 기존 K3 연동은 ID를 명시적으로 변경해야 한다.
Kimi 멤버십에 API 사용량이 포함되나?
아니다. API 비용은 Kimi 멤버십과 Kimi Code 구독에서 분리돼 있다. 출시 첫 주 이용자들은 같은 작업이라도 구독 쿼터가 종량제 토큰보다 훨씬 제한적이었다고 보고했다.
추론을 끌 수 있나?
안 된다. Kimi K3.1 Pro는 항상 추론한다. low, high, max는 숙고 수준만 조절하며 기본값은 max다. 짧고 추론이 필요 없는 요청에는 다른 모델을 써야 한다.
API는 OpenAI와 호환되나?
그렇다. OpenAI SDK 클라이언트의 엔드포인트를 https://api.moonshot.ai/v1(또는 게이트웨이 base URL)로 지정하고 모델 ID를 설정한 뒤 stream=True로 스트리밍하면 된다. 퀵스타트에서 temperature 1.0과 top-p 0.95는 고정값이다. 대신 reasoning_effort와 max_completion_tokens를 조정해야 한다.