 AIREITER
이번 주에 자체 호스팅용 체크포인트가 필요하다면 선택지는 사실상 하나다. MiniMax M3.1 Flash 오픈 웨이트는 지금 바로 내려받을 수 있지만, Kimi K3.1 Pro 웨이트는 아직 공개되지 않았다. Moonshot은 2026년 11월 4일까지 공개하겠다고 밝혔으므로, 현재 Hugging Face에서 직접 받을 수 있는 모델은 두 제품 중 MiniMax뿐이다.
현재 Hugging Face에서 받을 수 있는 웨이트는 MiniMax뿐
MiniMax는 2026년 10월 22~23일경 Hugging Face에 minimax-community 라이선스로 M3.1 Flash 웨이트를 공개했다. 출시 보도에 따르면 ModelScope에서도 제공된다(Cocoloop). 반면 Kimi 공식 기술 블로그는 Kimi K3.1 Pro를 현재 Kimi.com, 앱, Kimi Code, Kimi API에서 사용할 수 있다고 안내하며, 전체 모델 웨이트는 2026년 11월 4일까지 공개한다고 명시했다(kimi.com).
MiniMax M3.1 Flash와 Kimi K3.1 Pro 사양 비교
MiniMax M3.1 Flash 오픈 웨이트는 전체 약 4,280억 개, 토큰당 활성화 230억 개 파라미터를 갖춘 네이티브 멀티모달 MoE다. 텍스트·이미지·비디오를 입력받아 텍스트를 생성하며, 컨텍스트는 최대 100만 토큰이다(MiniMax 출시 글). Kimi K3.1 Pro는 공식적으로 3T급 MoE와 100만 토큰 컨텍스트 윈도우를 내세운다(kimi.com). 다만 전체 2.8T, 활성화 104B라는 수치는 Moonshot의 공식 파라미터 공개가 아니라 출시 보도에서 나온 정보다(ArtificialWatch, ExplainX).
| 항목 | MiniMax M3.1 Flash | Kimi K3.1 Pro |
|---|---|---|
| 전체 / 활성화 파라미터 | 약 428B / 토큰당 23B | 3T급; 출시 보도에서는 2.8T / 활성화 104B로 언급 |
| Hugging Face 저장소 | MiniMaxAI/MiniMax-M3.1-Flash, 공개됨 | 2026년 10월 24일 기준 없음; 11월 4일까지 공개 예정 |
| 다운로드 크기 | 약 252GB | 미확인; MiniMax 수준의 밀도(파라미터 B당 약 0.59GB)라면 2.8T 체크포인트는 TB급 |
| 컨텍스트 | 최대 100만 토큰(배포 환경에 따라 다름) | 100만 토큰 |
| 입력 / 출력 | 텍스트·이미지·비디오 입력, 텍스트 출력 | 멀티모달, 텍스트 출력; 자체 호스팅 시 정확한 모달리티는 미확인 |
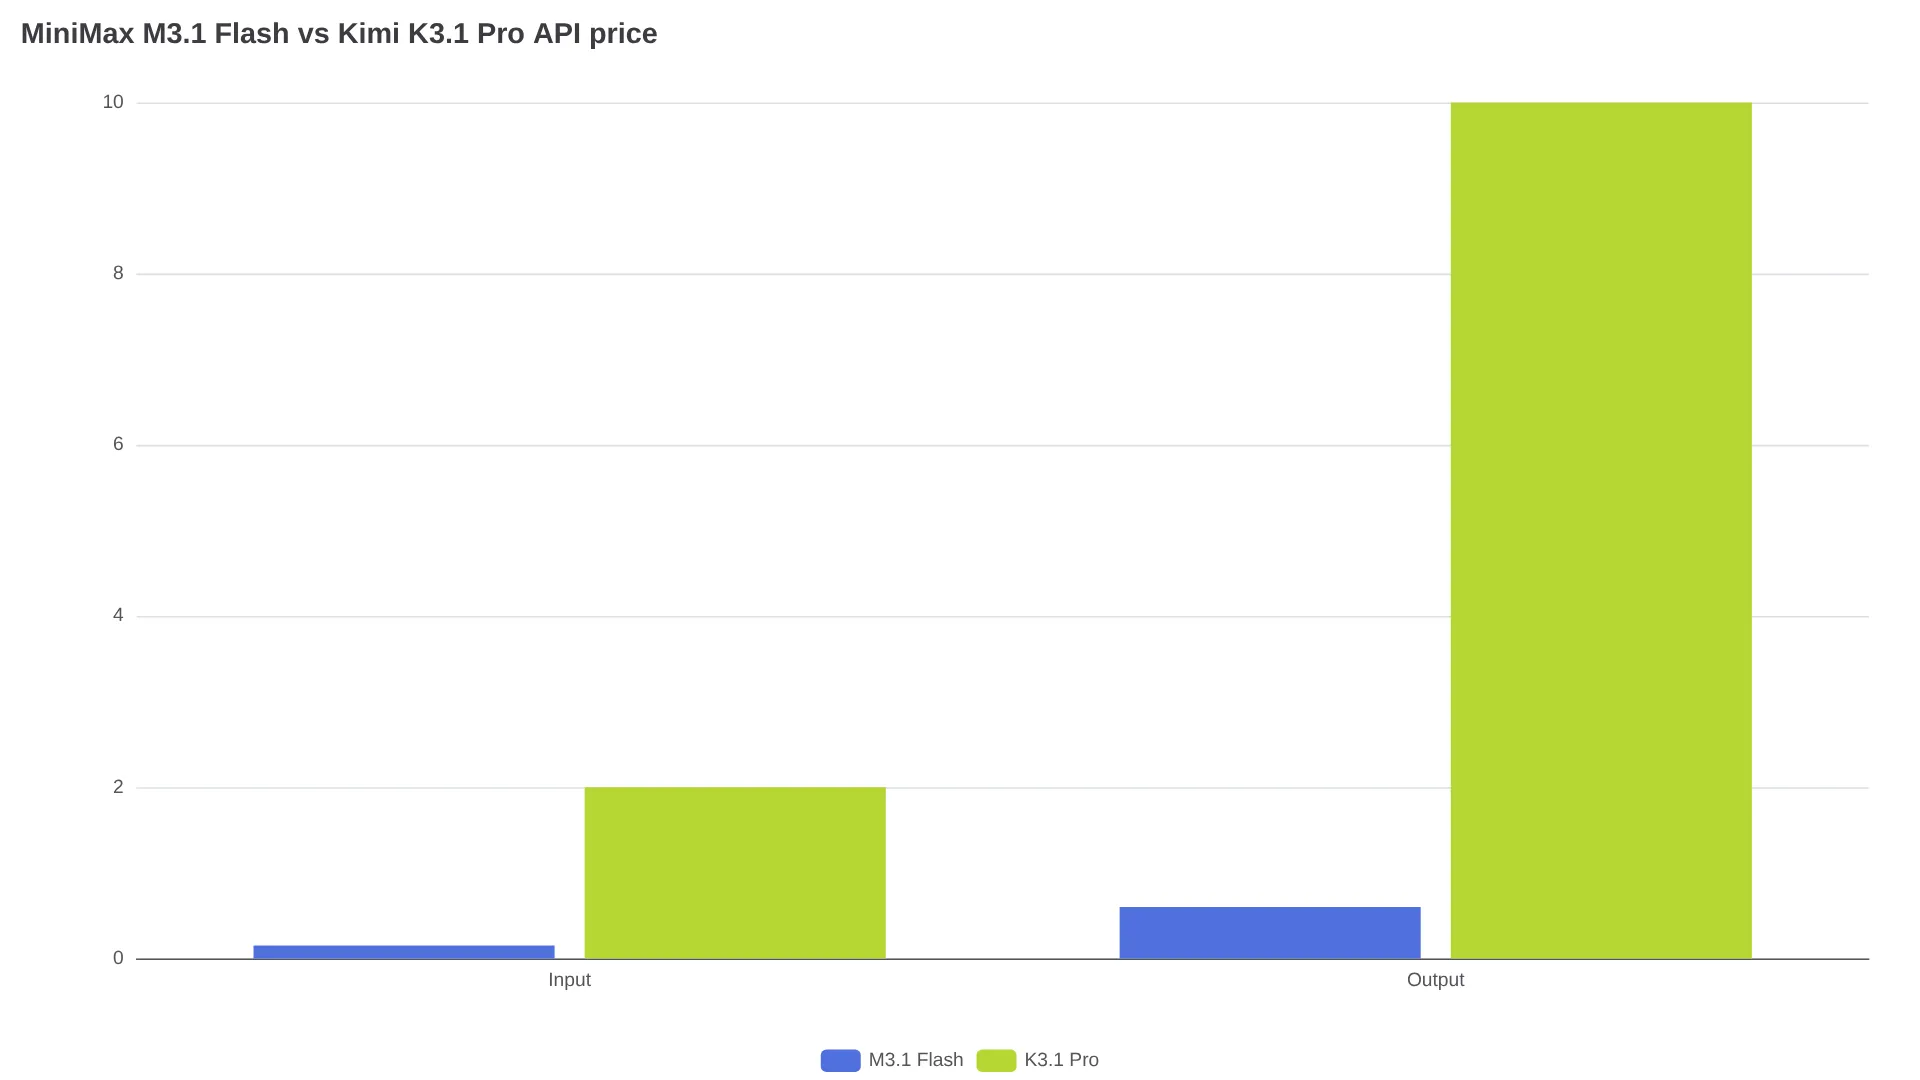
| 공식 API 가격 | 100만 토큰당 입력 $0.15 / 출력 $0.60 / 캐시 $0.015 (MiniMax) | 100만 토큰당 입력 $2 / 출력 $10으로 보도됨 (ArtificialWatch) |
| 서빙 레시피 | SGLang, vLLM, TokenSpeed, 멀티칩용 FlagOS | 미발표; API 모델 ID는 kimi-k3.1-pro / kimi-k3.1-pro-highspeed (Kimi 문서) |
| 권장 샘플링 | Temperature 1.0, top-p 0.95; 추론 low~max | Kimi 벤치마크 설정 기준 최대 추론 노력, temp 1.0, top-p 0.95 |
MiniMax 체크포인트는 공식 명령어로 내려받을 수 있다.
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash벤치마크를 시작하기 전 전체 파일 세트와 DSpark draft head, 토크나이저, 설정 파일이 모두 있는지 확인해야 한다. MiniMax는 공식 웨이트 기준의 결과이며, 서드파티 양자화 버전에서는 결과가 달라질 수 있다고 경고한다.
아래 벤치마크 수치는 별도 표기가 없는 한 벤더가 제시한 결과로 봐야 한다.
| 벤치마크 | M3.1 Flash (벤더 제공) | 벤더가 인용한 경쟁 모델 |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | DeepSeek V4.1 Flash-1017: 60.5 |
| BankerToolBench | 76.2 | Opus 5: 76.2 (동점) |
| LOCA-Bench 256K | 60.3 | GPT-5.6 Sol: 60.0 |
| DeepSWE v1.1 | 73.7 | DeepSeek V4.1 Flash-1017: 77.0 |
| OSWorld 2.0 | 61.7 | Opus 5: 70.6 |
| Terminal-Bench 4.0 | 38.1 | Opus 5: 51.8 |
인용된 한 독립 평가 스냅샷에서 M3.1 Flash는 53.78%(26개 중 16위)로 중위권에 머물렀고, 장기 작업 점수는 약한 편이었다(Vals). Kimi 자체 차트는 K3.1 Pro가 Agents' Last Exam(43.2), SWE Marathon(51.7)을 포함해 제시된 14개 테스트 중 6개에서 선두라고 주장하며, Terminal-Bench 4.0 점수는 65.7로 제시한다.
252GB 모델을 직접 호스팅할 때의 비용
저장소 크기는 약 252GB다. 4비트 기준으로 계산하면 4,280억 개 파라미터만 약 214GB를 차지하며, 여기에 KV 캐시와 런타임 버퍼는 포함되지 않는다. 실사용 가능한 컨텍스트를 확보하려면 80GB급 GPU 여러 장을 계획하는 편이 맞다. NVIDIA의 RTX Spark 계정은 로컬 실행 환경으로 DGX Station 또는 4x DGX Spark 128GB 클러스터를 언급했고(X 게시물), X의 자체 호스팅 사용자들도 252GB 다운로드와 이 정도의 하드웨어 요구 사항이면 일반 데스크톱은 대상이 아니며 API는 저렴하다고 지적했다(@bufcapy).
먼저 API 비용부터 계산해 보는 것이 좋다. MiniMax API는 유난히 저렴하기 때문이다. 100만 토큰당 입력 $0.15, 출력 $0.60이라면 하루에 입력 1,000만 토큰과 출력 200만 토큰을 쓰는 비용은 10 × $0.15 + 2 × $0.60 = $2.70, 한 달로는 약 $81이다.
손익분기점은 월간 클러스터 비용을 토큰당 API 비용으로 나누면 된다. 입력 100만 토큰당 $0.15 기준으로 월 임대료 $150은 입력 10억 토큰과 같고, 출력 100만 토큰당 $0.60 기준으로 월 $600은 출력 10억 토큰과 같다. 실제 임대 견적과 엔지니어링 시간을 넣어 계산해야 한다. 이 요금 기준의 월간 API 청구액이 그 총비용을 넘거나, 정책상 웨이트를 자체 경계 안에 둬야 할 때에만 자체 호스팅의 경제성이 생긴다. Kimi는 차이가 더 크다. 보도된 100만 토큰당 $2/$10 API 가격은 MiniMax보다 입력 약 13배, 출력 약 17배 수준이다. 따라서 향후 2.8T 파라미터 체크포인트를 직접 운영하려면 TB급 스토리지와 멀티노드 클러스터를 정당화할 만큼 매우 높은 지속 처리량이 필요하다.
공개 첫날부터 가능한 자체 호스팅 범위
출시 당일 프레임워크 지원은 실제로 제공되지만 완전하지는 않다. 모델 카드는 SGLang, vLLM, TokenSpeed와 멀티칩 배포용 FlagOS를 명시하고 SGLang용 Docker 이미지도 제공한다. 다만 Transformers, KTransformers, unsloth, ATOM 연동은 출시 시점에도 진행 중이었다. 한 배포자는 vLLM H100/H200 예제 설정이 전체 100만 토큰이 아니라 256K 토큰을 대상으로 하며, 비디오 입력은 꺼져 있고 DSpark speculative decoding도 활성화되지 않았다고 전했다(@sancaksofttech). 같은 웨이트를 받아도 모든 환경에서 모든 기능을 쓸 수 있는 것은 아니다.
r/LocalLLaMA에서는 “Flash”가 작은 모델 크기가 아니라 추론 비용 효율을 의미한다는 우려가 반복해서 나왔다.
양자화하면 256GB에 들어갈 수 있을까요? 제발요 — u/BawbbySmith, r/LocalLLaMA
하드웨어보다 먼저 확인할 라이선스 조항
M3.1 Flash는 오픈소스가 아니라 오픈 웨이트다. 저장소의 LICENSE(minimax-community로 표기, LICENSE 파일 참조)는 비상업적 사용을 자유롭게 허용한다. 상업적 사용 시에는 "Built with MiniMax M3.1-Flash"를 눈에 띄게 표시하고 MiniMax에 일회성 통지를 보내야 한다. 연간 매출이 $20M을 넘는 조직 또는 제품은 사전 서면 승인이 필요하며, 군사 용도는 금지된다.
내부 도구에는 부담이 크지 않지만, 배지 표기와 매출 기준을 충족하기 어려운 상업적 호스팅에는 사실상 걸림돌이 될 수 있다. Kimi의 라이선스는 11월 4일 웨이트가 공개되기 전까지 알 수 없다. 또한 Moonshot은 기술 블로그에서 사이버 관련 학습 데이터를 오픈 웨이트에서 제거했기 때문에 공개 체크포인트가 API 모델과 다를 것이라고 이미 밝혔다(kimi.com). 구축에 들어가기 전에 두 모델의 LICENSE 파일을 모두 읽어야 한다.
상황별 선택 가이드
| 상황 | 추천 |
|---|---|
| 이번 주 안에 로컬 평가, 파인튜닝 베이스 또는 에어갭 배포용 웨이트가 필요함 | MiniMax M3.1 Flash — 둘 중 유일하게 지금 다운로드 가능 |
| 부하 변동이 있는 비용 민감형 코딩 에이전트 | MiniMax API($0.15/$0.60) — 지속적으로 높은 사용량이 될 때만 자체 호스팅 고려 |
| 프런티어급 장기 코딩 작업이 목표이고 기다릴 수 있음 | 지금 Kimi K3.1 Pro API를 평가하고, 11월 4일 웨이트·라이선스·실제 크기가 공개된 뒤 자체 호스팅 결정 |
| 상업용 호스팅 제품 | 우선 법무 검토를 통해 MiniMax의 출처 표기 및 $20M 승인 조건을 확인; Kimi는 라이선스 공개 전까지 판단 불가 |
| 소비자용 GPU 또는 단일 Mac | 검증된 단일 기기 레시피가 인용되지 않음 — 지원되지 않는 구성을 테스트할 준비가 없다면 API 사용 |
FAQ
MiniMax M3.1 Flash 공식 웨이트는 어디에서 내려받나?
공식 저장소는 Hugging Face의 MiniMaxAI/MiniMax-M3.1-Flash이며, ModelScope 미러도 있다. hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash 명령으로 받을 수 있다.
공식 Kimi K3.1 Pro Hugging Face 저장소가 있나?
없다. 2026년 10월 24일 기준으로 공개된 K3.1 Pro 웨이트 저장소는 없으며, Moonshot 기술 블로그는 2026년 11월 4일까지 전체 웨이트를 공개하겠다고 약속했다.
MiniMax M3.1 Flash를 상업적으로 사용할 수 있나?
가능하지만 조건이 있다. "Built with MiniMax M3.1-Flash"를 표시하고, 일회성 통지를 보내며, 연간 매출 $20M 이상에서는 사전 서면 승인을 받아야 한다. 군사 용도는 금지된다. 법률 자문과 함께 저장소 LICENSE를 확인해야 한다.
소비자용 GPU나 Apple Silicon에서 실행할 수 있나?
인용된 배포 가이드에는 검증된 단일 소비자 GPU 구성은 없다. 추정상 양자화 웨이트와 KV 캐시를 위해 80GB GPU 여러 장이 필요하다. NVIDIA는 DGX Station 또는 4x DGX Spark 128GB 클러스터를 언급한다.
지금 vLLM이나 SGLang에서 동작하나?
둘 다 출시 당일 레시피가 제공되며, 멀티칩 실행용 TokenSpeed와 FlagOS도 있다. 다만 예제 설정은 컨텍스트를 256K로 제한하거나 비디오 입력을 끄고 DSpark를 비활성화할 수 있으므로, 사용 하드웨어에 맞는 최신 모델 카드 레시피를 확인해야 한다.
자체 호스팅에서도 100만 토큰 전체 컨텍스트를 쓸 수 있나?
광고된 최대치는 100만 토큰이지만, 실제 사용 가능한 길이는 GPU 메모리와 서빙 구성에 달려 있다. 장문 컨텍스트 워크로드에서는 KV 캐시 여유 공간을 별도로 계산해야 한다.
관련 글: MiniMax M3.1 Flash 오픈 웨이트: 다운로드, 실행, 비용 가이드, Kimi K3.1 Pro API 가격 가이드, Kimi K3 오픈 웨이트