 AIREITER
파일을 읽고, 테스트를 실행하고, 수정과 재시도를 반복하는 코딩 에이전트는 이슈 하나를 해결하는 데 5만~20만 토큰을 쓴다. GPT-5.6 Sol의 출력 토큰 가격은 100만 토큰당 $30이므로, 출력 비용만으로도 작업 1건에 $1.50~$6이 든다. 반면 DeepSeek V4 Pro의 출력 가격은 100만 토큰당 $0.87로, 비용만 보면 약 1/34 수준이다. 다만 다단계 작업의 신뢰성은 Claude나 GPT만큼 깊이 있게 독립 검증되지 않았다. 아래에서는 공개 코딩 벤치마크, 2026년 8월 기준 확인된 API 가격, 컨텍스트 한도, 그리고 에이전트 워크플로별 적합성을 기준으로 6개 모델을 비교한다.
2026년 코딩 에이전트 LLM 6종 비교
각 모델은 공식 자료 또는 리더보드의 벤치마크 수치와 2026년 8월에 확인한 API 가격을 함께 정리했다. 순위에 포함한 정확한 모델의 공개 점수가 없을 때는 가장 가까운 변형 모델의 수치를 대체 지표로 사용했으며, 해당 사실을 명시했다.
1. Claude Opus 5 — 품질을 최우선으로 할 때
Claude Opus 5는 공식 SWE-bench Verified 리더보드에서 Claude 계열의 강세를 이어가고 있다. 전작인 Claude 4.5 Opus는 mini-SWE-agent 하니스에서 76.8%를 기록했다. Opus 5의 SWE-bench Verified 점수는 아직 공개되지 않았지만, 이 수치는 예상 성능 등급을 가늠할 만한 대체 지표다. Opus 5는 100만 토큰 컨텍스트 윈도우와 최대 128K 토큰 출력을 제공한다. 가격은 입력 100만 토큰당 $5, 출력 100만 토큰당 $25로 여기서 다루는 일반적인 선택지 가운데 가장 비싸다. 여러 파일에 걸친 리팩터링이 실패했을 때 드는 사람의 시간이 토큰 비용보다 큰 환경이라면 Opus 5가 맞다. 반대로 대량의 반복적 수정 작업에는 적합하지 않다.
2. GPT-5.6 Sol — 터미널 작업에 강한 모델
GPT-5.6 Sol(모델 ID gpt-5.6-sol)은 입력 100만 토큰당 $5, 출력 100만 토큰당 $30이며 컨텍스트 윈도우는 105만 토큰이다. xAI의 공개 벤치마크 비교에 따르면 GPT-5.6 Sol Max는 Terminal-Bench v3.0에서 34.6%로 선두를 기록했다. Grok 4.6의 26%보다 높은 수치다. DeepSWE v1.1에서도 73%를 기록했다. 두 벤치마크 모두 터미널 중심 에이전트 루프와 특히 관련성이 높다. 대가는 출력 100만 토큰당 $30이라는 가격으로, Sol은 이 목록에서 가장 비싼 모델이다. OpenAI는 Sol의 SWE-bench Pro 점수를 64.6%, 중간급 변형 모델인 Terra의 점수를 63.4%로 보고했다. 부담이 덜한 작업에 더 저렴한 OpenAI 모델을 찾는 경우 참고할 만하다.
3. Grok 4.6 — 장시간 에이전트의 가성비 선택
2026년 8월 12일 출시된 Grok 4.6은 장시간 실행되는 에이전트 워크플로를 겨냥한 모델이다. xAI 발표에 따르면 Artificial Analysis Intelligence Index에서 GPT-5.6 Sol Max와 61점으로 동률을 이뤘고, CursorBench v3.2에서는 69.9% 대 67.2%, FrontierCode v1.1에서는 61.3% 대 60.6%, APEX-Agents에서는 57.5% 대 56.7%로 앞섰다. 가격은 입력 100만 토큰당 $2, 출력 100만 토큰당 $6으로, GPT-5.6 Sol Max와 비슷한 벤치마크 성능을 출력 비용 약 5분의 1에 제공한다. 약점은 순수 터미널 실행 능력이다. Terminal-Bench v3.0 점수는 26%로 Sol Max의 34.6%에 크게 못 미친다. 에이전트가 터미널 우선이 아니라 IDE 중심, 예를 들어 Cursor나 Grok Build 중심으로 동작한다면 Grok 4.6은 이 목록에서 품질 대비 가격이 가장 좋은 선택지다. 더 낮은 지연 시간을 위한 "fast" 변형은 가격이 $4/$12로 두 배가 된다. 컨텍스트 윈도우는 500K 토큰이다.
4. DeepSeek V4 Pro — 비용을 낮춘 주력 모델
DeepSeek V4 Pro는 API로 이용 가능한 프런티어급 모델 중 가장 저렴하다. 입력은 100만 토큰당 $0.435, 출력은 $0.87이며 캐시된 입력은 100만 토큰당 $0.003625까지 내려간다. 100만 토큰 컨텍스트 윈도우와 최대 384K 토큰 출력은 저장소 단위 작업에도 충분한 수준이다. DeepSeek V4 Pro를 Claude나 GPT와 동일한 하니스 깊이에서 비교한 공개 다단계 에이전트 벤치마크는 없다. 따라서 복잡한 리팩터링에 투입하기 전에는 실제 환경에서 긴 세션의 도구 호출 신뢰성을 검증해야 한다. 예산이 제한된 팀이나 라우팅 구성의 1차 처리 모델로는 경제성이 매우 뛰어나다. 다만 토큰 비용보다 신뢰성이 중요한 가장 어려운 다중 파일 리팩터링에서는 상위 모델로 넘길 가능성을 염두에 둬야 한다.
5. Gemini 3.1 Pro — 대규모 컨텍스트 분석용
Google의 Gemini 3.1 Pro Preview는 200K 토큰 미만 프롬프트에서 입력 100만 토큰당 $2, 출력 100만 토큰당 $12다. 이 임계값을 넘으면 $4/$18로 오른다. 가장 눈에 띄는 강점은 컨텍스트 용량이다. Gemini의 200만 토큰 컨텍스트 윈도우는 여기 소개한 모델 가운데 가장 크며, 코드베이스 전체를 한 번에 넣어 읽는 저장소 단위 분석에 적합하다. 3.1 Pro의 예상 등급을 가늠하는 대체 지표로, Gemini 3 Flash는 Tembo의 2026년 6월 스냅샷에서 SWE-bench Verified 75.8%를 기록했다. Claude 4.5 Opus 다음으로 높은 점수다. Gemini의 긴 에이전트 루프에서의 도구 호출 일관성은 Claude나 GPT만큼 깊이 검증되지 않았으므로, 다단계 워크플로에 배포하기 전 자체 하니스에서 테스트하는 편이 좋다.
6. Kimi K3 — 오픈 웨이트 에이전트 선택지
Moonshot AI의 Kimi K3는 같은 2026년 6월 스냅샷에서 SWE-bench Verified 70.8%를 기록했다. 오픈 웨이트 모델 중에서는 GLM-5의 72.8%, MiniMax M2.5의 75.8%보다 낮다. 오픈 웨이트 모델인 만큼 코드를 네트워크 밖으로 보낼 수 없는 팀도 자체 호스팅할 수 있다. Moonshot의 호스팅 API에서도 K3를 제공하지만, 구체적인 가격은 배포 구성에 따라 달라진다. 충분한 GPU 하드웨어를 갖춘 로컬 에이전트 환경이라면 Kimi K3와 OpenCode 같은 경량 하니스를 조합해 토큰당 API 비용 없이 충분히 유능한 코딩 에이전트를 구성할 수 있다.
API 가격과 이슈 1건당 예상 비용
토큰 단가만으로는 충분하지 않다. 실제로 중요한 지표는 에이전트 루프를 통해 GitHub 이슈 하나를 해결하는 데 드는 비용이다.
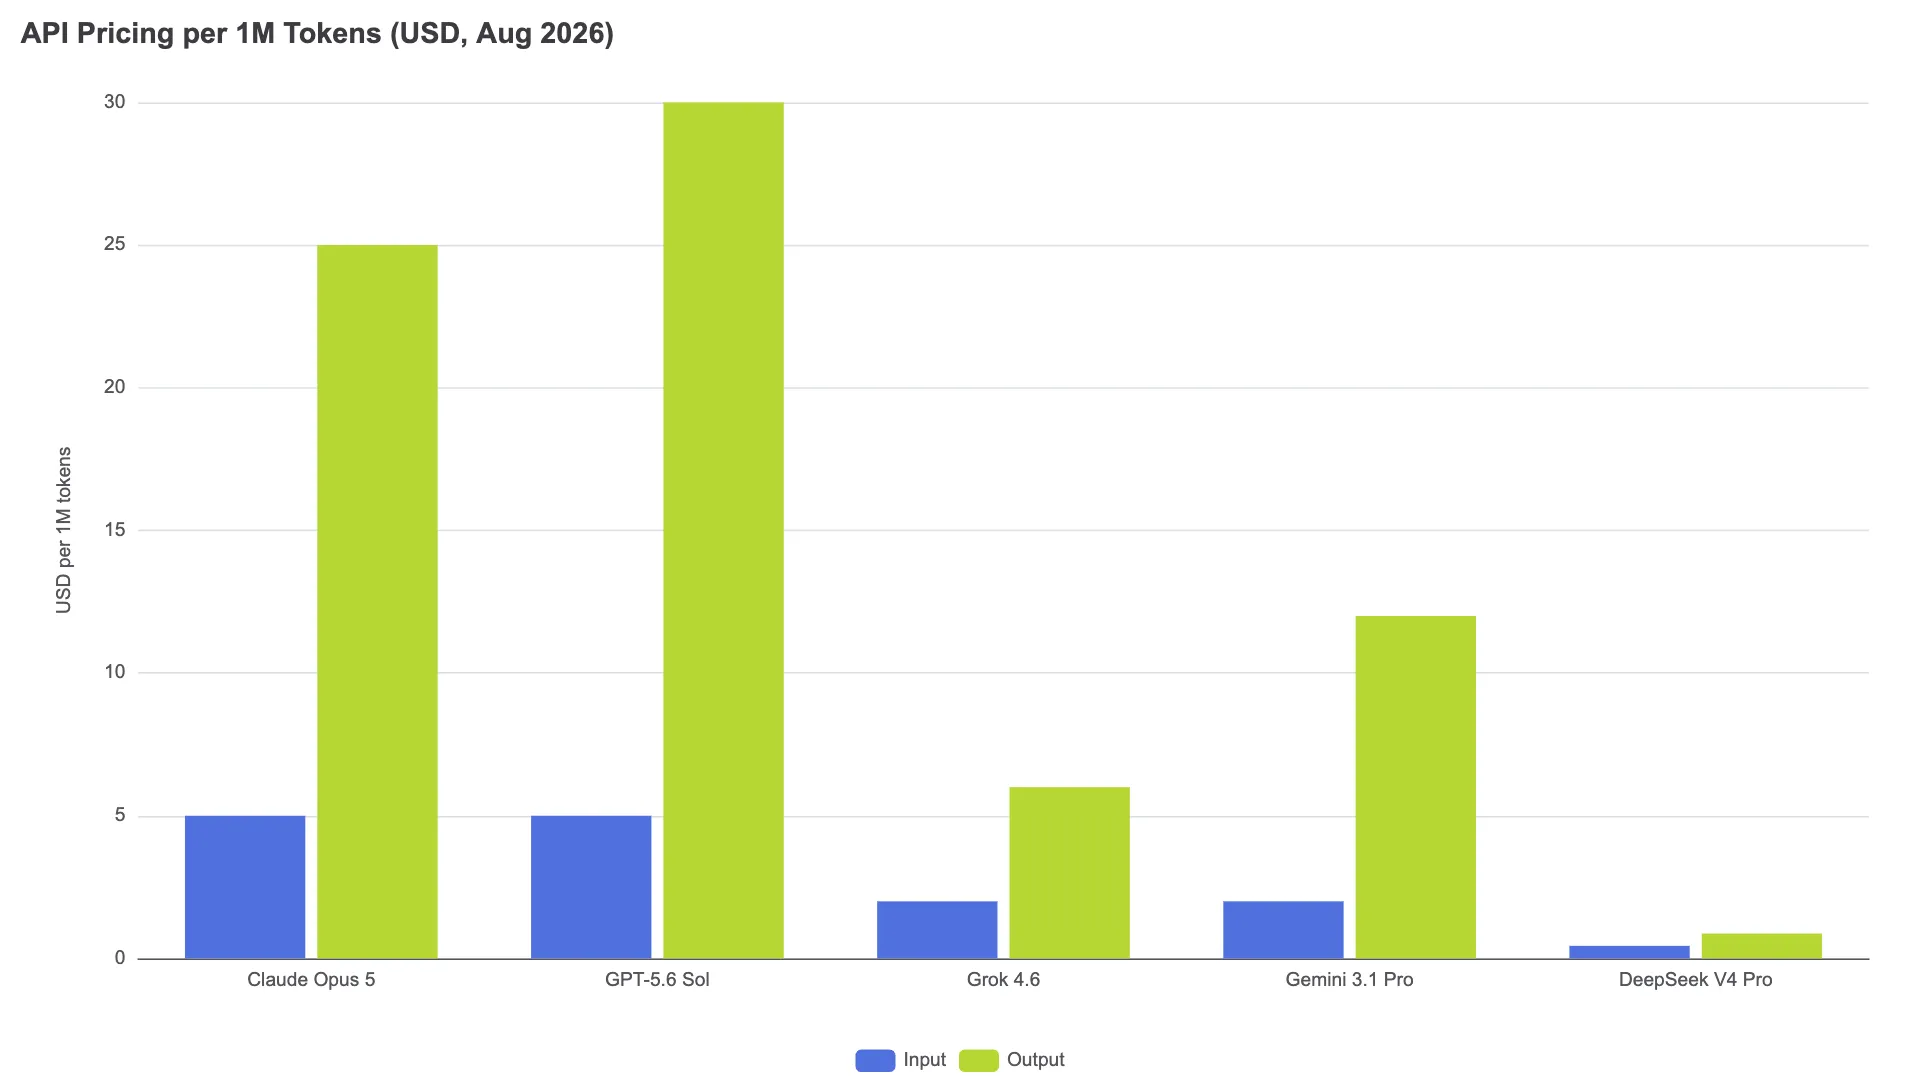
파일 읽기, 계획 수립, 수정, 테스트 실행, 실패 수정으로 이어지는 일반적인 에이전트 루프는 해결된 이슈 1건당 대략 50K~200K 토큰을 소비하며, 이 중 출력은 전체 토큰의 30~50%를 차지한다. 이 수치는 Tembo의 에이전트 루프 분석 등을 바탕으로 한 업계 추정치다. 실제 사용량은 저장소 크기, 테스트 스위트 길이, 하니스 효율에 따라 달라진다. 총 125K 토큰의 중간값, 즉 입력 75K와 출력 50K를 기준으로 계산한 이슈 1건당 비용은 다음과 같다.
| 모델 | 입력 비용 | 출력 비용 | 작업당 합계 |
|---|---|---|---|
| Claude Opus 5 | $0.375 | $1.25 | $1.63 |
| GPT-5.6 Sol | $0.375 | $1.50 | $1.88 |
| Grok 4.6 | $0.15 | $0.30 | $0.45 |
| Gemini 3.1 Pro | $0.15 | $0.60 | $0.75 |
| DeepSeek V4 Pro | $0.033 | $0.044 | $0.077 |
Kimi K3는 Moonshot의 호스팅 API를 쓸지, 자체 GPU에서 호스팅할지에 따라 비용이 완전히 달라지므로 표에서 제외했다. 비교할 수 있는 단일 정가가 없기 때문이다. Grok 4.6은 작업당 $0.45로, GPT-5.6 Sol Max와 Artificial Analysis Intelligence Index 점수가 같으면서 Sol의 작업당 비용은 약 4분의 1에 그친다.
이 추정치에는 재시도, 캐시 토큰 할인, 도구 호출 오버헤드, 인프라 비용이 포함되지 않았다. 재시도나 사람의 수정이 더 많이 필요한 모델은 토큰 단가가 낮아도 실전 비용이 더 커질 수 있다. 따라서 단일 모델에 고정하기보다 일상 작업은 DeepSeek이나 Grok으로 보내고, 어려운 리팩터링은 Opus로 올리는 라우팅 방식이 더 나은 결과를 낼 수 있다.
코딩 에이전트 워크플로별 추천 모델
모든 워크플로에 맞는 단일 모델은 없다. 에이전트 작업 유형별로 어떤 모델을 연결하면 좋은지 정리했다.
빠른 반복 작업과 일상적인 수정. 오류 설명, 작은 함수 추가, 테스트 스텁, 문서 업데이트처럼 빈도가 높고 위험이 낮은 작업에는 Gemini 3.5 Flash(100만 토큰당 $1.50/$9) 또는 Claude Sonnet 5를 사용한다.
심층 리팩터링과 아키텍처 작업. 여러 파일 변경, 모듈 간 의존성, 잘못된 판단이 몇 시간의 디버깅으로 이어질 수 있는 아키텍처 결정이 포함된다면 Claude Opus 5가 적합하다. 긴 세션에서의 정확한 지시 이행과 안정적인 컨텍스트 일관성이 핵심 차별점이다.
장시간 실행되는 자율 에이전트. Grok 4.6은 바로 이 용도를 위해 설계됐다. xAI 발표에 따르면 개발 과정에서 자체 점검 행동을 포함한 지속적인 에이전트 궤적에 집중했다. 작업당 $0.45이므로 GPT-5.6 Sol의 작업당 $1.88이 주는 비용 부담 없이 더 오래 실행할 수 있다. 다만 터미널 비중이 높은 워크플로라면 Terminal-Bench 선두인 GPT-5.6 Sol의 34.6%가 더 안전한 선택이다.
예산 우선과 자체 호스팅. 비용에 민감한 팀이라면 작업당 $0.077인 API 기반 DeepSeek V4 Pro가 기본 선택지다. 외부 API로 코드를 보낼 수 없는 조직은 Kimi K3(SWE-bench Verified 70.8%)나 MiniMax M2.5(75.8%) 같은 오픈 웨이트 모델을 자체 호스팅할 수 있다. 오픈 웨이트 모델 진영은 SWE-bench Verified 기준으로 폐쇄형 선두 모델과의 격차를 수 퍼센트포인트 이내까지 좁혔다.
모델만 바꿔서는 안 되는 이유: 하니스의 한계
Claude Code, Codex CLI, Cursor, OpenCode 같은 오픈소스 도구처럼 에이전트가 사용하는 하니스는 모델이 직접 통제할 수 없는 네 가지를 결정한다. 컨텍스트 관리(언제 압축하고 무엇을 남길지), 도구 정의와 라우팅, 오류 복구 패턴, 검토 및 승인 흐름이다. Tembo의 분석이 지적하듯, mini-SWE-agent 같은 통제된 하니스에서 나온 모델의 벤치마크 점수는 구성이 다른 실제 환경에서의 해결률과 다를 수 있다. 이 때문에 모델과 하니스의 향상을 뒤섞은 벤더 발표 점수보다, 하니스를 동일하게 고정한 벤치마크가 모델 비교에 더 유용하다.
모델을 교체하기 전에 먼저 하니스를 점검하자. 에이전트가 컨텍스트를 효율적으로 압축하는지, 도구 정의가 명확한지, 오류 복구가 무의미한 반복 대신 합리적인 재시도를 수행하는지 확인해야 한다.
FAQ
코딩 에이전트에 가장 저렴한 LLM은 무엇인가요?
DeepSeek V4 Pro는 입력 100만 토큰당 $0.435, 출력 100만 토큰당 $0.87로 프런티어급 모델 가운데 가장 저렴한 선택지이며, 해결된 에이전트 작업 1건당 비용은 약 $0.08이다.
내 저장소에서 코딩 에이전트 모델을 테스트하려면 어떻게 해야 하나요?
실제 백로그에서 버그 수정, 기능 개발, 리팩터링을 섞어 대표 이슈 20~30개를 고른다. 같은 작업을 선택한 하니스에서 각 모델로 실행한 뒤 세 가지 지표를 추적한다. 해결률, 즉 에이전트의 패치가 테스트를 통과했는지, 작업당 토큰 소비량, 완료까지 걸린 시간이다. 이처럼 저장소 특성에 맞춘 평가는 어떤 공개 벤치마크보다 예측력이 높다.