 AIREITER
Gemini 3.8 Flash의 API 요금은 2026년 12월 31일까지 입력 토큰 100만 개당 $0.75, 출력 토큰 100만 개당 $3.75입니다. 다만 추론을 더 많이 수행하는 만큼 완료된 작업의 실제 비용은 커질 수 있습니다. 모든 Gemini 3.7 Flash 요청을 한꺼번에 바꾸기보다는 멀티모달 작업과 특화 에이전트부터 검증하는 편이 현실적입니다.
출시 당일 기준으로 본 Gemini 3.8 Flash
Google의 출시 발표에 따르면 Gemini 3.8 Flash는 2026년 9월 2일 공개됐으며, 안정 버전 API 모델 ID는 gemini-3.8-flash입니다. Google은 이 모델을 소프트웨어 엔지니어링, 자율 에이전트, 여러 단계를 거치는 엔터프라이즈 워크플로에 적합한 모델로 소개합니다. Google AI for Developers 모델 페이지에서는 안정 버전으로 표시하고 있으며, Google DeepMind 모델 카드는 Gemini 3.7 Flash를 기반으로 한 모델이라고 설명합니다.
Gemini 3.7 Flash에서 달라진 점
Google에 따르면 Gemini 3.8 Flash는 어려운 작업에서 더 많은 추론 단계를 거치고, 도구를 반복적으로 호출합니다. 대신 추론 수준을 높이면 토큰 사용량도 늘어날 수 있습니다. Artificial Analysis의 고추론 설정 Intelligence Index 점수는 Gemini 3.8 Flash가 59점으로 Gemini 3.7 Flash의 56점보다 높았지만, 작업당 비용은 $0.58로 Gemini 3.7 Flash의 $0.40보다 컸습니다. (Google 출시 발표; Artificial Analysis 비교 자료)
모델보다 먼저 작업 유형부터 정하자
Gemini 3.8 Flash는 긴 컨텍스트, 여러 도구, 멀티모달 근거가 필요한 요청에서 강점을 보입니다. 반대로 짧고 반복적인 작업에서는 추가 추론 루프가 반드시 이점으로 이어지지는 않습니다.
멀티모달 작업과 특화 에이전트에는 Gemini 3.8 Flash
BenchmarkList에 따르면 Finance Agent v2에서 61.4%, HLE-Verified에서 54.9%, LVBench에서 87.8%, CharXiv-R에서 86.2%, LABBench2에서 86.2%를 기록했습니다. 다만 이 기록은 출시 게시물, 자체 보고, 독립 출처 결과를 구분해 정리한 것이므로, 모든 수치를 하나의 동일한 독립 테스트 결과로 받아들여서는 안 됩니다. (BenchmarkList 모델 기록)
| 작업 유형 | 확인할 근거 | 판단 |
|---|---|---|
| 금융 및 구조화된 분석 | Finance Agent v2: 61.4% | 통제된 파일럿에 적합한 후보 |
| 긴 동영상 또는 차트 이해 | LVBench: 87.8%; CharXiv-R: 86.2% | 텍스트 전용 모델이 맞지 않는 작업에서 유력한 후보 |
| 생물학 및 과학 워크플로 | LABBench2: 86.2%; BioMysteryBench human-difficult: 56.5% | 전문가 검토를 포함해 테스트 |
| 긴 문서와 PDF | 입력 한도 1,048,576토큰; PDF 입력 지원 | 검색과 종합에 유용하지만 검색 결과 누락 여부를 검증 |
Google의 모델 카드에는 환각, 타임아웃, 간헐적인 느린 응답이 여전히 한계로 기재돼 있습니다. (Gemini 3.8 Flash 모델 카드)
단순하고 효율성이 중요한 요청은 Gemini 3.7 Flash 유지
분류, 추출, 태깅, 짧은 요약 파이프라인에는 추가 추론이 필요하지 않을 수 있습니다. Artificial Analysis 측정에서 Gemini 3.8 Flash는 낮은 추론 수준에서 작업당 $0.24, 0.8분이었고, 높은 추론 수준에서는 $0.58, 2.5분이었습니다. Gemini 3.7 Flash의 높은 추론 수준 측정값은 작업당 $0.40, 2.2분이었습니다.
추가 추론이 실패를 막아주는 작업에는 3.8을 쓰고, 추가 출력이 비용만 늘리는 작업에는 3.7을 유지하는 방식이 적절합니다.
자율 코딩의 만능 승자로 단정하지 말 것
BenchmarkList에는 Terminal-Bench 2.1 89.4%, DeepSWE 1.1 73.7%라는 기록이 있지만, Terminal-Bench 4.0에서는 19.1%에 그쳤습니다. 장시간에 걸친 컴퓨터 사용 평가인 OSWorld 2.0에서는 59.0%를 기록했습니다. (BenchmarkList 코딩 및 에이전트 결과)
터미널이나 데스크톱 에이전트가 숨겨진 상태를 복구하고, 변경 사항을 검증하며, 도구 호출 실패 뒤에도 작업을 이어가야 한다면 모델을 바꾸기 전에 현재 모델과 Gemini 3.8 Flash를 동일한 워크플로에서 비교해야 합니다.
비용은 토큰 100만 개가 아니라 작업 단위로 봐야 한다
2026년 Gemini 3.8 Flash API 요금
Google의 공식 출시 게시물에 직접 API 요금이 다음과 같이 안내돼 있습니다. 프로모션 요금은 2026년 12월 31일 종료되고, 2027년 1월 1일부터 표준 요금이 적용됩니다. (Google 출시 발표)
| 기간 | 입력 요금 | 출력 요금 | 실제 의미 |
|---|---|---|---|
| 2026년 12월 31일까지 | 토큰 1M당 $0.75 | 토큰 1M당 $3.75 | 프로모션 요금 |
| 2027년 1월 1일부터 | 토큰 1M당 $1.50 | 토큰 1M당 $7.50 | 두 요금 모두 2배 인상 |
프로모션 요금 기준으로 출력 비용은 입력 비용의 5배입니다. Google 문서에는 Batch API, Flex inference, Priority inference도 안내돼 있지만, 인용한 모델 페이지에는 구체적인 숫자 요금이 표시돼 있지 않습니다.
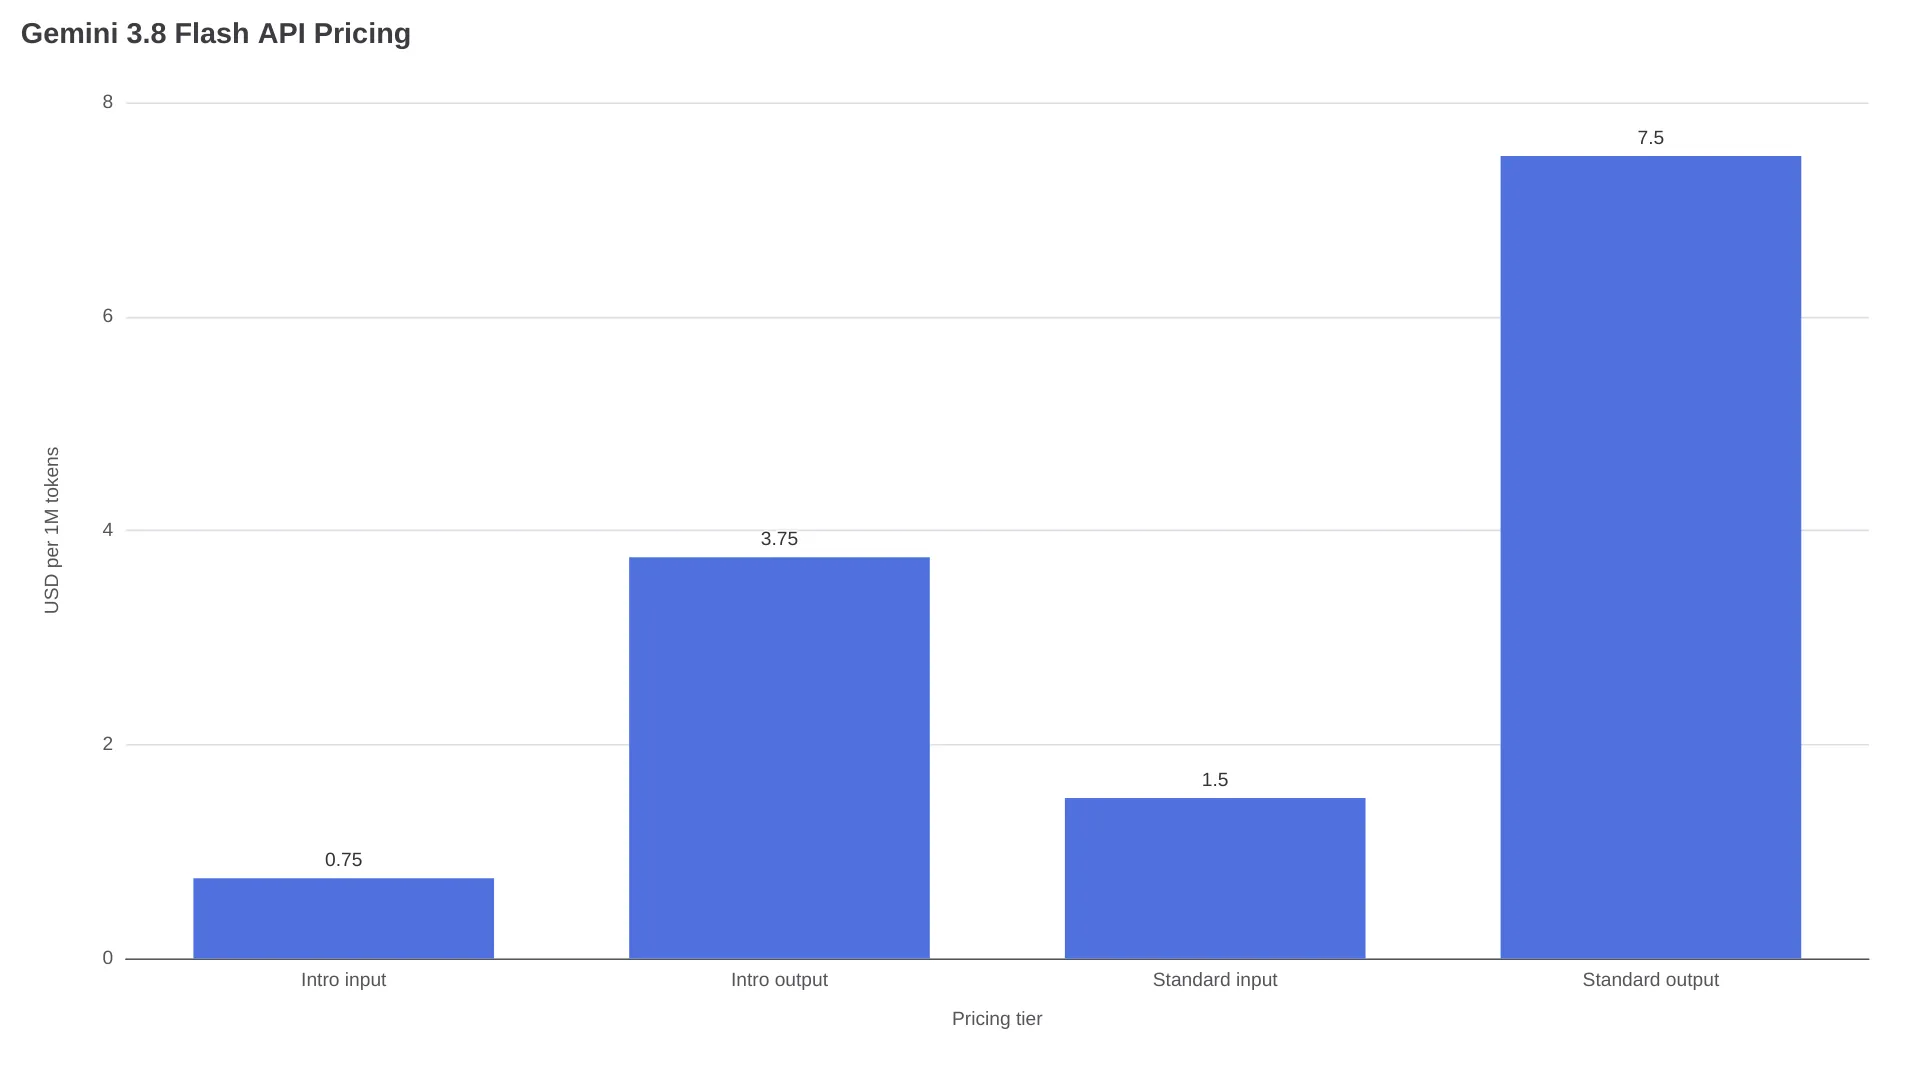
입력 토큰 200만 개와 출력 토큰 50만 개를 사용하는 작업은 프로모션 요금 기준 $3.38입니다. 계산식은 (2 × $0.75) + (0.5 × $3.75)입니다. 같은 사용량을 2027년 1월 1일부터 처리하면 비용은 $6.75가 됩니다. 계산식은 (2 × $1.50) + (0.5 × $7.50)입니다.
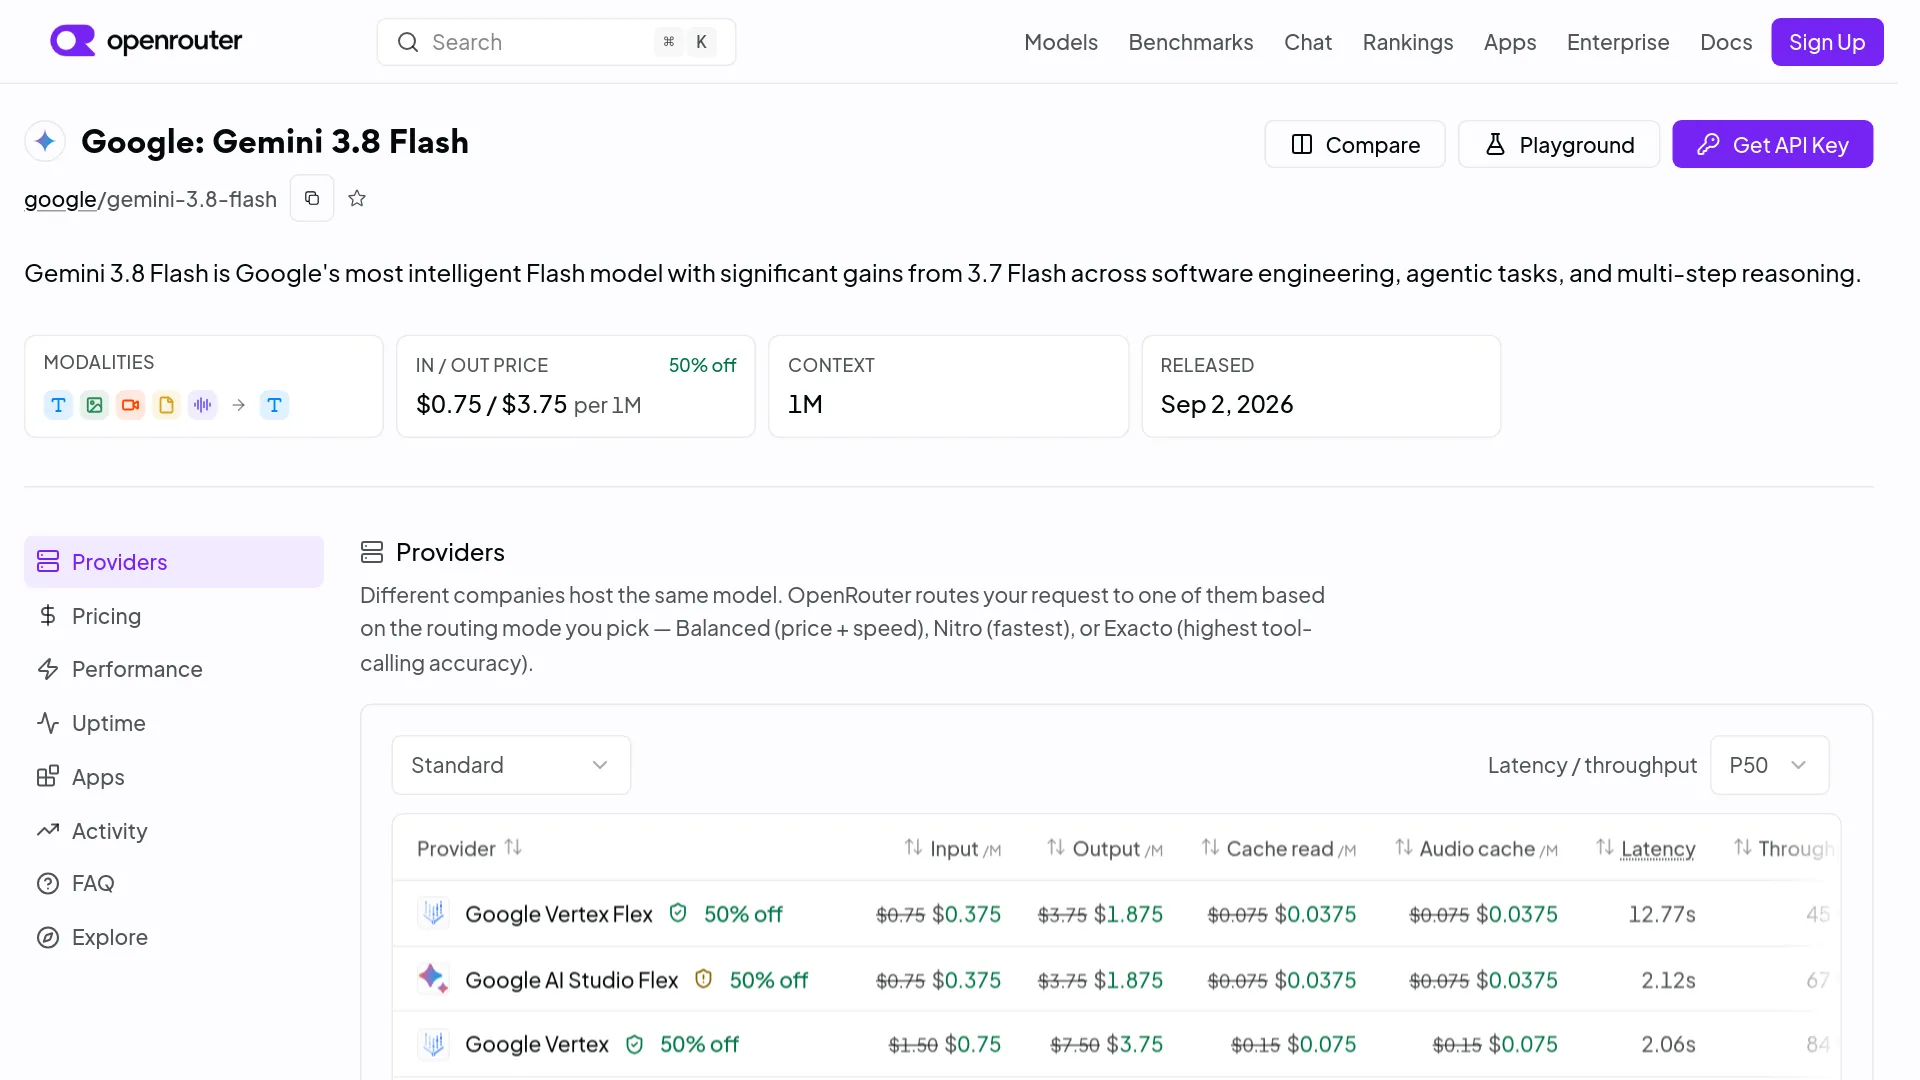
OpenRouter Gemini 3.8 Flash 페이지에는 Google Vertex와 Google AI Studio 경로, 캐시 요금, 지연 시간, 처리량, 표시된 할인율이 별도로 안내돼 있습니다. 라우터 요금과 Google의 직접 요금표를 비교하기 전에는 어느 제공업체와 결제 경로를 사용하는지 확인해야 합니다.
토큰 단가는 낮아도 청구액이 커지는 이유
Artificial Analysis가 보고한 Gemini 3.8 Flash의 추론 수준별 측정값은 다음과 같습니다.
| 추론 수준 | Intelligence Index | 작업당 비용 | 작업당 시간 |
|---|---|---|---|
| 낮음 | 52 | $0.24 | 0.8분 |
| 중간 | 57 | $0.41 | 기재되지 않음 |
| 높음 | 59 | $0.58 | 2.5분 |
인용한 분석에서 Artificial Analysis는 중간 추론 수준의 작업 시간을 제시하지 않았습니다. 같은 분석에 따르면 Intelligence Index 평가에서 Gemini 3.8 Flash는 출력 토큰 1억 2,000만 개를 생성했으며, 비교 대상 모델의 중앙값은 7,100만 개였습니다. 이는 평가 전체에서 측정된 값이지 모든 API 요청에 적용되는 예측치는 아닙니다. 다만 토큰 단가만으로 운영 예산을 계산하기 어려운 이유는 보여줍니다. (Artificial Analysis 모델 프로필)
내부 비교를 진행할 때는 완료된 작업 하나에 들어간 전체 입력 토큰, 캐시된 입력 토큰, 추론 토큰, 출력 토큰을 계산한 뒤, 전송한 요청 수가 아니라 성공적으로 완료된 작업 수로 API 지출을 나누세요. 도구 호출, 재시도, 사람의 수정 작업도 포함해야 합니다.
API 한도와 지원 기능
안정 버전 API에서 지원하는 기능
공식 모델 페이지에 따르면 최대 입력 한도는 1,048,576토큰, 최대 출력 한도는 65,536토큰입니다. Gemini 3.8 Flash는 텍스트, 이미지, 동영상, 오디오, PDF 입력을 지원하며 텍스트를 출력합니다. 캐싱, 코드 실행, 파일 검색, 함수 호출, Google Maps grounding, 검색 grounding, 구조화된 출력, URL context를 지원하고, 컴퓨터 사용 기능은 Preview 상태로 제공합니다. (공식 모델 문서)
사고 수준은 low, medium, high이며, minimal은 지원되지 않아 오류를 반환합니다. 네이티브 이미지나 오디오 생성은 제공하지 않으며, 개발자 문서에는 Live API 지원도 기재돼 있지 않습니다.
사용 가능한 서비스와 Cyber가 다른 이유
Google은 Gemini 3.8 Flash를 Gemini API, Google AI Studio, Android Studio, Stitch, Google Antigravity, Gemini Enterprise, Gemini 앱, Google Search의 AI Mode, Google Sheets의 Gemini에서 제공한다고 안내합니다. (Google 출시 발표)
Gemini 3.8 Flash Cyber는 별도의 사이버보안 특화 모델입니다. Google은 정부 기관, 핵심 인프라 운영자, 소프트웨어 유지관리자 등 신뢰할 수 있는 방어 조직을 우선 대상으로 Fairwind 액세스를 제공한다고 설명합니다. 출시 게시물에는 20개 프로그래밍 언어를 대상으로 한 내부 취약점 탐지 벤치마크에서 70%를 넘는 성공률과 CWE-Bench 패치 작업의 pass@1 47.2%가 제시돼 있습니다. 이 수치는 일반 모델이 아니라 Cyber에 해당합니다. Google의 발표는 Fairwind를 통한 액세스를 설명하므로, 일반 Flash API 경로에서 Cyber를 사용할 수 있다고 가정해서는 안 됩니다. (Google Cyber 발표)
제품 초기 배포 시점은 계정과 서비스 화면에 따라 다를 수 있습니다. 한 Reddit 사용자는 다음과 같이 전했습니다.
“3.8 Flash가 이제 Gemini 웹 앱에서도 표시됩니다. 공식적으로 출시된 것 같습니다. 저는 호주의 Pro 구독자이지만, 아직 AntiGravity나 iOS 앱에는 나타나지 않았습니다.” — u/DMAC80, r/GeminiAI
애플리케이션에서는 연동에 설정된 API 모델 ID인 gemini-3.8-flash와 사용할 수 있는 응답 메타데이터를 확인하세요. 모델이 스스로 어떤 모델인지 설명하는 것만으로는 엔드포인트를 검증할 수 없습니다.
현재 근거만으로는 확인할 수 없는 것
| 문서에 기재된 한계 | 실제 의미 |
|---|---|
| Artificial Analysis에 따르면 높은 추론 수준에서 첫 응답 토큰까지 13.39초가 걸렸으며, 이후 출력 속도는 약 304.6토큰/초였습니다. (Artificial Analysis 모델 프로필) | 초기 추론 대기 시간이 발생한 뒤 빠르게 생성될 수 있습니다. |
| DeepMind 모델 카드에는 2026년 3월 지식 기준일이 제시돼 있으며, 일부 영역은 2025년 1월로 제한됩니다. (Gemini 3.8 Flash 모델 카드) | 최신 정보에는 검색 grounding 또는 검증된 검색 시스템을 사용해야 합니다. |
| 컴퓨터 사용은 Preview 전용이고, 개발자 문서에는 자체 호스팅 옵션이 기재돼 있지 않으며, 출력 형식도 이미지·오디오·동영상이 아닌 텍스트입니다. (Google 개발자 문서) | 이런 요구사항에는 별도의 배포 방식이나 대체 모델을 준비해야 합니다. |
운영 환경에 안전하게 도입하는 방법
- 긴 컨텍스트 사례와 기존 실패 사례를 포함해 실제 운영 구성을 대표하는 작업 30–50개를 선정합니다.
- 현재 모델과 비교할 수 있도록 Gemini 3.8 Flash를 낮음, 중간, 높음 사고 수준에서 실행합니다.
- 전체 토큰, 캐시 적중, 도구 호출 횟수, 재시도, 첫 토큰까지의 시간, 완료 시간, 사람의 수정 횟수, 작업 수락률을 기록합니다.
- 성공한 작업당 비용을 계산하고 대화형 트래픽과 배치 트래픽을 분리합니다.
- 기본 경로를 바꾸기 전에 운영 요청 중 일부에만 카나리 배포합니다.
- 추가 추론이 수락된 작업의 비용을 낮추지 못한다면 단순한 작업에는 Gemini 3.7 Flash를 유지합니다.
- 2027년 1월 1일부터 적용될 입력 토큰 100만 개당 $1.50, 출력 토큰 100만 개당 $7.50 요금을 예산에 반영합니다.
첫 테스트는 결과를 확인할 수 있는 작업으로 구성하는 것이 좋습니다. 예를 들어 테스트가 포함된 여러 파일 변경, 정답이 정해진 문서 워크플로, 검토된 라벨이 있는 멀티모달 추출 작업이 적합합니다.
Gemini 3.8 Flash API 가격 FAQ
Gemini 3.8 Flash의 가격은 얼마인가요?
Google의 직접 API 프로모션 요금은 2026년 12월 31일까지 입력 토큰 100만 개당 $0.75, 출력 토큰 100만 개당 $3.75입니다. 2027년 1월 1일부터 안내된 요금은 각각 $1.50과 $7.50으로 바뀝니다.
Gemini 3.8 Flash가 Gemini 3.7 Flash보다 좋은가요?
높은 추론 수준의 Artificial Analysis Intelligence Index에서 59점 대 56점을 기록하는 등, 출시 당일 공개된 여러 추론 및 에이전트 측정 결과에서는 더 강한 모습을 보였습니다. 다만 Gemini 3.8 Flash는 출력 토큰을 더 많이 사용할 수 있으므로, 단순한 요청에서는 Gemini 3.7 Flash가 운영 비용 측면에서 더 저렴할 수 있습니다.
Gemini 3.8 Flash는 코딩 에이전트에 적합한가요?
충분히 검토할 만한 후보입니다. Terminal-Bench 2.1에서 89.4%, DeepSWE 1.1에서 73.7%라는 결과가 보고됐습니다. 다만 Terminal-Bench 4.0에서는 19.1%를 기록했으므로, 장시간 터미널 및 데스크톱 워크플로는 별도로 평가해야 합니다.
Gemini 3.8 Flash는 무료인가요?
API는 안내된 토큰 요금에 따라 유료로 제공됩니다. 직접 API 요금표와 현재 AI Studio 프로젝트 약관은 별도로 확인해야 합니다.
Gemini 3.8 Flash Cyber란 무엇이며 누가 사용할 수 있나요?
Gemini 3.8 Flash Cyber는 취약점 탐지와 자동 패치에 맞춰 조정된 모델입니다. Google은 Fairwind Program을 통해 신뢰할 수 있는 방어 조직을 우선 대상으로 액세스를 제공한다고 설명합니다. 일반 Gemini 3.8 Flash API 키로 누구나 사용할 수 있는 공개 모델은 아닙니다.
고정된 작업 세트에서 낮음 또는 중간 추론부터 시작해 수락된 결과당 비용을 측정하세요. 추가 작업이 측정 가능한 실패를 막아주는 경우에만 추론 수준을 높이는 방식이 안전합니다.