 AIREITER
2026年8月、Qwen 3.8とKimi K3の比較は単純な性能勝負ではなくなった。両ファミリーとも重みをダウンロードでき、最上位モデルも一般提供されているが、選ぶべきモデルは導入形態で変わる。検証済みのエージェント型コーディング性能ではKimi K3が最有力、トークン単価ではQwen 3.8 Maxが有利。そしてApache-2.0のQwen3.8-27Bなら、コンシューマー向けGPU 1枚で動かせる。もっとも、Kimiの「オープン」なフラッグシップは報告ベースで1.56 TBのチェックポイントだ。重みが公開されていることと、現実的にセルフホストできることは別の話である。
Qwen 3.8とKimi K3は何をリリースしたのか
Kimi K3(Moonshot AI)は、2026年7月16日に単一のフラッグシップモデルとして登場した。総パラメータ数は2.8兆、トークンあたりのアクティブパラメータは104BのMoEで、Kimi Delta AttentionとGated MLAを採用。コンテキスト長は1,048,576トークンで、ネイティブのビジョン入力にも対応する。7月27日には重みと技術レポートが、独自のKimi K3 Licenseで公開された。Emergentの比較記事にまとめられた規約によれば、大規模な商用再販事業者や月間ユーザー数が1億人を超える製品には条件が付く。
Alibabaが対抗して投入したのは、単体モデルではなくファミリーだった。Qwen 3.8 Maxは7月19日にプレビュー公開され、8月3日にQwenCloudで一般提供を開始。総パラメータ数は2.4T、アクティブパラメータは約95Bである。8月12日ごろには、Qwen/Qwen3.8-2.4T-A95BとしてHugging Face上に重みが現れ、独自のqwen3.8-maxライセンスが適用された。数日後にはQwen/Qwen3.8-27Bも公開された。こちらはApache-2.0の高密度27Bビジョン言語モデルで、ネイティブでは262K、YaRNを使えば1Mまでコンテキストを拡張できる(Yotta Labsは8月13~14日付としている)。
| Kimi K3 | Qwen 3.8 Max | Qwen3.8-27B | |
|---|---|---|---|
| 総パラメータ数 / アクティブパラメータ | 2.8T / 104B | 2.4T / 約95B | 27B高密度 |
| コンテキスト長 | 1,048,576 | 1M(最大入力991.8K) | ネイティブ262K、YaRNで1M |
| ライセンス | Kimi K3 License(独自) | 独自のqwen3.8-maxライセンス | Apache-2.0 |
| 重み公開時期 | 2026年7月27日 | 2026年8月12日ごろ | 2026年8月13~14日ごろ |
| ビジョン入力 | テキスト+画像(正式対応) | API経由でテキスト、画像、動画 | テキスト、画像、動画 |
なおMoonshotは、K3の公開から48時間以内に、需要がGPU容量を上回ったため新規コンシューマー向けサブスクリプションを一時停止したと報じられている。製品を単一プロバイダーに賭ける前に、覚えておきたい点だ。
ベンチマークは「誰が測ったか」で分けて見る
両社とも大きなベンチマーク表を出しているが、そこでは複数のハーネスが混在している。Kimiのモデルカード自身も、競合モデルのスコアには異なるエージェントハーネスが使われ、一部の行はH100ではなくH20ハードウェアで測定されたと明記している。以下の共通項目は、監査済みの数値ではなくベンダー公表値として扱うべきだ。
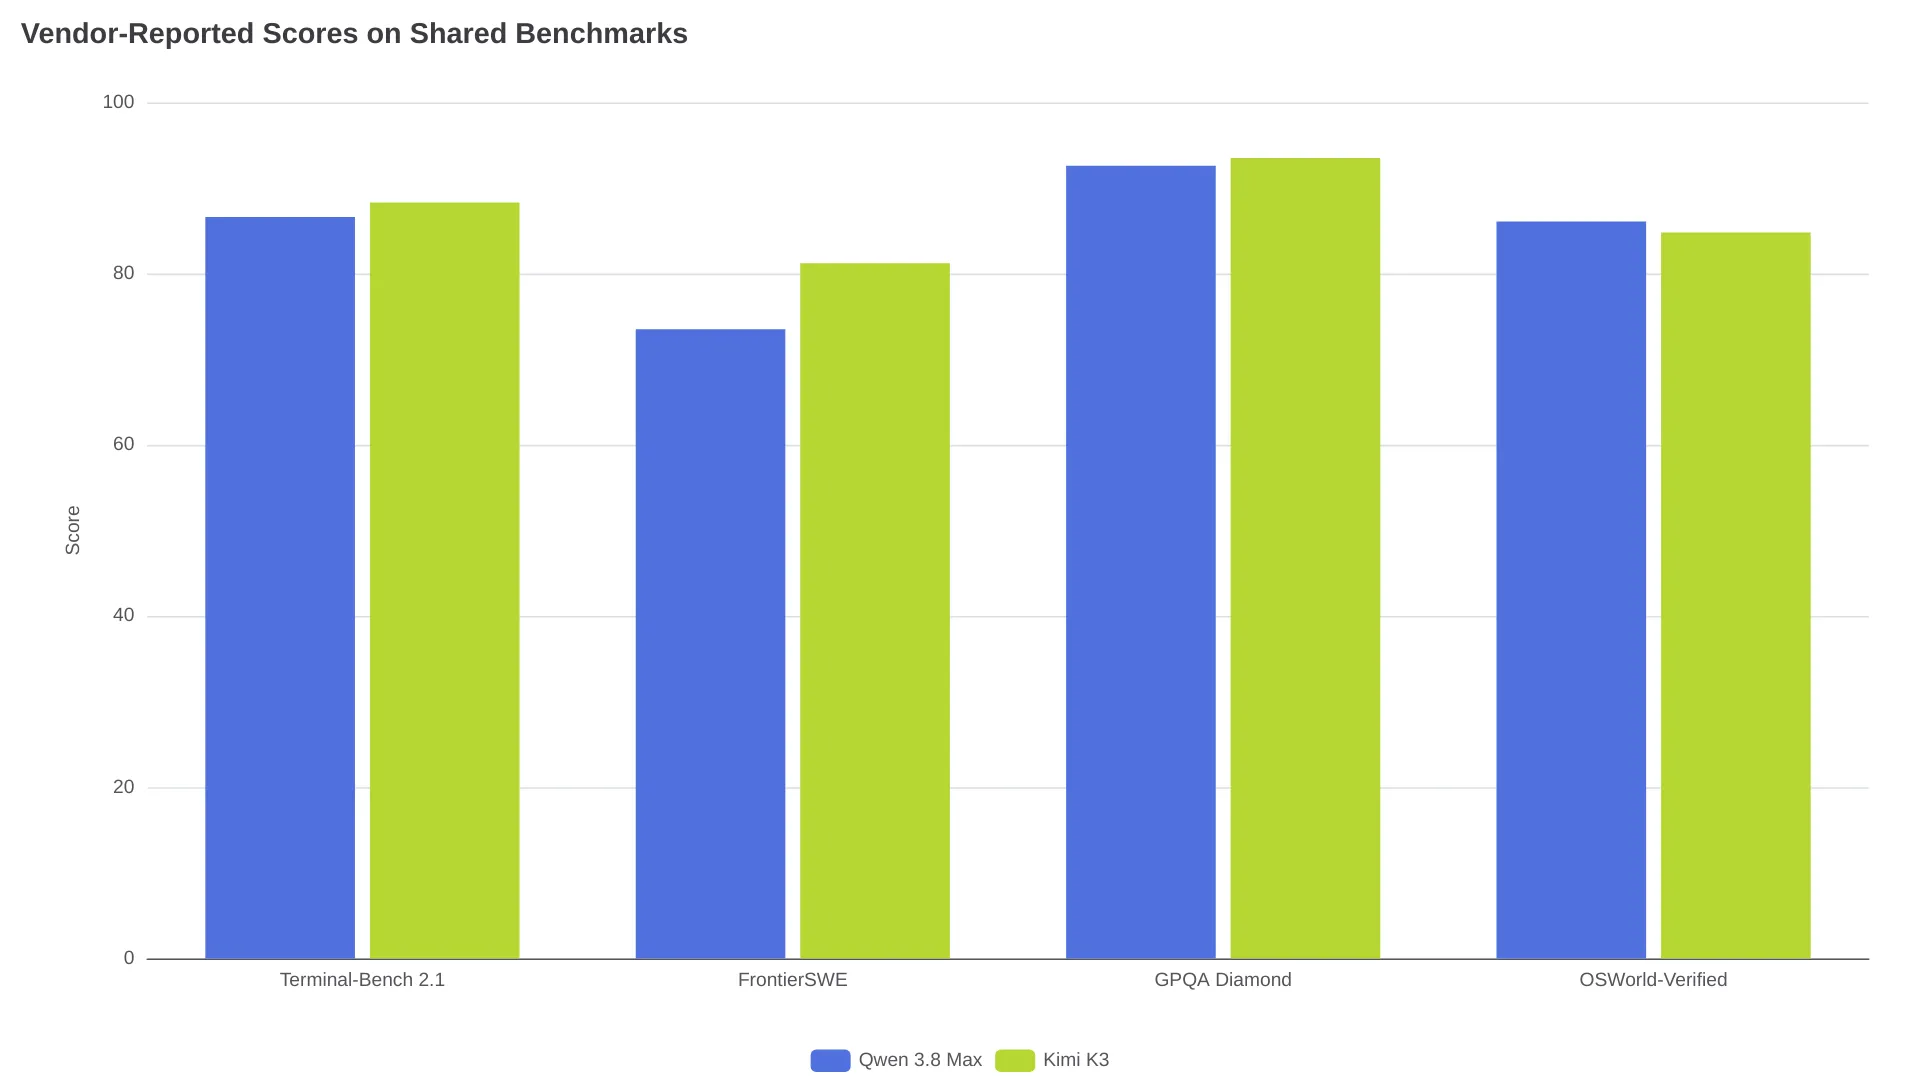
共通項目を見る限り、エージェント型コーディングではKimi K3が先行する。モデルカードによると、FrontierSWEは81.2対73.5、Terminal-Bench 2.1は88.3対86.6でK3が上回った(Qwen側の出典は2.4Tモデルのカード)。Qwenのローンチ資料ではOSWorld-Verifiedが86.1で、K3のカードにある84.8を上回る。またQwenのカードには、PaperBench 93.0、IFBench 82.8、SWE-bench Pro 67.7という単独項目での強い数値が載る。一方、Qwenが報告していない行では、K3がSWE-Marathon 42.0、BrowseComp 91.2、MCPMark-Verified 94.5を記録している。
独立評価の記録は、現時点ではK3に大きく偏っている。Emergentの追跡情報では、Kimi K3はローンチ時のArtificial Analysis Intelligence Indexが57、現行バージョンの指数では60で、Claude Fable 5とGPT-5.6 Solに次ぐ順位とされる。さらにOrcarouterの比較では、Frontend Code Arenaで1,679 Eloの1位を獲得したとされている。Qwen 3.8 Maxはローンチ時に独立したインデックスへ掲載されておらず、cheapestinference.comのトラッカーはArtificial Analysisの指数として53を報告した。56へ更新されたとするコミュニティ投稿もあるが、未検証だ。
同一タスクでの直接対決は、TrilogyAIのStackPerfアーキテクチャ分析のみである(Orcarouterが記録)。プレビューエンドポイントでの評価は、K3が83/100、Qwenが80/100だった。Qwenはリポジトリ引用数で354件対Kimiの274件、ゲートウェイリクエスト数で22回対Kimiの53回、ツール呼び出し失敗はゼロ対Kimiの2回を記録している。
共通表には出てこない数字も重要だ。Qwen自身のカードでは、27BのOSWorld-Verifiedは84.3で、K3の84.8との差は0.5ポイント以内に収まる。高密度27Bモデルが、コンピューター操作では2.8Tのフラッグシップにここまで迫る。ただしコーディング性能はK3のクラスではない。Terminal-Benchは73.0対88.3だ。それでもLiveCodeBench v6の90.3、SWE-bench Proの61.7は、実務で使える主力モデルと呼ぶに十分な値である。r/AISEOInsiderの実使用比較スレッドもデータと同じ傾向だった。単発のビルドではQwenの勝ちが多く、コンテキストが長くなり、修正の往復が深くなるとKimiが前に出る。
API料金:出力100万トークン15ドルと推論コスト
定価だけ見ても方向性は明確だが、実際の支出では差がさらに広がる。両モデルともデフォルトで推論を行い、K3はreasoning_effort: max、Qwenはxhighを使う。そして推論トークンも出力として課金されるからだ。
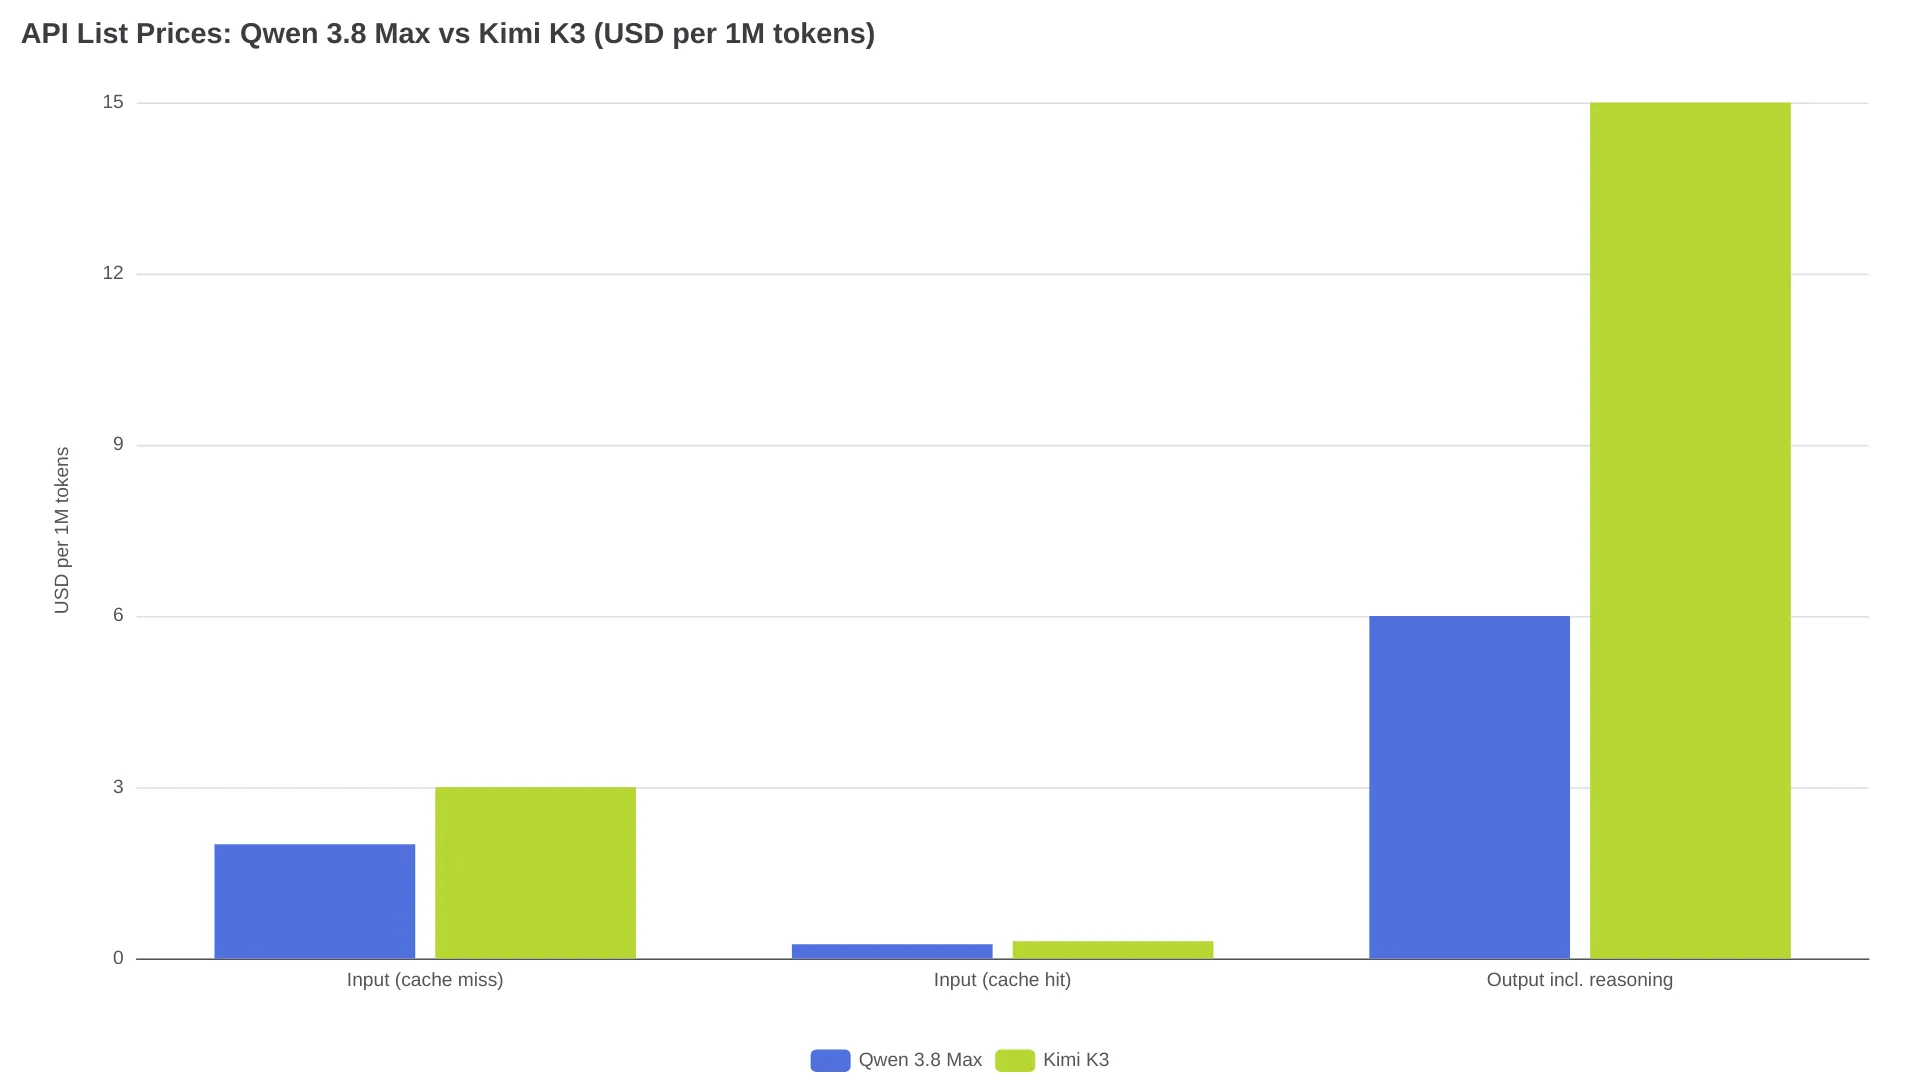
| 100万トークンあたり | Qwen 3.8 Max(QwenCloud) | Kimi K3(Moonshot) |
|---|---|---|
| 入力(キャッシュミス) | $2.00 | $3.00 |
| 入力(キャッシュヒット) | $0.25 | $0.30 |
| 出力(推論を含む) | $6.00 | $15.00 |
| 明示的キャッシュの作成 / 読み出し | $2.50 / $0.17 | — |
2026年8月時点の定価で、2つのセッションを試算すると次のようになる。
| セッション | Qwen 3.8 Max | Kimi K3 | 差 |
|---|---|---|---|
| エージェント型コーディング:入力500K(うち60%キャッシュ)、出力40K | $0.72 | $1.29 | 1.8倍 |
| 新規コンテキストの文書パイプライン:入力2M、出力100K | $4.60 | $7.50 | 1.6倍 |
この計算からルーティングの基準も見えてくる。自分のワークロードにおけるK3の受け入れ率が、Qwenよりおよそ1.8倍のトークンコスト差を上回る場合にだけ、K3へ送る価値がある。Moonshot自身も低予算向けの選択肢を用意しており、Kimi K2.7 Codeは256Kコンテキストで入力$0.95、出力$4.00だ。Kimiファミリーで最安のコーディング経路はK3ではない。現在K3をルーティングするなら、このAPIエンドポイントにMoonshot公表レートで掲載がある。両者のより詳細な料金体系は、Qwen3.8-Maxの料金分析とKimi K3の料金ガイドで確認できる。
セルフホスト:1.56 TBか、RTX 4090 1枚か
オープンウェイトという点では共通していても、セルフホストの現実はおよそ2桁違う。
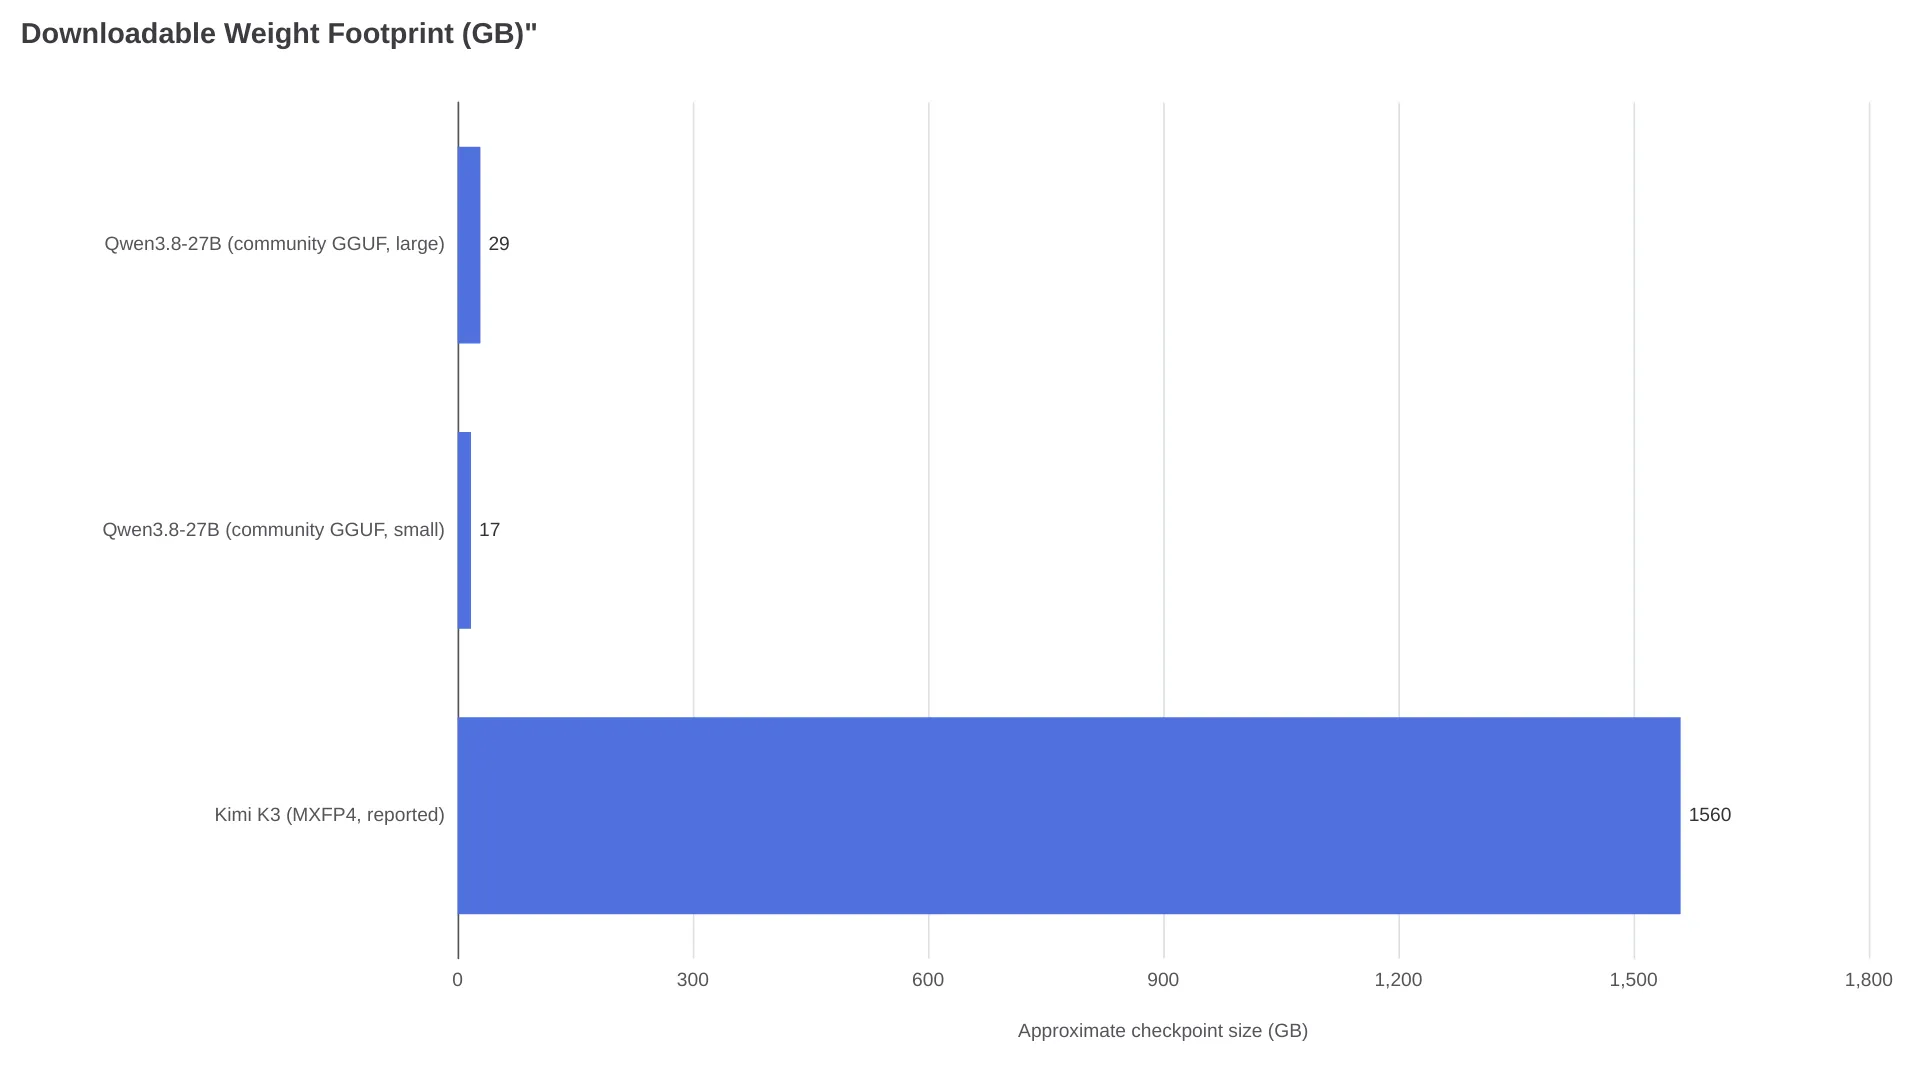
K3は量子化対応のMXFP4重みを提供している(モデルカード)。しかし、1.56 TBと報告されるチェックポイントはクラスタ向けの案件だ。同じ情報源では、64基以上のアクセラレータにまたがるvLLMを推奨している。トークンを1つ配信する前から、レンタル可能とはいえ実在するコスト項目になる。加えて、ライセンスの大規模利用条件も適用される。
27Bは対照的だ。コミュニティ製GGUFはおよそ8.5 GBから28.9 GBまであり、Unslothのdynamic GGUFおよびNVFP4ビルドなら最小で約17 GBに収まる。サーバー展開向けの公式FP8版も用意されている。つまり、すでに手元にあるようなハードウェアで動かせる。
「SINGLE RTX 4090で160KコンテキストのQwen3.8-27B。フルGPUオフロードで47~57 tok/s」— r/Qwen_AIのデプロイ投稿
Maxの重みは両者の中間に位置する。Qwen3.8-2.4T-A95BとそのFP8版は、独自のqwen3.8-maxライセンスでダウンロード可能だ。ただし公開アーティファクトはテキスト専用で、思考モードは無効化できない。ビジョン入力、非思考モード、デフォルト1Mコンテキストは、チェックポイントではなくQwenCloud APIレイヤーの機能である。27Bで各量子化方式ごとに何ができ、何ができないかは、Qwen3.8-27BフィールドガイドにランタイムとVRAM表がある。K3の重み公開については、Kimi K3オープンウェイト解説で詳しく扱っている。
エージェント実装で効いてくる統合上の注意点
モデルカードに書かれた3つの挙動を見落とすと、本番で丸1日デバッグすることになりかねない。
| モデル | 挙動 / 制限 | 実装への影響 |
|---|---|---|
| Kimi K3 | 思考は常時有効。マルチターンおよびツール利用クライアントは、reasoning_contentとtool_callsを含む過去のassistantメッセージ全体を再送する必要がある(カード) | 推論トレースを落とすとエージェントループが劣化する。保持すると、ループが長くなるほど支出が増える |
| Qwen3.8-27B | preserve_thinkingはデフォルトで有効。reasoning_effortはmedium/lowまで下げられる。262Kを超えるYaRNは静的スケーリング(カード) | リクエスト単位で無効化できる。カードでは、低い推論強度にしてもリトライで節約分が消え、エンドツーエンド時間が必ずしも短縮されないと警告している。YaRNは長いジョブでのみ有効にしたい |
| Qwen 3.8 MaxとK3の上限 | Max:入力991.8K / 出力131.07K(QwenCloud)。K3:入力1,048,576 / デフォルト出力131K、1Mへ近づく構成もある | どちらも「1Mコンテキスト」が1Mの実用的な出力を保証するわけではない。サードパーティーのニードルテストは248Kで18/18の事実を検出したが、それを超える範囲はテストしていない |
FAQ
コーディングではQwen 3.8の方がKimi K3より優れている?
現時点で得られる証拠では、そうは言えない。Kimi K3は重要なエージェント型コーディング項目で先行している。FrontierSWEは81.2対73.5、Terminal-Bench 2.1は88.3対86.6であり、独立インデックスのスコアも確認されているのはK3だけだ。Qwen 3.8 Maxはターミナル作業で近い性能を示し、トークン単価と上記試算のセッションコストでは安い。27Bはそもそもまったく別の重みクラスである。
Qwen 3.8とKimi K3では、どちらが安い?
定価の全項目でQwen 3.8 Maxだ。入力は$2対$3、出力は$6対$15。両モデルともデフォルトで有効な推論を出力として課金するため、タスクが難しくなるほどKimiの不利は広がる。上の計算では、キャッシュを使うエージェントセッションでおよそ1.8倍となった。
セルフホストは可能? ライセンスはどうなっている?
可能だ。3つのチェックポイントはいずれもダウンロードできる。Qwen3.8-27BはApache-2.0で、量子化すれば単体の24 GB GPUに収まる。Kimi K3は約1.56 TBのMXFP4チェックポイントのためクラスタ規模のハードウェアを必要とし、独自のKimi K3 Licenseが適用される。Qwen3.8-Maxの重みはQwen3.8-2.4T-A95Bとして公開されており、独自のqwen3.8-maxライセンスの対象となる。
両方とも1Mコンテキストは本物?
おおむねそうだ。Kimi K3は1,048,576トークンを仕様として掲げる。Qwen 3.8 Maxは1Mで、最大入力は991.8K。27Bはネイティブでは262,144であり、短コンテキスト品質とのトレードオフを伴うYaRNスケーリングでのみ1Mに届く。独立した検証が存在するのは248Kレベルまでだ。
結論:用途別の推奨と、判断が変わる条件
| 用途 | 推奨 | 理由 |
|---|---|---|
| 品質最優先のAPIコーディングエージェント | Kimi K3 | FrontierSWE 81.2、Terminal-Bench 88.3、AA検証済み60 |
| コスト重視、文書・ビジョン中心のAPI利用 | Qwen 3.8 Max | 出力は$6対$15、OSWorld 86.1、明示的キャッシュ読み出しは$0.17 |
| 所有ハードウェアでセルフホスト | Qwen3.8-27B | Apache-2.0、約17~29 GBの量子化版、RTX 4090 1枚で160Kコンテキスト |
| フロンティア級フラッグシップをセルフホスト | Kimi K3 | 独立したフロンティア級スコアを持つ、この中で唯一のオープンなチェックポイント。ただしクラスタ予算が必要 |
この表の一部を覆しうる要因は2つある。Qwen 3.8 Maxの独立評価と、独自qwen3.8-maxライセンスの規約公開だ。前者はトラッカー報告で53、K3の検証済み60に対して根拠がまだ薄い。どちらかが実現するまでは、API用途に絞ったより詳しい比較としてQwen 3.8 Max vs Kimi K3 API直接対決を参照してほしい。
関連記事: Qwen3.8-27B:確認済みの情報と、17GBで実際に動くもの · Kimi K3オープンウェイト · Qwen 3.8 Max vs Kimi K3:API編