 AIREITER
LongCat 2.5 APIは、入力100万トークンあたり0.30ドルという破格の料金に見える。ただし、この料金は終了日未定の期間限定キャンペーンだ。しかもPreview版ではループが発生したという報告があり、安いトークンがかえって高くつく可能性もある。現時点では本番移行ではなく、キャッシュを多用する小規模な試験を実施し、受け入れ可能な結果1件あたりのコストを測るのが現実的だ。
本番提供で料金は固まったが、信頼性への不安は残る
LongCat 2.5は正式提供に移行した。Meituanは2026年11月1日にLongCat-2.5のブログ記事を公開し、2026年11月2日にはAPIプラットフォームでLongCat-2.5を利用可能にした。対応するのはOpenAI Chat Completions、OpenAI Responses、Anthropic Messagesの各エンドポイントだ。
ただし、正式版になったからといって信頼性の問題が解消されたわけではない。OpenCodeでのPreview版テストはかなり不安定で、11月2日のリリースでループや破壊的な編集が直ったのかを、本番導入を検討する側が気にするのも当然だ。公開情報から言える正直な答えは、まだ検証されていないということ。詳細な失敗報告のほぼすべては9月下旬から10月にかけてのLongCat-2.5-Previewを対象としており、11月3日時点で独立した検証機関が本番チェックポイントを再テストした形跡はない。
「LongCat 2.5を試した。スペック上は強力だが、私のテストでは明確な弱点が1つあった」— 無料チャットページでクリスマスツリーのHTMLを生成させ、オーナメントがツリーの外に散らばったテスト後の@prompt48の投稿。
この話は、Redditで報告されている傾向とも一致する。チャットのデモではなく、実際のエージェント実行では別の失敗パターンが報告されている。
「VMのセットアップに使ったが、複数回にわたって、単純なlsコマンドの実行中にループし続けた」— r/opencodeのu/Such_Competition8263。
「タスクとはまったく関係のないコードを、最もランダムな形で完全に変更した」— 同じスレッドのu/Avernite。
提供されるのはAPIのみ。重みは「Coming soon」
LongCat 2.5の現実的な利用方法は、ダウンロード可能な重みを持たない超大規模なMixture-of-ExpertsモデルをAPI経由で使うことだ。総パラメーター数は1.6兆、1トークンあたりのアクティブパラメーターは約480億。テキストに加えて画像と動画を入力でき、出力はテキストのみ。コンテキスト長は1,048,576トークン、最大出力は262,144トークンに達する。要するに、コンテキストは巨大だが、出力はテキストに限られる。
マルチモーダル機能は後付けではなく、モデルに組み込まれている。画像はテキストと同じシーケンス内で離散トークンに変換され、1リクエストあたり最大100枚、1枚10MBまで対応する。形式はPNG、JPG、JPEG、WebP、GIF。動画は公開URL経由で最大10本、1本あたり100MBかつ3,600秒未満まで扱える。思考予算の上限は262,144トークンで、結果はreasoning_contentとして返る。思考を有効にした場合のtemperatureは1.0、無効時は0.7に固定される。
9月25日のPreviewと11月2日の本番版で何が変わったのか
検索結果が混乱しやすい最大の理由は、LongCat-2.5-PreviewとLongCat-2.5が別物だからだ。LongCat-2.5-Previewは2026年9月25日に、100万トークンのコンテキストと画像理解を備えて公開された。その後、11月1日から2日にかけて本番版のLongCat-2.5が登場し、動画入力、失敗したエージェント実行から学習するTrajectory2Task+、さらに8-bit比でプリフィル処理のスループットが43.3%高いとされる4-bit W4A4サービングが追加された。
ただし、モデルの重みは公開されなかった。リリース後もGitHubとHugging Faceのボタンには「Coming soon」と表示されており、ダウンロード可能なLongCatモデルとして最大なのは、引き続きMITライセンスのLongCat-2.0だ。総パラメーター数1.6兆のモデルを自前運用するのは、ほとんどのチームにとって近い将来の選択肢ではない。
LongCat 2.5 APIの0.30ドルは実際にいくらかかるのか
LongCat 2.5 APIのキャンペーン料金は3種類。そこに、見落としやすい高額なコスト要因が1つある。
| トークン種別 | 100万トークンあたりのキャンペーン料金 | 倍率 |
|---|---|---|
| キャッシュなし入力 | $0.30 | 1倍 |
| キャッシュ済み入力 | $0.006 | 0.02倍 |
| 出力 | $1.20 | 入力の4倍、キャッシュ済みの200倍 |
請求額は(キャッシュなし入力 x 0.30 + キャッシュ済み入力 x 0.006 + 出力 x 1.20) / 1,000,000で計算する。推論トークンは別料金ではなく、出力トークンに含まれる。入力100万トークンでキャッシュヒット率が80%なら、入力コストは0.30ドルから0.0648ドルまで下がる。入力全体で78.4%の節約になるが、98%割引なのはキャッシュされたトークン部分だけなので、98%安くなるわけではない。
キャンペーン料金で2つのワークロードを計算すると、コストを左右するのが出力だと分かる。入力20,000トークン、出力2,000トークンの要約なら0.0084ドル、1,000件あたり8.40ドルだ。一方、入力のうちキャッシュなしが200,000、キャッシュ済みが800,000、出力が40,000トークンのコンテキスト再利用型エージェントリクエストでは、0.1128ドル、1,000件あたり112.80ドルになる。
ツール実行の失敗による再試行、長すぎるレスポンス、使い物にならないのにHTTP 200として課金される応答は、請求額を押し上げる。評価では、全試行の総請求額を受け入れ可能な結果の数で割り、結果1件あたりのコストを測るべきだ。
キャンペーンの終了日は未定。割引後の予算も見ておく
LongCat 2.5のキャンペーン料金に関する制約は、技術ではなく期間にある。Meituanは0.30ドル/1.20ドル/0.006ドルを終了日未定の期間限定料金としており、通常料金は公開していない。また、価格変更の権利を留保しており、プラットフォームの請求記録を正式な基準としている。
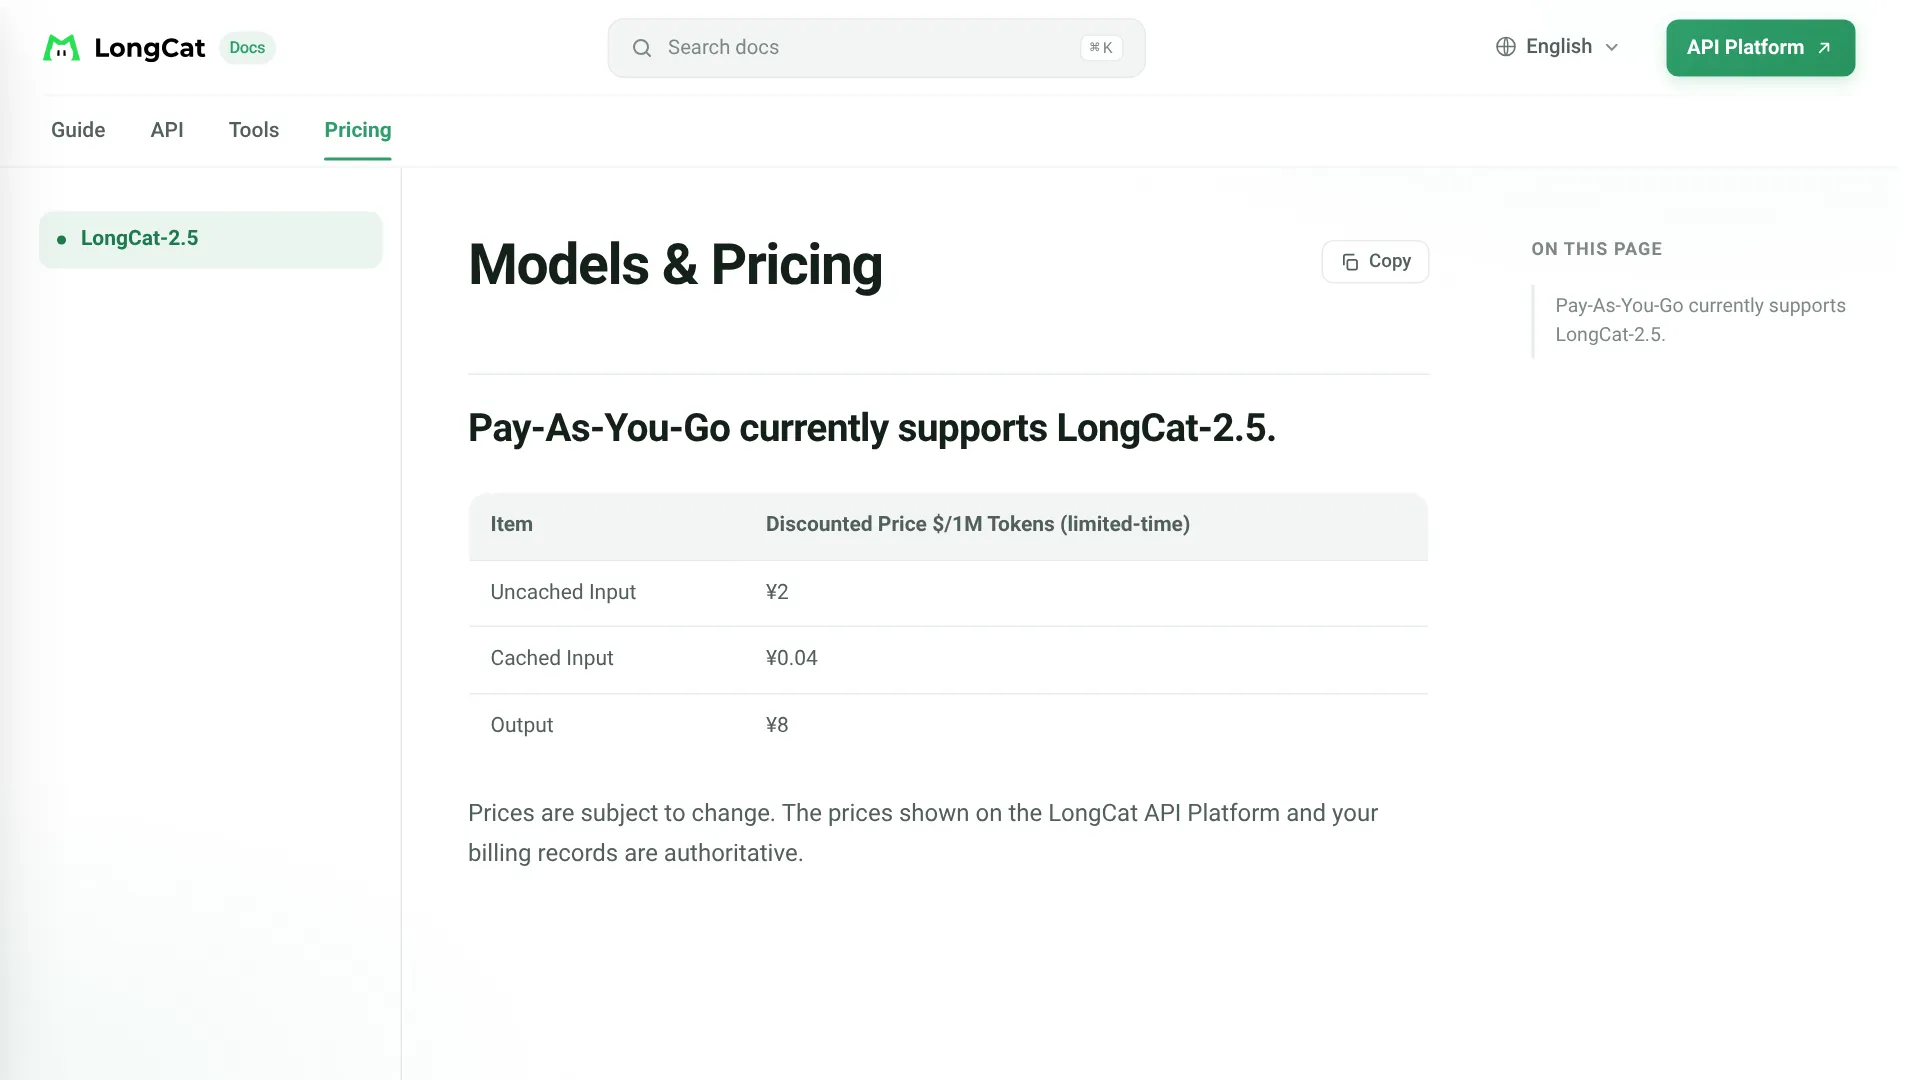
将来的に大幅な値上げがある可能性を示す材料もある。ZenMuxでは、割引前のPreview料金として入力0.75ドル、出力2.95ドルが示されていた。Artificial AnalysisもLongCat-2.0を同じ0.75ドル/2.95ドルで掲載している。キャンペーン料金の約2.5倍であり、キャンペーン料金が想定される通常料金の約40%にあたる計算だ。Meituanの中国語料金ページについては、Hokaiが11月3日に確認した内容として、100万トークンあたりキャッシュなし入力が2元、キャッシュ済み入力が0.04元、出力が8元と記載されている。
Token Packsとエンタープライズ向け段階料金
| 月間利用額 | エンタープライズ割引 |
|---|---|
| $75以上 | 10% |
| $300以上 | 20% |
| $1,200以上 | 30% |
| $6,000以上 | 40% |
- Token Packs:固定枠で有効期間は30日。フラッシュセール期間があり、枠は先に消費される。キャッシュヒットは無料で、キャッシュミスと出力が枠を消費する。未使用分は自動返金される。
- 従量課金:残高に有効期限はなく、カードとGoogle Payに対応。401、403、429、500の失敗リクエストは課金されない。
- エンタープライズ向け段階料金は毎月リセットされ、Token Packの利用分とキャンペーンクレジットは対象外。
提供ルートを比較:料金が同じでもリスクは異なる
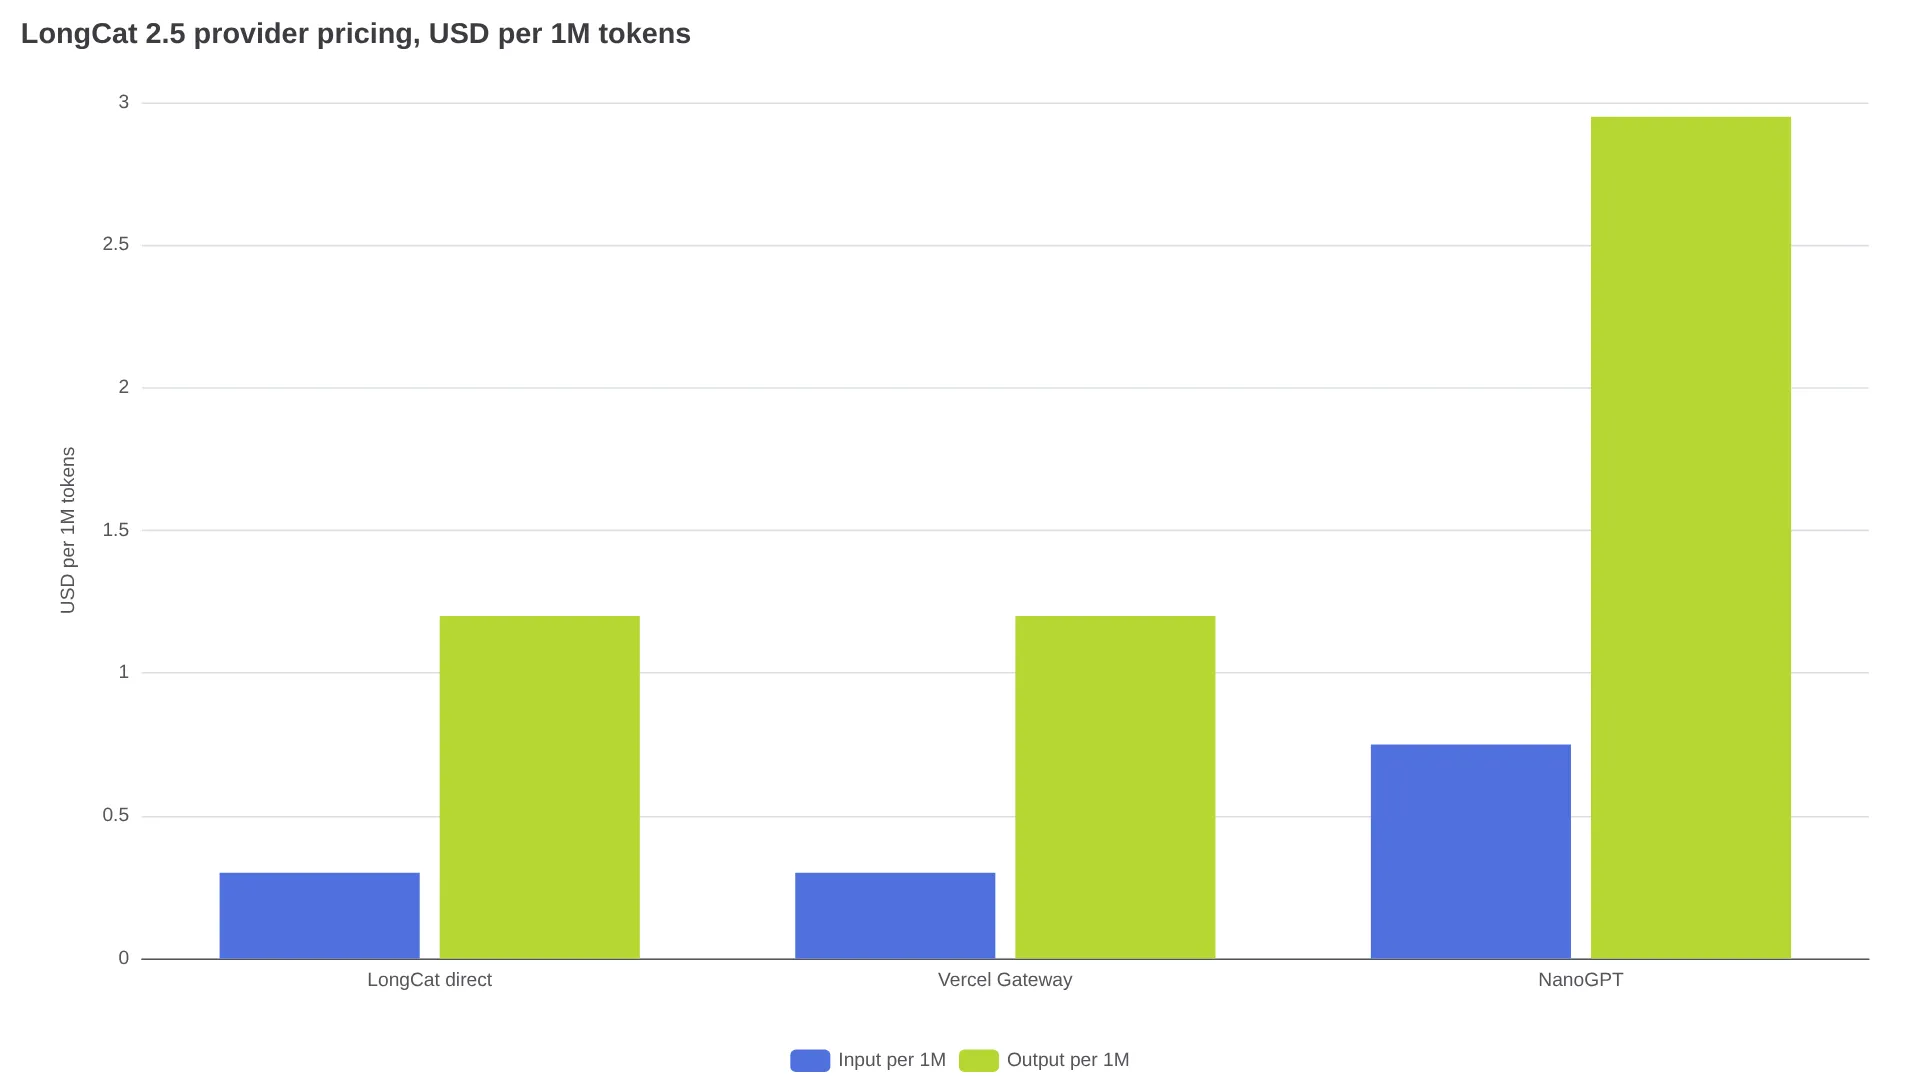
LongCat 2.5のプロバイダー料金は一見横並びだが、品質と規約まで見ると違いが出てくる。
| ルート | 入力/100万 | キャッシュ済み/100万 | 出力/100万 |
|---|---|---|---|
| LongCat直提供 | $0.30 | $0.006 | $1.20 |
| Vercel AI Gateway | $0.30 | $0.006 | $1.20 |
| NanoGPT | $0.75 | $0.015 | $2.95 |
LongCat公式APIは、キャッシュ状況を直接確認でき、Token Packも利用できるファーストパーティーのルートだ。Vercelは、トークン料金自体は同じでも、ゲートウェイクレジット、ルーティング、上限、プロバイダー規約が加わる。OpenCodeのPreview無料期間は別個のクライアント側キャンペーンであり、ファーストパーティーAPIが無料だという意味ではない。
キャッシュを多用する場合は混合計算で有利になるが、常にそうとは限らない。TokenPricingは入力と出力を3対1、入力の半分をキャッシュ済みとして計算し、100万トークンあたり0.4147ドルとしている。一方、Hokaiはキャッシュなしで3対1の比率を使い、0.525ドルと算出。LongCat-2.5を94モデル中27位、中央値1.63ドルの比較対象としている。どちらの計算も、実際のハーネスでキャッシュヒット率が低かったり、長い推論トレースが生成されたりすれば、前提は崩れる。
利用ルートを選ぶ前に、3点を確認したい。掲載モデルIDがLongCat-2.5なのかpreview別名なのか。キャッシュヒットが利用量のペイロードに表示されるのか。データ規約、出力上限、再試行ポリシーがLongCat公式APIドキュメントと一致しているのか、だ。
ベンチマークはベンダー実施。数字は割り引いて読む
LongCat 2.5のベンチマークを評価する際は、出典をまず確認する必要がある。Meituanの表にあるLongCat-2.5のスコアはすべてベンダー自身による測定だ。競合モデルの一部は公開報告から引用され、別の一部はMeituanが再実行した参考値にすぎない。11月3日時点で、Artificial AnalysisもOpenRouterもLongCat-2.5を掲載していなかった。
| ベンチマーク | LongCat-2.5 | 比較対象の最高スコア |
|---|---|---|
| Terminal-Bench 2.1 | 88.4 | 90.6 DeepSeek V4.1 Flash |
| Terminal-Bench 4.0 | 38.5 | 53.9 Opus 5 |
| DeepSWE 1.1 | 64.6 | 74.2 DeepSeek Flash |
| NL2Repo | 60.5 | 75.3 Opus 5 |
| BrowseComp | 91.9 | 91.5 DeepSeek Flash |
| VideoMME | 85.2 | 90.0 Kimi K3 |
旧版のTerminal-BenchとBrowseCompではほぼ互角だが、より難しいターミナル、リポジトリ、プログラム開発系のテストでは明確な差がある。また、Kimi K3.1 Pro、GPT-6 Astra、Claude Opus 5.5といった新しい競合モデルは比較表に含まれていない。
見落とされがちな規約:データ利用、temperature固定、SLAなし
企業コードに使えるかどうかは、ベンチマークよりLongCat 2.5のデータ規約と運用条件で決まる。API規約では、エンタープライズ契約や別途の書面合意で変更されない限り、入力、出力、フィードバックをサービス最適化、ブランドプロモーション、マーケティングに利用できる無償の世界規模ライセンスをLongCatに与える。APIサーバーはフランクフルト、香港、中国本土に置かれる可能性があり、準拠法はシンガポール法、紛争解決はSIAC仲裁となる。
- サンプリング設定が固定されるため、低temperatureによる再現性の確保はできない。音声入力と画像生成にも対応しない。
- データ保持期間もSLAも公開されていない。セルフホスティングは、公開日未定の重みを待つ必要がある。
- 認証失敗、レート制限、サーバーエラーは課金されないが、成功扱いでも役に立たないレスポンスは通常どおり課金される。
「100万トークンのコンテキストウィンドウは本当にすごい。LongCat2.5を使っているが、このコンテキスト長を活かしたバグハンターとしては確実に優秀だ」— @alexokita。
100万トークンのウィンドウは、まさにこの「バグハンター」として使うのが安全だ。明確なエラーコードに対する範囲を限定した修正に使い、人間がレビューする。監督なしのリファクタリングを任せる用途ではない。
エージェントにLongCat 2.5を呼ばせるべきか
LongCat 2.5を採用するかは、どこまで監督できるかと、機密性をどう扱うかで決まる。キャッシュを多用する長時間エージェント、スクリーンショットからのフロントエンド実装、画像入力によって説明の手間を減らせるブラウズ+開発型の調査には向いている。Claude Code、Codex、OpenCodeをコスト重視で使うユーザーにも候補になる。
| LongCat 2.5を使うケース | 他を検討したいケース |
|---|---|
| 大きなコンテキストを繰り返し使い、高いキャッシュヒット率を見込める | エンタープライズ規約なしで、規制対象または極めて機密性の高いコードを扱う |
| 明確なエラーコードを起点にした、範囲の限定されたバグ修正 | 自律的な複数ファイルのリファクタリング |
| 差分をレビューでき、受け入れ可能な結果1件あたりのコストを測定できる | 低いtemperatureの固定、SLA、すぐに利用できるセルフホスティングが必要 |
解決していないトレードオフは、キャンペーン料金と実力の裏付けだ。0.30ドル/1.20ドル、キャッシュ0.006ドルというLongCat-2.5は、入力5ドル/出力25ドルのClaude Opusの料金に対し、入力だけなら約16分の1に抑えられる。一方、Meituan自身の表でも、難しいターミナル系とリポジトリ系のテストではOpus 5が上回る。まず自分のハーネスでメーター付きの試験を行い、DeepSeek V4.1 FlashやGLM系の低価格ランナーと、受け入れ可能な結果1件あたりのコストを比較したい。そのうえで、割引によるメリットが監督コストを上回るか判断するべきだ。
関連記事:コーディング向けDeepSeek V4.1 Flash 1017レビュー、GLM 5.3のベンチマークと料金、Kimi K3.1 Pro API料金ガイド。
LongCat 2.5 API料金 FAQ
LongCat 2.5 APIの料金はいくらですか?
LongCat 2.5 APIのキャンペーン料金は、キャッシュなし入力が100万トークンあたり0.30ドル、キャッシュ済み入力が0.006ドル、出力が1.20ドル。出力はキャッシュなし入力の4倍なので、長い推論トレースを生成すると請求額が大きく膨らむ。
0.30ドルの料金は恒久的ですか?
いいえ。MeituanはLongCat 2.5の料金を終了日未定の期間限定としており、通常料金は公開していない。値上げシナリオとして、Preview時代の0.75ドル/2.95ドルを基準に予算を組んでおきたい。
LongCat 2.5はオープンソースですか、それともAPIのみですか?
2026年11月初旬時点で、LongCat 2.5はAPIのみ。GitHubとHugging Faceには日付もライセンスもないまま「Coming soon」と表示されている。一方、ダウンロード可能なMITライセンスの選択肢としてはLongCat-2.0が残っている。
LongCat 2.5はClaude CodeやOpenCodeで使えますか?
使える。LongCat 2.5は、モデルIDLongCat-2.5でOpenAI Chat Completions、OpenAI Responses、Anthropic Messagesに対応する。LongCat直提供またはゲートウェイにベースURLとモデル名を設定し、利用するルートでキャッシュ情報が報告されるか確認したい。
LongCat 2.5は企業コードに安全ですか?
企業コードに対するLongCat 2.5の安全性は、ベンチマークではなく契約条件で決まる。標準のAPI規約では、最適化やマーケティングのために入力と出力を再利用できるため、規制対象や機密性の高い作業には、データ利用に関する除外条項を盛り込んだエンタープライズ契約が必要だ。
本番版のLongCat 2.5はPreviewと違いますか?
違う。Previewは9月25日に画像理解を備えて公開され、本番版は11月1日から2日にかけて動画入力と、エージェント動作を再訓練したモデルとして提供された。公開されている失敗報告の多くはPreview版を対象としているため、本番版の信頼性については、まだ独立した再検証が必要だ。