 AIREITER
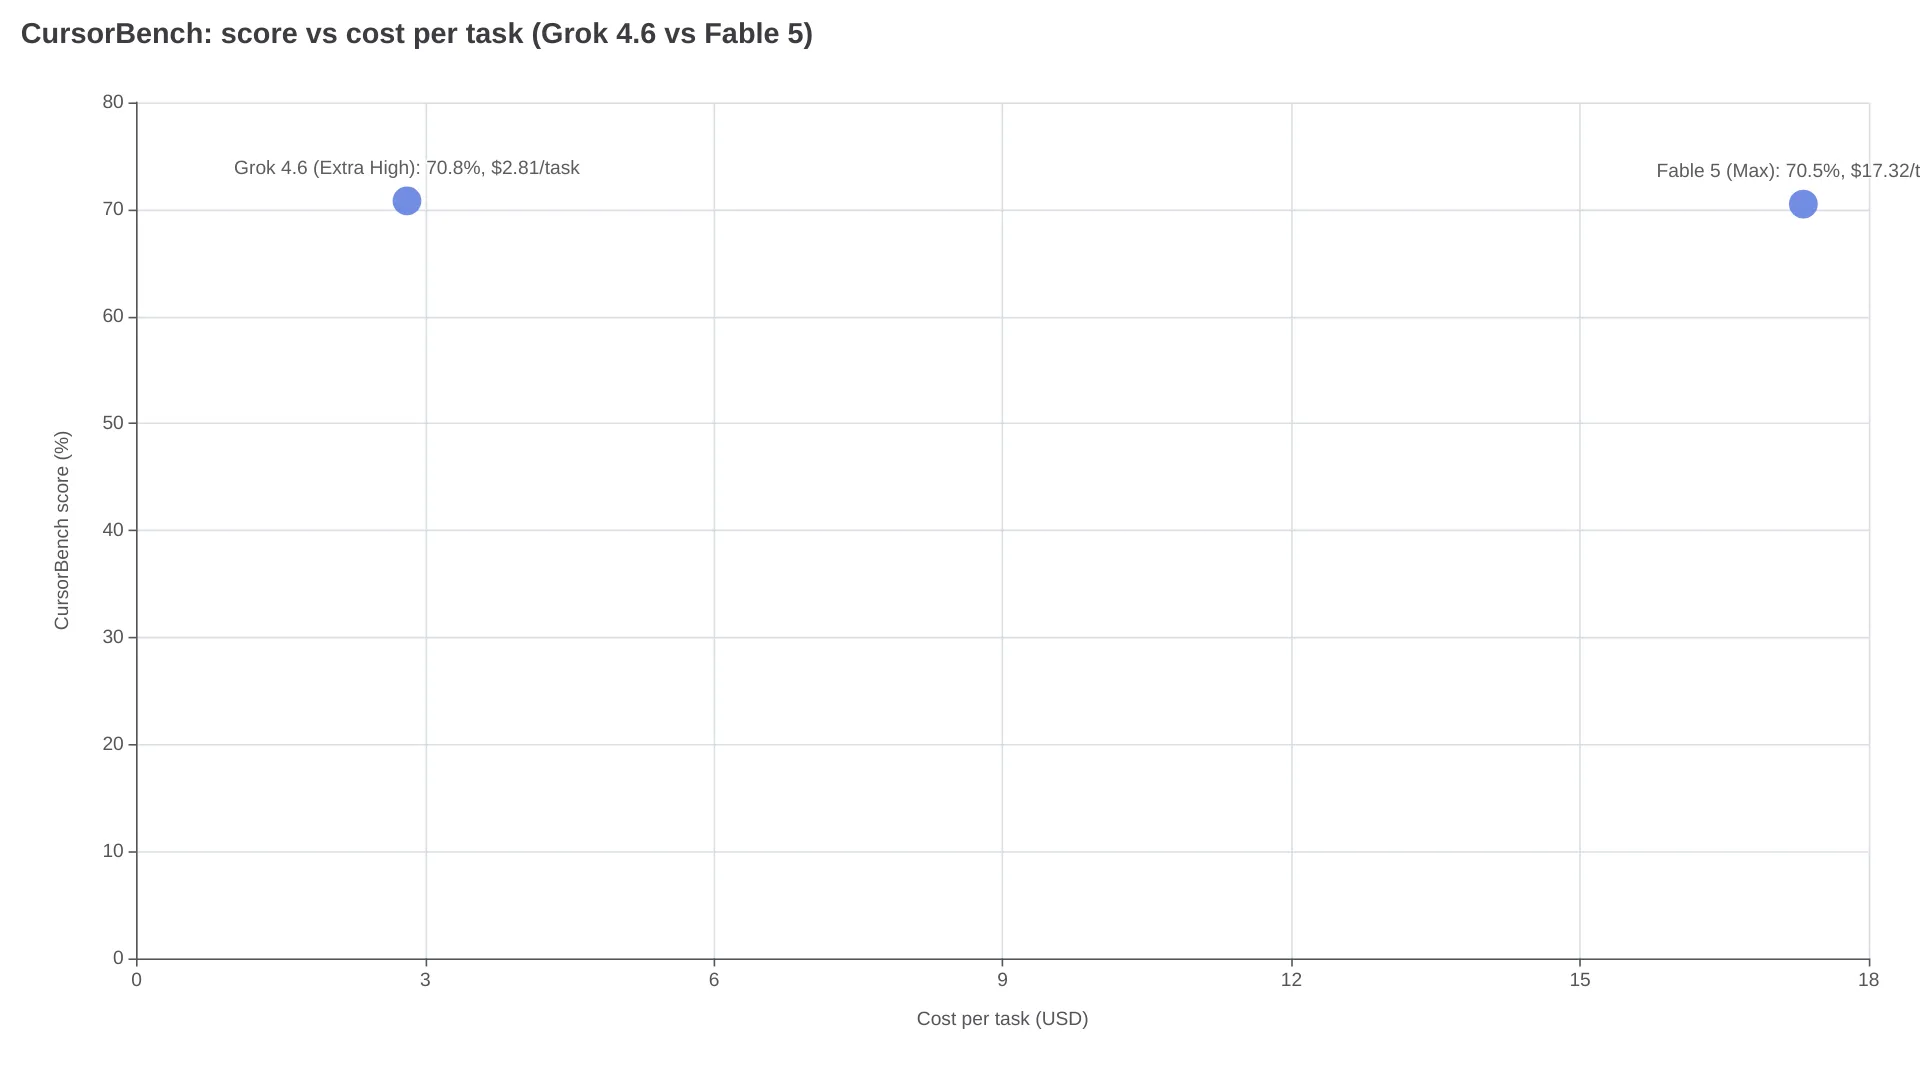
コーディングエージェントとしてのCursorBenchでは、Grok 4.6 Extra Highが70.8%、Fable 5 Maxが70.5%だった。同じエージェントハーネスでの比較なら、実質的には引き分けと見てよい。一方、完了タスクあたりのコストはGrokが$2.81、Fableが$17.32。性能が拮抗する中で、コストには約6倍の開きがある。ただし総合的な知能指数ではFable 5がなお上位で、コンテキストウィンドウも2倍だ。
Grok 4.6でFable 5との差はどこまで縮んだか
2か月前なら、この比較の答えはもっと明確だった。2026年7月、Artificial AnalysisのIntelligence Indexでは、Grok 4.5が56、Fable 5が62。6ポイント差でFable 5がリードしていた。2026年8月に登場したGrok 4.6は、報告されたベンチマーク差分から推定すると約5ポイント伸びて~59に到達し、GPT-5.6 Solとほぼ並んだ。Fable 5との差は約3ポイントまで縮小した計算になる。
コーディングエージェントの比較では、さらに差が詰まっている。Fable 5は2026年6月にCursorへ登場し、CursorBenchで72.9%という当時の最高スコアを記録した(r/accelerate)。それまでの最高値を8ポイント上回る結果だった。Grok 4.6のリリース後、8月にr/cursorへ投稿された直接比較では、Grok 4.6 Extra Highが70.8%、Fable 5 Maxが70.5%を記録。同一のエージェントハーネス内では、ほぼ同点といえる。もっとも、この比較を実行したCursorユーザーは重要な留保も示している。
「Grok 4.6を見て考え込んだ。CursorBenchの結果は、どこまでがモデルの実力で、どこまでがハーネスの力なのだろう?」 - r/cursor thread, August 2026
ベンチマークスコアが測るのは、基盤モデル単体ではない。プロンプトの足場、ツール、リトライを含むエージェントスタック全体だ。加えて、Fable 5のローンチ時の72.9%と8月時点の70.5%は異なる構成で得られた数値なので、どちらも方向性を示す材料として扱うべきだろう。
完了タスク単価ではGrok 4.6が圧倒的に有利
8月の比較で特に注目すべきなのは、タスク単価の差だ。
| 指標(CursorBench) | Grok 4.6 Extra High | Fable 5 Max |
|---|---|---|
| スコア | 70.8% | 70.5% |
| タスクあたりのコスト | $2.81 | $17.32 |
| タスクあたりのステップ数 | 46 | 72 |
Fable 5はほぼ同じスコアに到達するまでに、57%多いエージェントステップを必要とした。その追加ステップと、そこで消費される推論トークンがコスト差につながっていると考えられる。このため、両モデルを使い分ける開発者の間では、そもそも表示上のトークン単価で比較することへの疑問も出始めている。
「$/tokenは、AIエージェントを比較する尺度として間違いつつある。」 - r/grok thread title, August 2026
トークン単価の公表価格も、この差を部分的に説明できる。Fable 5はAnthropic APIで、入力100万トークンあたり$10、出力100万トークンあたり$50。Grok 4.5のxAI API公表価格は、200Kトークン以下のプロンプトで入力$2、出力$6だった。xAIは4.6専用の料金表を公表していないが、r/grokコミュニティでは4.6を「API価格のごく一部でSol級の性能」と報告している。Fable 5の各ティアにおける料金は、Fable 5 API pricing breakdownを参照してほしい。
ただし、実運用ではこの優位性が縮まる場面もある。xAIの公表価格によれば、Grokは200Kトークン超のプロンプトで料金がおおむね2倍になる(このティアでは100万トークンあたり入力$4、出力$12)。また、ワークフローの大半をFable 5に依存しているなら、モデルを切り替える前にFable 5 token costsを削減する構造的な方法もある。
Fable 5がまだ優位な領域
| 領域 | 根拠 | 実務での意味 |
|---|---|---|
| 知能指数 | Fable 5はAA Intelligence Indexで依然1位。62に対し、Grok 4.6はおよそ59 | 4.6で差は縮んだが、以前の6ポイント差のうち3ポイントは残っている |
| コンテキストウィンドウ | Fable 5は1,000,000トークン、Grokは500,000トークン | 大規模リポジトリとタスク履歴を一度に収めやすく、200K超のティアではGrokの価格優位も小さくなる |
| 最難関タスクの信頼性 | TryAIのビルドテストでは、Fable 5は初回で3Dルービックキューブを描画し、最良のSVGを生成。Grok 4.5は再実行が必要だった。Goldie Benchでは、47件のワンショットタスク中、Fable 5が20対17でリードし、シェーダーとGPU物理演算のビルドでは0.8~1.6ポイント上回った | 曖昧で一発勝負のタスクでは、Fable 5の推論能力の上限が表れる |
速度・レイテンシ・スループットの比較
TryAIの測定値は、同一プロバイダ経由、400トークン上限、プロンプト種別ごとに3回実行という条件のものだ。
| 指標 | Grok 4.5 | Fable 5 |
|---|---|---|
| 最初のトークンまでの時間 | 0.44秒 | 3.47秒 |
| スループット | 110 tok/s | 28 tok/s |
| 返信あたりのコスト | $0.00002 | $0.00009 |
| 成功率 | 100% | 100% |
Grokの生成速度は110 tok/sで、GPT-5.5やOpus 4.8のおよそ2倍、Fable 5の28 tok/sと比べると約4倍だ。Artificial Analysisは、最大努力の推論設定におけるFable 5のさらに厳しい数値も示している。最初の回答トークンまで113.68秒で、Grokの8.68秒を大幅に上回る。ただしストリーミング開始後はFable 5のデコード速度がわずかに速く、63.1 tok/s対58.9 tok/sとなる。実際の使用感に置き換えると、対話的な反復作業ではGrokが軽快で、Fable 5は長い思考を先に積み、その分だけ待ち時間が発生する。
利用方法、サブスクリプション、エージェント連携
Fable 5はAnthropic API、Claude Code、Cursorで提供されており、API以外の利用の大半は定額のClaude Proサブスクリプションでカバーされる。CLAUDE.md、プラグイン、スキル、MCPサーバーといったClaude Codeのエコシステムは、長年かけて成熟してきた。
Grok 4.6はxAI APIおよびGrok Build CLI(curl -fsSL https://x.ai/cli/install.sh | bash)で利用でき、X Premiumにはチャットアクセスが含まれる。ClockedCodeによると、Grok Buildは既存のCLAUDE.md、Claude Codeプラグイン、スキル、MCPサーバー、エージェント、フックを設定不要で読み込める。CI向けには-pフラグでヘッドレス実行が可能で、埋め込み用途向けにAgent Client Protocolも公開している。エコシステム自体はまだ新しいが、Claude Codeとの互換性により、対応構成であれば移行コストはほぼゼロに抑えられる。
両者に共通する課金面の現実もある。Claude ProとX Premiumの契約者は定額料金を支払うため、料金表そのものよりも、実際のワークロードでどの程度の利用制限に当たるかのほうが重要だ。
用途別の選び方
| 状況 | 選ぶべきモデル | 理由 |
|---|---|---|
| 大量処理が必要で、要件が明確なコーディング作業 | Grok 4.6 | CursorBenchで同等のスコアながら、$2.81/タスク対$17.32 |
| 大規模リポジトリでの正確性重視の作業 | Fable 5 | 1Mのコンテキストウィンドウ、知能指数1位、初回成功率の高さ |
| 対話型エージェントでの高速な反復 | Grok 4.6 | 最初のトークンまで0.44秒、110 tok/s |
| 曖昧なワンショット開発、最も難しい推論 | Fable 5 | TryAIの最難関タスクとGoldie Benchの直接比較で勝利 |
| API予算が厳格に決まっている場合 | Grok 4.6 | 出力トークン単価はFable 5のおよそ8分の1 |
私の見方では、範囲が限定され反復性の高い作業はGrok 4.6を標準にし、誤答のコストがトークン代を上回る仕事でFable 5を使うのがよい。実際に一定の利用量があるチームなら、両方を運用し、代表的なタスク規模、リトライ率、完了タスク単価で振り分けるべきだ。どちらか一方に固定するより、そのほうが安くつく。
よくある質問
コーディング用途ではGrok 4.6のほうがFable 5より優れている?
CursorBenchではほぼ互角だ。8月の比較ではGrok 4.6 Extra Highが70.8%、Fable 5 Maxが70.5%だった。ただし、より広範なArtificial Analysisの知能指数ではFable 5がリードしており、62対~59となっている。また、最難関のワンショットタスクでもFable 5が優勢だ。「優れているか」は、ボトルネックがタスク単価なのか、それとも正確性の上限なのかで変わる。
Grok 4.6はFable 5より安い?
はい。完了したCursorBenchタスクあたりでは、$2.81対$17.32でおよそ6分の1だ。トークン単価の比較では、xAIが4.6専用の料金表を公開していないため、Grok 4.5の公表価格を使っている。出力100万トークンあたり$6で、Fable 5は$50だ。ただし200Kトークンを超えるとGrokの料金はおおむね2倍になり、差は縮小する。
コンテキストウィンドウが大きいのはどちら?
Fable 5だ。1,000,000トークンで、Grokの500,000トークンの2倍にあたる。コードベース全体をコンテキストに保持するワークロードでは、この差がGrokの価格優位を上回ることがある。
Grok Buildは既存のClaude Code環境を使える?
使える。Grok BuildはCLAUDE.md、Claude Codeプラグイン、スキル、MCPサーバー、エージェント、フックを移植不要で自動的に読み込む。加えて、Grok固有の設定には独自の.grok/ディレクトリを使用する。
Grok 4.5のベンチマークはGrok 4.6の代用になる?
能力の比較にはならない。Grok 4.6は4.5比でIntelligence Indexを約5ポイント伸ばし、Fable 5に対する6ポイント差を約3ポイントまで縮めた。CursorBenchでも、明確に後れを取っていた4.5とは異なり、Fable 5 Maxと並んでいる。この記事にある速度とトークン単価の数値は、同等のGrok 4.6測定値がまだ公表されていないため、Grok 4.5の測定値だ。
最後まで残るトレードオフ
リポジトリが50,000行あり、チケットの要件が曖昧で、失敗した試行の検証に1時間かかる場合でも、Grokのコスト優位が維持されるか。今回の比較にあるベンチマークでは、その問いに答えられない。Fable 5の1Mコンテキストと高い知能上限は、まさにそのケースのためにある。高価だが確度を取りにいくFable 5と、低コストでステップを回せるGrok 4.6。この差は十分に大きく、多くのチームが両方を有効な選択肢として残す理由になっている。
関連記事:Grok 4.6 vs GPT-5.6 · Grok 4.6 vs Opus 5 · Claude Sonnet 5 vs Fable 5