 AIREITER
ベンチマークでは強いのに、なぜGLM-5.2から乗り換えようとする開発者が多いのか。ArenaのCode Arena Frontend boardでは1,595 Eloで2位に入り、FrontierSWEでもClaude Opus 4.8との差はわずか1ポイントです。性能そのものへの不満は、ほとんど聞かれません。2026年6月の登場以降、開発者コミュニティで繰り返し話題になるのは、タスクの途中で尽きるCoding Planのクォータ、ピーク時間帯のエラー、そして長いエージェントループで実質コストを押し上げるトークン消費量です。GLM-5.2の代替を選ぶなら、まず自分がどの問題に当たったのかを見極める必要があります。
先に結論:乗り換え理由別のGLM-5.2代替候補
まずは判断を急ぐ人向けに、結論を5つに絞ります。根拠は後ほど詳しく見ていきます。
- クォータ消費・エージェントループのコスト:DeepSeek V4 Flash。入力$0.14/M、出力$0.28/M、コンテキストは1M。
- エージェントループの不安定さ:Kimi K2.7 Code。入力$0.95/M、出力$4.00/M。
- 最難関タスクでの性能上限:Claude Opus 4.8。SWE-MarathonはGLM-5.2の2倍のスコアだが、価格はクローズドモデル水準。
- セルフホスティング・データ管理:Qwen3-Coder(Apache 2.0)。あるいは、4ビット版に372~475 GBのRAMを用意できるなら、GLM-5.2自身のMITライセンス重みも選べます。
- 不満はなく、単に新しいGLMを使いたい:GLM-5.3。Z.aiがローンチ日に確認したとおり、価格は同じ$1.40/$4.40です。
GLM-5.2の強みと、運用で見えてくるコスト
Z.aiの公式ドキュメントによると、GLM-5.2はテキスト専用のフラッグシップモデルです。コンテキストウィンドウは1Mトークン、最大出力は128Kトークン。API価格は入力$1.40/M、出力$4.40/M、キャッシュ済み入力$0.26/Mです。重みはMITライセンスで公開されており、2026年6月13日に当初はGLM Coding Plan限定で展開された後、6月16日にリリースされました。モデルカードのスコアはTerminal-Bench 2.1が81.0(Opus 4.8は85.0)、SWE-bench Proが62.1(Opus 4.8は69.2)、FrontierSWEが74.4(Opus 4.8は75.1)です。
クローズドな最先端モデルに迫る性能を、オープンウェイト級の価格で使える。それがGLM-5.2の魅力です。ただし、利用者がつまずくのは運用面です。Coding PlanのPro tierは5.2の登場前後に月額$35未満から$65へ上昇し、その変更は@bridgemindaiが当日に記録しています。とはいえ、価格以上に不満を集めているのはプラン内のクォータです。
「GLM 5.2なら、週次のレート制限を1日で使い切れる。」— u/intl_spy、r/opencode
「GLM-5.2は好きだけど、とにかくトークンを食う。」— @atomtanstudio
実務で自己進化型エージェントをGLM-5.2に走らせた開発者は、週末1回で$500超を消費したと報告しています。途中でモデルを切り替えるとKVキャッシュが失われ、同じコンテキストへの料金をもう一度支払うことになる、という指摘です(@Xianbao_QIAN)。このモデルの費用対効果については、別の開発者が端的にこう述べています。
「GLM 5.2は優秀だが、月額$200のCodexサブスクリプションのほうが、GLM 5.2 APIを$200使うより利用量が多い。補完的なモデルとしては素晴らしいが、置き換えにはならない。」— @mweinbach
さらにピーク時間帯のキャパシティ問題もあります。GLM-4.5からのプラン契約者である@gengdaJは、夜間になるとサーバーが「爆発」して古いモデルへフォールバックする、と説明しています。モデルを気に入っている人まで「GLM-5.2 alternatives」を検索する理由は、ここにあります。
代替モデル一覧:価格と乗り換え理由で比較
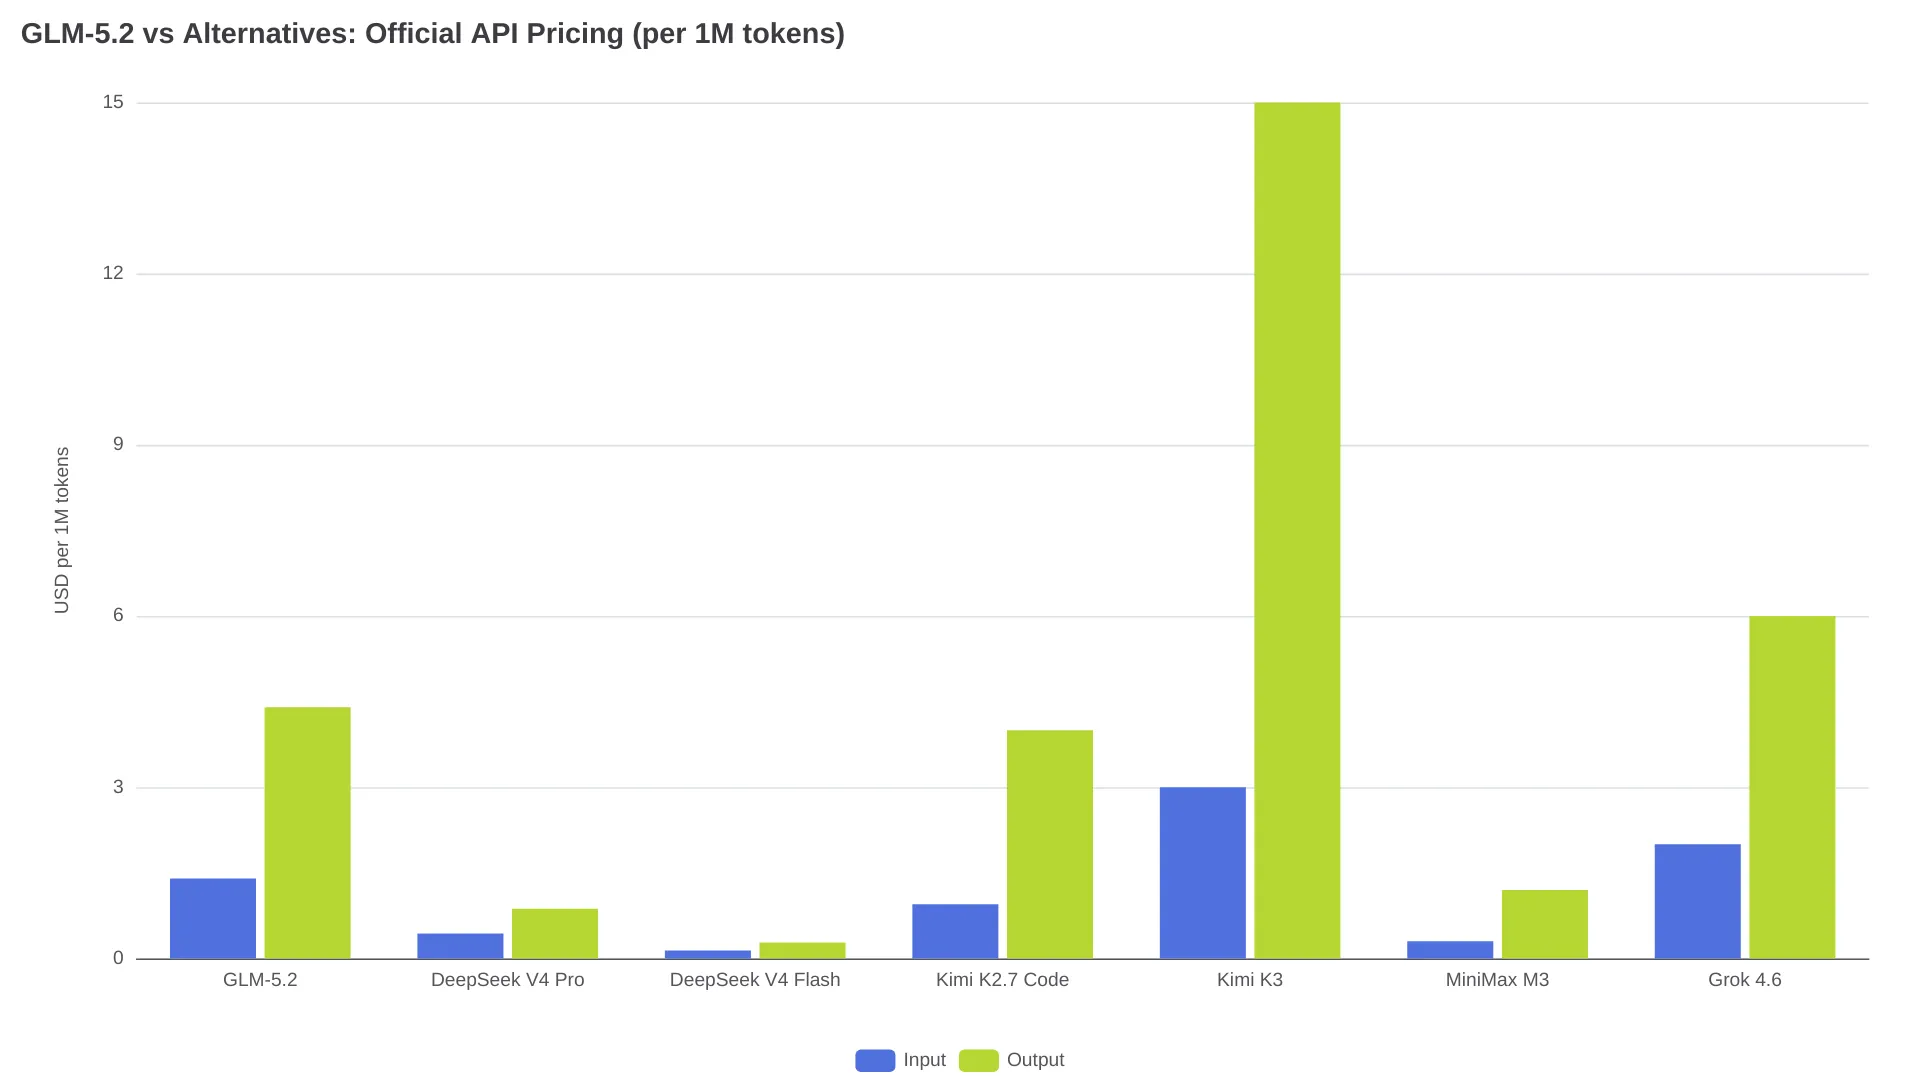
以下の価格はすべて、2026年8月時点で各ベンダーの公式価格ページから確認したものです。Kimi K3とMiniMax M3はキャッシュミス時の入力価格であり、キャッシュヒット時の価格は大幅に低くなります。
| モデル | コンテキスト | 重み / ライセンス | API価格($/1M、入力 / 出力) | 乗り換えるべきケース |
|---|---|---|---|---|
| GLM-5.2(基準) | 1M | MIT | $1.40 / $4.40 | — |
| DeepSeek V4 Pro | 1M | Open(Layer3 LabsによればMIT) | $0.435 / $0.87 | 同じコンテキスト長で、難しい推論をもっと安く回したい |
| DeepSeek V4 Flash | 1M | Open | $0.14 / $0.28 | クォータ消費だけが問題 |
| Kimi K2.7 Code | 256K | Open(Modified MIT) | $0.95 / $4.00 | コンテキスト長よりエージェントループの信頼性を優先する |
| Kimi K3 | 1M | Closed | $3.00 / $15.00 | Kimiの安定性と1Mコンテキストの両方が必要 |
| MiniMax M3 | 1M | Closed | $0.30 / $1.20* | マルチモーダル入力、または大量・価格重視の処理 |
| Qwen3.8 Max / Qwen3-Coder | 1M | Apache 2.0 | 重みは無料、ホスト版は提供先により異なる | セルフホスティングやファインチューニングが目的 |
| Grok 4.6 | 500K | Closed | $2.00 / $6.00 | 速度と、十分に大きく扱いやすいコンテキストが欲しい |
この7モデルに加え、後半では2つのアップグレード先も扱います。最難関タスクで失敗し続けるチーム向けのClaude Opus 4.8と、同価格・同ファミリーで更新できるGLM-5.3です。
\* MiniMax M3のこの価格帯は入力が512Kトークン以下の場合に適用されます。これを超えると価格は2倍です。GLM-5.3はZ.aiのローンチ発表によるとGLM-5.2と同一価格のため、コスト比較からは除外しています。
症状別に選ぶ、GLM-5.2からの乗り換え先
クォータを使い切るなら:DeepSeek V4 Flashへ処理を振り分ける
価格差は明確です。キャッシュミス時の入力では、GLM-5.2の$1.40/MはDeepSeek V4 Flashの$0.14/Mの10倍。出力は$4.40と$0.28で、差は15.7倍です。エージェントループの実装フェーズ、たとえばファイル編集、テスト修正、定型コードの作成では、この差がターンごとに積み重なります。DeepSeekは同じ1Mトークンのコンテキストと、384Kの最大出力を提供しています。より難しい推論向けのV4 Proなら、$0.435/$0.87で値引き幅の大半を維持できます。使い分けはGLM-5.2 vs DeepSeek V4 Proの比較、低予算帯についてはV4 Flashとの直接比較で詳しく解説しています。
OpenCode Goの契約者コミュニティで定着しているのは、完全な乗り換えではなく役割分担です。GLM-5.2は計画とレビューに使い、消耗の大きい実装作業は安価なモデルに任せます。u/narkeesoは「OpenCode GoのGLM 5.2は計画にしか使わない」と書き、同じエコシステムのu/Endokyも「GLM 5.2はエスカレーション用、または計画用に限定する」と表現しています。
エージェントループが不安定なら:Kimi K2.7 Code
性能ではなくサービス品質が問題なら、調査したスレッドで最も名前が挙がった代替がKimiです。中国語で投稿されたあるユーザーの要約は、次のとおりです。
「モデルの能力はほぼ同じだが、安定して提供できないことが、GLMではなくKimiを選んだ理由だ。」— @wonjder
Kimi K2.7 Codeはコーディング特化の選択肢です。入力$0.95/M、出力$4.00/M、キャッシュヒット時は$0.19/M。コンテキストは262,144トークンで、GLM-5.2の4分の1です。ここが本質的なトレードオフになります。GLM-5.2がテキスト専用なのに対し、K2.7 Codeはテキスト、画像、動画の入力を受け付けるため、マルチモーダル対応も補えます。256Kではリポジトリ全体を収められない場合は、1MコンテキストのKimi K3を検討できます。ただし価格は$3.00/$15.00で、出力$15はGLM-5.2の3.4倍です。K3は節約のためではなく、安定性を買う選択です。ベンチマーク面はKimi K2.7 Code vs GLM-5.2比較を参照してください。
最難関タスクの成功率を上げたいなら:Claude Opus 4.8
コンパイラビルド、カーネル作業、数時間に及ぶ自律ジョブを対象とするSWE-Marathonでは、Opus 4.8が26.0、GLM-5.2が13.0です。NL2Repoでも69.7対48.9となっています。数値はZ.aiのモデルカードによるものです。同じモデルカードでは、GLM-5.2は両ボードで最高順位のオープンモデルとされています。ただし、タスクが長く難しくなるほど差は広がります。Opusはクローズドソースでセルフホスティングはできず、価格もプレミアム帯です。そのプレミアムが回収できる条件は、GLM-5.2 vs Opus比較で確認できます。
セルフホスティングとデータ管理なら:Qwen3-Coder、またはGLM自身の重み
Qwen3-CoderとQwen3.8 Maxは、1Mトークンのコンテキストを備え、Apache 2.0で提供されています。単一GPUでのサービングを想定したコンパクトな派生モデルもあります。Layer3 Labsとglm5.appの両方が、セルフホスティング向けとしてこのファミリーを挙げています。ファインチューニングやプライベート環境への導入を重視するなら、ここで挙げた代替候補の中では実用的な選択です。ファミリーの詳細はQwen 3.8 Maxのオープンウェイト解説にまとめています。
やや意外な選択肢として、MITライセンスを活かしてGLM-5.2自身をセルフホストする方法もあります。ただし必要なリソースは軽くありません。BF16の重みは1.51 TBを占有し、UnslothのGGUFリリースによる4ビット量子化でも、ロードに372~475 GBのメモリが必要です。実際には4ビット版でも複数GPUサーバー向け、完全なBF16はクラスタ規模になります。ローカル実行のツール群もまだ新しく、llama.cppにGLM-5.2のindexerサポートが入ったのは2026年7月24日です(PR #25407)。GLM-5.2のセルフホスティングは手軽さのためではなく、データ主権のための選択です。クラスタを用意できないなら、Qwenのコンパクト版がワークステーション級の代替になります。
マルチモーダル入力と低コスト大量処理なら:MiniMax M3
MiniMax M3は、1Mコンテキストとマルチモーダル入力を組み合わせ、入力$0.30/M、出力$1.20/Mで利用できます。これは入力512Kトークン以下の価格帯であり、しきい値を超えると両方とも2倍になるため、予算計画では注意が必要です。チーム予算向けには、MiniMaxのtoken plansが月額$20/$50/$120で用意されています。M3、M2.7、画像、音声のラインアップを対象とし、クォータは5時間ごとのローリングウィンドウと週次ウィンドウで計測されます。
速度を最優先するなら:Grok 4.6
Grok 4.6の価格は入力$2.00/M、出力$6.00/Mで、コンテキストは500Kです。xAIのAPIページは、ベンチマーク表を公開せずに業界最高水準のコーディングとツール呼び出しをうたっています。そのため、この主張はあくまでポジショニングとして受け取るべきです。ただし、利用者レベルの評価もあります。@bourneliu66は、自身の「big three」におけるGLMの枠をGrokが奪ったと述べ、より強く、速く、安いと評価しています。この順序を採用する前に、自分のワークロードで検証してください。
問題はないが最新のGLMを使いたいなら:GLM-5.3
GLM-5.3は2026年8月18日にAPIへ登場し、Z.aiの発表によればGLM-5.2と同じ価格です。代替候補を探している理由が不満ではなく、アップグレードへの不安なら、実際に何が変わったのかはGLM-5.2 vs GLM-5.3比較を確認してください。
完全移行ではなく、GLM-5.2を格下げするという運用
上のスレッドで繰り返し見られる着地点は、全面移行ではありません。GLM-5.2をプランナー兼レビュアーに回し、実行はより安価なモデルに任せる構成です。これはモデルの性格にも合っています。Z.aiはGLM-5.2を長時間稼働するエンジニアリングエージェント向けに位置付けており、一方で予算重視のモデル群と比べるとトークン単価は最も高い部類です。
この分割運用では、2つの仕組みが成否を左右します。1つ目はKVキャッシュの喪失です。実行途中でモデルを切り替えたり、同じモデルでも提供元を変更したりすると、コンテキスト料金が再び発生します。2つ目はプロバイダー差です。r/opencodeCLIのユーザーは、同一モデルを提供するFireworks、NeuralWatt、OpenCode Goの間で速度に大きな差があると報告しています。
運用面は、単一のOpenAI互換エンドポイントでまとめられます。両方の役割でGLM-5.2 APIのリクエスト形式を維持し、プロバイダーの品質が落ちたときは経路を切り替え、請求も一本化できます。ただしコンテキストが無料になるわけではありません。モデル間・プロバイダー間でキャッシュの再利用は引き継がれず、それが週末に$500を消費した報告の背景にあるコストです。切り替えは実行途中ではなく、タスクの境界で行うべきです。Claude Code内でこの分割構成を使う場合は、Claude CodeでGLM-5.2を使うガイドでハーネス側を解説しています。
30秒で選ぶ判断表
| 困っていること | おすすめ | 手放すもの |
|---|---|---|
| 週次クォータが1日で消える | DeepSeek V4 Flash | GLM比でのエージェント型コーディングの洗練度の一部 |
| プロバイダーエラーでエージェントループが止まる | Kimi K2.7 Code | 1Mコンテキスト(代わりに256K) |
| 最難関の数時間タスクに失敗する | Claude Opus 4.8 | オープンウェイト、低価格、セルフホスト |
| 自前のハードウェアで重みを動かしたい | Qwen3-Coder | GLMのElo首位級フロントエンドコーディング |
| 一般作業でトークンを使いすぎる | MiniMax M3 | 入力512K超では価格が2倍 |
| 規制対応または調達要件がある | セルフホストしたQwenまたはGLM重み | マネージドサービスの手軽さ |
| 最新のGLMを使いたい | GLM-5.3 | なし。同価格 |
FAQ
総合的に見て、GLM-5.2の最良の代替は何ですか?
総合力で最も近い代替はDeepSeek V4 Proです。1Mコンテキスト、オープンウェイト、トークン単価は3~5分の1です。長いエージェント実行でベンチマーク差より信頼性を重視するなら、Kimi K2.7 Codeのほうが適しています。
コーディングではDeepSeekのほうがGLM-5.2より優れていますか?
難しいアルゴリズム推論では、glm5.appの比較はDeepSeek V4 Proを上位に置いています。一方、長期的で複数ファイルにまたがるエージェント作業では、GLM-5.2の1Mコンテキストと長期エージェント向けの学習、つまりZ.aiが公表している専門領域が優位性を維持します。実務的には、DeepSeekが実行、GLMが計画です。
GLM-5.2の代替で最も安いのは何ですか?
DeepSeek V4 Flashです。入力$0.14/M、出力$0.28/Mで、キャッシュヒット時の入力は$0.0028/Mです。繰り返し使うコンテキストなら、実質的に無料に近い価格になります。
GLM-5.2と同じ1Mトークンのコンテキストを持つ代替はありますか?
DeepSeek V4 Pro、DeepSeek V4 Flash、Kimi K3、MiniMax M3、Qwen3.8 Maxはいずれも1Mトークンのウィンドウを掲げています。Kimi K2.7 Codeは256K、Grok 4.6は500Kで、1Mではありません。
乗り換えずにGLM-5.2をローカル実行できますか?
技術的には可能です。MITライセンスの重みが公開されています。ただし4ビット版でも372~475 GBのRAMが必要で、llama.cppのサポートがマージされたのも2026年7月24日です。大半のチームにとって、実用的な選択肢はホスト型APIアクセスのみです。
GLM-5.2の代替モデルをサブスクリプションで使う場合、月額はいくらですか?
MiniMaxのtoken plansは月額$20~$120です。Digital Appliedの価格調査によると、KimiのCode CLIは月額$19から、Z.aiのCoding Planは月額$18からです。Z.aiのPro tierは6月の値上げ以降、月額$65となっています。