 AIREITER
短く定型的なAPI処理なら、Claude Haiku 5.5はSonnet 5.5の20分の1という価格で使えます。境目は100,000トークンです。これを超えると価格差は4倍まで縮まり、エージェントのループ処理では多くのチームが思う以上に早く到達します。要約や抽出のような短い反復タスクにはHaiku 5.5で十分ですが、デバッグや複数ステップのコーディングでは、Sonnet 5.5の上乗せコストにはなお価値があります。
Haikuの20分の1価格が崩れる、100Kトークンの境目
Claude Haiku 5.5とClaude Sonnet 5.5は、コンテキスト容量の公称値こそ同じでも、請求額は大きく異なります。両モデルともコンテキストウィンドウは1Mトークン、最大出力は128Kトークンです。モデルIDはそれぞれclaude-haiku-5-5、claude-sonnet-5-5。AnthropicによるHaiku 5.5の発表とSonnet 5.5の発表によると、Sonnet 5.5は2026年9月28日、Haiku 5.5は2026年10月7日にリリースされました。Sonnet 5.5のClaudeプラットフォームドキュメントにも、1Mのコンテキストと128Kの出力上限が記載されています。
| 項目 | Claude Haiku 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| モデルID | claude-haiku-5-5 | claude-sonnet-5-5 |
| リリース | 2026年10月7日 | 2026年9月28日 |
| コンテキスト / 最大出力 | 1M / 128K | 1M / 128K |
| 100K未満の入力 / 出力 | 100万トークンあたり$0.10 / $0.50 | 100万トークンあたり$2 / $10 |
| 100K超プロンプトの入力 / 出力 | 100万トークンあたり$0.50 / $2.50 | 100万トークンあたり$2 / $10(段階制なし) |
| キャッシュ読み取り | 100万トークンあたり$0.01 | 100万トークンあたり$0.10 |
| デフォルトのeffort | medium | high |
価格はAnthropicのリストレートです。APIKOによるAnthropic料金のまとめによれば、Haiku 5.5はプロンプトトークンが100,000を超えた時点で、キャッシュの読み取り・書き込みを含むリクエスト全体に上位料金帯を適用します。
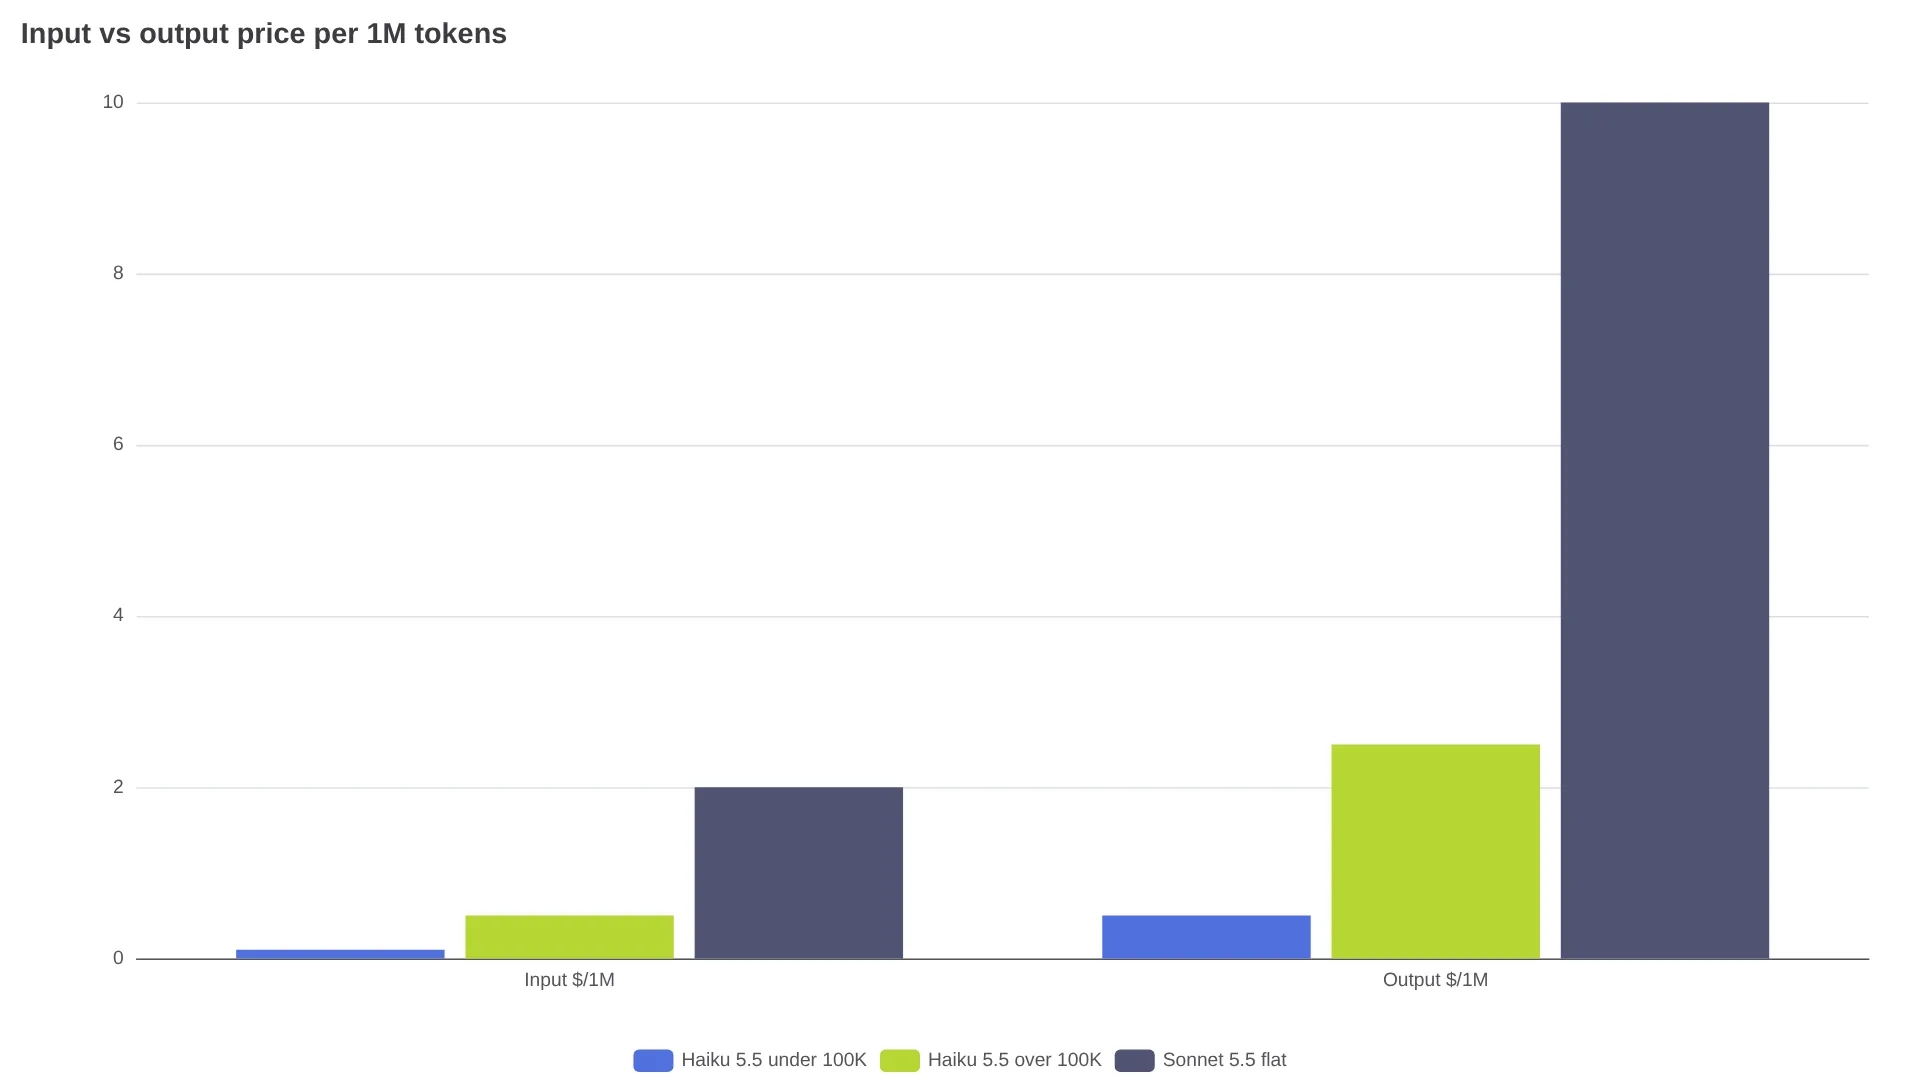
99Kトークンの同一文書を1,000件、それぞれ出力1Kトークンで処理する場合、リスト価格でのバッチ費用は約$10.40です。APIKOの料金では同じバッチが$4.54とされています。一方、101Kトークンの文書を1,000件処理すると、リスト価格では約$53.00。文書あたりわずか2,000トークン増えるだけで5倍になります。Sonnet 5.5で同じ101Kバッチを処理した場合は約$212.00です。この計算は、APIKOのHaiku 5.5対Sonnet 5.5テストに掲載されたリスト価格から算出されています。さらに、入力10K・出力1Kの呼び出しを1,000回行うモデルケースでは、Sonnet 5.5が合計$30.00、Haiku 5.5が$1.50となり、95%の削減です。これはSimのSonnet 5.5対Haiku 5.5料金比較によるものです。
実際のエージェントループは、意図せずこの閾値に達します。Haiku 5.5のトークン利用量を扱ったr/ClaudeAIのスレッドでは、あるユーザーがモデル呼び出しの20回目前後で100Kを超え、その後の164回中145回が上位料金帯になったと報告しています。履歴とツール出力が蓄積するためです。そのスレッドで挙げられた対策は、チケットを小さく分ける、対象ファイルを絞る、冗長なテスト出力を抑える、長く生きる1つの会話ではなく新しいサブエージェントを使う、といったものです。短いジョブならHaikuの低価格を維持できます。長大なコンテキストを扱うパイプラインでは、Sonnetの費用を予算に組み込む必要があります。
「Haiku 5.5の低価格は、コンテキストが100K未満であることが前提です。100K入力を超えると価格は5倍に跳ね上がります。翻訳や要約のような小さなジョブなら節約できますが、長文コンテキストの作業にはSonnetを使うべきです。」— @zookmas1314
各モデルをさらに詳しく見るなら、Claude Haiku 5.5 API pricingとClaude Sonnet 5.5 API review and pricingも参照してください。
ベンチマークで見えるHaiku 5.5とSonnet 5.5の差
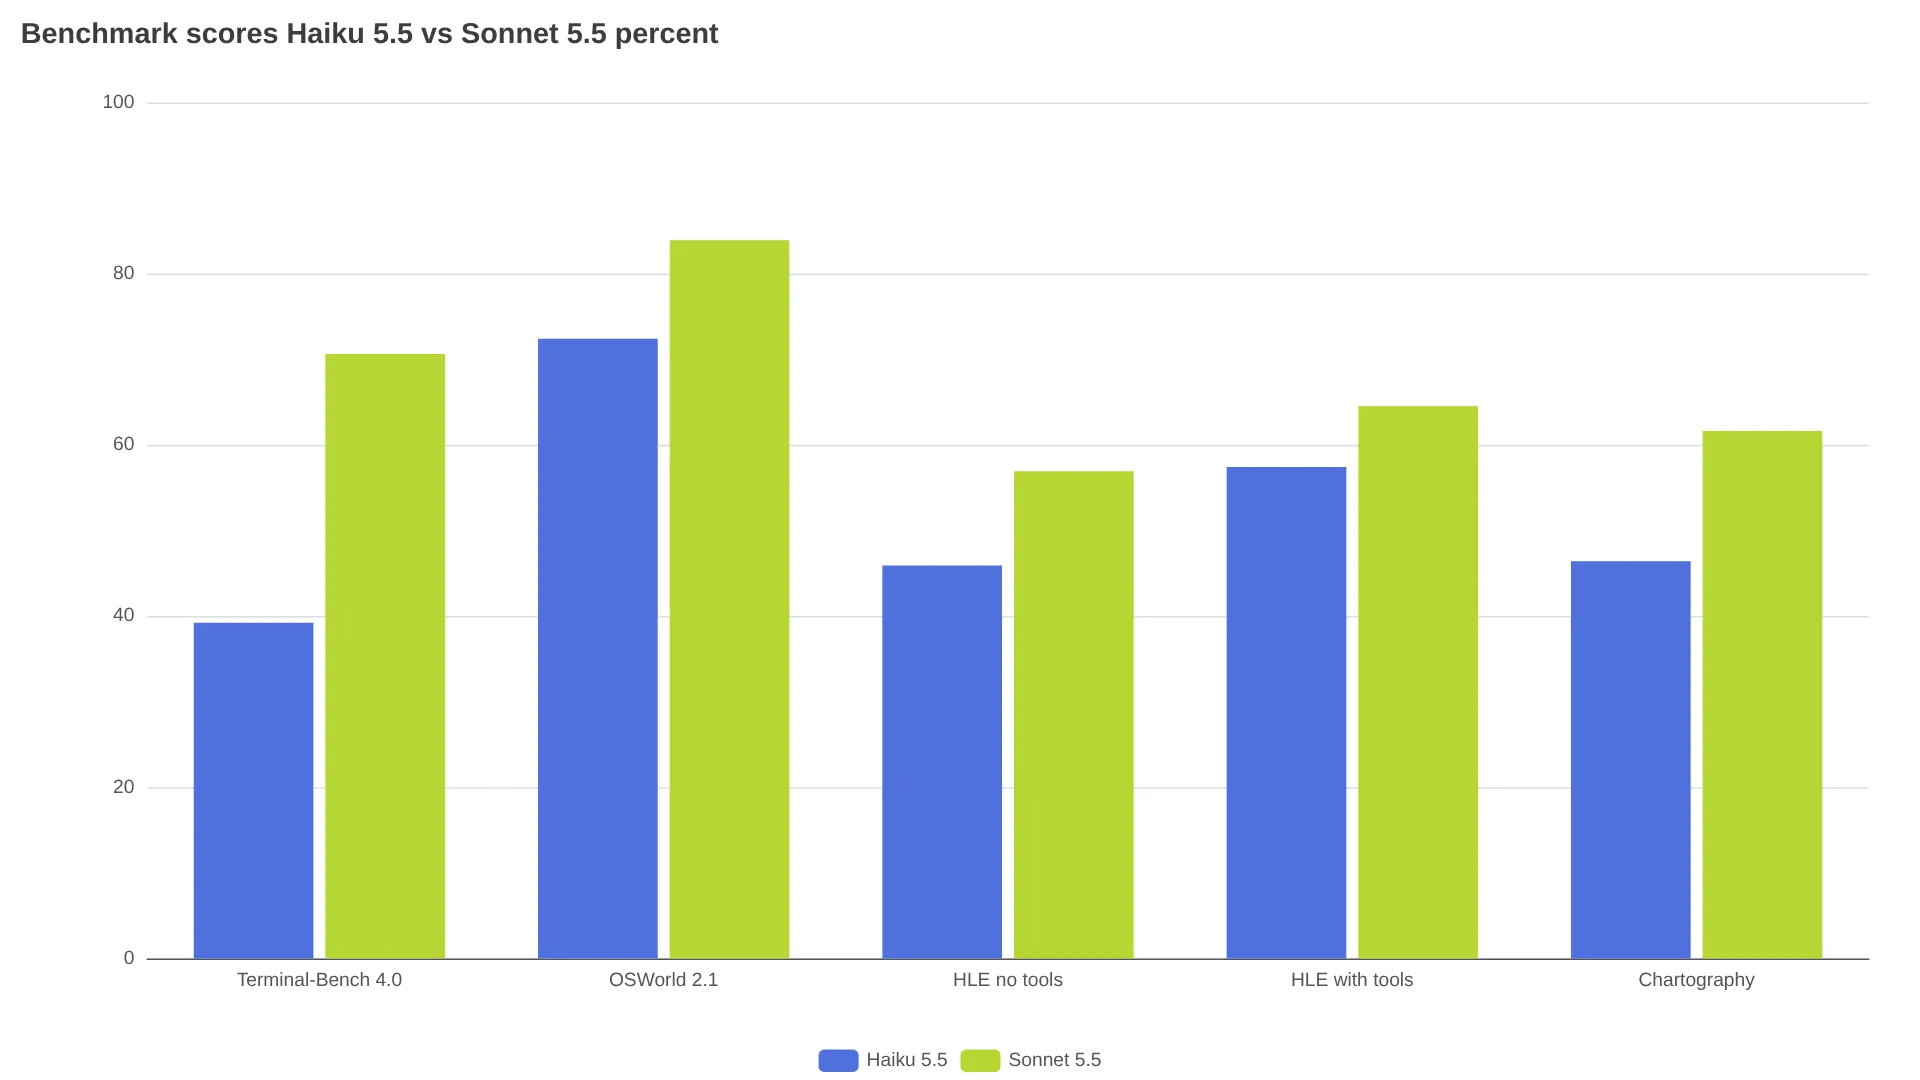
Anthropicが公開した直接比較では、報告されたすべての結果でSonnet 5.5が上回っています。差が最も大きいのは、エージェントがコードを書き、実行する領域です。エージェント型コーディングのTerminal-Bench 4.0は、Haiku 5.5が39.2%、Sonnet 5.5が70.6%。コンピュータ操作のOSWorld 2.1では72.4%対83.9%で、差は比較的小さくなります。ツールなしのHumanity's Last Examは45.9%対56.9%、ツールありでは57.4%対64.5%です。数値はAPIKOの比較記事にまとめられたベンチマーク表に基づきます。
ただしeffort設定によって、この差は縮まることも広がることもあります。同じ比較で引用されたArtificial Analysisの結果では、Haiku xhighとSonnet mediumはいずれもIntelligence Indexで41。Terminal-Benchのスコアも29.3%対29.8%とほぼ同等でした。一方、1タスクあたりのコストはHaiku xhighが$0.12、Sonnet mediumが$0.48で、所要時間は295秒対122秒です。このデータセットでSonnetのデフォルトであるhighのスコア47に到達したHaiku設定はありません。なお、このコストにはHaikuの100K超料金帯は含まれないため、長文コンテキストの処理では下限値として捉えるべきです。
範囲を絞った抽出や分類であれば、Sonnetのコーディング性能差は必要ありません。一方、主担当エージェントによる実装、長いツールループ、視覚的推論では違いが出ます。たとえばChartographyは46.4%対61.6%です。単一のEloやインデックス値を、あらゆる用途に通用する品質順位と見なすべきではありません。Redditのあるテストでは、Rustとレガシーコードが混在するコードベースでHaiku-mediumがSonnetと同等の結果を出し、費用は$1.68に対して$0.08でした。同じワークフローでHaiku-highは385リクエストを行ったものの、品質の向上はありませんでした。詳細はr/ClaudeCodeの統制されたHaiku 5.5コーディングテストにあります。
モデル名よりeffort設定が効く:Haiku lowとSonnet low
「Haikuは冗長だ」という不満の多くは、デフォルトのeffort設定で説明できます。Haiku 5.5のデフォルトはmedium、Sonnet 5.5はhighであり、thinkingの設定方法もモデルごとに異なります。Haikuでは{"type": "disabled"}でthinkingを無効化します。Sonnetはhigh以下のeffortで{"type": "between_tools"}を使い、xhigh/maxではadaptiveまたはthinking指定の省略を使います。これはClaudeプラットフォームドキュメントおよびAPIKOの挙動メモに記載されています。
APIKOが2026年10月10日に実施した、22タスク・Messagesエンドポイント528リクエストの評価では、Haikuのlowは66回中65回に合格しました。Sonnetは設定により64〜66回です。短いタスクに限れば、ゲートウェイコストはおよそ18分の1でした。thinkingを完全に無効化すると、Haikuは66回中56回まで低下し、CSVの合計やコードトレースなど、推論と厳密な形式を必要とする失敗に集中しました。デフォルトのmediumでは66回中66回に合格した一方、出力トークンはHaiku lowの4.4倍で、その大半はthinkingトークンでした。
このデータとユーザー報告から導ける実用的なルールは次のとおりです。
- まずはHaiku lowから:分類、ルーティング、抽出、短いJSONなど、範囲が明確なタスクはHaikuのデフォルト
mediumではなくlowで始めます。 - Sonnet lowの前にHaiku high/xhighを試す:Haiku水準の価格帯を保ちつつ品質を上げたい場合に有効です。APIKOの比較で引用されたArtificial Analysisの数値では、Haiku
maxは43、Sonnetlowは36で、コストは約60%でした。 - Sonnet medium以上は難所に回す:デバッグ、複数ステップの実装、長いツールシーケンスなど、Haiku-highの追加レイテンシが品質向上につながらない場面に割り当てます。
- 共有コードではthinkingをモデル別に明示する:1つのテンプレートからHaikuに
between_tools、またはSonnetにdisabledを送ると、APIKOのゲートウェイテストでは上流から400が返されました。
「メインのオーケストレーターとレビュー役はOpus/Sonnet、Haikuは実働担当にする。機能ごとに新しいHaikuインスタンスを使う。」— r/ClaudeAIのu/ohrajaaa
難易度ではなく、見逃しの影響でルーティングする
ルーティングで問うべきなのは「このタスクは難しいか」ではありません。「Haikuがもっともらしく誤り、誰もレビューしなかった場合に何が起こるか」です。引用した複数のユーザーテストは、ほぼ同じ傾向を報告しています。Haikuは判断を伴う作業で静かに失敗しやすく、検証コストが高い領域ではSonnetの価値が出ます。
| タスクの種類 | 主担当モデル |
|---|---|
| 感情分類、チケットルーティング、許可情報のJSON化、ログ要約、OCRとアノテーション、SQLの選択、圧縮用サブエージェント | Haiku 5.5 |
| コードベース検索、1ファイルの編集、1ターンで完結する文書処理 | Haiku 5.5 |
| 主担当のコーディングエージェント、実際のデバッグ、複数ステップのリファクタリング、ファクトチェック、文書の出典帰属 | Sonnet 5.5 |
ユーザーからは、1ターンで完結する大量処理のHaikuパターンにおいて、3倍の速度と大幅な利用量削減が得られたという報告があります。r/ClaudeAIの「What is Haiku 5.5 best suited for?」には、数MBの文書を数ドルで処理した例もあります。
6種類のタスクでサブエージェントを比較したテストでは、Haikuは安価である一方、リサーチと事実に基づく判断では信頼性が大幅に低く、見落としたファイルがあっても「きれいな結果に見える」と報告されています。出典はr/ClaudeCodeのHaiku対Sonnet対Opusサブエージェントテストです。このスレッドで示されたガードレールは明快です。
「出力が何らかのアクションを起こすなら……より大きなモデルに渡すか、より大きなモデルでチェックする。」— r/ClaudeCodeのu/vladgladi
本番運用で注意したいのは、Haikuでも構造化出力の準拠が無償で保証されるわけではない点です。APIKOの評価ではlowで厳密な形式を満たさない例が記録されました。ラベル自体は正しいものの、ベア配列で返すべきところをJSONオブジェクトで囲んでいました。また、同じ統制コーディングテストでは、低effort時に検証を省略したり制約を無視したりするとの報告もあります。
本番で使い続けられるHaikuファースト構成
APIKOによる10月10日の、ドキュメント記載パターンを対象にしたゲートウェイテストでは、セットアップコードでモデル固有のthinking、ツール選択、履歴を扱う必要があるとされています。Haikuは強制指定のtool_choiceを受け付けますが、Sonnetは上流で拒否します。Sonnetではautoか構造化出力を使います。また、HaikuはSonnetのthinkingブロックを読めません。一方、履歴を追記専用に保てばSonnetはHaikuのthinkingを読めますが、編集済みのSonnetブロックを再送すると400になることがあります。
ユーザーの間で独立して収束しているHaikuファーストのパターンは、次のようなものです。
- 初回パスはHaiku 5.5の
low:分類、抽出、ドラフトを処理します。thinkingを完全に無効にする場合はthinking: {"type": "disabled"}を使います。 - 検証できる結果だけ受理:許可リスト内のラベル、またはスキーマに適合したJSONだけを受け入れます。不確実、無効、または影響の大きいものはSonnet 5.5の
mediumへエスカレーションします。 - サブエージェントは使い捨てにする:1つの会話を100K超まで成長させるのではなく、ファイルまたは機能ごとにHaikuインスタンスを新規作成します。
- アクションにつながる出力は上位モデルでレビュー:アクション実行、メッセージ送信、本番コードの編集を行う場合は、SonnetまたはOpusをレビュー役に置きます。
「Haikuは、何をすべきかを理解し、品質をレビューできるなら非常に優秀です。」— r/ClaudeCodeのu/Awric
Anthropicは、要約のような大量タスクにおけるサブエージェントとして、SonnetやOpusと併用するHaiku 5.5を位置付けています。出典は@ClaudeDevsです。共有された構成例の一つでは、リポジトリ検索にはHaikuの群れを使い、差分とテストはSonnetが保持します。これは@mirku21によるものです。
Haiku 5.5とSonnet 5.5のFAQ
Haiku 5.5はSonnet 5.5よりどれほど安い?
リスト価格では、プロンプトが100Kトークン未満なら20分の1です。100万トークンあたり、Haikuは入力$0.10・出力$0.50、Sonnetは入力$2・出力$10です。100K超では4分の1となり、Haikuは$0.50・$2.50、Sonnetは$2・$10です。キャッシュ読み取りは100万トークンあたり$0.01対$0.10です。
Haiku 5.5とSonnet 5.5のコンテキストウィンドウは同じ?
はい。Anthropicおよびプラットフォームドキュメントでは、両モデルともコンテキストウィンドウ1Mトークン、最大出力128Kトークンとされています。
Haiku 5.5は本番API用途に十分?
範囲が狭く、大量に処理でき、結果を検査可能なタスクなら、通常はスキーマ検証とlow effortの組み合わせで十分です。一方、主担当エージェントのコーディングや判断負荷の高いリサーチでは、Sonnet 5.5より見落としや偽陽性が多いとユーザーは報告しています。
コーディングエージェントにはどちらが向く?
主担当エージェントとデバッグにはSonnet 5.5です。Terminal-Benchは70.6%対39.2%です。Haiku 5.5は、SonnetまたはOpusをレビュー役に置いた検索担当、入力担当、1ファイル単位のサブエージェント作業に向いています。
Haikuの100K料金閾値を超えないには?
閾値前に文書を分割し、サブエージェントの対象を必要なファイルに絞り、冗長なテスト出力を抑え、タスクごとに新しいサブエージェントを開始します。エージェント型の履歴は、およそ20回の呼び出しで100Kを超えます。
会話の途中でSonnet 5.5からHaiku 5.5へ移せる?
きれいには移せません。HaikuはSonnetのthinkingブロックを読めないため、Sonnetのまま続けるか、Haikuでやり直す必要があります。Haikuの履歴をSonnetへ上げる場合は、追記専用であれば推論を維持できます。
ルーティングでは解消できない、唯一のトレードオフ
| ワークロード | 選ぶモデル | 理由 |
|---|---|---|
| 数百件の分類、抽出、要約、JSON正規化 | Haiku 5.5のlow | 検証を前提にすれば、短いタスクでSonnetに近い合格率を約18分の1のコストで得られる |
| 大規模なコードベース、長いツールループ、正確でなければならないデバッグ | Sonnet 5.5 | Terminal-Benchで31ポイント先行し、静かな見落としも少ない |
| 100Kの前後にまたがる文書 | 両方で見積もる | Haikuの5倍料金帯で差の大半が消え、閾値超ではSonnetは4倍高いだけになる |
| 気づかれない誤りがそのまま出荷されるあらゆる処理 | Haikuで下書き、Sonnetでレビュー | 検証済み成功1件あたりのコストは、名目上のトークン単価より重要 |
Haiku 5.5は、試行あたりの価格で勝ります。しかしレビューと再実行がトークンコストの大部分を占めるなら、Sonnetのほうが安くなる可能性があります。この違いを基準にルーターを設計すれば、どちらのモデルも賭けではなくなります。