 AIREITER
時間単価$0.15のAPIでも、1時間の音声に対して$0.30を請求されることがあります。一方、時間単価$0.36のAPIなら、同じファイルでも請求額は$0.36です。この請求ルールの違いは、精度ランキングよりも多くのSTT予算を左右します。それにもかかわらず、比較記事では見落とされがちです。
2026年に最適な音声認識APIは、録音ファイルを文字起こしするのか、ライブ音声エージェントを動かすのかで変わります。録音音声を低コストで処理したいなら、まずはAssemblyAI Universal-2の$0.15/時間から検討するとよいでしょう。話者の発話ターンが重要なライブエージェントでは、Deepgram FluxまたはNova-3 streamingが有力です。90以上の言語と幅広い話者分離を求めるなら、ElevenLabs Scribe v2のバッチ処理($0.22/時間)を試す価値があります。以下の料金は、ボリュームディスカウント適用前の従量課金における主力モデルの価格を、音声1時間あたりに換算したものです。
バッチ処理とストリーミングは別サービスとして選ぶ
バッチ文字起こしとリアルタイムストリーミングは、別の製品として評価すべきです。バッチAPIは通常、処理した音声時間に応じて課金され、ファイルをアップロードしてから結果をポーリングで取得します。対してストリーミングAPIは、WebSocketを開いているアイドル時間も含め、セッション時間単位で課金されることがあります。重要なのは部分結果がどれだけ速く返るかです。
部分結果の遅延、最終確定までの遅延、発話終了判定の遅延は、それぞれ別の指標です。最初の単語が表示される時点、結果が書き換わらなくなる時点、システムが話者の発話終了を判断する時点を測っています。これらを混在させてベンダーを順位付けすると誤解を招きます。Dextoやversusrefのストリーミング比較でも、この点は注意されています。
用途ごとの見方は次のとおりです。
- 大量の録音アーカイブ、ポッドキャスト、会議、通話ログ:時間単価、話者分離の精度、大容量ファイルへの対応、修正にかかる時間を重視します。
- ライブ字幕や電話エージェント:安定した部分結果、発話終了判定、割り込みへの対応、LLMとTTSを含めたエンドツーエンドの遅延を重視します。
- AWSまたはGCP上のコンタクトセンター通話:調達要件やチャネル単位の課金が、$0.05/時間のリスト価格差より重要になることが少なくありません。
「実際の顧客録音でAPIをテストしてください。騒がしい部屋、インド英語アクセント、ヒンディー語と英語のコードスイッチング……。精度、遅延、信頼性を先に見る。価格は最後です。」— @Aditya_Chawla20
この投稿では、AssemblyAIの$0.21/時間、ElevenLabs Scribe v2の$0.22/時間、Deepgram Nova-3のおよそ$0.26/時間を比較し、5セントの差よりも、実際の音声でどのモデルが機能し続けるかのほうが重要だと結論付けています。
音声1時間あたりの料金一覧
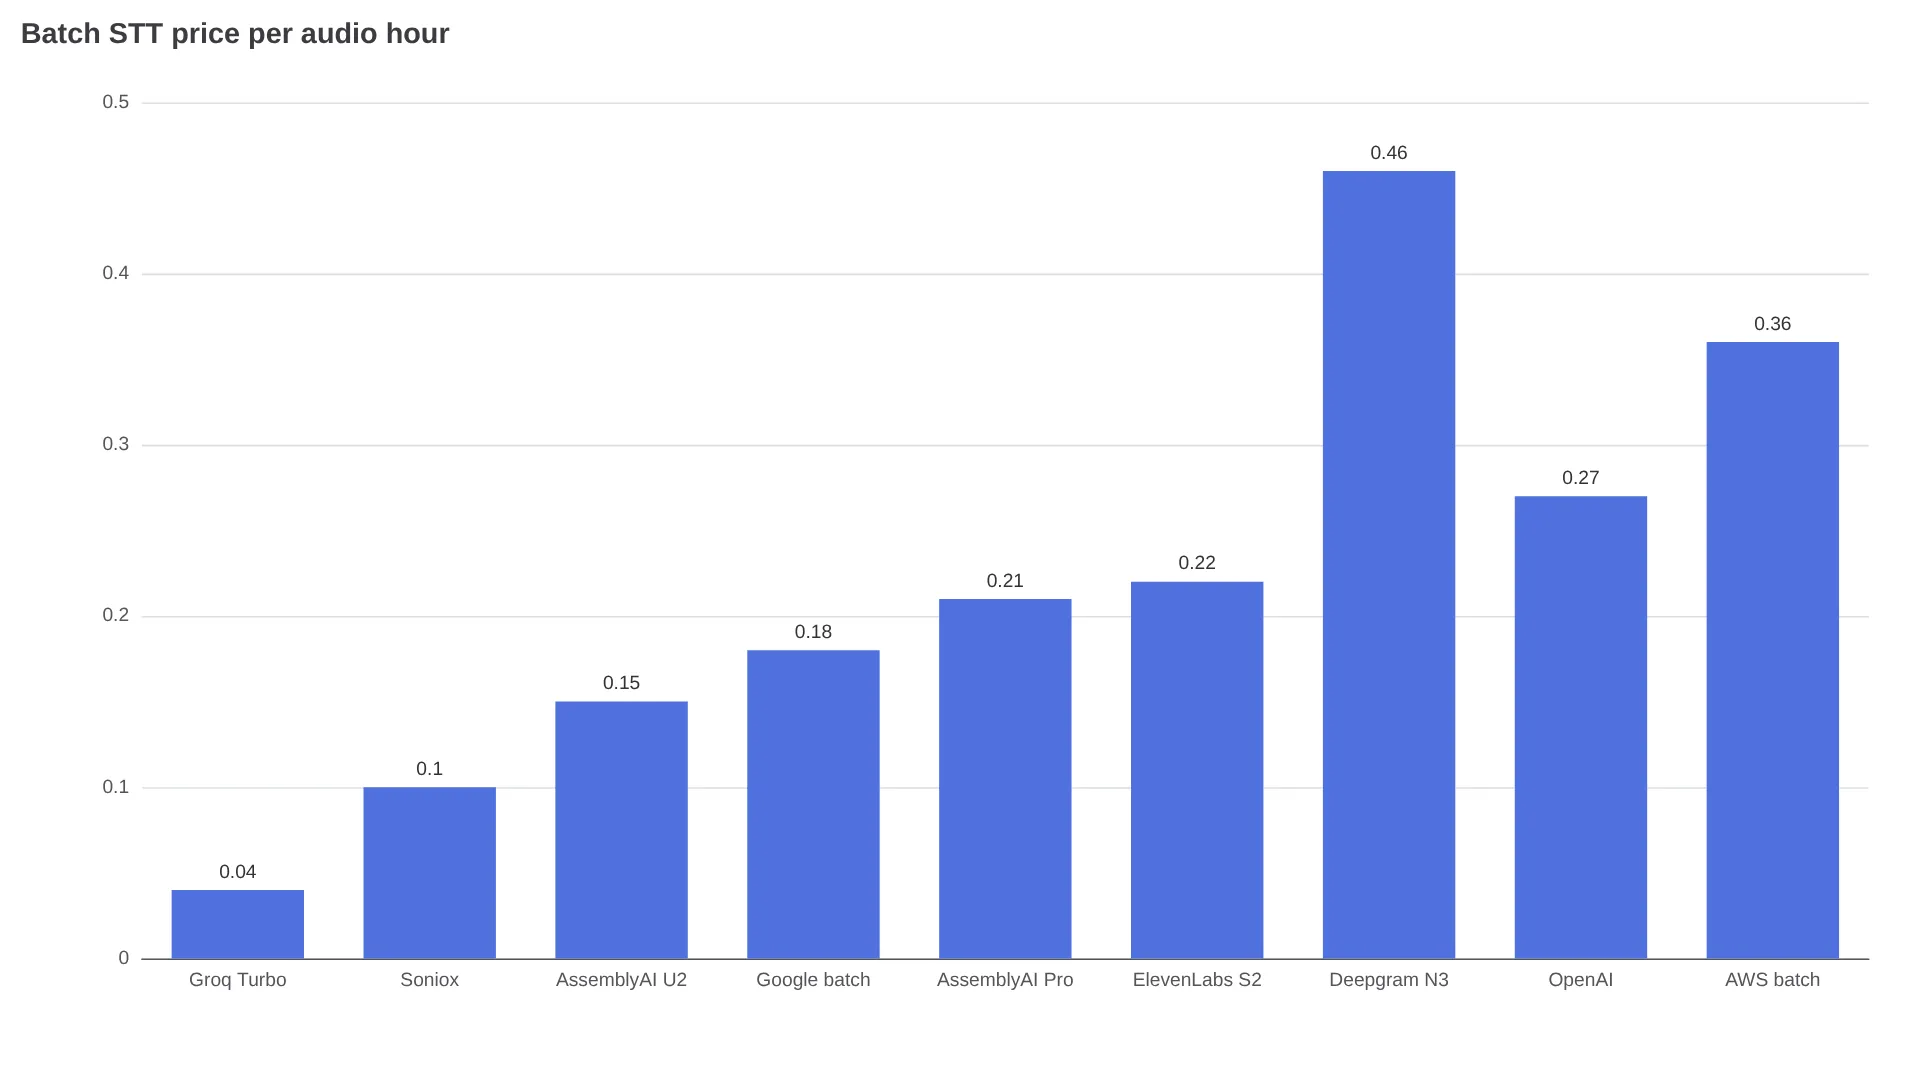
| 提供元 | バッチ | ストリーミング/リアルタイム | 対応言語 | 無料の開始特典 |
|---|---|---|---|---|
| Groq Whisper | Large v3 Turbo $0.04/時間 | ストリーミングエンドポイントなし | Whisperの多言語セット | 制限付き無料枠 |
| Soniox | 非同期 約$0.10/時間 | リアルタイム 約$0.12/時間 | 1モデルで60以上 | 記載なし |
| AssemblyAI | Universal-2 $0.15/時間、Universal-3.5 Pro $0.21/時間 | Universal-Streaming $0.15/時間、Pro Realtime $0.45/時間 | U2は99、3.5 Proは18 | カード不要で$50クレジット |
| Google Cloud | Dynamic Batch $0.18/時間、Standard $0.96/時間 | Standard:最初の500k分は$0.96/時間 | 125以上のロケールを公称 | $300のCloudクレジット |
| ElevenLabs Scribe | Scribe v2 $0.22/時間 | Scribe v2 Realtime $0.39/時間 | 90以上 | 無料プランで約4.5時間 |
| Deepgram | Nova-3:階層により$0.26~$0.46/時間(プロモーション価格/通常の単一言語価格) | Nova-3プロモーション 約$0.29/時間、Flux English $0.39/時間($0.0065/分) | 45以上 | $200クレジット |
| OpenAI | gpt-transcribe $0.27/時間($0.0045/分) | gpt-live-transcribe $1.02/時間($0.017/分) | モデルごとに記載、Whisperは98 | 記載なし |
| AWS Transcribe | $0.36/時間($0.006/分) | $0.60/時間($0.01/分) | 幅広いが機能により異なる | 12か月間、月60分 |
| Speechmatics | Melia 1 基本$0.24/時間 | Linden 1 $0.30/時間、Enhanced $0.80/時間 | 55以上 | $100クレジット |
| Gladia | Solaria-3 €0.16/時間 | €0.68/時間 | Solaria-1は100以上、Solaria-3は6 | €50クレジット、1年間 |
Deepgramの価格幅は、プロモーション時と通常時の単一言語・録音済み音声向け料金の違いによるものです。予算を組む前に、Deepgramの料金ページで現在適用される階層を確認してください。
見落としやすいマルチチャネル課金
ステレオ音声の1時間が、必ずしも請求上の1時間になるわけではありません。AssemblyAIとGoogleはチャネルごとに課金するため、Universal-2で60分・2チャネルの通話を処理すると、$0.15 x 2 = $0.30です。同じ通話をGoogle Standardで処理すれば、$0.96 x 2 = $1.92になります。AWS Transcribeは最大2チャネルを時間課金に含めるため、CometAPIが挙げた米国東部の大容量利用例では、このステレオ通話のバッチ料金は約$0.36のままです。時間単価を比較する前に、チャネル数がどうカウントされるかを必ず確認しましょう。
追加機能で料金順位は簡単に逆転する
文字起こしの基本料金は、総額の出発点にすぎません。CometAPIの費目別内訳によると、Deepgram Nova-3の単一言語・録音済み音声向け料金は$0.0077/分ですが、話者分離を付けると$0.0097/分、話者分離とマスキングを組み合わせると$0.0117/分になります。キータームプロンプトを追加すると、さらに$0.0013/分です。AssemblyAIでは録音済み音声の話者分離が$0.02/時間、ストリーミングの話者分離は$0.12/時間です。ElevenLabsはリアルタイムのキータームに$0.08/時間、エンティティ検出に$0.07/時間を追加します。
採用できる文字起こし1件あたりの総コストは、API処理費+有料機能+再試行+ストレージ/転送費+人手による修正時間です。CometAPIの試算では、レビュー担当者のコストを$30/時間とした場合、$0.15/時間で8分の修正が必要な経路は合計$4.15でした。一方、$0.60/時間でも修正が3分で済む経路は合計$2.10です。
音声エージェントでは、まず発話ターン制御を検証する
音声エージェントがつまずくのは、きれいな音声のWERではなく、割り込みや間です。発話ターンをどう扱うか、文脈制御、リアルタイム料金、主要な制約を横並びで比較してください。
| 提供元 | 発話ターン制御 | リアルタイム料金 | 制約 |
|---|---|---|---|
| Deepgram Flux | EndOfTurnイベント、しきい値調整、eager mode + TurnResumed。Dextoが引用したDeepgramドキュメントによると、eagerではLLM呼び出しが50~70%増える可能性あり | Flux English $0.0065/分、Nova-3 streamingプロモーション 約$0.0048/分 | 多言語Fluxは10言語、プロモーションは終了する |
| AssemblyAI | プロンプト+キーターム+エージェントの直前の返信1,750文字、句読点ベースの発話終了判定 | Universal-Streaming $0.15/時間、Pro Realtime $0.45/時間 | 安価なストリーミング階層は英語中心。アイドル状態のソケット時間も課金対象 |
| ElevenLabs Scribe | ベンダー公称のモデル遅延は約150 ms、90以上の言語、バッチ話者分離は最大32話者 | Scribe v2 Realtime $0.39/時間+リアルタイムキーターム$0.08/時間 | リアルタイム話者分離は掲載されていない。ベンダー値にネットワークやエージェントスタックは含まれない |
| OpenAI | WebSocket経由の文字起こし差分。サーバー側VADなし。クライアント側でターンを確定し、リアルタイムの話者ラベルや単語タイムスタンプもなし | gpt-live-transcribe $0.017/分 | クライアント側の発話終了判定が必要。この表ではリアルタイムの時間単価が最も高い |
ツール呼び出しとLLMの遅延も測定しましょう。ホテル向けエージェントを開発するあるXユーザーは、STTが高速でもツール呼び出し後に5~7秒の無音が発生すると報告しています:@albertolco88。このエンドツーエンドの空白は、STT単体の比較表には現れません。
録音の文字起こしでは、テキスト精度と話者分離を別々に評価する
r/speechtechで共有されたユーザーベンチマークでは、6人が参加した実際の2時間22分のスウェーデン語会議を、pyannoteの正解データと比較しました。投稿者によると、Deepgramは最速で話者分離も最も強力でした。ElevenLabsはスウェーデン語の文字起こしテキストでは優れていたものの、6人中2人の話者を認識できませんでした。AssemblyAIは精度が近かった一方、このパイプラインでは大幅に時間がかかったとのことです。投稿者は単一の勝者を決めるのではなく、複数プロバイダーを組み合わせました。
「3社の中ではDeepgramが最も強力で、とても速かったです。」— r/speechrecognitionのu/DoctorNootNoot
録音処理では、使いやすいAPIと扱いにくいAPIを分ける確認項目が3つあります。
- 1つの発話内でのコードスイッチング。多言語会議のスレッドでは、話者が文の途中でフィンランド語と英語、あるいはスペイン語と英語を切り替えると、切り替わり部分が崩れるという報告があります。Universal-3.5 Proは18言語間のコードスイッチングを掲げています。GladiaとSpeechmaticsは多言語検出を強みとして位置付けています。すべての欧州言語ペアを初期設定だけで正確に扱えるベンダーはないため、実際に使う言語ペアで検証してください。
- 大規模な話者分離。対応話者数(ElevenLabsのバッチは32、Azureは35、Speechmaticsのリアルタイムは上限の記載なし)、そもそもリアルタイム話者分離があるか、料金と遅延への影響を確認します。同じスウェーデン語ベンチマークの投稿者は、テキスト精度が近くてもAssemblyAIの処理完了は本番パイプラインには遅すぎると述べています。
- 大容量ファイル。OpenAIの音声アップロード上限は25 MBです。長時間録音ではこれが障害になります。バッチ処理中心のAPIでは、URL指定のジョブ、数時間のファイル、永続的な非同期ポーリングに対応しています。バッチ文字起こしのスレッドでは、「大きなファイルをアップロードできない」、URL処理も理解できなかったというユーザー報告がありました。WER表では見えない導入上の障壁です。
オフライン用途では、セルフホストのWhisper large-v3が依然として選択肢になります。Echosawの同一音声テストでは、英語の読み上げ音声と会議音声、合計22.7分を比較しました。ホスト型APIはクリーンな章で2.1%未満のWERを記録した一方、2 vCPUのWhisper環境はセグメント欠落を伴って10~17%、会議音声では0.5倍速で32.7%でした。本番でセルフホストする場合、実用的なスループットを得るには通常、VADとチャンク分割を組み合わせたGPU運用が必要です。
クラウドネイティブ、専門API、セルフホストの選び方
- ハイパースケーラーのネイティブサービス。Google Dynamic Batchは$0.18/時間で、すでにGCPにある緊急性の低い大規模アーカイブに適しています。Standardは$0.96/時間で、リアルタイム利用ではコストが重くなります。AWS Transcribeは、2チャネル込みのS3/IAMベース通話フローに向いています。Azure Speechは、バッチが約$0.18/時間、リアルタイムが約$1.00/時間で、リアルタイムには月5時間の無料枠があります。文字起こし料金以外に、ストレージ、転送、マスキングの費用も考慮してください。
- 低価格なマネージド・バッチ。Groq Whisper Turboは$0.04/時間で、単純なバッチ一括処理ならマネージドAPIの中で最安ですが、ストリーミングと話者分離は提供していません。Sonioxの非同期処理は約$0.10/時間で、表中では話者分離とタイムスタンプを含み60以上の言語に対応する最安のバッチ料金です。ただし、独立したベンチマークの蓄積は比較的少なめです。
- ハイブリッドパイプライン。テキスト精度で優位な場面ではElevenLabs、話者分離で優位な場面ではDeepgram、安価なバッチのあふれ分にはWhisperまたはGroqを使います。オーケストレーションのコストは増えますが、あなたの音声でテキストと話者ラベルの両方を1社が最上位で処理できないなら、安価なAPIを2回呼ぶほうが高額な修正作業1回より安く済む場合があります。
移行に関する注意点として、OpenAIはwhisper-1、gpt-4o-transcribe、gpt-4o-mini-transcribe、gpt-4o-transcribe-diarizeを非推奨とし、2027年2月26日に停止予定としています。これらのモデルを使っているチームは、特に単語タイムスタンプや話者分離の動作が変わる箇所について、期限前に代替モデルを検証すべきです。
自社音声で7日間の検証を行う
ベンダーが公表するWERは、データセット、正規化方法、モデルバージョンが異なるため、直接比較できません。自社のアクセント、ノイズ、専門用語を含む実際の発話ターンまたは会議セグメントを30~50件集め、正解テキストを一度だけ手作業で作成します。その後、残りのパイプラインは変えずに、同一の音声を2~3社へストリーミングまたはアップロードしてください。
音声秒数、チャネル数、有効にした機能、モデルバージョン、部分結果の遅延、最終確定までの遅延、エージェント全体の遅延、話者分離エラー率、採用した文字起こしあたりの修正分数を記録します。氏名、メールアドレス、金額、製品用語など、業務上重要なトークンは一般的なWERとは分けて採点しましょう。時間単価が最安でも、人手レビューが2倍になる経路は、総コストでは負けることが多いです。
FAQ
2026年時点で最も安い音声認識APIは?
上の表で話者分離をサポートするマネージド・バッチのリスト価格では、Sonioxの約$0.10/時間とAssemblyAI Universal-2の$0.15/時間が最安です。ストリーミングや話者分離が不要な純粋なバッチ処理なら、Groq Whisper Turboの$0.04/時間がさらに安価です。
ストリーミング遅延が最も低いAPIは?
Dextoによるベンダー公称値のまとめでは、ElevenLabsのモデル遅延は約150 ms、Deepgramの発話終了は約260 ms、Speechmaticsの平均最終確定は350 ms未満です。部分結果、最終確定、エンドツーエンドの遅延を自社の通話でテストしてください。
音声エージェントに最適なSTT APIは?
ネイティブの発話ターン制御ならDeepgram Flux、コンテキストプロンプトならAssemblyAI、ElevenLabsの音声スタックで幅広い言語を扱うならElevenLabs Realtime、クライアント側で発話終了判定を実装できるOpenAIネイティブ構成ならOpenAIのライブ文字起こしが候補です。
多言語音声やコードスイッチングに強いAPIは?
ElevenLabs(90以上)、AssemblyAI U2(99、コードスイッチング対応の3.5 Proは18)、Gladia Solaria-1(100以上)、Speechmatics(55以上)が候補です。実際の言語ペアで必ず試してください。文中での言語切り替えでは、今も遷移部分が崩れることがあります。
文字起こしと話者分離は1社にまとめるべき?
上で紹介したスウェーデン語・6話者のレポートのように、あるプロバイダーがテキストでは最も優れる一方、話者ラベルで劣るなら、複数社の組み合わせが単独利用を上回ることがあります。オーケストレーションと二重課金のコストを、削減できる修正時間と比較してください。
OpenAI Whisperは終了する?
OpenAIは、whisper-1およびgpt-4o-transcribe系を含む旧来の文字起こしモデルを非推奨とし、2027年2月26日に停止予定としています。現在の選択肢は、ファイル向けのgpt-transcribeと、ライブ音声向けのgpt-live-transcribeです。
| ワークロード | まず試す候補 | 理由 |
|---|---|---|
| 大規模な録音アーカイブ | AssemblyAI U2 / Google Dynamic Batch / Groq Whisper | 時間単価が低い。話者分離が不要ならGroqが最安 |
| ライブ音声エージェント | Deepgram Flux / AssemblyAI Realtime / ElevenLabs Realtime | 発話ターン制御、コンテキストプロンプト、低いモデル遅延 |
| 多言語会議 | ElevenLabs Scribe v2 / Speechmatics / Gladia | 90以上/55以上/100以上の言語対応を掲げ、コードスイッチングを重視 |
| AWSまたはGCPネイティブ | Transcribe / Cloud STT | IAM、ストレージ、調達要件がリスト価格を上回る |
| オフラインまたはデータ所在要件 | セルフホストWhisper | 音声データが自社ハードウェアから出ない |
関連記事:Best Text-to-Speech API、Best Voice Cloning API 2026、Gemini 3.5 Transcribe API Guide。