 AIREITER
品質ならOpus 5.5、定価ならGPT-6.1 Sol。ただし、1回のリクエストが272K入力トークン以内に収まる場合に限る。この境界を超えるとSolの長文コンテキスト追加料金で価格差の大半が消え、Codexユーザーからは実際の待ち時間でもSolのほうが遅く感じるという報告が出ている。
どちらも現在利用できるモデルだ。Anthropicは2026年9月22日、Claude 5.5シリーズの第1弾としてClaude Opus 5.5をリリース。OpenAIは2026年9月29日にGPT-6.1 Solを公開し、API IDにはgpt-6.1-solを使う。スペック表だけでは、実際の請求額を左右する3つのポイント――長文コンテキストの料金の崖、推論の強度設定、サブスクリプションのクォータ挙動――までは見えてこない。
30秒で結論
間違ったパッチや過剰な修正のコストがトークン代を上回るなら、Claude Opus 5.5を選びたい。長期的なマイグレーション、複数リポジトリの監査、放置して動かすエージェントが向いている。一方、1回の入力が272Kトークン以内に収まる、量の多い定型処理ならGPT-6.1 Sol。チケットの自動処理、PDF抽出、業務ワークフローなどが候補だ。
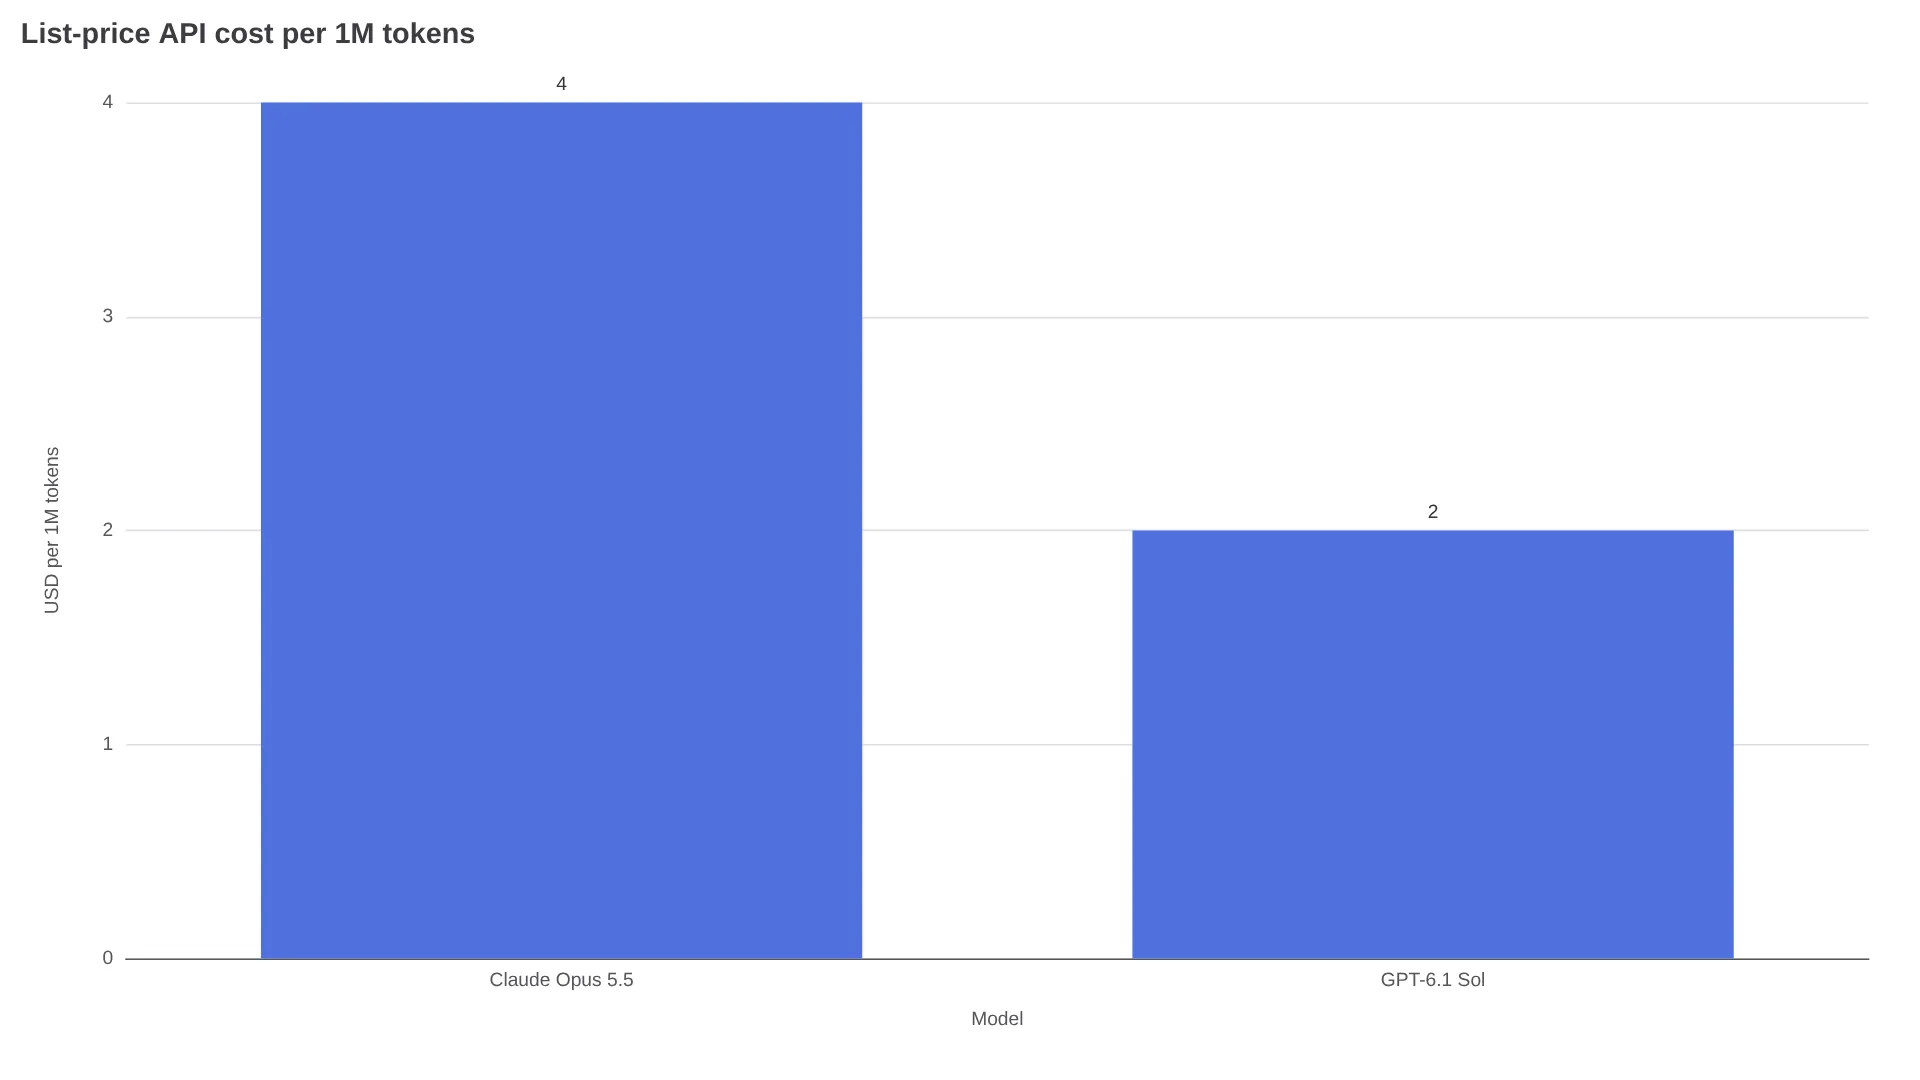
スペック上の差は小さい。コンテキストは1M対1.05M、最大出力はどちらも128K、入力・出力料金は100万トークンあたり$4/$20対$2/$10だ。ところが挙動には差がある。エージェント型コーディングではOpus 5.5が高い数値を出しており、Terminal-Bench 4.0で66.4%、FrontierCode v1.1で54.4%、CursorBench 4.0で57.8%。Solは定価が約半分で、AutomationBenchではタスク単価3分の1での勝利を記録している。サブスクリプションではさらに話が複雑だ。Redditのクォータ検証では、API料金から想像する以上の速さでSolの利用枠が減るという報告がある。
料金とコンテキスト上限、利用できる場所
| Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|
| 提供元 | Anthropic | OpenAI |
| リリース日 | September 22, 2026 | September 29, 2026 |
| API ID | 大半のゲートウェイではclaude-opus-5-5ファミリー | gpt-6.1-sol |
| 100万トークンあたりの入力 / 出力 | $4.00 / $20.00 | $2.00 / $10.00 |
| 100万トークンあたりのキャッシュ入力読み出し | $0.20 | $0.10 |
| コンテキストウィンドウ | 1,000,000トークン | 1,050,000トークン |
| 最大出力 | 128Kトークン | 128Kトークン |
| 高速モード | Fast mode $8 / $40、最大2.5倍の速度 | Codexで最大8倍のUltrafast、料金は通常の約2倍 |
| 利用できるサービス | Claude Code、API、Bedrock、Vertex、Foundry、OpenRouter | Codex、ChatGPT Work、API、Azure、Bedrock、OpenRouter |
| 利用できないサービス | — | リリース時点では通常のコンシューマー向けChat |
切り替えはモデル文字列を変更するだけで済む。AIReiterなら1つのコンソールから両モデルを呼び出せるため、ベンダーごとにAPIキーを管理する必要もない。
実際のワークロードでかかる料金
定価だけを見ると、Solは50%安い。だが実際の支払額は、1回のリクエストサイズとキャッシュの使い方で変わる。
OpenAIの追加料金は、1回の入力が272Kトークンを超えた場合にリクエスト単位で適用される。そのリクエスト全体について、入力とキャッシュ料金は2倍、出力料金は1.5倍になる。Anthropicは1Mのコンテキストウィンドウ全体を同じ料金で案内しており、リクエスト単位の追加料金は公表していない。キャッシュ読み出しは$0.20対$0.10なので、キャッシュを多用するループならSolの優位性をある程度維持できる。
| ワークロード | Opus 5.5 | GPT-6.1 Sol | 差 |
|---|---|---|---|
| バランス型アシスタント:入力1M / 出力250K、各リクエストは272K未満 | $9.00 | $4.50 | Solが50%安い |
| 検索処理、各リクエストは272K未満:入力10M / 出力1M | $60 | $30 | Solが50%安い |
| 検索処理、すべてのリクエストが272K超:入力10M / 出力1M | $60 | 約$55 | Solは約8%安いだけ |
| キャッシュを多用するループ:100Kのプレフィックスを1回書き込み、その後1,000回実行(新規5K + キャッシュ読み出し100K + 出力1K) | 約$60.50 | 約$30.25 | Solが約50%安い |
合計額は、トークナイザーの違いを考慮しない定価ベースの計算だ。Solの強みが最も出るのは、短く大量のリクエスト。巨大な入力を1回で処理する検索では、その差が最も小さくなる。
サブスクリプションの計算はAPI料金とは一致しない。固定プロンプトを使い、GPT-6.1 Sol、GPT-6 Sol、Opus 5.5を128個のプロンプトで比較したユーザーテストでは、Solファミリーのサブスクリプション消費量がトークン単価から想定されるより多かった。続くコメントでは、次のように率直な感想が述べられている。
「使用量という意味では互角かもしれないけど、Opusは実際の待ち時間ではずっと速い。今月乗り換えたのを後悔している」— u/ebrbrbr、r/ChatGPTのクォータ検証スレッド
別のCodexユーザーも、同じように利用枠が減ると報告している。
「使用量がまともならGPT 6.1 Solを使うのは構わない。でも、より『効率的』なはずなのに、結局どんどん利用枠を消費している。信じられない」— u/Longjumping_Stop6269、r/codex
予算を考えるときのルールは明快だ。1回のリクエストの中央値が272Kを超えるなら、移行前に追加料金を計算すること。$20または$100のシート契約を使うなら、見るべきは1ドルあたりのトークン数ではなく、マージ済みPRあたりのクォータ消費量だ。
コーディングとエージェント:ベンチマークと2つの実作業テスト
以下の第三者テストは、あくまで傾向を見るためのものだ。ハーネスや推論強度が異なる。出典はAnthropic、OpenAI、DataCampのビルドテスト、OpenRouterのスループット計測、SpringPromptのベンチマーク集計。
| ベンチマーク | Opus 5.5 | GPT-6.1 Sol | 注記 |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 未公表 | Anthropic実施、xhigh |
| FrontierCode v1.1 Main | 54.4% | Fable 5.1と同等、数値は未公表 | 報告元が異なる |
| CursorBench 4.0 | 57.8% | 未公表 | Anthropic実施 |
| DeepSWE v1.1 | 未公表 | Astraと同等、GPT-6 Solを6.4ポイント上回る | OpenAI実施、最大推論強度 |
| AutomationBench(47ツール) | 40.0% | medium設定でOpusを2.2ポイント上回る、コストは約3分の1 | 独立実施、フォールバックなし。AnthropicによるZapierテストの説明に基づく |
| OSWorld 2.0一部評価 | 81.8% | オフラインセットで約60.5% | 対象サブセットが異なる、ベンダー実施 |
| GDPval-AA v2.1 | 1,846 Elo | GDP.pdfでOpus+フォールバックを下回るコストでSolが勝利 | OpenAIによるベンダー横断の主張 |
公開されているエージェント型コーディングの実績はOpus 5.5のほうが豊富だ。対するSolが強みを見せるのは、低いタスクコストでの業務ワークフローや文書分析。Anthropicは、スコアの計測時に本番向けの安全対策を有効にしていたとしている。
第三者による2つの実作業テストを見ると、さらに違いが分かる。
- 単一ファイルのテトリス実装(DataCamp、OpenCode、同一プロンプト、高い推論強度、1回のみ)。重力反転の難しいロジックは両方とも通過した。操作性、完成度、プレイ感の評価はSolが5.0、Opusが4.3。Opusは3ターン、ツール呼び出し2回で完了したのに対し、Solは6ターン、9回の呼び出しを要した。ただし費用は、Solが推論トークン8.1Kだったのに対し、Opusは22.5Kを使い、$0.26対$0.87となった。
- 128プロンプトのクォータテスト(Reddit、固定プロンプト、クォータと時間を記録)。同じワークロードで、SolはGPT-6 Solより多くのサブスクリプション利用枠を消費した。一方、実際の経過時間ではOpusのほうが速く完了した。
ユーザー報告で繰り返し登場するのが、Opusの「やりすぎない」挙動だ。
「私にとってOpus 5.5の最大の強みは、純粋なコーディング速度ではない。単純な修正を過剰に設計しないことだ。以前のモデルは3行のパッチを頼むと4ファイルを書き換えていたが、5.5は既存のアーキテクチャを尊重してくれる」— u/food_fatherr、r/ClaudeAI
ただし、過剰生成については逆方向の報告もある。ある開発者は、ピクセル単位の正確さを求める依頼に対してSolが30,000個のテストを書き、削減を求めても25個しか削除しなかったと報告している。
スペック上の速度と、実際に感じる速度
デコード速度だけならスペック表はOpus寄りだ。SpringPrompt経由のArtificial Analysisでは約96対約53トークン/秒、OpenRouterでは中央値74対29。いっぽう、SpringPromptでは最初のトークンが出るまでの時間はSolがわずかに速く、低い推論強度で1.71秒対6.89秒だった。引用したCodexの報告は逆方向で、単純なタスクに数分かかったり、長い文書処理で待たされたりするなど、エンドツーエンドではSolが遅いと述べている。
これは矛盾しない。トークン/秒が測るのは最初の出力チャンク以降のデコード速度であり、実際の待ち時間には推論、キュー待ち、ハーネスのオーバーヘッドも含まれるからだ。
- OpusのFast modeは$8/$40(2倍)で、最大2.5倍の速度。SolのUltrafastは、料金約2倍でCodex上の最大8倍速をうたう。
- 引用したCodexとWorkの報告が見ているのは、APIのデコード速度ではなくレイテンシーだ。ある40分のPDF処理では、5時間の利用枠のうち6%しか使わなかったという例もあるが、これは単一の体験談であり、一般的な速度ではない。
- Cursor、Claude Code、Codex CLIのような対話型ループで使うなら、導入を決める前に実際のチケットを各モデルで3件ずつ試したい。
請求額を左右する設定
モデル名の看板より、初期設定のほうが重要だ。
- OpusはMediumかHighから始める。引用したユーザー報告では、Extra HighとMaxは通常のパッチで得られる効果が小さいわりに、クォータを大きく消費するという。
- 思考モードの扱いは異なる。Opusは思考を無効化できず、ツールの強制利用も拒否される。新しいアカウントでは、編集済みコンテキストによって400エラーが出る場合もある(DataCampのAPIメモ)。Solは
noneからmaxまで段階的に設定でき、キャッシュを無効にせず会話途中で推論強度を変更できる(DataCampの推論制御)。コストに上限を設けたループではSolのほうが扱いやすい。 - 安全対策によって処理先が変わる。Opusでサイバーセキュリティ関連のタスクを実行すると、Cyber Verification Programの対象外では大半がOpus 4.8へ振り替えられる。生物学関連の作業にはLife Sciencesプログラムが必要だ(Anthropic)。こうしたタスクでは、フォールバックによる品質やクォータの想定外の変化を見込んでおきたい。
ワークロード別の選び方
| 用途 | 選ぶモデル | 理由 |
|---|---|---|
| 20万行のマイグレーション、複数リポジトリの監査、9時間のエージェント実行 | Opus 5.5 | エージェント評価が高く、不要な書き換えが少ない。1Mまで料金が変わらない |
| 1日1万件のチケット処理、各272K未満。小さなチャンクのRAG | GPT-6.1 Sol | 定価が半額。AutomationBenchとGDP.pdfで、1ドルあたりの性能が強い |
| 1回のリクエストが272Kを超える巨大な検索処理 | Opus 5.5、またはSol向けに分割 | Solの追加料金でリードが約8%まで縮まる |
| PDF中心の金融・法務Q&A | まずSolをテスト | Opus+フォールバックを下回るタスクコストで勝ったとされる。自分の文書で検証が必要 |
| $20のシート契約で対話型CLIを使う | 両方を試す。引用した報告ではOpus寄り | Solはトークン計算以上の速さで利用枠を消費し、体感速度も遅いという報告がある |
すべての用途で勝つモデルはない。Solは効率重視、Opusは抑制の効いた自律性重視だ。現実的には、計画とレビューをOpusに任せ、大量実行をSolに回す分担が考えられる。
Opus 5.5とGPT-6.1 SolのFAQ
APIではどちらが安い?
定価ではSol($2/$10対$4/$20、キャッシュ読み出しは$0.10対$0.20)。すべてのリクエストが272K入力を超えると、差は約8%まで縮まる。
コーディングエージェントにはどちらが向いている?
Opus 5.5は公開済みのTerminal-Bench、FrontierCode、CursorBenchで優位。SolはDeepSWEでAstraと同等の結果を出し、AutomationBenchではコスト3分の1で勝っている。
実際の利用ではどちらが速い?
デコード速度はOpusが優位(約74~96 tok/s対約29~53)。最初のトークンが出るまでの時間はSolがわずかに速い。2026年10月のCodex報告では、Solのほうが遅いという傾向が見られる。
APIのモデルIDは?
gpt-6.1-sol。Opusは大半のゲートウェイでclaude-opus-5-5のスラッグを使う。
GPT-6.1 Solは通常のChatGPTで使える?
9月29日のリリース時点では使えない。まずはWork、Codex、APIからの提供となる。アクセスが重要なら、自分のシートで利用可能か確認したい。
推論強度はどれに設定すべき?
Opus 5.5はMaxではなくMediumかHighから始める。Solはmediumで開始し、リトライが増えた場合だけ上げる。両方とも推論トークンは通常のトークンと同じ従量課金メーターに乗る(DataCampの課金メモ)。
プロンプトでは埋められないトレードオフ
Opus 5.5はリポジトリを尊重する代わりに、思考のコストがかかる。Solはトークンを安く抑えられる一方、レビューすべき成果物を大量に生成し、待ち時間も増える可能性がある。見落としがバグとしてリリースされると困るなら、Opusに料金を払う価値がある。多少のミスが許容でき、処理量が最優先なら、272K未満の範囲でSolの節約効果を活かしたい。