 AIREITER
Una classifica può dirti che due sistemi di riconoscimento vocale sono quasi alla pari. Monsoon aggiunge però la domanda che conta davvero: alla pari per quali speaker, regioni, dispositivi e convenzioni di scrittura? I nuovi set di valutazione en-IN e hi-IN rendono l’Open ASR Leaderboard più utile per valutare l’ASR multilingue, anche se le brevi registrazioni pubbliche vanno interpretate con attenzione.
In breve: Monsoon spiega meglio dove i modelli funzionano
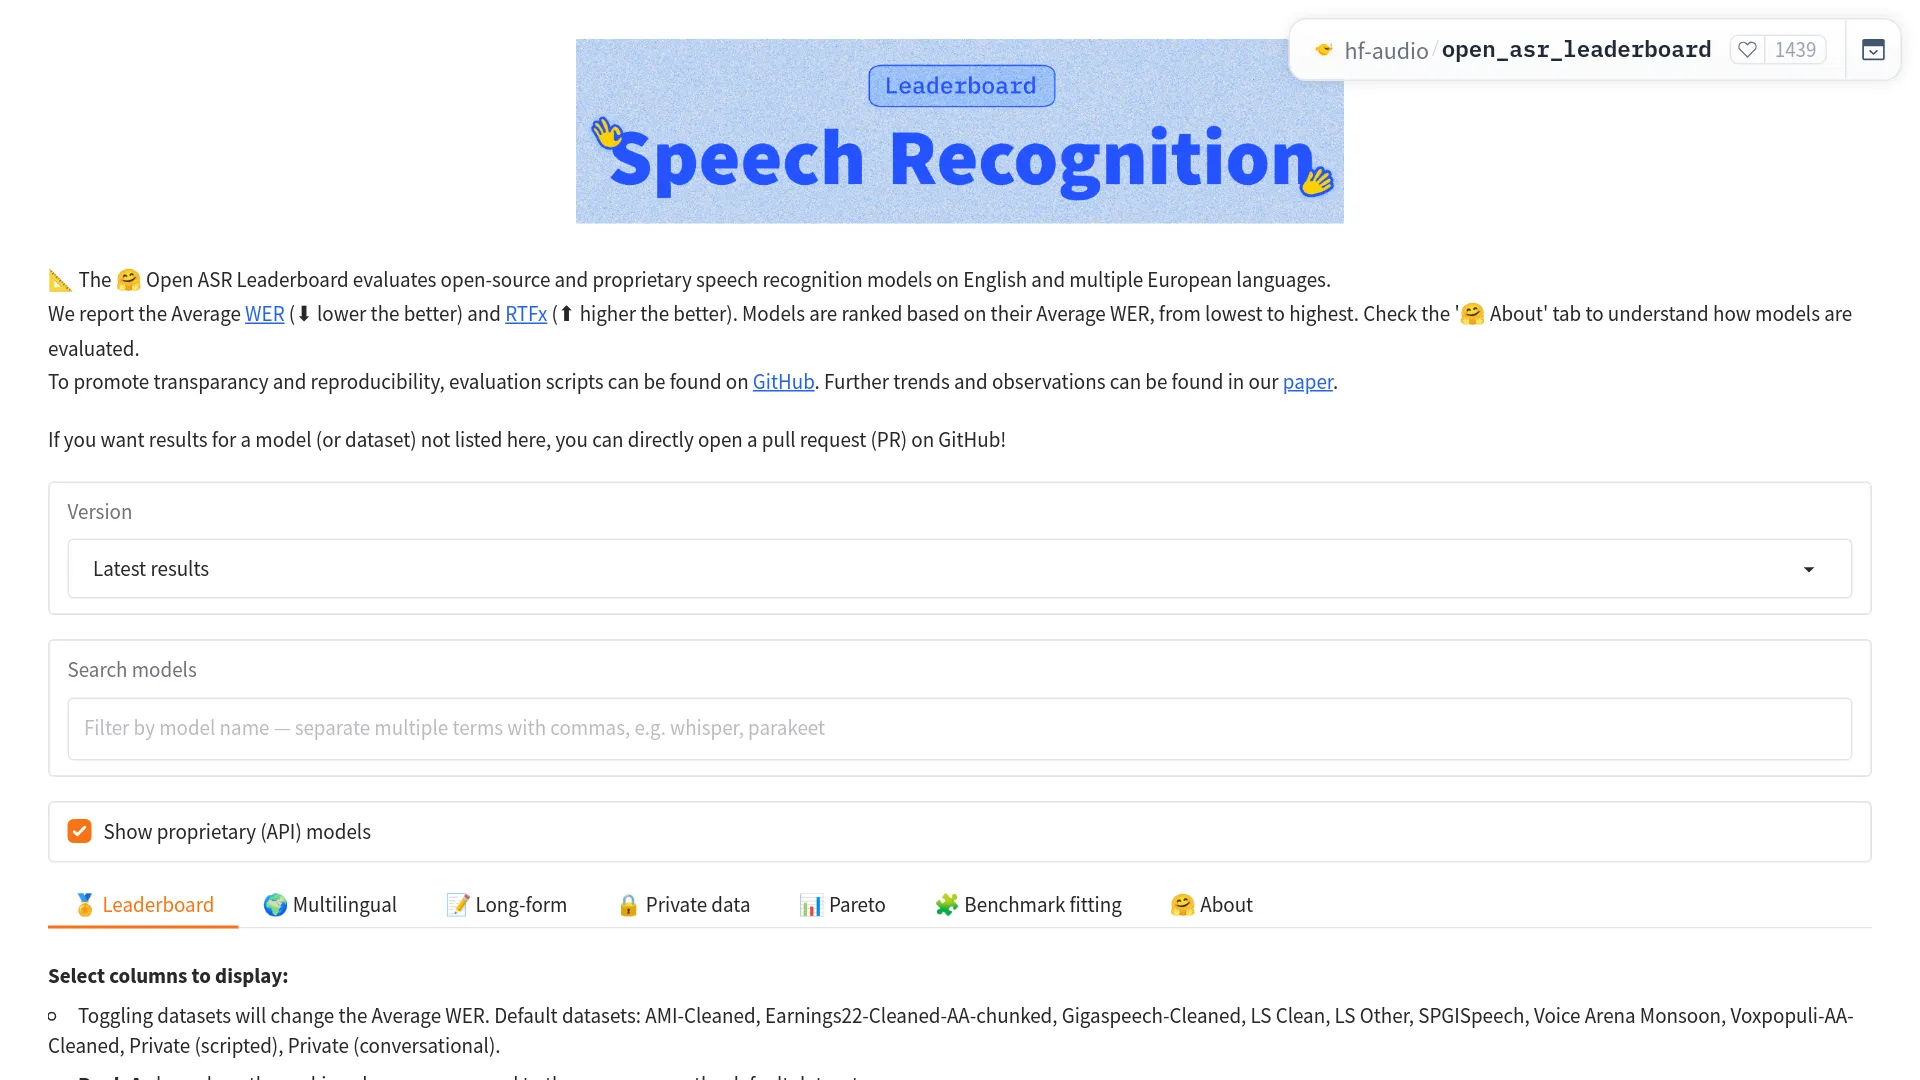
L’Open ASR Leaderboard ora include due set di valutazione Voice Arena: Monsoon en-IN per l’inglese indiano e Monsoon hi-IN per l’hindi. L’inglese indiano compare nelle colonne principali della classifica e contribuisce alla Average WER mostrata in evidenza. L’hindi è invece presente nella vista di valutazione multilingue, dove un modello deve coprire tutte le lingue selezionate per ottenere una posizione in classifica.
I quattro split, pubblici e privati, comprendono 4.888 speaker disgiunti e registrano 12 attributi legati agli speaker, tra dati demografici, contesto, area geografica e dispositivi utilizzati. I ricercatori possono così andare oltre la domanda “Quale modello ha la WER media più bassa?” e verificare dove ciascun sistema perde stabilità. Monsoon è un aggiornamento importante per valutare la robustezza regionale e lo scoring delle trascrizioni in hindi, ma non rappresenta una garanzia per la produzione né una misura rappresentativa di tutte le lingue parlate in India.
Cosa porta Monsoon nell’Open ASR Leaderboard
Monsoon introduce quattro split di test raccolti con lo stesso processo basato su parlato conversazionale e spontaneo. Per ciascuna lingua esiste uno split pubblico, utile per eseguire valutazioni autonome, e uno privato, pensato per rendere più difficile ottimizzare un modello direttamente sul benchmark. L’annuncio ufficiale presenta il rilascio come la prima aggiunta di una lingua indiana al contesto multilingue della leaderboard.
Il dettaglio dei quattro split
| Split | Audio | Speaker | Clip | Distretti d’origine | Stati / territori dell’Unione | Dispositivi | Formato del riferimento |
|---|---|---|---|---|---|---|---|
| Monsoon en-IN public | 5.62 h | 1,444 | 2,102 | 428 | 24 / 6 | 556 | Testo normalizzato con disfluenze |
| Monsoon en-IN private | 5.58 h | 1,405 | Non pubblico | 420 | 24 / 6 | 560 | Testo normalizzato con disfluenze |
| Monsoon hi-IN public | 1.33 h | 468 | 753 | 202 | 11 / 3 | 315 | Lattice di varianti accettate |
| Monsoon hi-IN private | 4.47 h | 1,571 | Non pubblico | 295 | 12 / 3 | 582 | Lattice di varianti accettate |
La scheda del dataset pubblico Monsoon en-IN indica audio a 16 kHz, clip con durata media di 9.6 secondi e mediana di 10.4 secondi. La scheda Monsoon hi-IN riporta invece una media di 6.4 secondi e una mediana di 5.0 secondi per lo split pubblico. Nel complesso, i quattro split arrivano a 17.00 ore: è quindi un benchmark focalizzato sulla varietà, costruito su brevi segmenti conversazionali e non su chiamate lunghe.
Pubblico per replicare, privato per misurare la generalizzazione
I ricercatori possono caricare gli split pubblici da Hugging Face, eseguire un sistema di riconoscimento, normalizzare l’output e calcolare uno score a livello di corpus. Per en-IN, la scheda del dataset richiede di dividere il totale delle inserzioni, cancellazioni e sostituzioni per il numero complessivo di parole nel riferimento, invece di fare la media delle WER calcolate clip per clip.
Per l’hindi, la scheda pubblica mette a disposizione lo scorer lattice-aware voi-oiwer. Un esempio minimo di caricamento è questo:
from datasets import load_dataset
from voi_oiwer import oiwer

hi = load_dataset(
    "VoiceArena/MonsoonASR-Open-ASR-leaderboard-hi-IN",
    split="test",
)
hypothesis = "replace with your model output for hi[0]"
result = oiwer(hypothesis, hi[0]["lattice"], "hindi")
score, (ins, dele, sub), ref_words = result[0], result[4], result[5]
Gli split privati restano riservati e disgiunti per speaker, così i team non possono ottimizzare il modello su ogni singolo esempio di valutazione. Il design dei dati privati mantiene questi risultati in viste aggregate separate, senza ridefinire la classifica pubblica predefinita.
La copertura degli speaker è il vero cambiamento nella valutazione
Lo split pubblico en-IN comprende 1.444 speaker distribuiti su 2.102 clip, mentre lo split pubblico hi-IN include 468 speaker e 753 clip. La tabella sulla copertura nell’annuncio ufficiale mostra che i dieci contributori principali rappresentano appena il 2.8%–6.8% della durata complessiva nei quattro split.
Questo riduce il rischio che uno speaker molto prolifico, un microfono o un particolare stile di registrazione finisca per dominare il punteggio, ma non rende il campione rappresentativo. I 12 attributi raccolti comprendono genere, data di nascita, professione, istruzione, stato civile, reddito, distretto e stato d’origine, città attuale, anni trascorsi nel distretto attuale, produttore del dispositivo e modello del dispositivo.
L’inglese indiano è una distribuzione geografica, non un unico accento
Lo split pubblico en-IN copre 428 distretti d’origine, 30 stati e territori dell’Unione, 641 città attuali e 556 modelli di smartphone. La composizione dei segmenti vede il Sud al 35%, l’Est al 18%, il Centro al 18%, il Nord al 16% e l’Ovest all’11%. Secondo l’annuncio di Hugging Face, nessun singolo stato supera il 13% degli speaker.
I campi native_district, native_state, current_city, years_spent_in_current_district, device_manufacturer e device_model permettono di confrontare gli slice regionali e quelli legati agli handset. “Inglese indiano” non significa quindi una sola condizione del microfono o un solo accento. Un modello può funzionare bene su una distribuzione regionale del parlato e risultare meno stabile su un’altra, pur mantenendo una WER complessiva competitiva.
L’hindi ha una copertura diversa e un problema di scoring specifico
Lo split pubblico in hindi è più piccolo: 1.33 ore, 468 speaker, 202 distretti e 315 modelli di smartphone. La copertura è concentrata nella fascia hindi; l’annuncio segnala che l’Uttar Pradesh rappresenta circa il 40% degli speaker hindi inclusi nella raccolta. È un’informazione utile per leggere il risultato, ma non dimostra che tutte le comunità hindi siano rappresentate nella stessa misura.
Inoltre, l’hindi include parole di origine inglese, code-switching, composti scritti uniti o separati, variazioni ortografiche in devanagari e alternative romanizzate. Per questo la scheda del dataset hi-IN conserva un lattice in cui ogni segmento della trascrizione può contenere più forme scritte accettate.
L’analisi degli errori regionali fa emergere differenze che la WER aggregata nasconde
L’esempio regionale ufficiale utilizza lo split pubblico in inglese indiano. Otto modelli si collocano tra 4.81 e 4.99 WER, con una differenza di appena 0.18 punti. L’annuncio avverte che un set di test di circa cinque ore potrebbe non essere sufficiente per distinguere una differenza così ridotta.
Quando gli stessi risultati vengono suddivisi nelle cinque zone geografiche, il quadro della stabilità cambia:
| Modello | Osservazione complessiva | Variabilità regionale | Risultato regionale concreto |
|---|---|---|---|
openai/whisper-large-v3-turbo | Punteggio complessivo competitivo | 0.46 punti WER | La regione peggiore non è indicata nell’esempio |
mistralai/Voxtral-Mini-3B-2507 | 0.14 punti dietro Whisper nel risultato complessivo | 1.68 punti WER | 4.38 nel Centro contro 6.06 nell’Est |
ibm-granite/granite-speech-3.3-2b | Incluso nell’analisi regionale | Non riportata | Il Nord è la regione peggiore |
microsoft/VibeVoice-ASR-HF | Incluso nell’analisi regionale | Non riportata | Il Sud è la regione peggiore |
Una variabilità più ampia indica che Voxtral è meno uniforme tra le regioni, non che commetta quattro volte più errori di trascrizione. Anche le aree problematiche cambiano da un modello all’altro: è un segnale di sensibilità specifica del sistema, ma non ne dimostra la causa.
Un utente reale, @FoucqueThomas, ha sottolineato la stessa distinzione dopo il rilascio:
“⚡ L’Open ASR Leaderboard aggiunge hindi e inglese indiano (4.888 speaker, 12 attributi per clip). Risultato: due modelli quasi identici sulla WER complessiva mostrano differenze fino a circa 4 volte a seconda della regione dello speaker. Finalmente un benchmark onesto sulla diversità del parlato.” — @FoucqueThomas su X
Se gli utenti sono concentrati in una determinata regione, un pareggio sulla metrica aggregata non basta per scegliere tra due modelli. L’esempio non dimostra che il pattern regionale sia stato causato da uno specifico squilibrio nei dati di addestramento.
Perché lo scoring basato su lattice è importante per valutare l’ASR multilingue
La WER standard presuppone un riferimento canonico. Funziona per la normalizzazione di maiuscole e ortografia, ma diventa meno adatta quando si valuta l’hindi con code-switching. Un output valido può usare una grafia in devanagari, una forma romanizzata, un’ortografia di origine inglese oppure una diversa separazione delle parole composte.
Monsoon hi-IN affronta il problema con lattice di riferimenti: il rilascio ufficiale descrive un processo in cui le varianti candidate vengono ampliate, sottoposte alla revisione di linguisti madrelingua e filtrate, mantenendo solo le forme compatibili con l’enunciato. Un’alternativa valida può quindi essere considerata corretta invece di venire penalizzata perché diversa dalla trascrizione scelta da un singolo annotatore.
Per la valutazione dell’hindi, la leaderboard utilizza l’Orthographically-Informed Word Error Rate (OIWER). Una variante accettata conta come corretta, mentre un errore di riconoscimento autentico continua a essere conteggiato. Il commit d’integrazione della leaderboard mostra come i dati hindi e le viste multilingue per lingua siano stati collegati all’applicazione.
Questa regola di scoring può modificare l’ordine dei modelli. L’annuncio ufficiale riferisce che, trasformando i lattice hindi in riferimenti singoli, i tassi di errore aumentano per tutti i sistemi testati e che l’incremento non è uniforme. Una leaderboard multilingue può quindi diventare più equa dal punto di vista linguistico senza ridurre ogni risultato a un unico numero universale.
Come usare la leaderboard aggiornata per scegliere un modello
Usa Monsoon come strumento di screening e diagnosi, poi valida il finalista su audio realmente rappresentativo del tuo dominio.
- Usa la Average WER per restringere il campo. L’inglese indiano ora incide sulla media principale della leaderboard, quindi i modelli che funzionano bene solo con inglese letto o non indiano sono meno protetti rispetto a un test conversazionale con accenti indiani.
- Controlla la copertura linguistica prima di confrontare le medie multilingue. Il codice della leaderboard mostra come
NAle lingue selezionate mancanti e riporta un valoreCoveragecome3/5; un modello riceve una posizione nella classifica multilingue solo quando supporta tutte le lingue selezionate. Vedi il codice di integrazione. - Suddividi i dati pubblici Monsoon usando i campi documentati. Confronta distretto d’origine, stato, città, dispositivo e gli altri metadati disponibili. Cerca la variabilità e la concentrazione degli errori, non soltanto il punteggio migliore ottenuto da un sottogruppo.
- Valida il modello su audio di produzione rappresentativo. Prova la combinazione di telefoni, condizioni di rumore, pattern di code-switching, VAD e durata del parlato che incontrerai davvero. Le clip pubbliche Monsoon durano in media meno di dieci secondi, quindi non possono rappresentare ogni scenario di call center, riunione o agente vocale.
Su X, il professionista @PlimmApp ha avvertito che il VAD può nascondere le allucinazioni sul silenzio quando la valutazione parte da segmenti che contengono già parlato: “anche il passaggio VAD nella pipeline è un punto cieco… un modello che genera testo fluido durante il silenzio non viene mai penalizzato”. Leggi il commento completo. I team che lavorano on-device dovrebbero valutare separatamente VAD, rilevamento dei punti di fine intervento e gestione delle allucinazioni.
Cosa Monsoon non può ancora dirci
- Scala e trasferimento al parlato lungo: Lo split pubblico en-IN è di 5.62 ore e quello pubblico hi-IN di 1.33 ore; la durata media delle clip è rispettivamente di 9.6 e 6.4 secondi. Le differenze minime nei punteggi e il comportamento con audio lunghi richiedono una validazione separata.
- Rappresentatività nazionale: Un’ampia copertura di distretti, stati e dispositivi non equivale a un censimento ponderato sulla popolazione degli speaker di inglese indiano o hindi.
- Spiegazioni causali: Le associazioni regionali non permettono di stabilire se la causa sia nei dati di addestramento, nell’acustica, nella fonetica, nel decoding o in un altro fattore.
- Capacità predittiva degli split privati: Gli split privati disgiunti per speaker sono pensati per testare la generalizzazione, ma i relativi esempi non possono essere analizzati autonomamente.
- Aderenza al testo downstream: Ricerca, sottotitoli, analytics e trascrizioni legali possono richiedere convenzioni diverse per scrittura, normalizzazione, punteggiatura o code-switching.
FAQ su Open ASR Leaderboard Monsoon
L’inglese indiano influisce sulla media principale della leaderboard?
Sì. Monsoon en-IN è un input predefinito della leaderboard inglese e contribuisce alla Average WER. Consulta il riepilogo degli split per conoscere le dimensioni delle versioni pubblica e privata.
L’hindi fa parte della classifica principale?
L’hindi è mostrato nella vista multilingue. Le lingue selezionate mancanti vengono indicate come NA e solo i modelli con copertura completa delle lingue selezionate ricevono una posizione nella classifica multilingue.
Posso scaricare i set pubblici e calcolare lo score?
Sì. Le schede en-IN e hi-IN includono esempi di caricamento. Usa un’aggregazione a livello di corpus e OIWER per i lattice hindi.
Perché l’hindi non viene valutato con la WER ordinaria?
Un riferimento hindi fisso può penalizzare varianti valide in devanagari, romanizzate, con code-switching o con parole composte segmentate diversamente. Il lattice registra le forme accettate per ogni segmento della trascrizione.
Una WER complessiva più bassa significa che un modello è migliore in ogni regione indiana?
No. L’esempio ufficiale su en-IN mostra WER complessive quasi identiche ma una variabilità regionale diversa. Analizza il comportamento dei sottogruppi e prova audio rappresentativo prima della messa in produzione.
La decisione pratica
Usa en-IN per lo screening iniziale, hi-IN e OIWER per confrontare modelli hindi o multilingue, e la variabilità regionale come indicatore di rischio quando è elevata. Poi valida il finalista sull’audio, sul rumore, sul comportamento del VAD e sulle convenzioni testuali che i tuoi utenti producono davvero.