 AIREITER
Un contesto da un milione di token e un endpoint da $0 fanno sembrare l’API Nemotron 3 Ultra la scelta più semplice. In realtà è soprattutto uno strumento per la valutazione: in produzione contano l’affidabilità del provider, la gestione dei dati e la disponibilità di un’alternativa a pagamento.
Vale la pena usare l’API Nemotron 3 Ultra?
L’API Nemotron 3 Ultra merita una prova per gli agenti che lavorano a lungo, l’analisi di documenti estesi e i workflow di coding che traggono vantaggio da un contesto molto ampio. Non è invece la scelta predefinita ideale per la chat ordinaria a bassa latenza, per prompt riservati inviati a un endpoint gratuito con logging o per un servizio di produzione privo di fallback.
NVIDIA ha rilasciato Nemotron 3 Ultra il 4 giugno 2026. La scheda tecnica ufficiale identifica il checkpoint NVFP4 come versione 1.0 GA, con licenza per uso commerciale e non commerciale secondo OpenMDW 1.1.
| Fatto decisivo | Valore verificato | Perché conta |
|---|---|---|
| Dimensione del modello | 550B totali, 55B attivi | Il calcolo sparso non rende piccoli tutti i pesi |
| Contesto massimo | Fino a 1M di token | I limiti del provider possono essere inferiori a seconda del percorso |
| Modalità | Input e output testuali | Non comprende immagini o video |
| SWE-Bench Verified ufficiale NVFP4 | 69.7 | Un dato utile per valutare gli agenti di coding |
| RULER 1M ufficiale NVFP4 | 94.0 | Rafforza il caso d’uso con contesto esteso |
| Prezzo OpenRouter free | $0 input, $0 output | Adatto ai test, non equivale a uno SLA |
| Snapshot della disponibilità OpenRouter free | 84.07% di successo in tre giorni | Raggiungibile non ha sempre significato utilizzabile |
| Minimo ufficiale per il self-hosting | 4x classe B200 o 8x H100 | Non è un deployment da workstation comune |
I benchmark riportati sopra provengono dalla scheda tecnica di NVIDIA e vanno considerati risultati di prima parte. La disponibilità rilevata da OpenRouter è una misurazione dinamica del provider, non una garanzia permanente.
Come chiamare gratis l’API Nemotron 3 Ultra in cinque minuti
Il percorso gratuito più rapido passa dall’endpoint di chat completions compatibile con OpenAI di OpenRouter e dall’ID esatto del modello nvidia/nemotron-3-ultra-550b-a55b:free. Crea una chiave OpenRouter, conservala in una variabile d’ambiente e invia prima una richiesta breve, invece di partire subito con un job a contesto esteso.
- Crea una chiave API in OpenRouter.
- Esportala come
OPENROUTER_API_KEY. - Chiama
/api/v1/chat/completionsusando l’ID del modello gratuito. - Durante la valutazione registra codice HTTP, latenza e risposte vuote.
- Prima di portare il workflow in produzione, aggiungi un percorso a pagamento o un altro modello.
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nvidia/nemotron-3-ultra-550b-a55b:free",
    "messages": [
      {
        "role": "user",
        "content": "Return three risks in this migration plan as a numbered list."
      }
    ],
    "max_tokens": 500
  }'
Lo stesso endpoint funziona anche con il client Python di OpenAI: basta modificare base_url e model:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENROUTER_API_KEY"],
    base_url="https://openrouter.ai/api/v1",
)

response = client.chat.completions.create(
    model="nvidia/nemotron-3-ultra-550b-a55b:free",
    messages=[
        {
            "role": "user",
            "content": "Inspect this plan and list the three highest-impact risks.",
        }
    ],
    max_tokens=500,
)

print(response.choices[0].message.content)
Cosa garantisce davvero il percorso gratuito
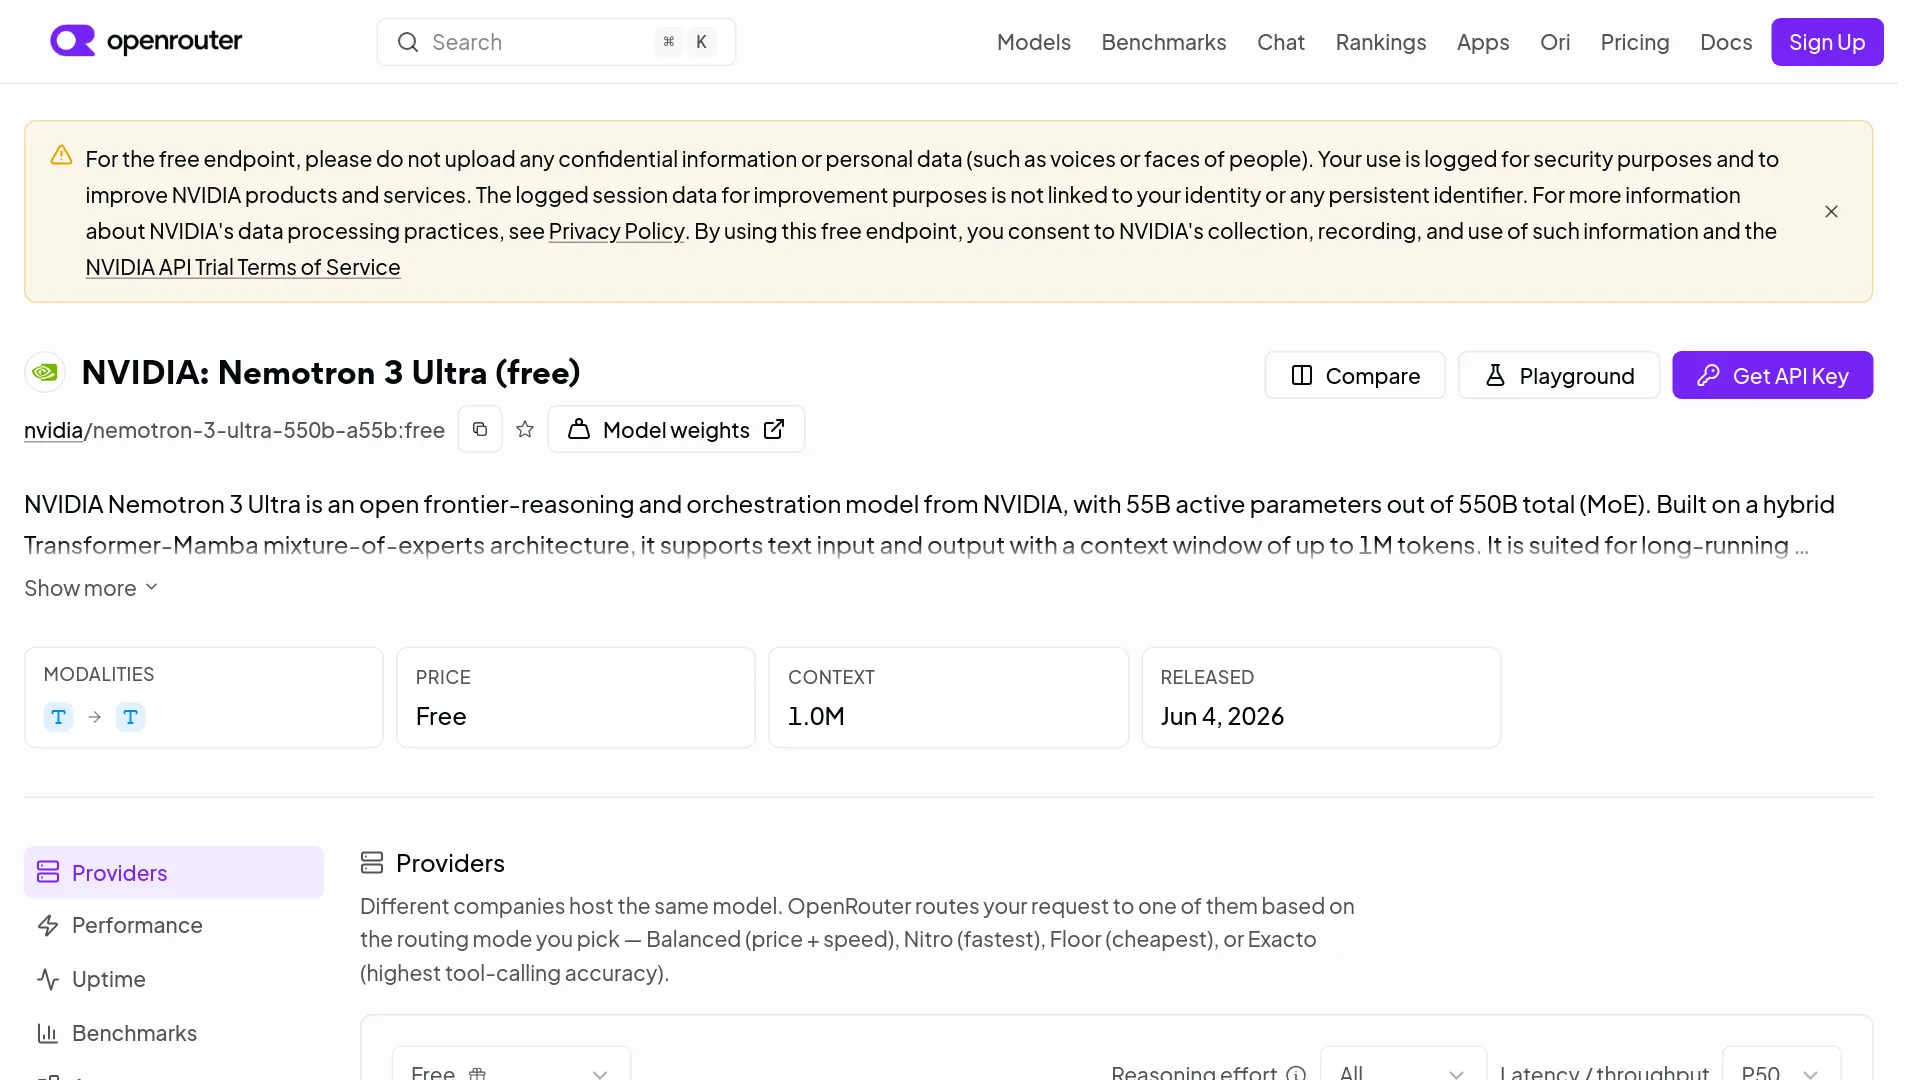
Il percorso gratuito di Nemotron 3 Ultra non garantisce né capacità illimitata né disponibilità da produzione. Il listing di OpenRouter indica che gli endpoint gratuiti sono soggetti a limiti di frequenza, ma non pubblica una quota precisa nella pagina del modello; lo snapshot del 19 settembre mostrava una raggiungibilità del 100%, ma solo l’84.07% di disponibilità effettiva in tre giorni, considerando errori e risposte vuote come fallimenti.
Nello stesso snapshot OpenRouter indicava un contesto da 1M di token, un completamento massimo di 65,536 token, il supporto al function calling, una latenza mediana di 2.28 secondi e una velocità mediana di 29 token al secondo.
Esiste anche un limite legato alle funzionalità specifiche del provider: il listing gratuito di OpenRouter supportava tools e tool_choice, ma non applicava response_format. Il percorso a pagamento di Segmind documenta invece l’output con JSON Schema a $0.625 per milione di token in input e $2.75 per milione di token in output. Se il codice dipende da JSON rigorosamente strutturato, devi testare il provider scelto invece di dedurre il supporto dalle capacità del modello base.
Non inviare dati personali o riservati attraverso il percorso gratuito di OpenRouter. Il listing specifica che l’utilizzo viene registrato per motivi di sicurezza e può essere impiegato per migliorare prodotti e servizi NVIDIA. In caso di 429, timeout o risposta vuota, usa un backoff esponenziale con limiti e poi passa a un endpoint a pagamento; non ritentare all’infinito la stessa azione di un agente.
Cosa cambia davvero con 550B A55B
La sigla 550B-A55B indica che Nemotron 3 Ultra contiene 550 miliardi di parametri complessivi, attivandone circa 55 miliardi per ogni token. NVIDIA combina routing LatentMoE, Mamba-2, alcuni livelli di attenzione e Multi-Token Prediction. L’attivazione sparsa riduce il calcolo per token, ma i pesi completi devono comunque essere conservati, distribuiti o scaricati in memoria; A55B non trasforma il modello in un deployment da 55B.
Il rilascio della ricerca di NVIDIA riporta fino a 1M di token di contesto e confronta il throughput su un carico poco comune, con 8.000 token in input e 64.000 in output. NVIDIA dichiara un throughput fino a 5.9x quello di GLM-5.1-754B-A40B, 4.8x quello di Kimi-K2.6-1T-A32B e 1.6x quello di Qwen-3.5-397B-17B. La pagina non specifica il throughput assoluto né l’hardware utilizzato: quei moltiplicatori non vanno quindi trasformati in previsioni sulla latenza dell’API.
Per scegliere come effettuare il deployment, la tabella ufficiale BF16/NVFP4 è più utile:
| Benchmark | BF16 | NVFP4 | Lettura pratica |
|---|---|---|---|
| SWE-Bench Verified | 71.9 | 69.7 | La quantizzazione costa 2.2 punti in questo test di coding |
| Terminal Bench 2.1 | 56.4 | 53.9 | Anche il lavoro agentico da terminale registra un calo |
| Media TauBench V3 | 70.9 | 70.3 | La media nell’uso degli strumenti resta vicina |
| GPQA, senza strumenti | 87.0 | 87.9 | NVFP4 non è uniformemente più debole |
| RULER 1M | 94.7 | 94.0 | Il recupero su contesto lungo resta vicino |
| OmniScience non-hallucination | 78.7 | 75.5 | Le verifiche di accuratezza fattuale restano importanti |
La variazione dipende dal task: NVFP4 perde 3.2 punti nel test di assenza di allucinazioni, ma guadagna 0.9 punti su GPQA.
Scegli in base al task, non al numero di parametri
Nemotron 3 Ultra va confrontato con DeepSeek V4, GLM 5.2 e Qwen 3.8 Max sul workload che arriverà davvero in produzione, non sulla dimensione del modello. Per questa guida non abbiamo raccolto risultati ottenuti con lo stesso harness che supportino un vincitore universale: il confronto più solido è quindi un piano di test con limiti verificati.
| Task | Da provare per primo | Elementi da verificare prima della scelta |
|---|---|---|
| Recupero o sintesi su un milione di token | Nemotron 3 Ultra | Il RULER 1M ufficiale in NVFP4 è 94.0; verifica accuratezza del recupero e latenza di prefill sulla lunghezza reale del prompt |
| Agente di coding a esecuzione prolungata | Nemotron 3 Ultra o DeepSeek V4 | Nemotron raggiunge 69.7 su SWE-Bench Verified e 53.9 su Terminal Bench 2.1; confronta successo sui task del repository e validità delle chiamate agli strumenti con un unico harness |
| Automazione con output strutturato | GLM 5.2, Qwen 3.8 Max o un provider Nemotron con supporto agli schemi | OpenRouter free non applica response_format; misura aderenza allo schema e numero di retry sull’endpoint esatto |
| Richieste brevi ad alto volume | DeepSeek V4, GLM 5.2 o Qwen 3.8 Max | Confronta il costo per task completato con successo e la latenza p95; la scala di Ultra non è automaticamente un vantaggio |
| Deployment open-weight su hardware NVIDIA | Nemotron 3 Ultra | Confronta BF16 e NVFP4 sul task target, poi calcola l’utilizzo sostenuto |
DeepSeek V4 e GLM 5.2 dispongono di API dedicate su AIReiter, mentre Qwen 3.8 Max è disponibile come modello chat in hosting: guida all’API DeepSeek V4 Pro, recensione dell’API GLM 5.2 e prezzi dell’API Qwen 3.8 Max. Sono alternative per la valutazione, non affermazioni secondo cui un modello vinca su ogni task.
È possibile eseguire Nemotron 3 Ultra in locale?
Nemotron 3 Ultra può essere eseguito in self-hosting, ma “in locale” significa hardware da data center o una DGX Station, non un laptop. NVIDIA indica 4x GB200, 4x B200, 4x GB300, 4x B300 oppure 8x H100 come configurazioni minime per il percorso di deployment standard.
Gli esempi ufficiali vLLM nella scheda tecnica di NVIDIA usano parallelismo tensoriale ed expert parallelism a 4 vie, cache KV FP8, prefill a blocchi e speculative decoding MTP. Un esempio standard usa come valore predefinito 262,144 token; per arrivare a 1,048,576 token serve un override esplicito. Il contesto dichiarato come headline, quindi, non corrisponde alla configurazione di serving predefinita.
NVIDIA documenta anche un deployment dedicato su una singola DGX Station. Il checkpoint NVFP4 viene eseguito su una GPU GB300 integrata, rendendo disponibili fino a 150 GiB di memoria CPU coerente e scaricando i pesi degli esperti. Questa configurazione richiede vLLM 0.22.0, il backend NVFP4 specifico per Blackwell e l’architettura di memoria della DGX Station; non è una ricetta applicabile a un normale PC con una sola GPU.
| Deployment | Sceglilo quando | Vincolo principale |
|---|---|---|
| API gratuita OpenRouter | Devi valutare prompt e comportamento degli strumenti | Limiti di frequenza, logging e disponibilità variabile |
| API hosted a pagamento | Devi andare in produzione prima che l’utilizzo giustifichi l’hardware | Prezzi, precisione, contesto e funzionalità variano in base al provider |
| Self-hosting su 4x classe B200 / 8x H100 | Contano volume sostenuto, controllo sui dati o personalizzazione del modello | Costo del capitale e gestione dell’inferenza distribuita |
| DGX Station GB300 singola con offload | Possiedi esattamente quel sistema con memoria coerente | Latenza dell’offload e forte dipendenza dall’hardware |
FAQ sull’API Nemotron 3 Ultra
L’API Nemotron 3 Ultra è gratuita?
Sì. OpenRouter indica nvidia/nemotron-3-ultra-550b-a55b:free a $0 per i token in input e output, ma l’endpoint è soggetto a limiti di frequenza e logging.
Nemotron 3 Ultra supporta davvero un milione di token?
NVIDIA specifica un massimo di 1M di token, ma i percorsi dei provider possono esporre valori predefiniti inferiori; l’esempio vLLM di NVIDIA usa 262,144 token per impostazione predefinita, a meno che l’operatore non abiliti 1,048,576.
L’API supporta gli strumenti e il JSON strutturato?
Il modello supporta gli strumenti, ma l’applicazione effettiva dipende dal provider: OpenRouter free non impone response_format, mentre Segmind documenta il JSON Schema rigoroso.
Posso usare Nemotron 3 Ultra per scopi commerciali?
NVIDIA dichiara che il rilascio OpenMDW 1.1 consente l’uso commerciale e non commerciale. Consulta i termini di licenza collegati nella scheda tecnica ufficiale per gli obblighi relativi a ridistribuzione e deployment.
È possibile disattivare il reasoning?
La documentazione API di NVIDIA espone enable_thinking=True/False. I provider hosted possono gestire questo controllo in modo diverso: verifica quindi il parametro accettato e il conteggio dei token sul percorso scelto.
550B A55B equivale a un modello denso da 55B?
No. A ogni token vengono attivati circa 55B di parametri, ma tutti i 550B devono comunque essere conservati, distribuiti o scaricati in memoria.
Una scelta di deployment, non una gara di benchmark
Il primo passo più sensato è usare l’API gratuita Nemotron 3 Ultra con prompt non sensibili e un piccolo set di valutazione. Passa a un endpoint a pagamento quando diventano importanti affidabilità, applicazione dello schema o capacità prevedibile; scegli il self-hosting solo se utilizzo misurato, privacy o personalizzazione possono giustificare almeno quattro GPU attuali ad alta memoria oppure il percorso documentato per DGX Station.
| Risultato dopo i test | Prossima azione |
|---|---|
| La qualità è alta, ma le chiamate gratuite falliscono o restano in coda | Aggiungi un percorso Nemotron a pagamento e una policy di retry |
| Il recupero su contesto lungo è il principale vantaggio | Testa il documento reale più grande e misura il tempo di prefill |
| Gli errori JSON sono il problema dominante | Usa un provider con applicazione dello schema oppure confronta i percorsi GLM/Qwen |
| Costi o latenza sui task brevi sono prioritari | Preferisci un modello più piccolo e riserva Ultra alle escalation |
| I dati non possono uscire dalla rete | Calcola il budget per il deployment ufficiale multi-GPU prima di decidere |