 AIREITER
GLM-5.2 accetta richieste con il formato di OpenAI su ogni suo endpoint, ma dietro quella facciata gli endpoint si comportano in modi tutt'altro che uniformi. Dal suo lancio del 16 giugno, l'API GLM-5.2 è una scelta da considerare per coding e agent sensibili ai costi, a patto di gestire in proprio tre criticità: semantica delle tool call, tempeste di retry e contabilità della cache. Il listino da $1.40/$4.40 per milione di token è reale; il costo effettivo di un task completato è un'altra cifra. È proprio questa differenza a guidare la recensione.
Compatibilità OpenAI: cosa c'è davvero e cosa manca
La documentazione ufficiale di GLM-5.2 supporta l'SDK Python di OpenAI con base URL https://api.z.ai/api/paas/v4/ e model ID glm-5.2: per una semplice integrazione chat, la modifica richiede davvero tre righe. La compatibilità riguarda però il formato della richiesta, non la semantica della risposta, i campi di controllo opzionali di OpenAI o la superficie più recente della Responses API.
| Contratto documentato | Valore |
|---|---|
| Modalità | Input testuale, output testuale, senza vision |
| Finestra di contesto | 1M token |
| Output massimo | 128K token |
| Funzionalità documentate | Thinking mode, streaming, function call, context caching, structured output, MCP |
| Endpoint a consumo | https://api.z.ai/api/paas/v4/ |
| Endpoint Coding Plan | https://api.z.ai/api/coding/paas/v4 |
| Endpoint compatibile con Anthropic | https://api.z.ai/api/anthropic |
| SDK ufficiali | zai-sdk (Python), Java, OpenAI SDK |
Il primo limite è netto: Z.ai non offre alcuna Responses API. «Codex only supports the Responses API format, which isn't available at Z.ai», osserva u/quinncom; altri passano invece da ZenMux come livello di traduzione. Il secondo riguarda Claude Code: funziona con l'endpoint compatibile con Anthropic, ma le note di configurazione di @armor_rust segnalano due insidie. Va usato AUTH_TOKEN, non API_KEY: quest'ultimo attiva una conferma di attendibilità che, dopo un solo rifiuto, può impedire definitivamente l'accesso. Inoltre, i base URL per abbonamento e pay-as-you-go sono diversi. La procedura completa è nella nostra guida alla configurazione di Claude Code.
Un developer lo ha sintetizzato così: «api compatibility stops at request shape; tool calling still needs provider-specific evals» — @sebuzdugan.
Tool calling: bene nei test brevi, fragile nei loop lunghi
Nei loop controllati e di breve durata, l'API GLM-5.2 restituisce esattamente ciò che promette la documentazione. Nei loop agentici prolungati, gli utenti più intensivi segnalano sequenze di chiamate corrotte che continuano a ciclare finché non intervengono i limiti impostati dal client. Le due conclusioni convivono: il rischio dipende interamente dal tipo di loop che si sta costruendo.
Il contratto documentato, verificato da una suite Docker da 27 richieste di GLM52.ai, prevede fino a 128 definizioni di funzione, nomi lunghi al massimo 64 caratteri e conformi a ^[a-zA-Z0-9_-]+$, parametri JSON Schema e argomenti restituiti come stringa JSON, che l'applicazione deve validare. È documentato soltanto tool_choice: "auto". Sul percorso Coding Plan, la suite ha superato tutte le 27 richieste: 4/4 corrispondenze esatte tra tool e argomenti, 3/3 rifiuti corretti senza tool, 4/4 ordini gestiti in due chiamate top-level e una latenza mediana di 5.3 secondi.
Il problema sono i campi che gli utenti OpenAI danno per scontati. Quando GLM52.ai ha inviato sonde con istruzioni in conflitto, l'endpoint ha risposto HTTP 200 ignorando poi quelle istruzioni:
| Controllo in stile OpenAI inviato | Comportamento osservato |
|---|---|
tool_choice: "required" + «non usare alcun tool» | Si è fermato, zero chiamate |
| Oggetto funzione forzata + «non usare mai questo tool» | Si è fermato, zero chiamate |
parallel_tool_calls: false + prompt con due ordini | Ha comunque restituito due chiamate |
strict: true | Accettato una volta; nessuna evidenza di enforcement dello schema |
Un HTTP 200 non equivale a un contratto comportamentale; ed è nei loop lunghi che emergono le crepe.
Un developer che ha fatto passare circa quattro miliardi di token nel modello è stato diretto: «biggest issue with GLM 5.2 4bil tokens in was the lack of vision, some tool call confusion, tool call corruption death (it just spirals)» — @RasputinKaiser. Esiste anche una segnalazione isolata e senza risposta di una seconda tool call codificata dal modello negli argomenti della prima: un solo caso, ma esattamente la classe di errore da cui un loop lato client deve proteggersi.
La difesa che funziona nella pratica consiste nel lasciare al modello il minor controllo possibile sull'orchestrazione. Un developer usa NVIDIA NIM con tool_call: false, assegnando l'intero loop al framework agentico; il loop di riferimento con limiti definiti blocca i passaggi del modello a quattro, consente al massimo quattro chiamate per turno e valida ogni JSON degli argomenti prima dell'esecuzione.
Streaming e latenza: i dati che i provider non mettono in vetrina
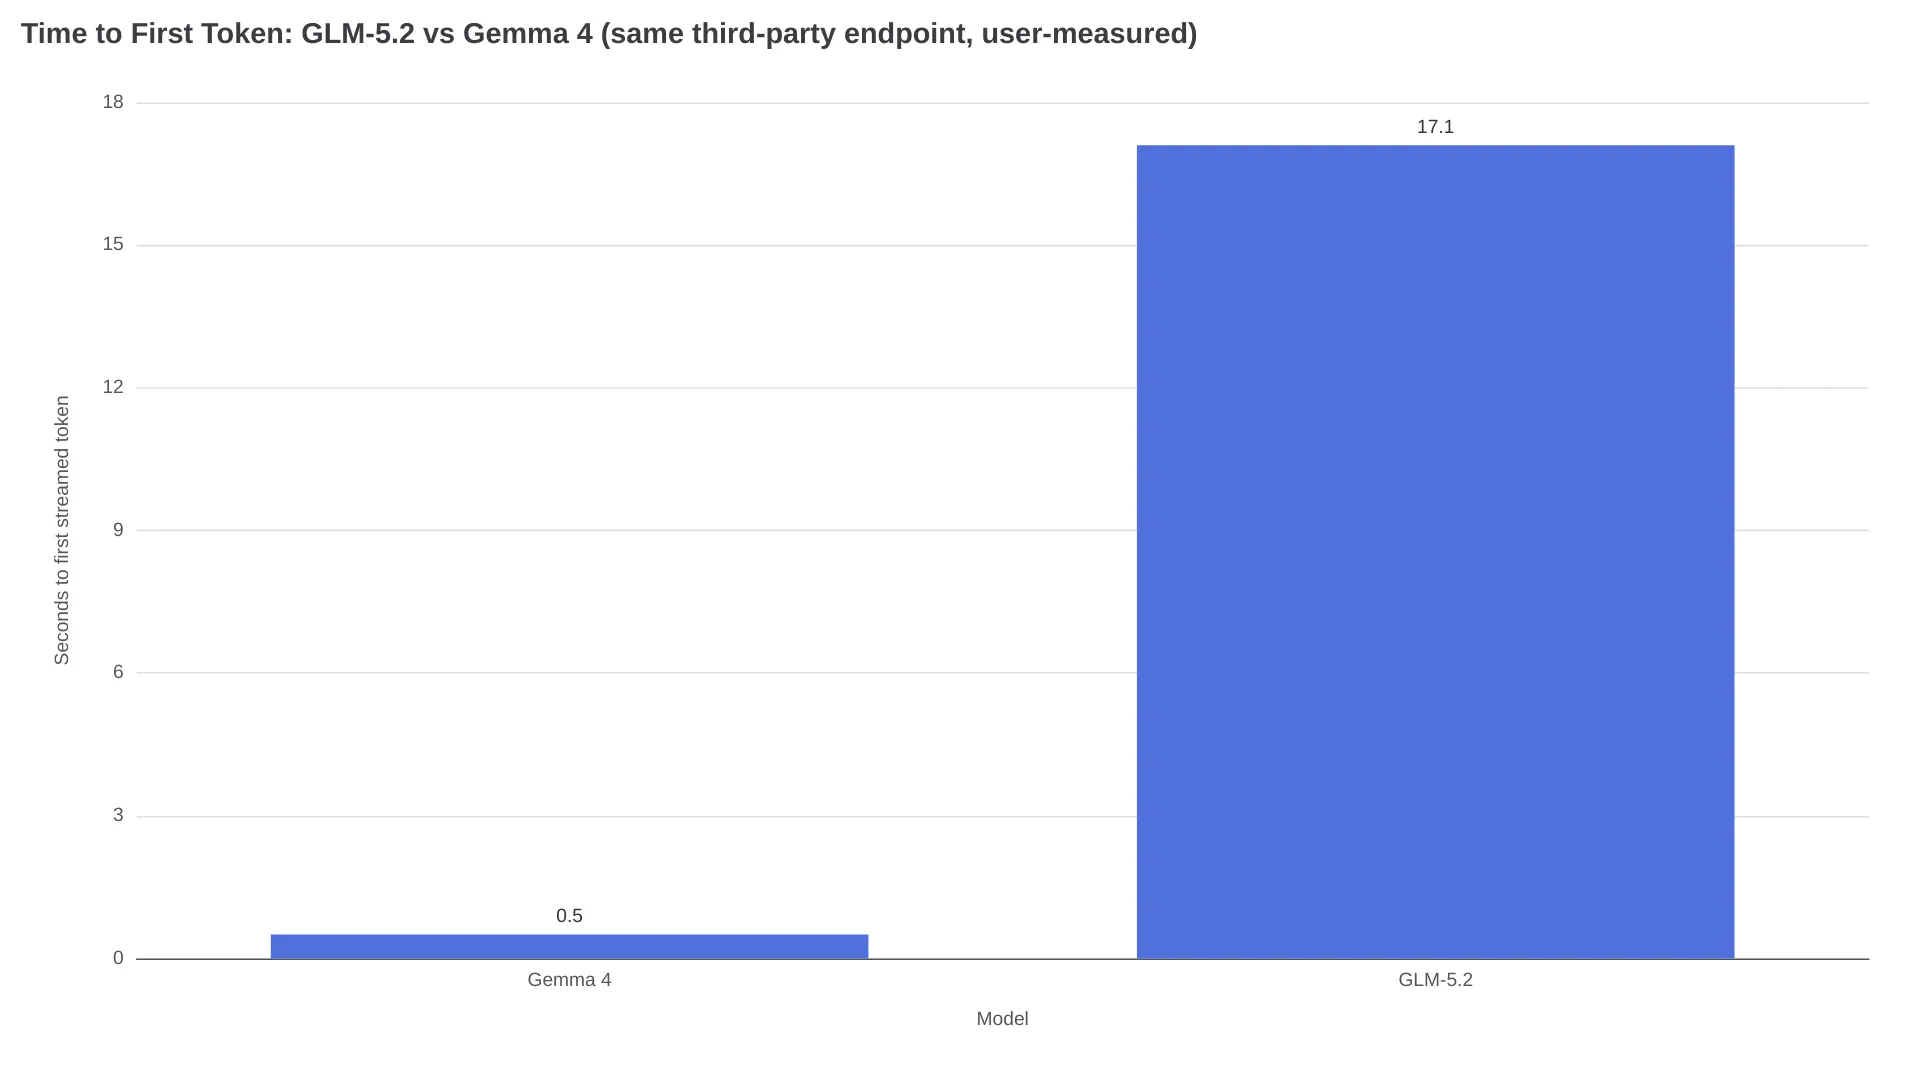
La latenza fino al primo token è il dato misurato più debole dell'API. Un test affiancato degli endpoint su Sarvam ha rilevato 148 token al secondo in streaming per GLM-5.2 contro i 260 di Gemma 4, con un time-to-first-token di 17.1 secondi contro 0.5: «starts generating 33x sooner», secondo @noctus91.
Anche il throughput pubblicizzato soffre dello stesso problema:
«All these GLM 5.2 providers advertise 200+ tok/s. Yet you try them and get 50 tok/s» — @tomgreenwald, che definisce il fenomeno «benchmaxxing but for providers.»
Sui percorsi in abbonamento sono emerse altre due forme di errore: stream che si interrompono a metà sessione — «the streaming just...stopped», tanto da spingere un utente del GLM Pro Coding Plan a rinunciare del tutto — e degrado al crescere della scala: «when you reach 300k+ context the model getting slow» (@mosh_Ontong). Per confronto, il benchmark eseguito da DataLLM Lab su nove task, tramite il proprio gateway, ha registrato in media 12.3 secondi per task completato: gran parte della storia della latenza dipende dall'endpoint, non dal modello.
Rate limit e 429: i retry diventano la norma
La documentazione del modello Z.ai non pubblica alcuna tabella dei rate limit, perciò gli sviluppatori li scoprono empiricamente, attraverso le 429. Sui percorsi Coding Plan, il quadro emerso dalla community è chiaro: i retry sono parte dell'operatività normale, non un'eccezione. Queste discussioni identificano modalità di errore, non tassi di prevalenza, ma riportano segnali coerenti.
Da una discussione sui rate limit in r/ZaiGLM:
- «Right now hitting 429/529 on coding max plan nearly for every second request. No concurrency...» — u/A-B-user
- «Yes, almost every request is retried, but the results are very good» — u/hyeluoh
- «It works fine (super slow but no errors) if I use single concurrency for glm52» — u/evia89
Gli errori dipendono anche dal client: la stessa API key funziona in ZCode ma genera 429 in OpenClaw, che un altro utente descrive come messaggio di servizio «troppo occupato». Gli strati in abbonamento complicano ulteriormente il quadro: utenti cinesi segnalano che il Coding Plan sposta automaticamente i workload 5.2 su GLM-5.3, consumando più rapidamente la quota, e che rivenditori terzi del Coding Plan applicano rate limit dopo poche chiamate.
Le contromisure tecniche più solide sono backoff esponenziale con jitter, idempotency key per qualunque operazione di scrittura, un budget di retry per task anziché per richiesta e una modalità degradata con concurrency=1 attivabile automaticamente. I pattern di retry della nostra guida per risolvere le 429 di OpenRouter si applicano qui senza modifiche.
Il nodo irrisolto della fatturazione della cache
Il context caching è documentato e, quando abbiamo consultato le pagine dei provider il 13 luglio, l'input in cache risultava quotato a circa $0.26 per milione di token contro $1.40 per input nuovo. La lamentela ancora senza risposta — quella con il maggior coinvolgimento tra le segnalazioni API esaminate nelle discussioni della community — è che su alcuni percorsi il contesto ripetuto venga fatturato come input nuovo, moltiplicando il costo di ogni loop agentico che reinvia un system prompt esteso.
«cached tokens are not working properly on GLM 5.2. The repeated context is being counted as normal input instead of cached tokens.» — @Da7_Tech, che parla di «a serious billing/cache accounting problem.»
Nella stessa discussione, un task completato da Claude Opus 4.8 in meno di 1.5M token risultava ancora incompleto su GLM-5.2 dopo 53M token, con la quota di cinque ore al 100%, mentre il contatore interno dell'app mostrava circa 1.67M.
Due mesi più tardi, lo stesso developer riassumeva ancora così: «plenty of users complain that cache hits appear to count against usage. If that happens to you, the value of the plan collapses.» In quelle discussioni non è comparsa una risposta ufficiale fino alla fine di agosto.
Finché non vi sarà conferma che il problema è stato risolto, il prezzo dell'input cached va considerato uno scenario ottimistico da verificare sulle proprie fatture: registrate cached_tokens nell'oggetto usage di ogni risposta e riconciliate i dati ogni settimana.
Reasoning effort: un controllo, tre denominazioni
La superficie ufficiale espone thinking.type con valori enabled/disabled e reasoning_effort con valori high e max; gli esempi della documentazione usano reasoning_effort: "max". Le indicazioni di lancio di Z.ai affermavano che max punta alla capacità massima, mentre high bilancia prestazioni ed efficienza dei token; per il codice è raccomandato max.
Da qui derivano due aspetti importanti per l'integrazione. Il primo: i percorsi coding usano max come impostazione predefinita. «It defaults to max so you don't need to unless you want to scale it down» (r/ZaiGLM). I token di reasoning vengono tariffati alle tariffe di output, quindi il default può far crescere silenziosamente la spesa. Nei Coding Plan, inoltre, gli utenti che hanno documentato la contabilità del piano riportano che le chiamate con effort max consumano 3x quota nella fascia di Pechino 14:00–18:00 dei giorni feriali, sommandosi a una finestra di cinque ore e ai crediti settimanali.
Il secondo: spesso il controllo non raggiunge il backend. Gli utenti di OpenCode riferiscono che «currently it does not let you tweak reasoning effort» per i provider custom; alcuni client presentano poi la stessa opzione con un terzo nome, xhigh, senza necessariamente inoltrarla al provider (r/opencodeCLI). Anche la verbosità dipende dallo stesso controllo: un developer che effettua confronti quotidiani ha osservato che un modello concorrente era «not as verbose as Opus-4.8 or GLM-5.2.»
Stesso model string, comportamenti diversi: il drift degli endpoint
glm-5.2 è un unico model string che può puntare a deployment sostanzialmente differenti. Quando a inizio agosto hanno iniziato a circolare risultati sull'accuratezza degli endpoint, il responsabile di Z.ai ha chiesto alla community «to test the official GLM-5.2 API as an additional reference point. It may score above 100%» — @ZixuanLi_. Il riferimento indicato era l'API ufficiale, non gli endpoint di terze parti misurati nel report.
In pratica, il drift si manifesta con limiti di output token abbastanza bassi da troncare il reasoning a metà stream, throughput elevato nella fase di lancio che poi svanisce — il pattern di «benchmaxxing» citato sopra — e soglie di contesto diverse in base all'host. Together AI offre GLM-5.2 con 256K, mentre l'API ufficiale, che nella documentazione dichiara 1M, e gli aggregatori nel nostro confronto di luglio mantengono la finestra completa.
La variazione dei prezzi è ancora più ampia di quella comportamentale: rispetto al listino Z.ai di $1.40/$4.40, nel nostro confronto provider di luglio OpenRouter indicava $0.42/$1.32, con tariffe per input cached da $0.14 su Fireworks a $0.26. Scegliete l'endpoint in funzione del workload, quindi testatelo di nuovo su quell'esatto endpoint: un comportamento verificato su un percorso non è trasferibile a un altro.
Prima del deploy: un pre-flight test da 30 minuti
Tutte le modalità di errore descritte sopra sono rilevabili in mezz'ora, prima di vincolare un workload di produzione. Eseguite questi test sull'esatto endpoint, model string e SDK che intendete portare in produzione:
- Testate i conflitti nel contratto dei tool. Inviate
tool_choice: "required"insieme all'istruzione di non usare tool eparallel_tool_calls: falsecon un prompt contenente due ordini. Aspettatevi che entrambi vengano ignorati; se la vostra orchestrazione dipende da uno dei due, fermatevi qui. - Stress test dei retry. Lanciate 50 richieste alla concurrency prevista e registrate il tasso di 429/529 insieme al rapporto tra retry riusciti e tentativi. Se i retry superano circa un terzo delle richieste, una soglia operativa prudente, portate la concurrency a 1 e misurate di nuovo.
- Controllate la contabilità della cache. Reinviate cinque volte un prefisso identico da 10K token; sommate
cached_tokensdalle risposte usage e confrontate il totale con l'input fatturato nella dashboard. Una discrepanza qui invalida il modello di costo. - Misurate la latenza con contesto realistico. Rilevate time-to-first-token e stalli durante lo stream a dimensioni di contesto rappresentative, non con un smoke test da 1K token: altrimenti il rallentamento oltre 300K resta invisibile.
- Scegliete il percorso corretto. Il Coding Plan è progettato per tool di coding interattivi; le analisi sulla contabilità del piano riportano che non è concesso per servire siti web, bot o traffico SaaS. I backend di prodotto devono quindi usare l'API a consumo.
Il compromesso non si risolve del tutto: GLM-5.2 propone alcuni dei token per coding capaci più economici sul mercato, ma il prezzo d'ingresso è un lavoro di wrapper engineering che le API frontier incorporano invece nel costo per token.
FAQ sulla recensione dell'API GLM-5.2
Posso usare l'SDK OpenAI con GLM-5.2?
Sì, per le chat completions: impostate base_url su https://api.z.ai/api/paas/v4/ e il modello su glm-5.2. Non esiste una Responses API, quindi la superficie più recente di OpenAI, incluso Codex, richiede un livello di traduzione.
L'API GLM-5.2 supporta streaming, function calling e structured output?
Tutte e tre sono funzionalità documentate, insieme a context caching e MCP. Le riserve riguardano il comportamento: la stabilità dello streaming varia in base all'endpoint e i campi di controllo dei tool in stile OpenAI, cioè tool_choice oltre auto, parallel_tool_calls e strict, non vengono rispettati.
Quali model string e base URL devo usare?
Per il percorso ufficiale a consumo: glm-5.2 su https://api.z.ai/api/paas/v4/. Il Coding Plan utilizza una base diversa, mentre OpenRouter elenca il modello come z-ai/glm-5.2.
Perché GLM-5.2 è lento o insolitamente verboso?
I percorsi coding usano per default il reasoning effort max, tariffato come token di output, e le segnalazioni della community collocano il throughput sostenuto più vicino a 50 tok/s che agli oltre 200 pubblicizzati. Latenza e verbosità sono più spesso effetti di configurazione ed endpoint che limiti intrinseci del modello.
Posso alimentare l'API della mia applicazione con il GLM Coding Plan?
No. Le analisi sulla contabilità del piano riportano che l'abbonamento è destinato a tool di coding interattivi ed esclude la fornitura di servizi a siti web, bot o prodotti SaaS. I moltiplicatori di quota nelle ore di punta di Pechino lo rendono comunque poco adatto a un traffico costante.
La finestra di contesto da 1M è disponibile presso tutti i provider?
No. L'API ufficiale e la maggior parte degli aggregatori supportano 1M, ma Together AI limita GLM-5.2 a 256K: una differenza sufficiente a modificare l'architettura dei workflow su repository di grandi dimensioni.
Approfondimenti correlati
- Recensione GLM-5.2: due mesi dopo l'hype — qualità del modello, benchmark e profili d'uso consigliati
- API GLM 5.2: accesso più economico, prezzi e chiavi gratuite — la matrice completa dei prezzi dei provider
- GLM-5.2 vs GLM-5.3 — se il successore di agosto cambia davvero la valutazione