 AIREITER
I miglioramenti nel coding attribuiti a GLM-5.3 sono, per ora, dichiarazioni dell'annuncio. Alla verifica del 14 agosto 2026, la documentazione pubblica dell'API Z.ai e la relativa tabella prezzi riportano ancora glm-5.2, non glm-5.3. Riferimento API Z.ai Prezzi Z.ai
In breve: aggiorna la valutazione, non il traffico di produzione
GLM-5.3 merita un pilot controllato sui compiti più impegnativi per coding agent, ma solo se è disponibile attraverso un canale di accesso verificato. GLM-5.2 dovrebbe restare il riferimento in produzione finché GLM-5.3 non offre un identificativo di modello confermato, condizioni operative chiare e risultati migliori sui task di accettazione della tua organizzazione.
Nell'annuncio di Z.ai su GLM-5.3, ripreso in una discussione pubblicata contestualmente al rilascio, si afferma che il modello mantiene la base di GLM-5.2 e ottiene nuove capacità tramite post-training. Viene dichiarato un miglioramento del 50% su Z.ai Code Bench e risultati open source ai vertici su Terminal-Bench 3.0 e Agents' Last Exam. La discussione citata, tuttavia, non riporta punteggi grezzi, configurazioni, prezzi, lunghezza del contesto o licenza. Discussione sul rilascio di GLM-5.3
Le differenze concrete tra GLM-5.2 e GLM-5.3
GLM-5.2 è un modello testuale documentato, con una superficie API pronta per la produzione. Z.ai indica una finestra di contesto da 1M token, output massimo di 128K, function calling, output strutturato, caching, supporto MCP e un checkpoint con licenza MIT su Hugging Face. Documentazione GLM-5.2 Model card GLM-5.2
GLM-5.3 viene presentato come un aggiornamento di post-training per coding e cyber-difesa. Il materiale di rilascio disponibile afferma che la base resta quella di GLM-5.2 e che i pesi sono previsti dopo valutazioni di sicurezza e hardening. Non conferma però che limiti di contesto e output, condizioni MIT o supporto API pubblico di GLM-5.2 vengano mantenuti senza variazioni. Discussione sul rilascio di GLM-5.3
| Area decisionale | GLM-5.2 | GLM-5.3 |
|---|---|---|
| Relazione con il modello base | Model card open-weight pubblicata | Z.ai afferma che usa la base GLM-5.2; i miglioramenti derivano dal post-training |
| Evidenze sul coding | La tabella del fornitore riporta 62.1 su SWE-bench Pro e 81.0 su Terminal-Bench 2.1 | Z.ai dichiara un risultato migliore del 50% sul proprio Code Bench interno; il materiale di rilascio non indica un punteggio assoluto |
| Specifiche per il contesto lungo | Documentati 1M di contesto e 128K di output massimo | Non specificate nel materiale di rilascio |
| Documentazione API pubblica | glm-5.2 è elencato nel riferimento chat-completions | glm-5.3 non compare nel riferimento verificato il 14 agosto 2026 |
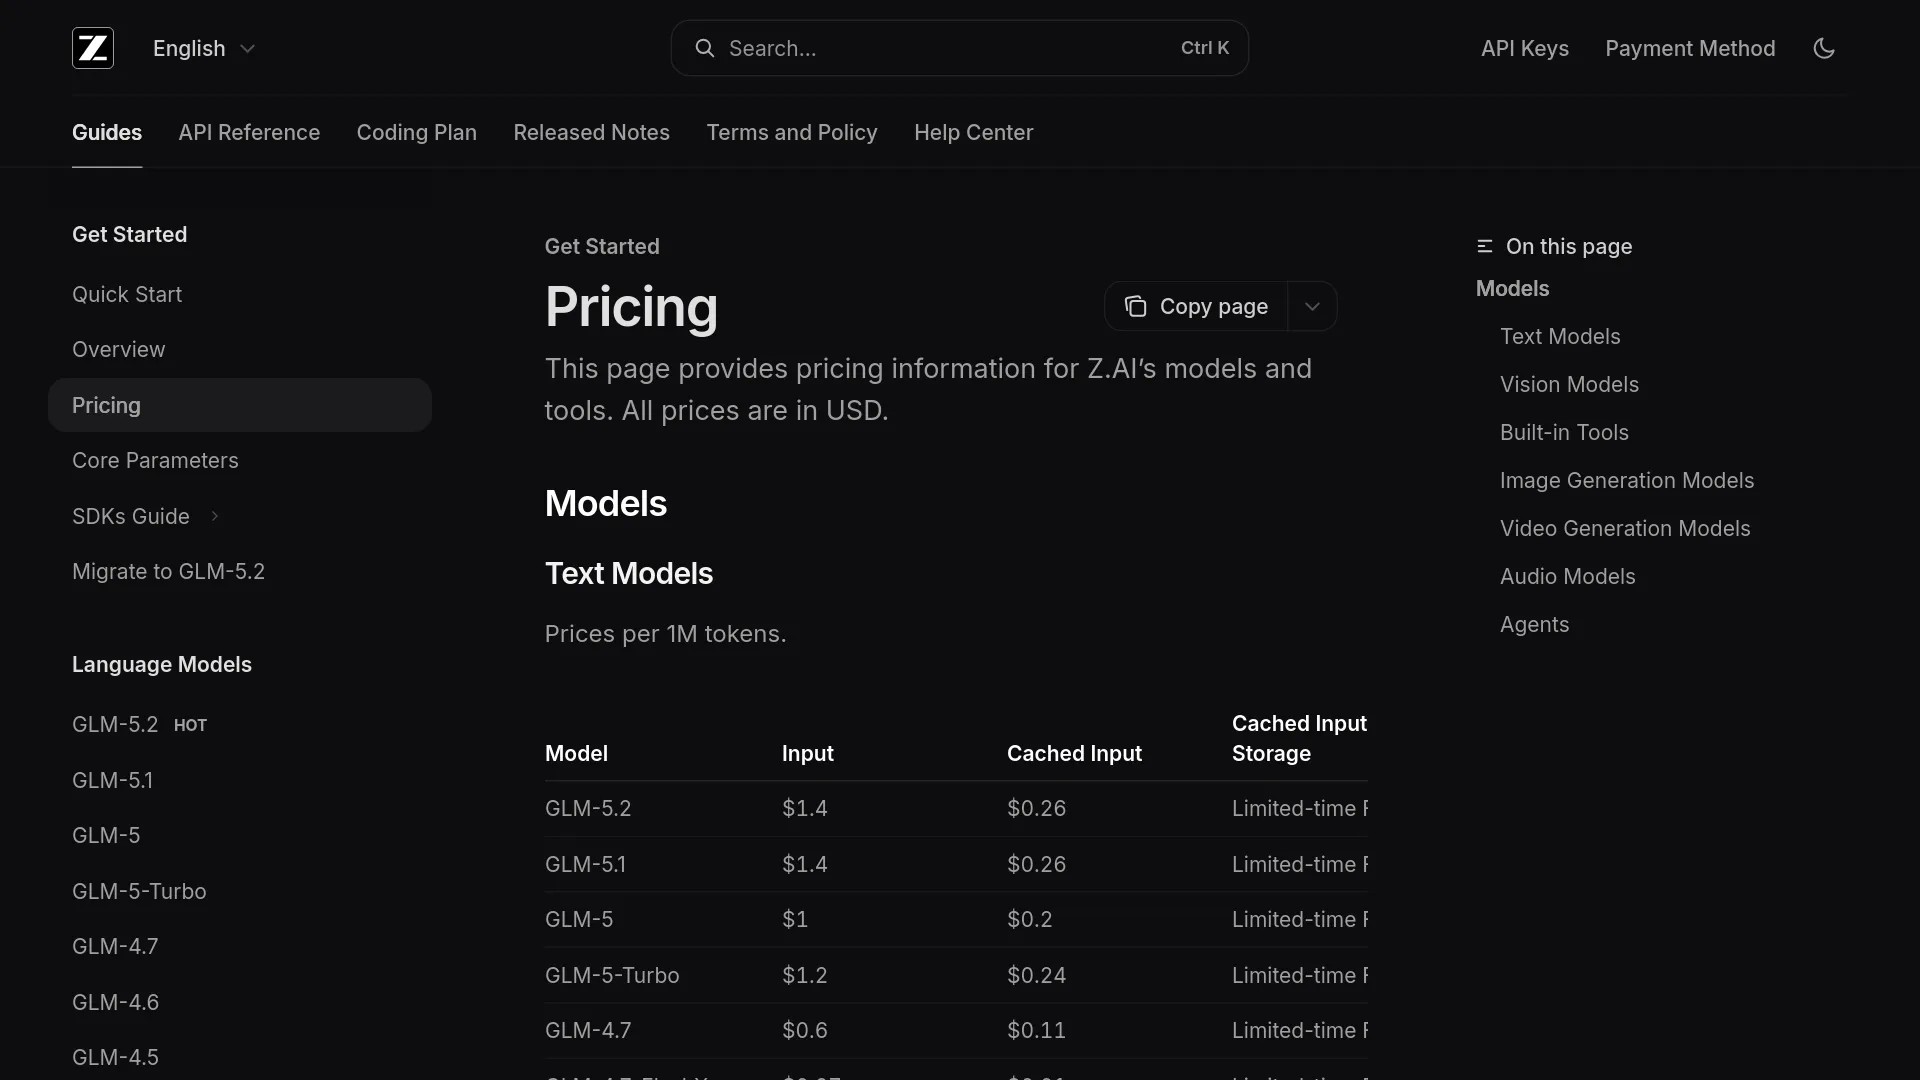
| Prezzo API diretto di listino | $1.40 input, $0.26 input in cache, $4.40 output per MTok | Non presente nella tabella prezzi pubblica verificata il 14 agosto 2026 |
| Pesi e licenza | Pesi GLM-5.2 scaricabili con licenza MIT | I pesi sono indicati come in attesa di valutazione sulla sicurezza; licenza non dichiarata |
I dati su GLM-5.2 sono documentati; per GLM-5.3 restano da confermare tutti gli aspetti per cui il materiale di rilascio non fornisce dettagli su API, prezzi, pesi o licenza. Riferimento API Z.ai Prezzi Z.ai Model card GLM-5.2
Perché il claim sul coding di 5.3 non basta per una migrazione diretta
Il dato del 50% su Code Bench non specifica set di task, harness dell'agente, budget di token e punteggi assoluti: informazioni indispensabili per stimare le prestazioni sui test di accettazione di un repository. Discussione sul rilascio di GLM-5.3
“L'harness conta ancora più del modello.” Fonte: Semgrep Security Research
L'esperimento IDOR di Semgrep con GLM-5.2 chiarisce bene il punto: su un dataset e in una singola esecuzione, la configurazione GLM-5.2 basata solo su prompt ha ottenuto il 39% di F1, mentre l'harness multimodale sviluppato ad hoc ha raggiunto il 61% con GPT-5.5. Gli autori invitano a non estendere quell'ordine di risultati oltre il task testato; per questo, un pilot con GLM-5.3 dovrebbe mantenere invariato lo scaffold esistente. Metodologia e risultati Semgrep
I risultati riportati per GLM-5.2 su FrontierSWE, DeepSWE e Terminal-Bench sono utili per scegliere i casi di test, ma la sua model card documenta anche harness specifici del modello, budget di token e impostazioni di valutazione. Model card GLM-5.2
Oggi il fattore decisivo è la disponibilità
Tra le due versioni, GLM-5.2 è l'unica con un contratto API pubblico chiaramente definito al momento della verifica. Il riferimento Z.ai per chat-completions usa glm-5.2 nell'esempio di richiesta, lo elenca tra i valori disponibili per i modelli testuali e indica che reasoning_effort è supportato solo da GLM-5.2. Riferimento Z.ai per chat-completions
Le segnalazioni della community sull'accesso non costituiscono prova di un'integrazione API pubblica supportata. Thread della community su GLM 5.3
Un test in tre task per decidere l'upgrade da GLM-5.2
Chi usa GLM-5.2 dovrebbe valutare una nuova versione come un cambiamento dell'intero sistema agente, anche se il modello base è condiviso. Nel primo confronto non modificare prompt, strumenti, permessi o policy di retry.
- Fissa tre task rappresentativi. Scegli un bug fix circoscritto con un test oracle, un refactoring su più file con controlli sulle modifiche vietate e un task di review o migrazione a contesto lungo. Congela commit del repository, testo del task, strumenti e criteri di accettazione.
- Verifica la route 5.3 prima di inviarle traffico. Annota fornitore, ID esatto del modello, limiti di contesto e output, prezzo per token, rate limit, condizioni sul trattamento dei dati e comportamento in caso di errore dalla documentazione corrente del fornitore. Non dedurre questi dati da GLM-5.2 o da uno screenshot di un piano per il coding. Riferimento API Z.ai Prezzi Z.ai
- Confronta gli esiti accettati, non un singolo punteggio. Esegui lo stesso scaffold con entrambe le versioni e registra tasso di accettazione, test falliti, modifiche vietate, tempo totale, token di input/cache/output, retry e tempo necessario per le correzioni umane. Instrada soltanto la classe di task in cui GLM-5.3 migliora gli esiti accettati senza un peggioramento inaccettabile di costi o affidabilità. Metodologia Semgrep
Scegli la versione in base allo scenario di deployment
| Il tuo scenario | Cosa scegliere ora | Prossima azione |
|---|---|---|
| App in produzione sull'API pubblica Z.ai documentata | GLM-5.2 | Mantieni la stringa del modello attuale e le metriche di riferimento |
| Accesso confermato a GLM-5.3 per task difficili di code agent | Pilot controllato con GLM-5.3 | Esegui il test in tre task con lo stesso harness |
| Deployment locale o privato | GLM-5.2 | Attendi la pubblicazione di pesi, licenza e indicazioni di serving per GLM-5.3 |
| Comprensione di screenshot, PDF o immagini | Nessuno dei due risultati risolve l'esigenza | Valuta un modello vision documentato; GLM-5.2 è text-to-text |
Testa 5.3 solo quando accesso documentato e risultati accettati migliori giustificano la sostituzione del riferimento 5.2. Discussione sul rilascio di GLM-5.3 Documentazione GLM-5.2
FAQ
GLM-5.3 è un nuovo modello base?
Secondo quanto dichiarato da Z.ai, GLM-5.3 usa la stessa base di GLM-5.2 e deve i suoi miglioramenti al post-training. Il materiale di rilascio citato non fornisce specifiche su una nuova architettura o sul numero di parametri. Discussione sul rilascio di GLM-5.3
GLM-5.3 è disponibile tramite l'API pubblica Z.ai?
Il riferimento pubblico di Z.ai verificato il 14 agosto 2026 non elenca glm-5.3; prima di integrare una route 5.3, controlla la documentazione aggiornata del fornitore. Riferimento Z.ai per chat-completions
GLM-5.3 mantiene il contesto da 1M e la licenza MIT di GLM-5.2?
Il materiale citato sul rilascio di GLM-5.3 non lo conferma. Il contesto da 1M e la licenza MIT di GLM-5.2 sono documentati nella sua model card ufficiale; avere in comune la discendenza dal modello base non prova che le condizioni di rilascio siano equivalenti. Model card GLM-5.2 Discussione sul rilascio di GLM-5.3