 AIREITER
Nei benchmark NVIDIA, Nemotron 3.5 Lightning resta dietro a Qwen 3.6 35B-A3B in 11 test su 12. Eppure promette una generazione di token fino a 4 volte più veloce. Non è una contraddizione: questo MoE da 30B, con appena 3B di parametri attivi per token, punta ai passaggi ripetitivi delle pipeline agentiche, dove velocità e costo contano più del ragionamento al massimo livello. Il compromesso è nell'hardware: i pesi BF16 a precisione piena richiedono una GPU da 80 GB, mentre NVIDIA indica il checkpoint NVFP4 come scelta consigliata per la produzione.
Perché Nemotron 3.5 Lightning non è il solito modello da 30B
Nemotron 3.5 Lightning adotta un'architettura ibrida che alterna livelli state-space Mamba-2, routing MoE e livelli di attention selettivi; NVIDIA definisce questa combinazione nemotron_h. I livelli Mamba-2 riducono il carico di memoria e calcolo dell'attention sui contesti lunghi. È così che Lightning arriva a una finestra di contesto da 1 milione di token, limitata nella pratica a 256K su una singola H100 da 80 GB secondo la model card, evitando il costo quadratico di un modello basato esclusivamente sull'attention.
| Specifica | Valore |
|---|---|
| Parametri totali | 30B |
| Parametri attivi per token | 3B |
| Architettura | Ibrida Mamba-2 + MoE + Attention |
| Lunghezza del contesto | Fino a 1M token (256K su una singola H100) |
| Opzioni di precisione | BF16, NVFP4 |
| Licenza | OpenMDW v1.1 (utilizzabile commercialmente) |
| Lingue | Inglese, spagnolo, francese, tedesco, italiano, giapponese + coding |
| Corpus di pre-training | 20T+ token |
| Modalità di ragionamento | Attivabile tramite enable_thinking nel chat template |
| Sampling consigliato | Temperatura 1.0, top-p 0.95 |
NVIDIA presenta Lightning come il membro più piccolo della famiglia Nemotron 3, addestrato specificamente per il comportamento degli agent harness: chiamate agli strumenti, validazione dell'output, formattazione dei risultati e delega a subagent. Un modello di ragionamento frontier, come Nemotron 3 Ultra, si occupa della pianificazione complessa; Lightning gestisce invece l'esecuzione ordinaria, che altrimenti consumerebbe il budget di token di un modello premium.
Benchmark: i punti di forza e i limiti di Lightning
La model card su HuggingFace pubblica 14 righe di benchmark che confrontano Lightning con Qwen 3.6 35B-A3B, Gemma 4 26B-A4B, Nemotron 3 Nano/Super e GPT-OSS 20B. Qui sotto sono riportate le 10 più utili per la scelta:
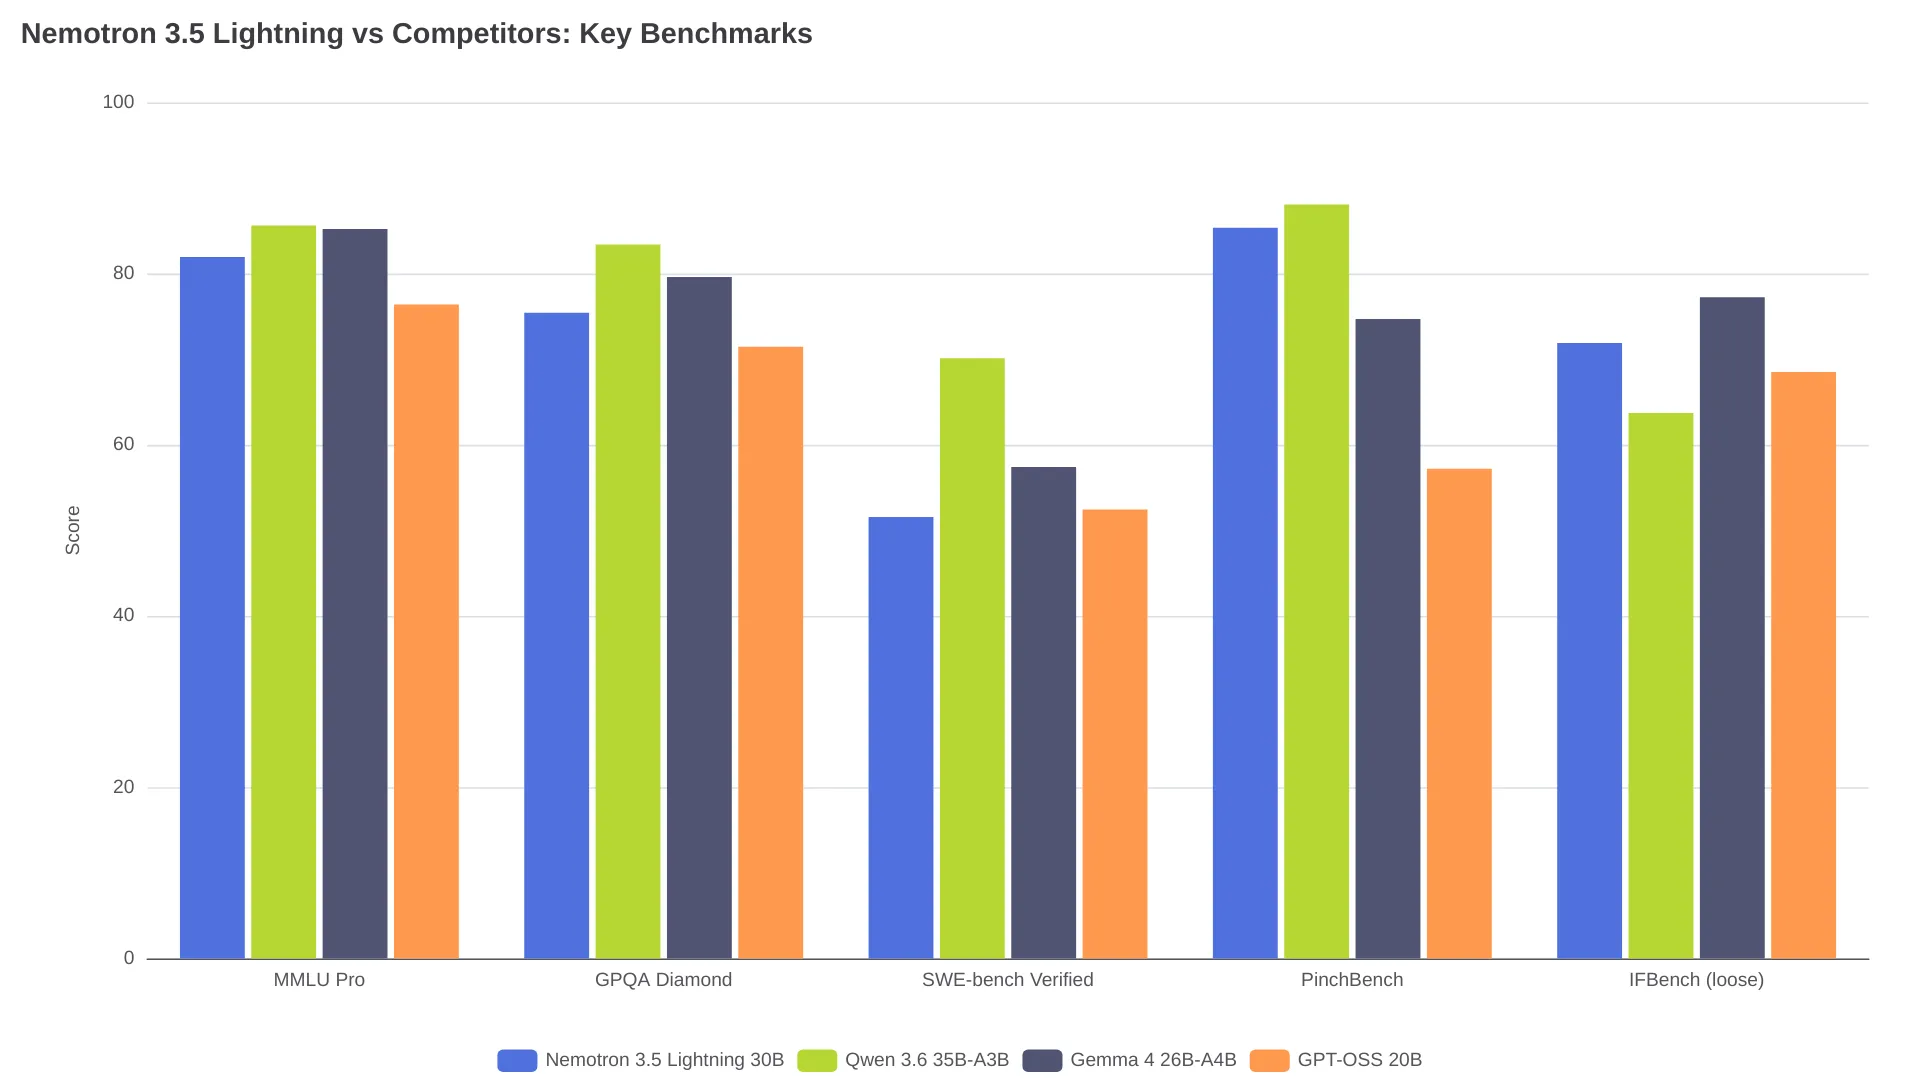
| Benchmark | Nemotron 3.5 Lightning | Qwen 3.6 35B-A3B | Gemma 4 26B-A4B | GPT-OSS 20B |
|---|---|---|---|---|
| MMLU Pro | 81.94 | 85.63 | 85.20 | 76.40 |
| GPQA Diamond (senza strumenti) | 75.44 | 83.40 | 79.61 | 71.46 |
| SWE-bench Verified | 51.56 | 70.12 | 57.40 | 52.44 |
| SWE-bench Multilingual | 39.33 | 63.40 | 43.40 | 41.93 |
| Terminal-Bench 2.1 | 24.58 | 44.38 | 37.22 | 15.17 |
| PinchBench | 85.37 | 88.07 | 74.70 | 57.20 |
| BrowseComp | 36.97 | 48.74 | 26.30 | - |
| IFBench (modalità loose) | 71.88 | 63.71 | 77.25 | 68.50 |
| AA-LCR | 52.00 | 61.06 | 57.56 | 32.88 |
| SciCode | 32.60 | 35.33 | 40.28 | 38.63 |
Lightning è dietro a Qwen 3.6 35B-A3B in 11 delle 12 righe comparabili. L'unica eccezione è IFBench, dedicato all'instruction following in modalità loose: 71.88 contro 63.71 di Qwen, un vantaggio di 8 punti coerente con il posizionamento del modello per l'esecuzione agentica. Quando bisogna formattare tool call e verificare output, seguire le istruzioni può essere più importante del ragionamento puro.
È sulla velocità che Lightning fa la differenza. Nella valutazione PinchBench di NVIDIA, composta da 10.000 task agentici misurati in GPU-hour H100, Lightning completa il carico in circa 16,5 GPU-hour con l'86% di accuratezza. Qwen 3.6 35B richiede invece 23,5-24 GPU-hour al 87%, mentre Gemma 4 26B arriva a 25-26 GPU-hour con il 73%:
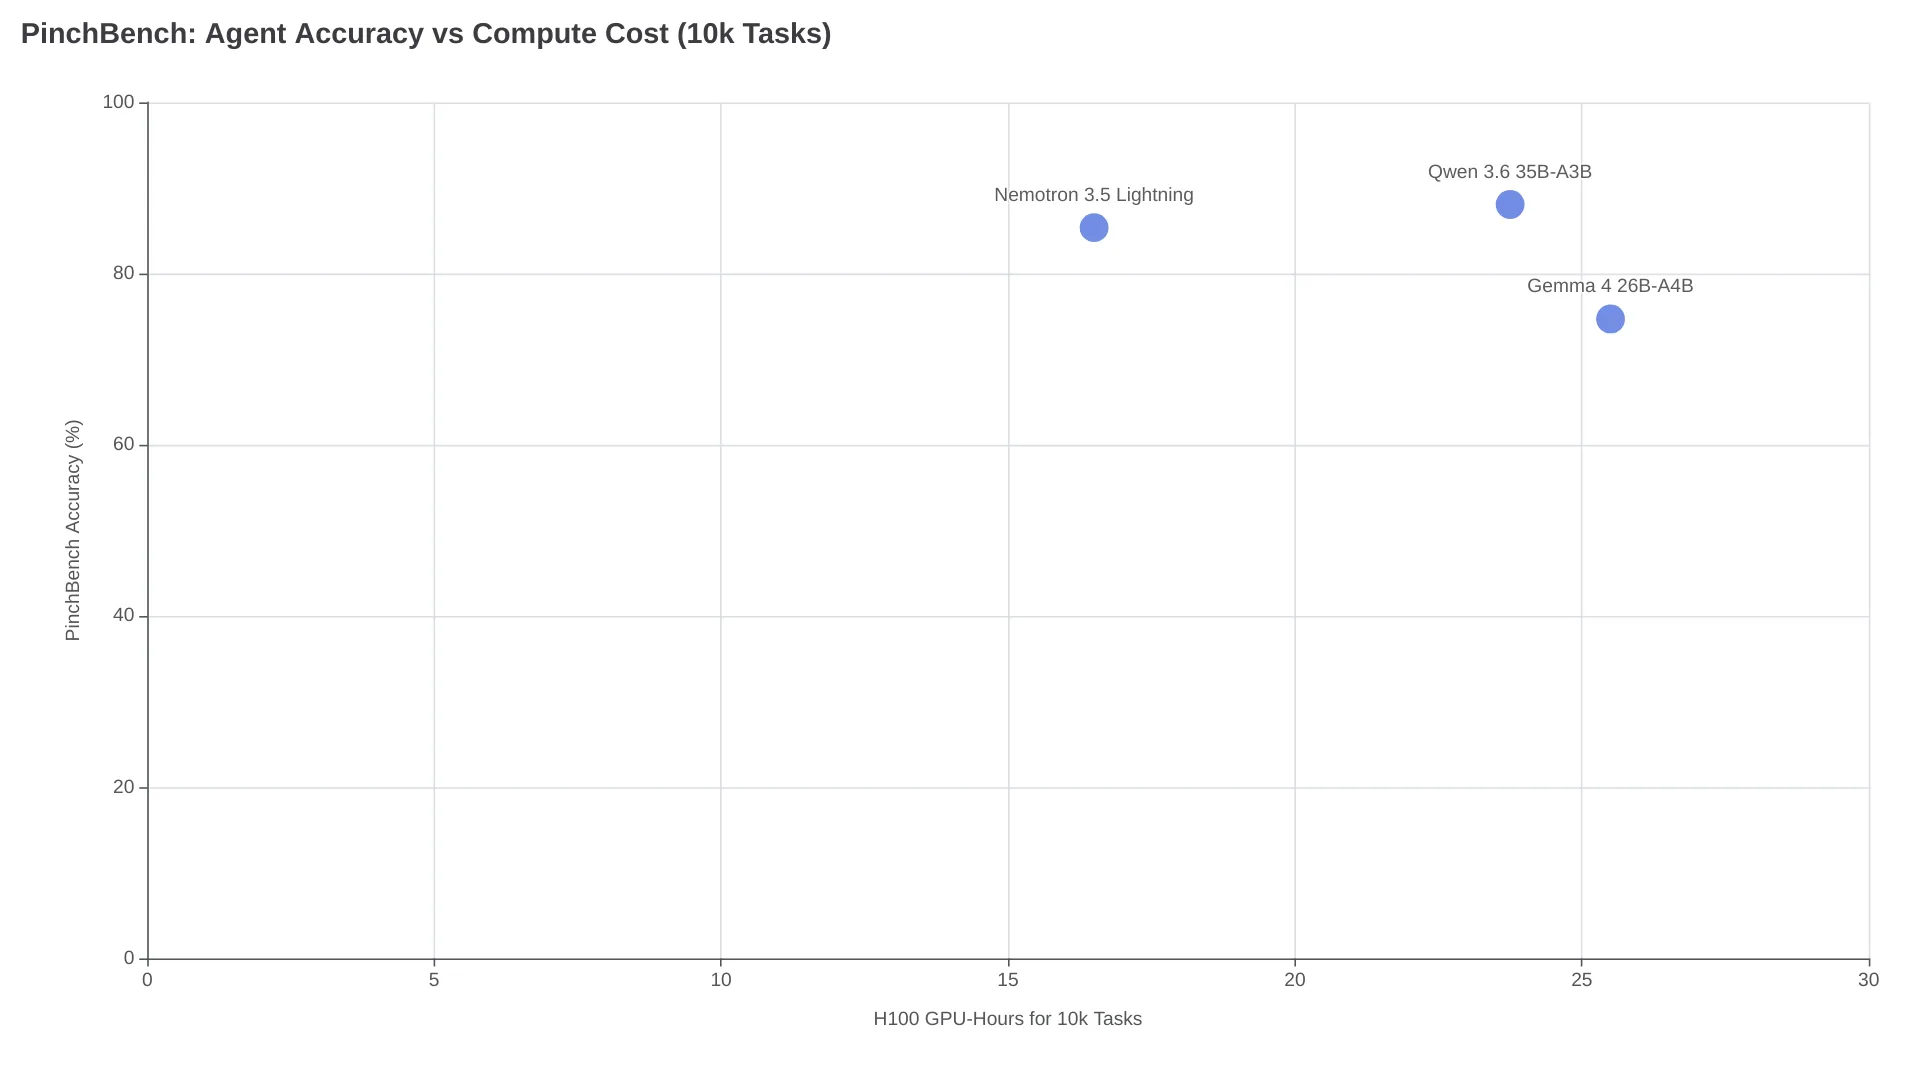
In sostanza, si parla di circa il 30% di calcolo in meno a fronte di un'accuratezza quasi identica: un vantaggio rilevante per chi esegue 10.000 passaggi agentici e paga a GPU-hour. NVIDIA riporta inoltre circa 670 token in output al secondo e ~23-24 punti Intelligence Index nella classifica di Artificial Analysis, collocandolo sulla frontiera di Pareto dei modelli open-weight con meno di 40B di parametri totali.
Anche i test della community su r/LocalLLaMA hanno rilevato velocità simili: un utente con DGX Spark ha segnalato 78,5 token al secondo in target-only e 90,7 token al secondo con speculative decoding sul checkpoint NVFP4. Un altro utente, nella discussione principale, ha collocato la qualità di Lightning «tra Gemma 4 26B e 31B, molto più vicina a 26B», osservando che gira circa 2 volte più veloce di Gemma 31B ma genera molti thinking token, che nella pratica riducono il vantaggio di velocità. Le prime conversioni GGUF Q4 hanno prodotto file da 25 GB con avvisi sui tensori inutilizzati: un segnale che l'architettura ibrida Mamba-2 potrebbe non essere ancora pienamente supportata da tutti gli strumenti basati su GGUF.
Requisiti hardware e opzioni per il deployment locale
Il checkpoint BF16, ovvero i pesi di riferimento a precisione piena, richiede 1x H100 80GB o 1x A100 80GB per il deployment su una singola GPU e utilizza un file safetensors shardato da 65,8 GB. NVIDIA raccomanda esplicitamente la release separata NVFP4 per l'inferenza in produzione.
| Checkpoint | Dimensione file (circa) | GPU minima | Ideale per |
|---|---|---|---|
| BF16 | 65.8 GB | 1x H100/A100 80GB | Fine-tuning, ricerca, creazione di varianti quantizzate |
| NVFP4 | ~16 GB | RTX 5090, DGX Spark, Jetson (Blackwell/Hopper/Ampere) | Inferenza in produzione, deployment di agenti |
| GGUF Q4 | ~25 GB | 16 GB+ VRAM (realizzato dalla community) | llama.cpp, Ollama, LM Studio |
NVIDIA ha collaborato con quattro progetti per il serving locale garantendo il supporto Day-0: vLLM, SGLang, Ollama e llama.cpp; vengono citati anche LM Studio e Unsloth. Il modello supporta tre strategie di speculative decoding:
- DSpark - consigliato per DGX Spark e inferenza data center a bassa concorrenza
- DFlash - modello draft alternativo, dipendente dal carico di lavoro
- MTP (Multi-Token Prediction) - integrato nel modello, ideale per concorrenza medio-alta
Per accedere al modello senza hardware locale, Lightning è disponibile su build.nvidia.com come microservizio NIM e su OpenRouter. Il checkpoint NVFP4 gira su GeForce RTX 5090, DGX Spark, sistemi OEM GB10 e NVIDIA Jetson.
Routing degli agenti: il caso d'uso in cui Lightning conta davvero
La libreria di routing open source di NVIDIA, NeMo Switchyard, assegna ogni passaggio di un workflow agentico al modello più adatto in base ad accuratezza, velocità e costo. La pianificazione viene inoltrata a un modello di ragionamento frontier, l'esecuzione a Lightning. In un proprio benchmark interno, NVIDIA sostiene che Switchyard abbia mantenuto un completamento dei task di «livello frontier», riducendo il costo a circa un terzo rispetto all'uso esclusivo di Opus 4.8. Tra le attività instradate su Lightning ci sono git pull, la validazione degli output degli strumenti, la formattazione dei risultati e le chiamate API di routine.
Non è soltanto un caso teorico. CodeRabbit ha pubblicato su Reddit un caso d'uso reale: ha effettuato il post-training di Nemotron 3.5 Lightning per il routing delle code review, combinando SFT mirato e RLVR (reinforcement learning con ricompense verificabili). Il modello ha superato la baseline in una valutazione congelata da 1.000 task, con meno di $100 di costi di training. NVIDIA supporta questo workflow con NeMo Automodel e NeMo Megatron Bridge per LoRA/SFT, NeMo RL e NeMo Gym per il reinforcement learning, oltre a un dataset aperto chiamato Nemotron-RL Agentic Terminal Pivot.
Per i team che costruiscono pipeline agentiche, la domanda concreta è questa: si può fare fine-tuning di Lightning affinché gestisca la maggior parte dei passaggi dell'agente al costo di 3B di parametri attivi, riservando un modello frontier ai pochi step che lo richiedono davvero?
Vale la pena usare Nemotron 3.5 Lightning?
| Caso d'uso | Consiglio | Motivo |
|---|---|---|
| Routing agentico ad alto volume (tool call, validazione, formattazione) | Lightning NVFP4 | 3B di parametri attivi, velocità token 4x, ~30% di calcolo in meno a precisione simile |
| Assistente di coding generalista | Qwen 3.6 35B-A3B | 70.12 contro 51.56 su SWE-bench Verified: 19 punti di differenza |
| Ragionamento / pianificazione complessi | Nemotron 3 Ultra o un modello frontier | Lightning non è concepito esplicitamente come modello di pianificazione |
| Chat locale su singola GPU consumer | Lightning NVFP4 su RTX 5090 | Funziona, ma le conversioni GGUF sono ancora acerbe; vLLM/SGLang sono più affidabili |
| Fine-tuning per un task agentico circoscritto | Lightning BF16 | 3B di parametri attivi = fine-tuning più economico; OpenMDW v1.1 consente l'uso commerciale |
| Instruction following su larga scala | Lightning | IFBench 71.88 contro Qwen 63.71: vantaggio di 8 punti |
Lightning sacrifica l'accuratezza di picco in favore della velocità nell'esecuzione ad alto volume. La riduzione del 30% nel calcolo si accumula su centinaia di passaggi agentici per sessione, ma il modello è stato lanciato l'11 agosto 2026 e il suo ecosistema è ancora in fase di maturazione. L'architettura ibrida Mamba-2 implica che gli strumenti basati su GGUF potrebbero non supportarla ancora completamente. Sull'hardware NVIDIA, con vLLM o SGLang, il checkpoint NVFP4 è oggi la strada più sicura per il deployment; su Apple Silicon o in configurazioni esclusivamente GGUF, è meglio attendere che la community stabilizzi le conversioni.
Domande frequenti
Nemotron 3.5 Lightning può girare su hardware consumer?
Per l'hardware consumer NVIDIA supporta solo il checkpoint NVFP4. I pesi BF16 richiedono una GPU da 80 GB, H100 o A100. NVFP4 gira su GeForce RTX 5090, DGX Spark e NVIDIA Jetson. Esistono conversioni community in GGUF Q4 per llama.cpp e Ollama su sistemi con 16 GB+ di VRAM, ma le prime build hanno segnalato problemi di tensori inutilizzati legati all'architettura ibrida Mamba-2.
Come si confronta Nemotron 3.5 Lightning con Qwen 3.6 35B?
Qwen 3.6 35B-A3B supera Lightning in 11 dei 12 benchmark pubblicati, con gli scarti maggiori su SWE-bench Verified e Terminal-Bench. Lightning vince nell'instruction following di IFBench e completa i task circa il 30% più rapidamente, a accuratezza simile, nei carichi agentici. Qwen è il modello generalista più forte; Lightning è quello più rapido nell'esecuzione degli agenti.
Nemotron 3.5 Lightning è valido per il coding?
Per i benchmark di coding puri, no: su SWE-bench Verified ottiene 51.56 contro i 70.12 di Qwen 3.6. Tuttavia, CodeRabbit ha effettuato con successo il fine-tuning di Lightning per il routing delle code review con meno di $100, superando la propria baseline. Il modello è progettato per la personalizzazione: addestrandolo sulle convenzioni del proprio codebase, può gestire task di coding di routine al costo di 3B di parametri attivi.
Quale licenza usa Nemotron 3.5 Lightning?
Il modello viene distribuito con licenza OpenMDW v1.1 (Open Model Data Weight), che NVIDIA descrive come rilasciata «nel modo più permissivo possibile». La licenza consente l'uso commerciale, inclusi pesi, dati di training e recipe. I termini completi sono disponibili nella model card su HuggingFace.