 AIREITER
Il prezzo per token di Hy4 preview è solo uno degli elementi da valutare. Tencent ha pubblicato un listino in CNY e OpenRouter offre già un endpoint live, ma la scelta della route dipende dall’uso della cache, dal supporto agli strumenti e dalla capacità del team di gestire un modello distribuito su otto GPU.
Prezzi API di Hy4 preview in sintesi
Tencent Cloud TokenHub indica per Hy4 preview CNY 6 per milione di token in input, CNY 18 per milione di token in output e CNY 0.30 per milione di token di input letti dalla cache. Nella pagina del modello ospitato, OpenRouter riporta gli stessi parametri a $0.834, $2.501 e $0.042.
| Route | Input / 1M token | Output / 1M token | Input da cache / 1M token | ID modello |
|---|---|---|---|---|
| Tencent Cloud TokenHub | CNY 6 | CNY 18 | CNY 0.30 | Da verificare in TokenHub |
| OpenRouter | $0.834 | $2.501 | $0.042 | tencent/hy4-preview |
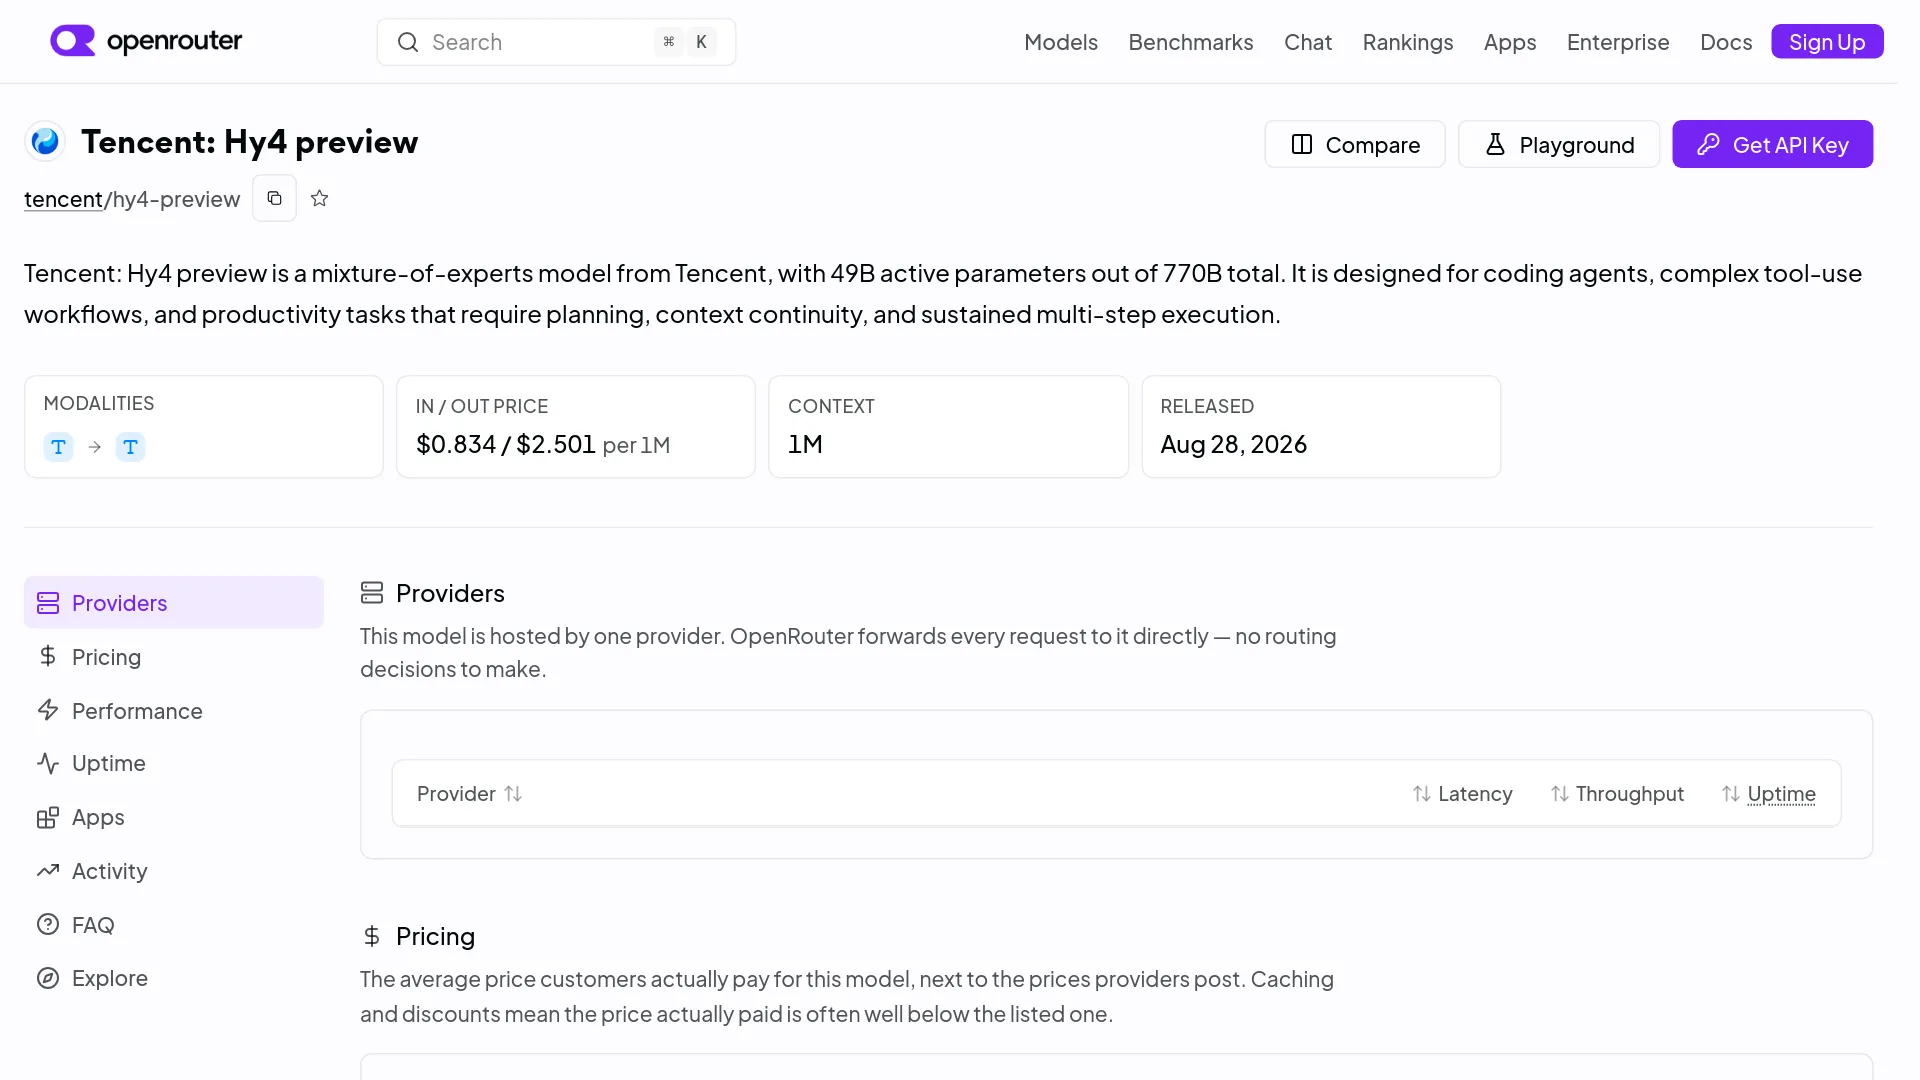
La pagina ufficiale dei prezzi di Tencent Cloud TokenHub, aggiornata il 28 agosto 2026, è la fonte più solida per il listino in CNY. La pagina del modello su OpenRouter è invece la fonte per l’ID del modello ospitato, il limite di contesto esatto, il tetto massimo di completamento e le funzionalità dell’endpoint.
Dividendo ogni prezzo OpenRouter per il corrispondente valore Tencent si ottiene circa $0.139 per CNY per tutti e tre i parametri. Si tratta di un allineamento implicito tra i listini pubblicati dai provider, non di un tasso di cambio di mercato: tasse, commissioni valutarie, condizioni dell’account e routing possono comunque modificare l’importo fatturato.
Un calcolo realistico del costo di Hy4
Con 100.000 token in input e 10.000 token in output, una richiesta costa CNY 0.78 secondo il listino Tencent:
- Input:
0.1 × CNY 6 = CNY 0.60. - Output:
0.01 × CNY 18 = CNY 0.18. - Totale: CNY 0.78.
Se i 100.000 token di input rientrano in un cache hit, la stessa richiesta costa circa CNY 0.21: 0.1 × CNY 0.30 + 0.01 × CNY 18.
Ai prezzi mostrati da OpenRouter, i totali equivalenti sono $0.10841 senza cache e $0.02921 con l’input in cache. I calcoli presuppongono esattamente i volumi di token indicati ed escludono eventuali costi del provider o rettifiche dell’account.
Perché l’output fa salire rapidamente la spesa
In entrambi i listini visualizzati, l’output costa tre volte l’input nuovo. Trace lunghi degli agenti, patch di codice e report generati possono quindi diventare la voce di spesa dominante, anche quando il system prompt o il prefisso di un repository sono memorizzati in cache.
Registra separatamente input nuovo, input letto dalla cache e output. Un cache hit riduce la quota del prompt, non il costo della risposta generata.
Cosa offre l’API a questo prezzo
Hy4 preview è un modello Mixture-of-Experts con un backbone da 770B di parametri totali, 49B di parametri attivi per token e una finestra di contesto da 1M token. Tencent lo posiziona per attività software a lungo raggio, pianificazione e produttività, ma le evidenze disponibili sulla qualità provengono dal vendor e non da benchmark API indipendenti.
| Dato API o modello | Dettaglio verificato |
|---|---|
| ID del modello su OpenRouter | tencent/hy4-preview |
| Contesto | 1M token nella scheda Tencent; 1,048,576 su OpenRouter |
| Completamento massimo | 64,000 token su OpenRouter |
| Licenza | Apache License 2.0 nella model card Tencent |
| Checkpoint pubblicati | Hy4 preview e Hy4 preview-FP8 |
| Runtime locali ufficiali | vLLM e SGLang |
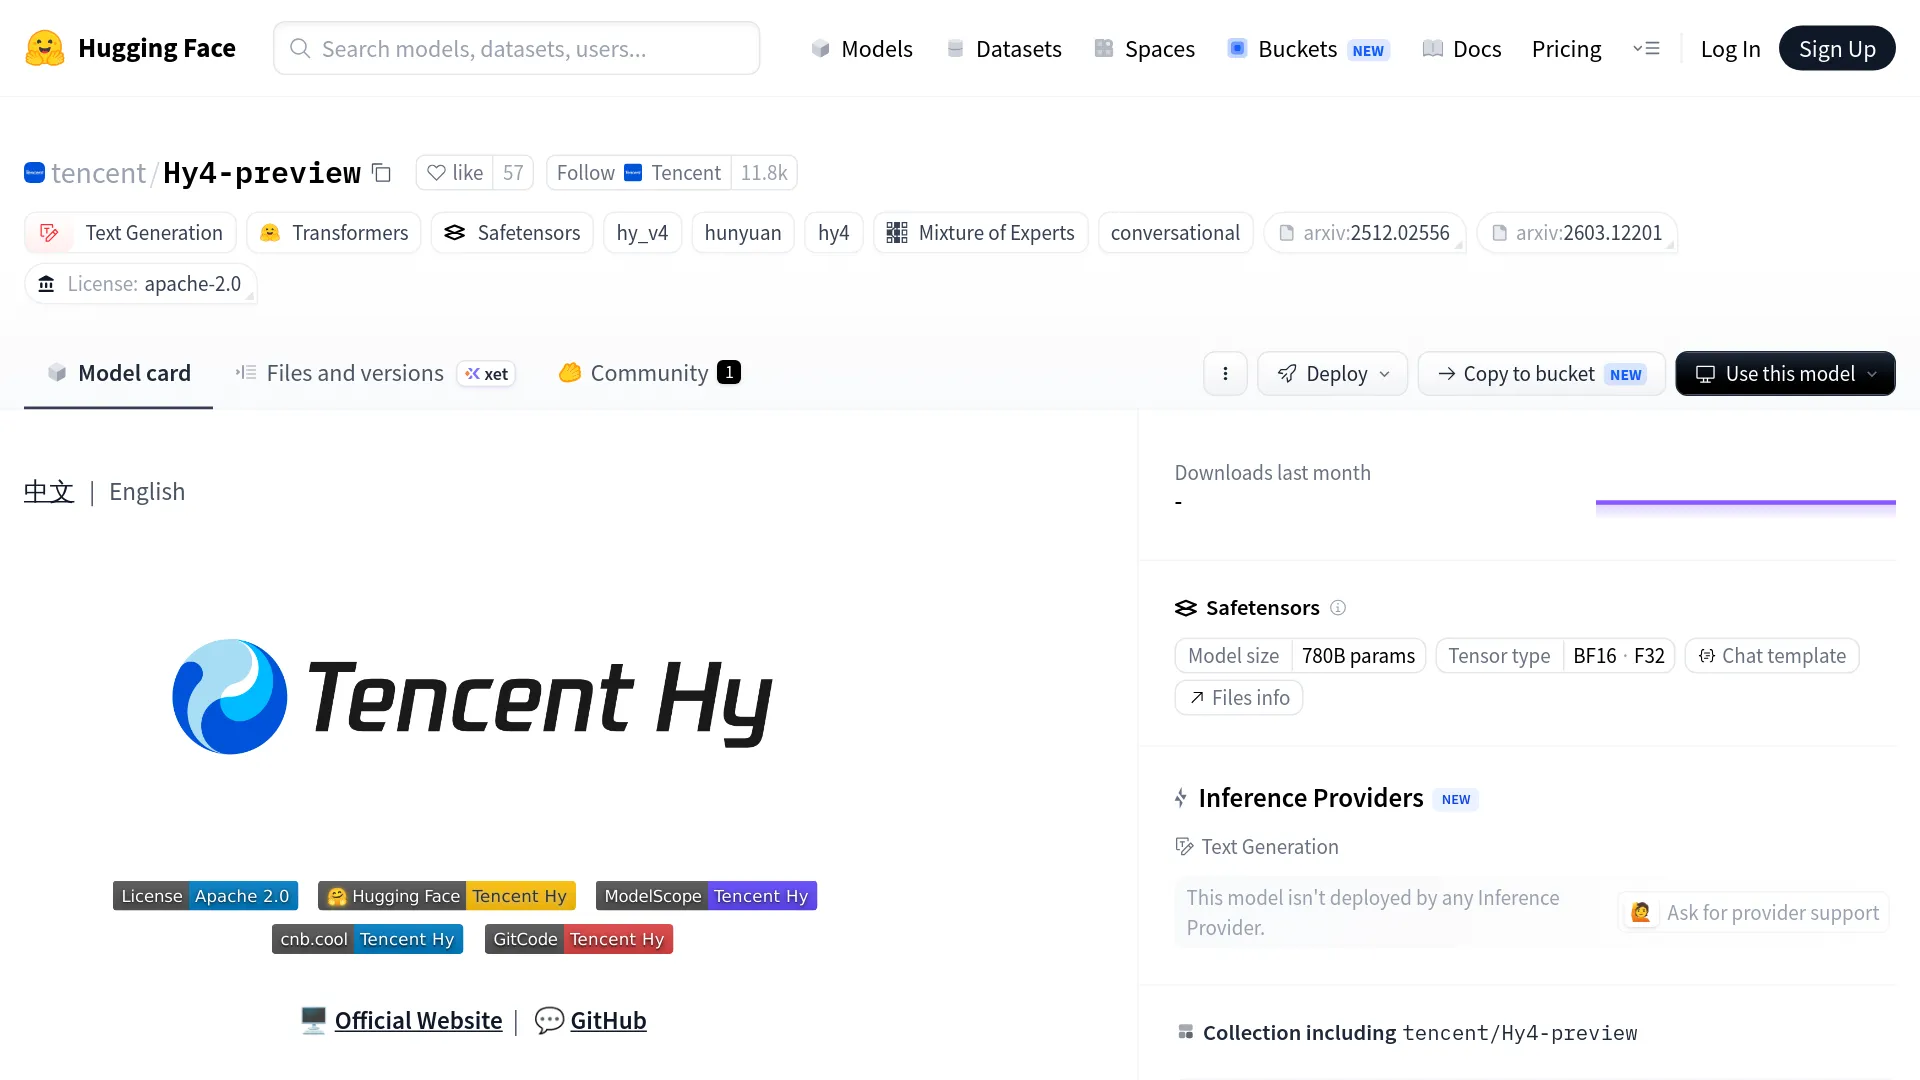
La model card ufficiale di Tencent pubblica pesi, licenza e documentazione per il deployment. Negli esempi di serving raccomanda il checkpoint FP8, ma non quantifica le differenze di memoria, throughput o qualità rispetto al checkpoint non FP8.
Il limite per gli agenti: OpenRouter non espone tool né JSON vincolato
La scheda OpenRouter segnala che questo endpoint non accetta tools e non supporta response_format per un output strutturato vincolato. È una limitazione della route, non la prova che ogni deployment locale di Hy4 sia privo di supporto per i parser.
Gli esempi Tencent per vLLM e SGLang includono parser per tool call e reasoning di Hy4. Se la tua applicazione dipende dal function calling nativo o da JSON vincolato a uno schema, verifica il provider scelto prima dell’integrazione e predisponi, quando necessario, un livello esterno di orchestrazione o validazione.
API ospitata o deployment locale?
Per la valutazione e per la maggior parte degli esperimenti iniziali in produzione, l’accesso hosted evita il lavoro su storage, GPU e runtime richiesto dalla procedura locale pubblicata. Il serving locale è sensato solo se il team gestisce già operazioni su GPU distribuite oppure ha esigenze stringenti di controllo dei dati.
| Fattore decisionale | API ospitata | Deployment locale di Hy4 |
|---|---|---|
| Configurazione | Account del provider e chiave API | Download dei pesi e preparazione del runtime |
| Scalabilità | Gestita dal provider | Gli esempi ufficiali usano parallelismo tensoriale a 8 vie |
| Storage | Nessun peso in locale | Repository Hugging Face indicato a circa 1.56 TB |
| Comportamento API | Dipende dal provider | La configurazione di vLLM/SGLang è sotto il tuo controllo |
| Rischio principale | Limiti della preview e cambi di route | Hardware, compatibilità del runtime e costi operativi |
Quando ha senso eseguire Hy4 in locale
Ospita Hy4 autonomamente solo se disponi già di infrastruttura multi-GPU adeguata, devi mantenere i prompt nel tuo ambiente, puoi gestire vLLM o SGLang e accetti il comportamento di un modello preview. Tencent documenta vLLM con Python 3.12 e SGLang con transformers>=5.6.0, ma quei comandi sono esempi e non requisiti minimi garantiti.
Una delle prime discussioni della community chiarisce anche perché la questione hardware va affrontata prima dei benchmark:
“I don't know who ... runs 780b models...” — u/_-_David nella discussione su Hy4 preview in r/LocalLLaMA.
È la reazione di un utente, non una misurazione della capacità. Resta comunque un filtro utile: un modello con contesto da 1M non è automaticamente praticabile in locale.
Hy3 resta il riferimento più economico
Hy3 standard è l’opzione meno costosa nella tabella TokenHub attuale di Tencent: CNY 1 in input, CNY 4 in output e CNY 0.25 di input da cache per milione di token. Il costo dell’input nuovo di Hy4 è sei volte superiore, mentre l’output costa 4.5 volte di più; il passaggio va quindi giustificato da un’esigenza concreta di contesto più ampio o da prestazioni migliori su attività complesse.
| Domanda di scelta | Scegli Hy4 preview quando… | Scegli Hy3 standard quando… |
|---|---|---|
| Contesto | Il carico di lavoro richiede la classe da 1M token | I prompt rientrano in un limite attuale inferiore |
| Budget | Le capacità aggiuntive giustificano il prezzo CNY 6/18 | Conta soprattutto ridurre il costo per token |
| Stabilità | Puoi testare una route preview | Vuoi una base consolidata e più semplice |
La stessa pagina ufficiale di TokenHub segnala la rimozione di Hy3 preview il 31 agosto 2026, quindi non è un obiettivo sensato per una nuova integrazione.
Prima di portare Hy4 preview in produzione
- Registra provider, ID del modello, valuta, regione e timestamp del listino.
- Invia una richiesta breve e verifica modello e provider restituiti.
- Ripeti una richiesta con un prefisso stabile per controllare la contabilizzazione della cache.
- Prova la lunghezza di contesto realmente necessaria alla tua applicazione, senza dare per scontata la qualità sull’intera finestra.
- Testa separatamente un completamento lungo, perché l’output è il parametro più costoso.
- Se servono alla tua applicazione, invia richieste di tool call e output strutturato: OpenRouter attualmente dichiara entrambi non supportati.
- Registra input nuovo, letture dalla cache, output, errori e retry.
- Mantieni un fallback e prompt di regressione mentre la route costruisce uno storico di uptime e utilizzo.
OpenRouter riporta attualmente dati insufficienti su uptime e utilizzo applicativo per Hy4 preview. Questo non dimostra una scarsa affidabilità, ma significa che esiste poca cronologia pubblica del servizio su cui basare la pianificazione della capacità.
FAQ sui prezzi API di Hy4 preview
Quanto costa l’API di Hy4 preview?
Tencent Cloud TokenHub indica CNY 6 per l’input, CNY 18 per l’output e CNY 0.30 per l’input da cache per milione di token. Nella sua pagina hosted, OpenRouter riporta $0.834, $2.501 e $0.042 per gli stessi parametri.
Qual è l’ID del modello Hy4 preview su OpenRouter?
Usa tencent/hy4-preview. Verifica provider e modello restituiti nel tuo account, perché le impostazioni di routing hosted possono cambiare.
Hy4 preview supporta una finestra di contesto da 1M token?
Sì. La model card Tencent indica 1M token, mentre OpenRouter specifica 1,048,576 token e un completamento massimo di 64,000 token per la sua route.
Hy4 preview è open source?
Tencent pubblica i checkpoint di Hy4 preview con Apache License 2.0 nella sua model card ufficiale. Per i checkpoint scaricabili, “open-weight” è una definizione più precisa.
L’endpoint OpenRouter supporta il tool calling?
La scheda OpenRouter acquisita indica di no. Non accetta tools e non supporta output strutturato vincolato tramite response_format; il serving locale e altri provider possono esporre comportamenti diversi.
La scelta in una riga
Usa una route hosted di Hy4 preview per valutazioni controllate ed esperimenti con contesti lunghi; ospitalo autonomamente solo se capacità GPU distribuita, esigenze di controllo dei dati e rischio legato alla preview sono compatibili con il tuo carico di lavoro.