 AIREITER
Fino al 31 dicembre 2026, Gemini 3.8 Flash costa $0.75 per milione di token in input e $3.75 per milione di token in output. Il ragionamento più intenso, però, può far salire il costo delle attività completate. Ha senso provarlo per agenti multimodali e specializzati, non sostituire in blocco ogni richiesta oggi affidata a Gemini 3.7 Flash.
La risposta in breve: che cos’è davvero Gemini 3.8 Flash
Gemini 3.8 Flash è stato lanciato il 2 settembre 2026, secondo l’annuncio di lancio di Google, con l’ID del modello API stabile gemini-3.8-flash. Google lo presenta come una soluzione per l’ingegneria del software, gli agenti autonomi e i flussi di lavoro aziendali articolati in più passaggi. La pagina del modello per gli sviluppatori Google AI lo indica come stabile, mentre la scheda del modello Google DeepMind specifica che è basato su Gemini 3.7 Flash.
Cosa cambia rispetto a Gemini 3.7 Flash
Secondo Google, Gemini 3.8 Flash esegue più passaggi di ragionamento e richiama gli strumenti in modo iterativo quando affronta attività difficili, avvertendo però che un livello di impegno maggiore può consumare più token. Artificial Analysis gli assegna un punteggio Intelligence Index di 59 con ragionamento alto, contro 56 per Gemini 3.7 Flash, ma rileva anche un costo per attività di $0.58 contro $0.40. (Annuncio di lancio di Google; Confronto di Artificial Analysis)
Prima il carico di lavoro, poi il modello
Gemini 3.8 Flash dà il meglio quando una richiesta richiede un contesto ampio, più strumenti o informazioni multimodali. Per attività brevi e ripetitive, invece, i cicli aggiuntivi potrebbero non portare vantaggi.
Gemini 3.8 Flash per agenti multimodali e attività specialistiche
BenchmarkList riporta il 61.4% su Finance Agent v2, il 54.9% su HLE-Verified, l’87.8% su LVBench, l’86.2% su CharXiv-R e l’86.2% su LABBench2. I suoi record distinguono tra risultati dell’articolo di lancio, risultati auto-dichiarati e risultati ottenuti da fonti indipendenti: questi numeri sono quindi indicatori utili, non il risultato di un unico test indipendente e uniforme. (Scheda del modello su BenchmarkList)
| Carico di lavoro | Elementi da valutare | Decisione |
|---|---|---|
| Analisi finanziaria e strutturata | Finance Agent v2: 61.4% | Candidato solido per un progetto pilota controllato |
| Comprensione di video lunghi o grafici | LVBench: 87.8%; CharXiv-R: 86.2% | Candidato solido quando i modelli solo testuali non sono adatti |
| Flussi di lavoro biologici e scientifici | LABBench2: 86.2%; BioMysteryBench human-difficult: 56.5% | Da testare con revisione di esperti |
| Documenti lunghi e PDF | Limite di input pari a 1,048,576 token; input PDF supportato | Utile per recupero e sintesi, con successiva verifica del richiamo delle informazioni |
La scheda del modello di Google elenca ancora allucinazioni, timeout e occasionali rallentamenti tra i limiti del sistema. (Scheda del modello Gemini 3.8 Flash)
Gemini 3.7 Flash resta adatto al traffico semplice
Una pipeline per classificazione, estrazione, tagging o brevi riepiloghi potrebbe non aver bisogno di un ragionamento aggiuntivo. Artificial Analysis ha misurato per Gemini 3.8 Flash un costo di $0.24 per attività e 0.8 minuti con ragionamento basso, contro $0.58 e 2.5 minuti con ragionamento alto. Per Gemini 3.7 Flash, i valori con ragionamento alto erano $0.40 per attività e 2.2 minuti.
Usa la versione 3.8 quando il ragionamento aggiuntivo evita un’attività fallita; mantieni la 3.7 quando l’output extra aggiunge soltanto costi.
Non è ancora corretto definirlo il vincitore assoluto per gli agenti di coding
BenchmarkList registra l’89.4% su Terminal-Bench 2.1 e il 73.7% su DeepSWE 1.1, ma soltanto il 19.1% su Terminal-Bench 4.0. Riporta inoltre il 59.0% su OSWorld 2.0, una valutazione per l’uso del computer su orizzonti temporali lunghi. (Risultati di coding e agentici su BenchmarkList)
Per un agente da terminale o desktop che deve ricostruire lo stato nascosto, verificare le modifiche e proseguire dopo i fallimenti degli strumenti, confronta Gemini 3.8 Flash con il modello attuale sullo stesso flusso di lavoro prima di effettuare il passaggio.
Il costo va calcolato per attività, non per milione di token
Prezzi dell’API Gemini 3.8 Flash fino al 2026
Il post ufficiale di lancio di Google indica le seguenti tariffe dirette per l’API. Il prezzo introduttivo termina il 31 dicembre 2026, mentre la tariffa standard entra in vigore il 1° gennaio 2027. (Annuncio di lancio di Google)
| Periodo | Prezzo input | Prezzo output | Interpretazione pratica |
|---|---|---|---|
| Fino al 31 dicembre 2026 | $0.75 / 1M token | $3.75 / 1M token | Tariffa introduttiva |
| Dal 1° gennaio 2027 | $1.50 / 1M token | $7.50 / 1M token | Entrambe le tariffe raddoppiano |
Con la tariffa introduttiva, l’output costa cinque volte più dell’input. La documentazione di Google elenca anche Batch API, Flex inference e Priority inference, ma la pagina del modello citata non riporta i relativi prezzi numerici.
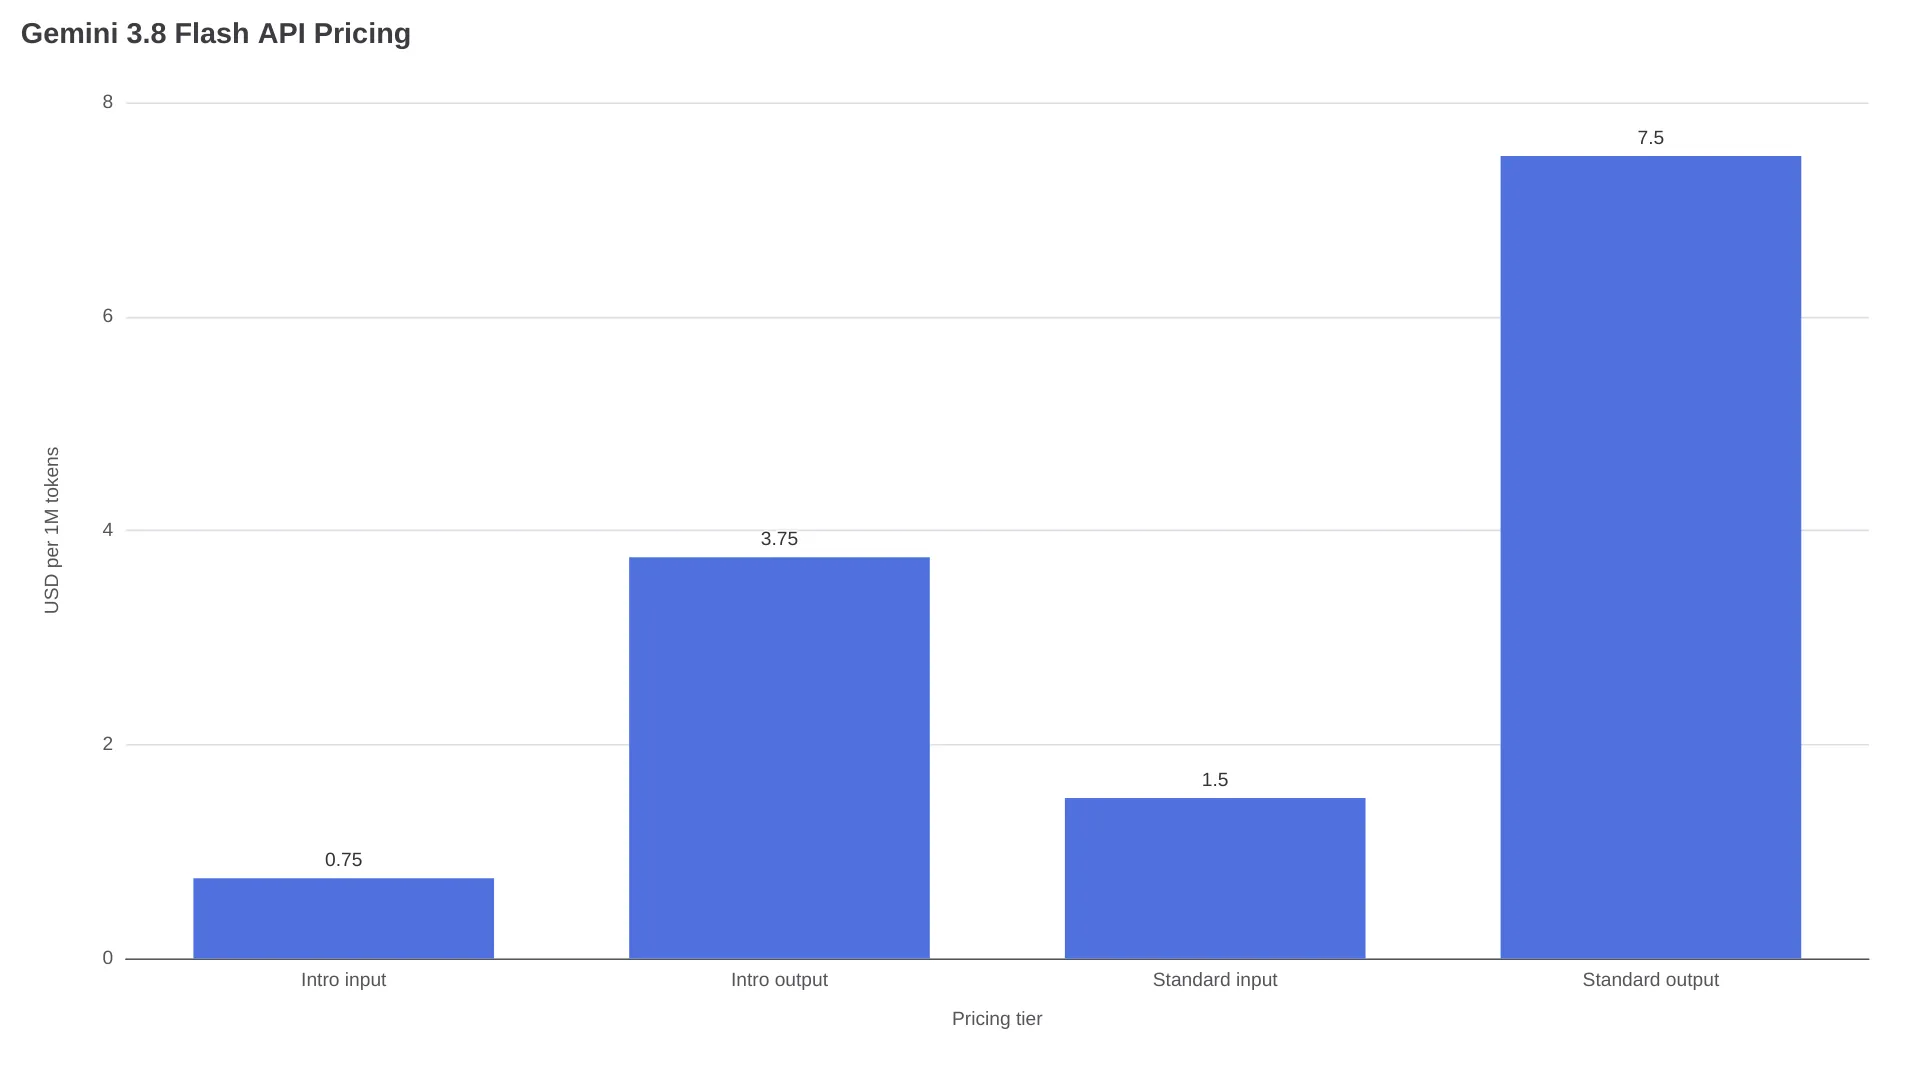
Un’attività che utilizza 2 milioni di token in input e 500.000 token in output costa $3.38 con la tariffa introduttiva: (2 × $0.75) + (0.5 × $3.75). Lo stesso mix costa $6.75 dal 1° gennaio 2027: (2 × $1.50) + (0.5 × $7.50).
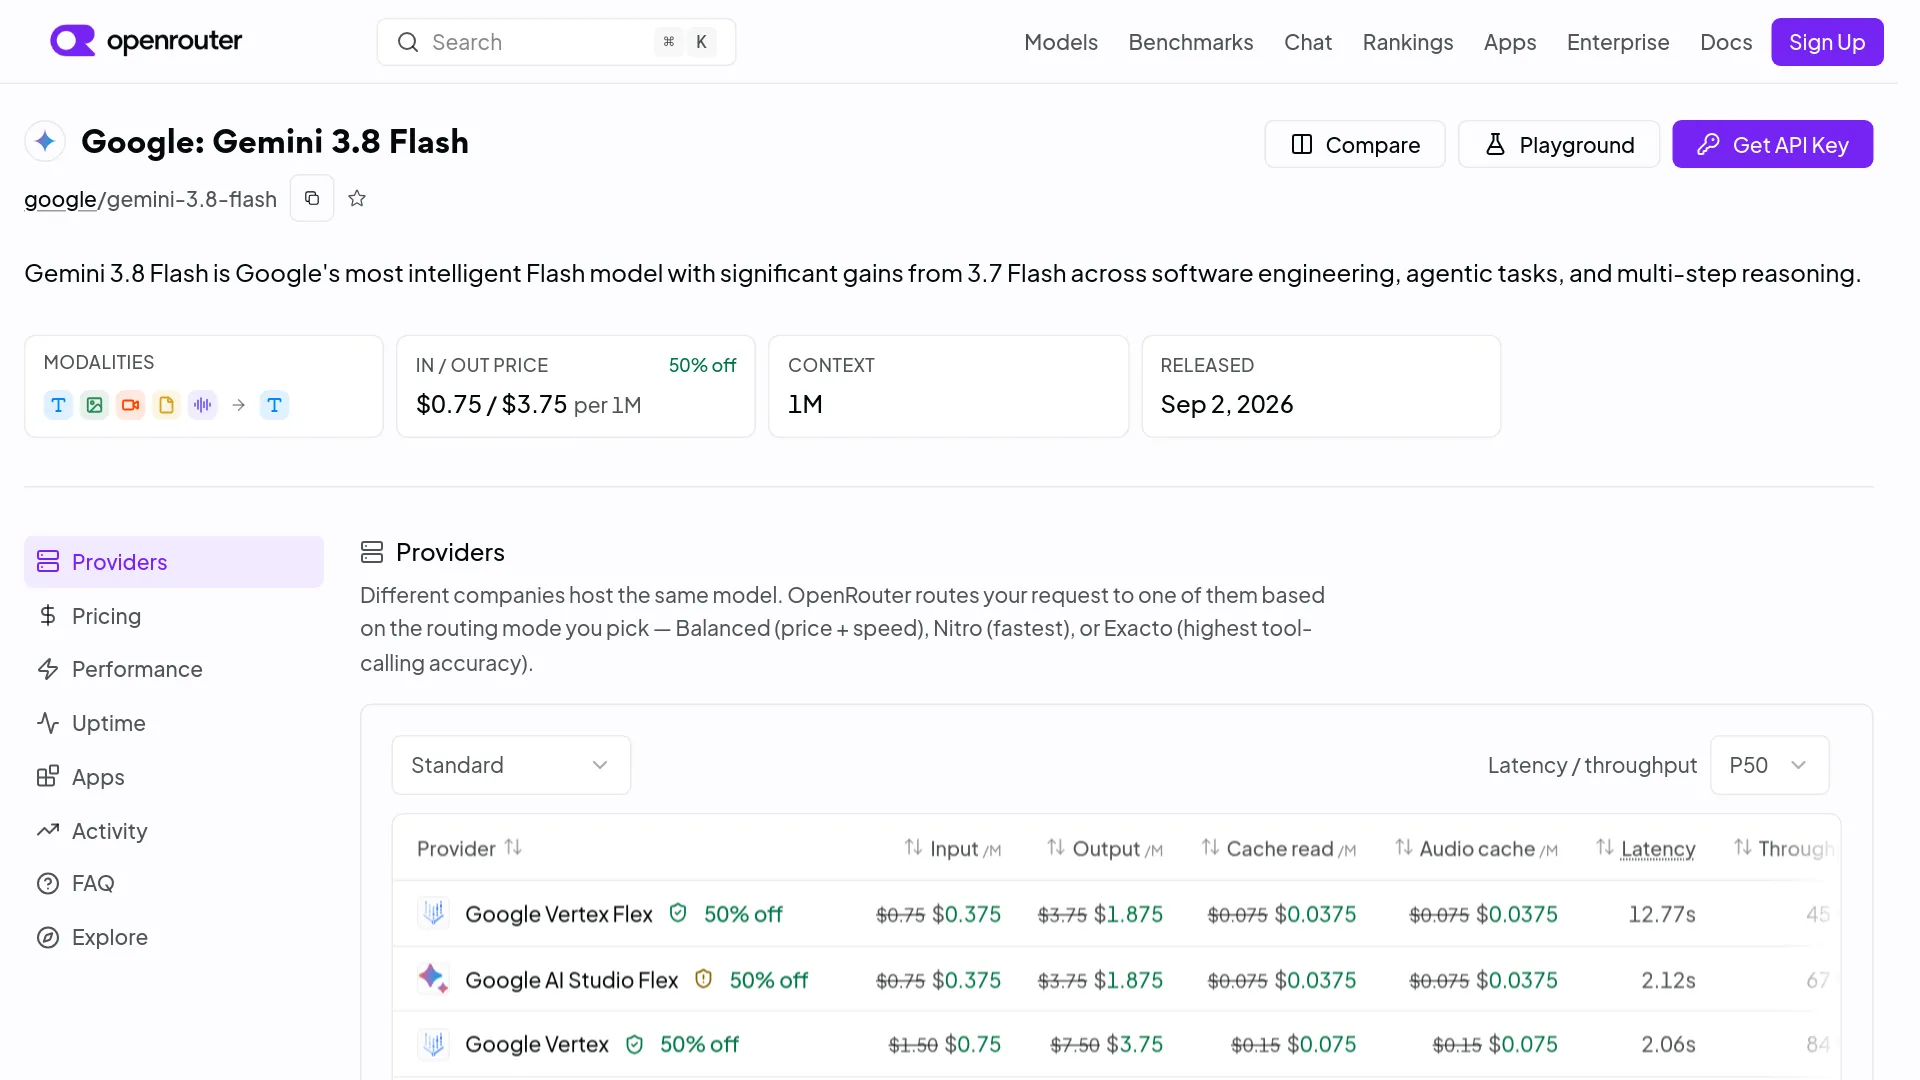
La pagina OpenRouter di Gemini 3.8 Flash riporta separatamente i percorsi Google Vertex e Google AI Studio, i prezzi della cache, la latenza, il throughput e uno sconto visualizzato. Prima di confrontare il prezzo di un router con il listino diretto di Google, verifica il provider e il percorso di fatturazione.
Perché un token più economico può tradursi in una fattura più alta
Artificial Analysis riporta le seguenti misurazioni di Gemini 3.8 Flash in base al livello di ragionamento:
| Livello di ragionamento | Intelligence Index | Costo per attività | Tempo per attività |
|---|---|---|---|
| Basso | 52 | $0.24 | 0.8 minuti |
| Medio | 57 | $0.41 | Non indicato |
| Alto | 59 | $0.58 | 2.5 minuti |
Nell’analisi citata, Artificial Analysis non indica il tempo associato al ragionamento medio. La stessa analisi afferma che Gemini 3.8 Flash ha generato 120 milioni di token in output durante la valutazione Intelligence Index, contro una mediana di 71 milioni di token per i modelli comparabili. Si tratta di una misurazione sull’intera valutazione, non di una previsione per ogni richiesta API. Il dato mostra comunque perché il prezzo dei token, preso da solo, è un indicatore debole per definire il budget di produzione. (Profilo del modello su Artificial Analysis)
Per un confronto interno, calcola il totale dei token in input, dei token in cache, dei token di ragionamento e dei token in output per ogni attività completata. Poi dividi la spesa API per le attività riuscite, non per il numero di richieste inviate. Includi anche chiamate agli strumenti, tentativi ripetuti e correzioni umane.
Limiti e capacità dell’API
Cosa supporta l’API stabile
La pagina ufficiale del modello indica un limite massimo di input pari a 1,048,576 token e un limite massimo di output pari a 65,536 token. Gemini 3.8 Flash accetta input testuali, immagini, video, audio e PDF e restituisce testo. Supporta caching, esecuzione del codice, file search, function calling, Google Maps grounding, search grounding, output strutturati, URL context e computer use in Preview. (Documentazione ufficiale del modello)
I livelli di ragionamento disponibili sono low, medium e high; minimal non è supportato e restituisce un errore. Il modello non offre la generazione nativa di immagini o audio e la documentazione per gli sviluppatori non indica il supporto per Live API.
Dove puoi usarlo e perché Cyber è un prodotto diverso
Google elenca Gemini 3.8 Flash in Gemini API, Google AI Studio, Android Studio, Stitch, Google Antigravity, Gemini Enterprise, nell’app Gemini, in AI Mode nella Ricerca Google e in Gemini in Google Sheets. (Annuncio di lancio di Google)
Gemini 3.8 Flash Cyber è una variante separata dedicata alla cybersicurezza. Google afferma che l’accesso a Fairwind viene dato in via prioritaria a difensori considerati affidabili, tra cui autorità governative, operatori di infrastrutture critiche e manutentori di software. Il post di lancio riporta un tasso di successo superiore al 70% in un benchmark interno per la scoperta di vulnerabilità su 20 linguaggi di programmazione e un risultato pass@1 del 47.2% nel patching valutato da CWE-Bench; questi dati riguardano Cyber, non il modello generale. L’annuncio di Google descrive l’accesso tramite Fairwind: non bisogna quindi presumere che il normale percorso dell’API Flash dia accesso a Cyber. (Annuncio di Google su Cyber)
La disponibilità iniziale di un prodotto può variare in base all’account e alla piattaforma. Un utente di Reddit ha riferito:
“3.8 Flash is showing up for me in the Gemini web app now too, so it looks like it’s officially live. I’m in Australia on a Pro subscription, but it hasn’t appeared in AntiGravity or the iOS app yet.” — u/DMAC80, r/GeminiAI
Per un’applicazione, verifica l’ID del modello API configurato, gemini-3.8-flash, e tutti i metadati della risposta disponibili per la tua integrazione: l’autodescrizione di un modello non equivale alla verifica dell’endpoint.
Cosa non dimostrano ancora i dati disponibili
| Limite documentato | Implicazione pratica |
|---|---|
| Artificial Analysis riporta 13.39 secondi prima del primo token di risposta con ragionamento alto, nonostante una velocità successiva di circa 304.6 token in output al secondo. (Profilo del modello su Artificial Analysis) | È prevedibile un’attesa iniziale per il ragionamento, seguita da una generazione rapida. |
| La scheda del modello DeepMind indica un knowledge cutoff a marzo 2026, con alcuni ambiti limitati a gennaio 2025. (Scheda del modello Gemini 3.8 Flash) | Per informazioni aggiornate, usa search grounding o un sistema di retrieval verificato. |
| Il computer use è disponibile soltanto in Preview, la documentazione per gli sviluppatori non indica un’opzione di self-hosting e l’output è testuale, non basato su immagini, audio o video. (Documentazione per gli sviluppatori Google) | Per questi requisiti, prevedi un deployment o un fallback a un modello separato. |
Un rollout a basso rischio per il traffico di produzione
- Seleziona 30–50 attività reali che rappresentino il mix di produzione, includendo i casi con contesto lungo e i fallimenti già noti.
- Esegui Gemini 3.8 Flash ai livelli di ragionamento basso, medio e alto insieme al modello attuale.
- Registra il totale dei token, i cache hit, i passaggi con gli strumenti, i tentativi ripetuti, il tempo al primo token, il tempo di completamento, le correzioni umane e il tasso di attività accettate.
- Calcola il costo per attività riuscita e separa il traffico interattivo da quello batch.
- Invia una piccola quota di richieste di produzione al nuovo modello prima di modificare il percorso predefinito.
- Mantieni Gemini 3.7 Flash per le attività semplici se il ragionamento aggiuntivo non migliora il costo per attività accettata.
- Metti a budget la tariffa dal 1° gennaio 2027: $1.50 per l’input e $7.50 per l’output ogni milione di token.
Il primo test utile dovrebbe avere un risultato verificabile: una modifica su più file con relativi test, un flusso documentale con risposta nota oppure un’attività di estrazione multimodale con etichette revisionate.
FAQ sui prezzi dell’API Gemini 3.8 Flash
Quanto costa Gemini 3.8 Flash?
La tariffa introduttiva diretta di Google per l’API è di $0.75 per milione di token in input e $3.75 per milione di token in output fino al 31 dicembre 2026. Dal 1° gennaio 2027, le tariffe indicate diventano rispettivamente $1.50 e $7.50.
Gemini 3.8 Flash è migliore di Gemini 3.7 Flash?
È più forte in diverse misurazioni di ragionamento e capacità agentiche riportate al momento del lancio, tra cui il risultato 59 contro 56 nell’Intelligence Index di Artificial Analysis con ragionamento alto. Gemini 3.7 Flash può comunque costare meno per il traffico semplice, perché la versione 3.8 potrebbe utilizzare più token in output.
Gemini 3.8 Flash è adatto agli agenti di coding?
È un candidato credibile, con risultati riportati dell’89.4% su Terminal-Bench 2.1 e del 73.7% su DeepSWE 1.1. Il 19.1% ottenuto su Terminal-Bench 4.0 indica però che i flussi di lavoro da terminale e desktop su orizzonti lunghi richiedono una valutazione dedicata.
Gemini 3.8 Flash è gratuito?
L’API è a pagamento secondo le tariffe indicate per i token. Verifica separatamente le condizioni attuali del progetto AI Studio e il listino diretto dell’API.
Che cos’è Gemini 3.8 Flash Cyber e chi può accedervi?
Gemini 3.8 Flash Cyber è ottimizzato per la scoperta di vulnerabilità e il patching automatizzato. Google afferma che l’accesso viene assegnato in via prioritaria tramite il Fairwind Program a difensori considerati affidabili; non è un modello pubblico generalista disponibile con una normale chiave API di Gemini 3.8 Flash.
Inizia con un ragionamento basso o medio su un set fisso di attività, misura il costo per risultato accettato e aumenta il livello di impegno soltanto nei casi in cui il lavoro aggiuntivo eviti un errore misurabile.