 AIREITER
Après trois semaines de « coming soon », les poids de Qwen3.8-2.4T-A95B sont apparus sur ModelScope le 12 août 2026. Le modèle affiche 2 400 milliards de paramètres au total, mais n’en active que 95 milliards par token. Reste un obstacle de taille : même quantifié en 4 bits, il occupe environ 1,2 To de VRAM. En dehors d’un datacenter, rares sont ceux qui pourront réellement l’exécuter en local. Voici ce que contient cette sortie, ce qu’elle coûte et dans quels cas l’API s’impose comme la seule option raisonnable.
Les poids de Qwen3.8-2.4T-A95B sont disponibles
Les poids sont bien en ligne. L’équipe Qwen d’Alibaba a publié le checkpoint de Qwen3.8-2.4T-A95B via son compte communautaire ModelScope tard dans la journée du 12 août. C’est le premier modèle de la gamme Qwen-Max à bénéficier d’une sortie open weight. Les trois précédents, Qwen3.5-Max, Qwen3.6-Max et Qwen3.7-Max, étaient restés exclusivement accessibles par API.
Il faut d’emblée distinguer deux produits portant le nom « Qwen3.8 » :
| Nom | De quoi s’agit-il ? | Où l’obtenir |
|---|---|---|
| Qwen3.8-2.4T-A95B | Modèle de base open weight | ModelScope (checkpoint téléchargeable) |
| Qwen3.8-Max | Version hébergée dans le cloud, avec des capacités additionnelles pour la production | Alibaba Token Plan, Qoder, QoderWork |
Qwen3.8-Max repose sur le modèle open weight A95B, mais y ajoute des améliorations post-entraînement. Alibaba décrit un système en trois étapes associant montée en échelle dans des environnements réels, signaux de récompense unifiés et équilibrage des données en ligne. Les poids ouverts donnent accès au modèle de base, pas à l’intégralité de la pile de production Max.
Les guides affirmant que les poids étaient « promis mais indisponibles » ne sont donc plus à jour : la sortie est arrivée dans la fenêtre prévue par Alibaba, la « semaine du 10 août ».
Caractéristiques confirmées : 95B actifs et 256K de contexte natif
Depuis l’aperçu lancé le 19 juillet, le nombre de paramètres actifs était la spécification la plus demandée et la plus absente. Plusieurs guides tiers l’indiquaient explicitement comme « non publiée ». C’est désormais confirmé : 95 milliards de paramètres actifs par token, sur un total de 2 400 milliards.
| Spécification | Valeur confirmée |
|---|---|
| Paramètres totaux | 2.4T |
| Paramètres actifs par token | 95B |
| Architecture | MoE (dans la continuité du design hybride de Qwen3.5) |
| Experts par couche MoE | 512 |
| Experts routés par token | 10 |
| Experts partagés par token | 1 |
| Fenêtre de contexte native | 262,144 tokens (256K) |
| Contexte extensible | 1,010,000 tokens (1.01M) |
| Méthode d’entraînement | Multi-Token Prediction (MTP) |
| Première sortie open weight Qwen-Max | Oui (12 août 2026) |
Deux points méritent d’être soulignés. D’abord, la fenêtre de contexte native est de 256K, et non d’un million de tokens comme beaucoup le supposaient. Le chiffre de 1,01M désigne un mode extensible dont Alibaba n’a pas encore documenté les compromis en matière de qualité. Ensuite, le routage MoE est extrêmement parcimonieux : seuls 11 experts sur 512 sont mobilisés pour chaque token, soit 10 experts routés et 1 expert partagé. Ce taux d’activation d’environ 4 % des paramètres (95B sur 2.4T) rend économiquement possible un tarif de 2 $/M de tokens en entrée, malgré l’empreinte totale de 2.4T.
L’entraînement MTP (Multi-Token Prediction) permet aux moteurs d’inférence compatibles de prédire plusieurs tokens à chaque passage avant, avec à la clé un débit potentiellement supérieur. Alibaba n’a toutefois pas précisé quels moteurs le prennent en charge.
Auto-hébergement : le vrai coût d’un modèle de 2.4T paramètres
Les caractéristiques sont impressionnantes, jusqu’au moment où il faut charger le modèle. Les chiffres parlent d’eux-mêmes.
Avec une quantification 4 bits, 2 400 milliards de paramètres nécessitent environ 1,2 To de stockage, avant même le cache KV, la mémoire des activations et les surcoûts d’exécution. Un GPU NVIDIA H200 embarque 141 Go de mémoire. Huit H200 totalisent 1 128 Go : ce n’est pas suffisant pour contenir les poids tout en servant simultanément une fenêtre de contexte exploitable.
| Scénario de déploiement | VRAM nécessaire (est.) | Matériel | Réaliste ? |
|---|---|---|---|
| Pleine précision (16 bits) | ~4.8 TB | 34+ GPU H200 | Datacenter uniquement |
| Quantification 4 bits | ~1.2 TB | 9+ GPU H200 | Datacenter uniquement |
| Quantification 1.5 bit | ~450 GB | 4+ GPU H200 | Très contraint ; perte de qualité incertaine |
| Qwen3.8-27B (alternative) | ~27 GB en 4 bits | 1 GPU grand public | Oui |
Les 95B de paramètres actifs favorisent bien le débit d’inférence par token : à chaque passage avant, le modèle ne route qu’une fraction de ses experts. Mais ce nombre ne réduit pas la mémoire requise pour stocker les 512 réseaux d’experts. Comme le résume GEO Toolbox : « L’activation parcimonieuse rend le modèle peu coûteux à exploiter à grande échelle, pas peu coûteux à posséder. »
Pour un déploiement local ou sur un seul serveur, la variante Qwen3.8-27B est l’option réaliste. Elle partage la lignée d’entraînement de Qwen3.8, tout en tenant sur un unique GPU grand public en 4 bits. Le modèle 2.4T vise la recherche et les datacenters.
Pourquoi l’API est souvent le choix le plus rationnel
L’auto-hébergement d’un modèle MoE de 2.4T étant hors de portée de presque toutes les équipes, l’API constitue le principal moyen d’y accéder concrètement. Model Studio d’Alibaba facture Qwen3.8 Max 2 $ par million de tokens en entrée et 6 $ par million de tokens en sortie. C’est moins cher que son prédécesseur comme que son concurrent chinois le plus proche.
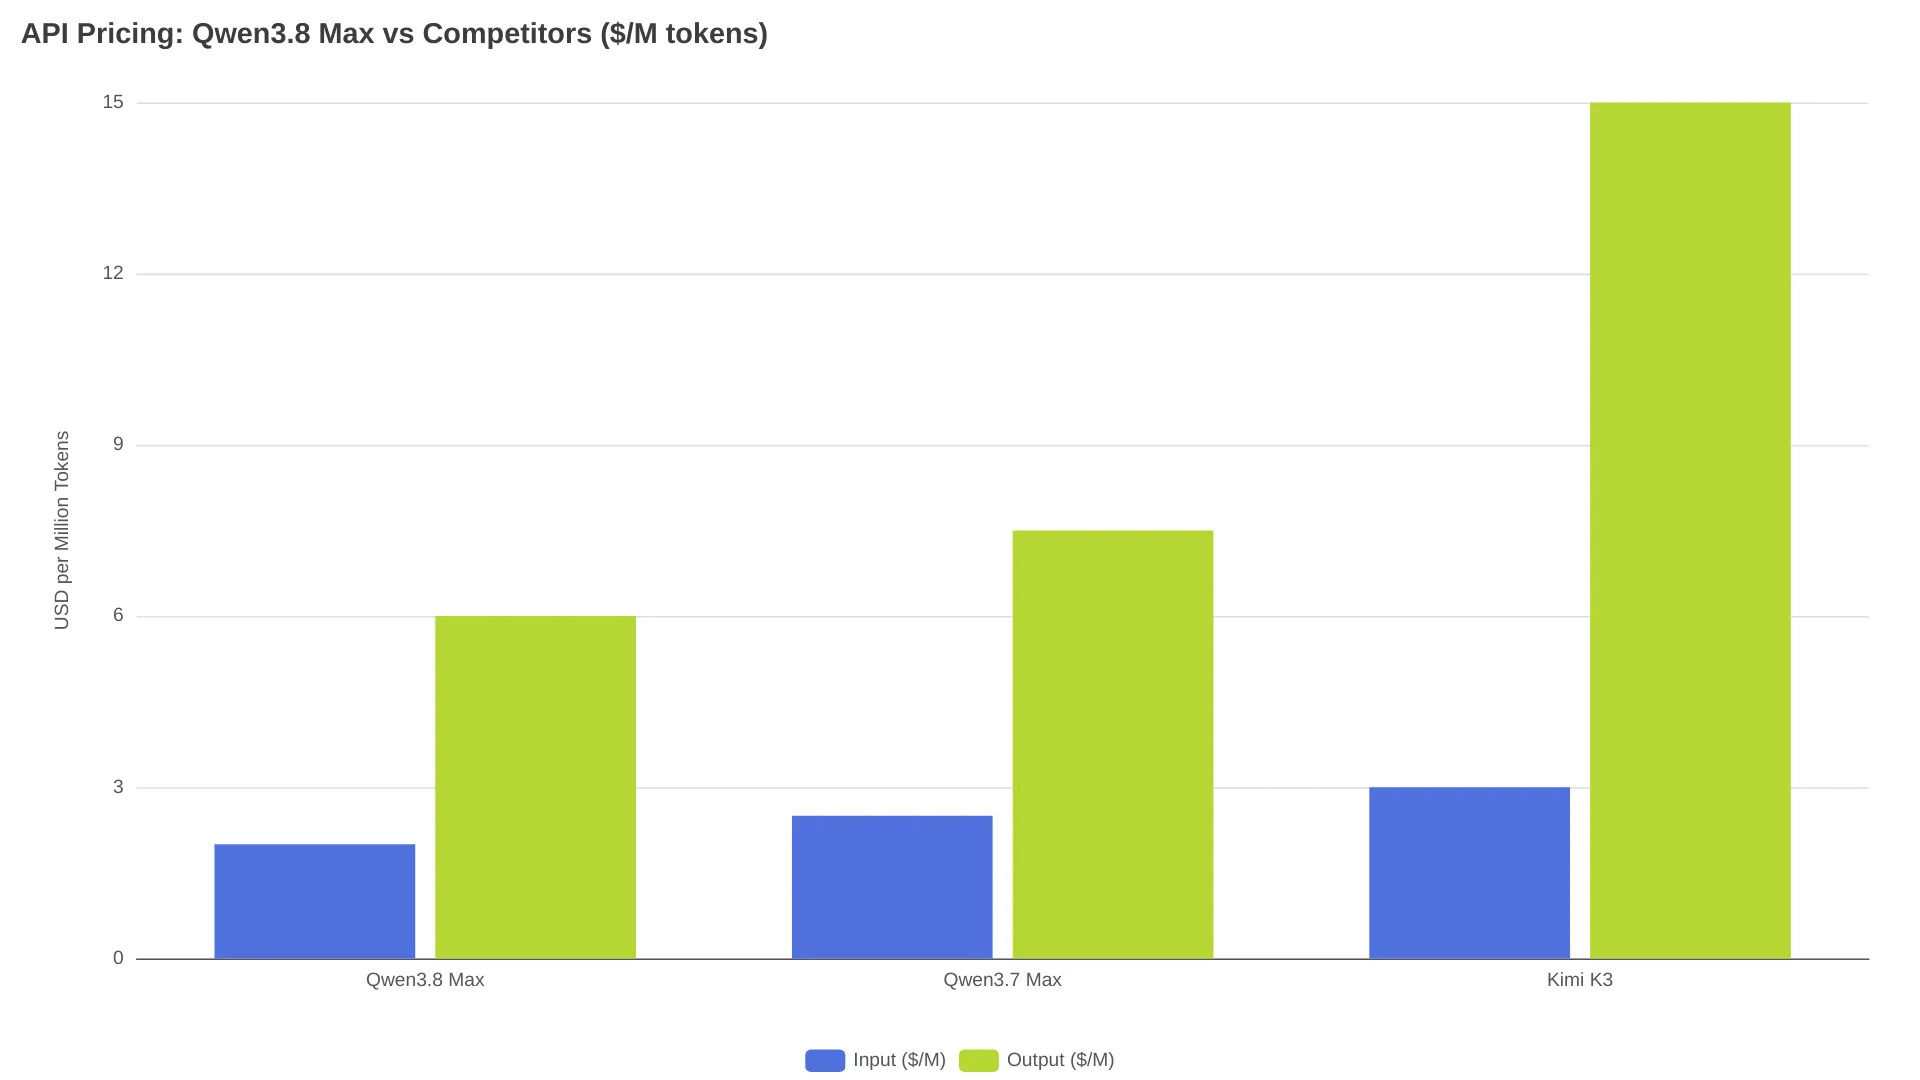
| Modèle | Entrée ($/M) | Sortie ($/M) | Contexte |
|---|---|---|---|
| Qwen3.8 Max | $2.00 | $6.00 | 256K natif (1.01M extensible) |
| Qwen3.7 Max | $2.50 | $7.50 | 1M |
| Kimi K3 | $3.00 | $15.00 | 1M |
Au-delà de la facturation à l’usage, Alibaba propose trois formules d’abonnement :
- Lite : $6/mois (~10,000 crédits)
- Standard : $18/mois (~40,000 crédits)
- Pro : $68/mois (~160,000 crédits)
L’endpoint Token Plan accepte les formats d’API compatibles avec OpenAI et Anthropic. Des outils tels que Claude Code, Cursor et OpenCode fonctionnent donc sans modification côté client. Qoder, le produit de programmation d’Alibaba, propose des tarifs promotionnels en crédits pouvant descendre jusqu’à 0.01x le tarif standard pendant les heures creuses (14:00-00:00 UTC). Il s’agit toutefois de réductions de lancement, pas de tarifs pérennes.
Le modèle par abonnement a un revers : le mode de raisonnement de Qwen3.8 Max est bavard, et les retours de la communauté sur l’épuisement des quotas vont dans le même sens :
« Qwen a tendance à beaucoup trop réfléchir. » - u/darko, r/Qwen_AI
Dans le même fil Reddit, un abonné Lite indique avoir épuisé son quota hebdomadaire en moins de deux jours, pour environ 50 millions de tokens. Un utilisateur de l’offre Pro décrit une consommation de 500 millions de tokens en une journée, avec sept agents exécutés en parallèle et un taux de cache hit de 94 %. Le paramètre reasoning_effort, configurable sur low, medium ou xhigh, contrôle directement le volume de raisonnement produit par le modèle, et donc la vitesse à laquelle les crédits disparaissent. Lors du test d’un utilisateur, le réglage low a ramené le temps de réflexion à environ 10 secondes par requête.
Pour une analyse détaillée des coûts, consultez notre guide des tarifs API de Qwen3.8 Max.
Benchmarks : les forces et les limites de Qwen3.8 Max
Alibaba a publié des résultats comparant Qwen3.8 Max à Fable 5 et GPT-5.6 Sol. Le bilan est contrasté, et l’écart entre les scores annoncés par le fournisseur et les mesures indépendantes est suffisamment important pour être pris en compte.
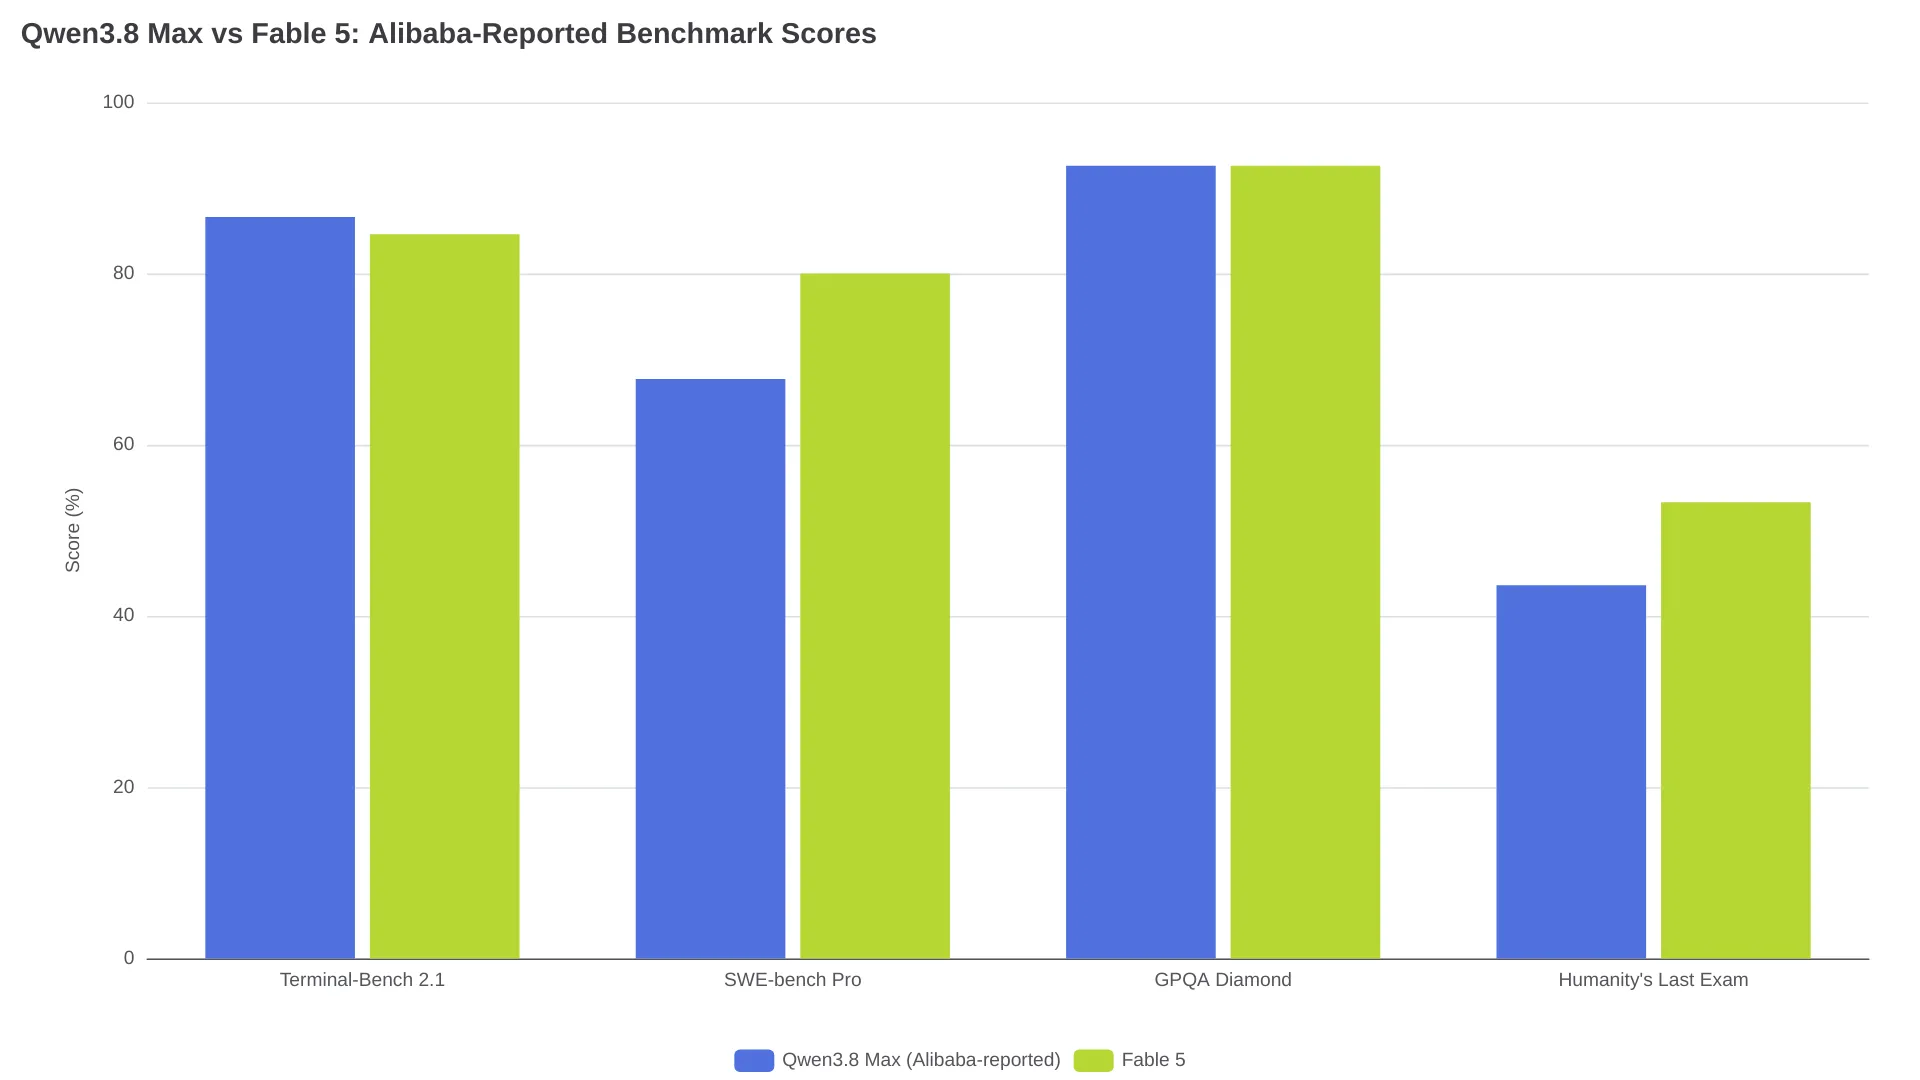
| Benchmark | Qwen3.8 Max (Alibaba) | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench 2.1 | 86.6 | 84.6 | Supérieur à Qwen (score exact non publié) |
| SWE-bench Pro | 67.7 | 80.0 | 64.6 |
| GPQA Diamond | 92.6 | 92.6 | Supérieur à Qwen |
| Humanity's Last Exam | 43.6 | 53.3 | Non publié |
Les tests indépendants racontent une autre histoire. Artificial Analysis a mesuré Qwen3.8 Max à 81.3 % sur Terminal-Bench 2.1, soit 5.3 points de moins que les 86.6 % annoncés par Alibaba. À ce niveau, Qwen se situe approximativement à la dixième place au classement général, derrière Fable 5 (84.6 %) et Kimi K3 (85.0 %).
Qwen3.8 Max conserve néanmoins un avantage sur certains points : son score de 67.7 % à SWE-bench Pro dépasse les 64.6 % de GPT-5.6 Sol, tandis que ses résultats multimodaux sont solides (MathVision 95.2 contre 92.7 pour Fable 5, LogicVista 91.9 contre 85.7). Le modèle progresse aussi fortement par rapport à Qwen3.7 Max sur DeepSWE 1.1 (21.6 -> 56.6), ce qui suggère de réels gains pour les tâches d’agents en ingénierie logicielle.
Les avis de la communauté reflètent ce contraste. Dans le même fil Reddit où certains reprochaient son excès de réflexion, on trouve aussi ce commentaire :
« Le résultat était exceptionnel, vraiment. » - u/TangerineLogical9779, r/Qwen_AI
La vitesse semble instable, oscillant entre 8 tokens/s et 60 tokens/s selon la charge et l’heure de la journée. Pour un comparatif direct avec Kimi K3, consultez notre comparatif Qwen3.8 Max vs Kimi K3.
FAQ
Les poids de Qwen3.8-Max sont-ils téléchargeables ?
Oui. Alibaba a publié le checkpoint Qwen3.8-2.4T-A95B sur ModelScope le 12 août 2026. C’est le premier modèle de la gamme Qwen-Max à proposer des poids ouverts. La version cloud Qwen3.8-Max ajoute des capacités de production au-dessus de ce modèle de base.
Quelle licence s’applique aux poids ouverts ?
La licence exacte n’était pas confirmée au moment de la rédaction. Les précédents laissent penser à Apache 2.0, puisque Qwen3.6 était distribué sous cette licence, mais Qwen3.7 Max est resté fermé. Avant tout projet commercial, lisez la licence effective dans le dépôt ModelScope.
Quelle est la différence entre Qwen3.8-2.4T-A95B et Qwen3.8-Max ?
Qwen3.8-2.4T-A95B est le modèle de base open weight : 2.4T paramètres, 95B actifs, architecture MoE et contexte natif de 256K. Qwen3.8-Max est la version cloud d’Alibaba, construite sur ce modèle et enrichie par un post-entraînement en environnement de production, avec notamment des systèmes de récompense unifiés et un équilibrage des données en ligne. Les poids ouverts donnent accès à la base ; l’API donne accès à la version améliorée.
Puis-je faire tourner Qwen3.8-Max en local ?
Pas dans des conditions réalistes. En quantification 4 bits, le modèle demande environ 1,2 To de VRAM, soit neuf H200 ou plus pour les seuls poids, sans marge pour le cache de contexte. Même une quantification à 1.5 bit nécessite encore plusieurs centaines de gigaoctets. La variante Qwen3.8-27B, qui tient sur un GPU grand public, est l’alternative locale réaliste.
Combien coûte l’API Qwen3.8 Max ?
L’API Model Studio coûte 2 $ par million de tokens en entrée et 6 $ par million de tokens en sortie. Les abonnements commencent à 6 $/mois avec Lite et atteignent 68 $/mois avec Pro. Qoder propose des réductions promotionnelles sur les crédits allant jusqu’à 98 % pendant les heures creuses, mais ces tarifs de lancement peuvent évoluer.