 AIREITER
Avec son contexte d’un million de tokens et son endpoint à 0 $, l’API Nemotron 3 Ultra semble être un choix évident. En pratique, l’accès gratuit sert surtout à l’évaluation. Pour la production, il faut tenir compte de la fiabilité du fournisseur, du traitement des données et de la disponibilité d’une solution de secours.
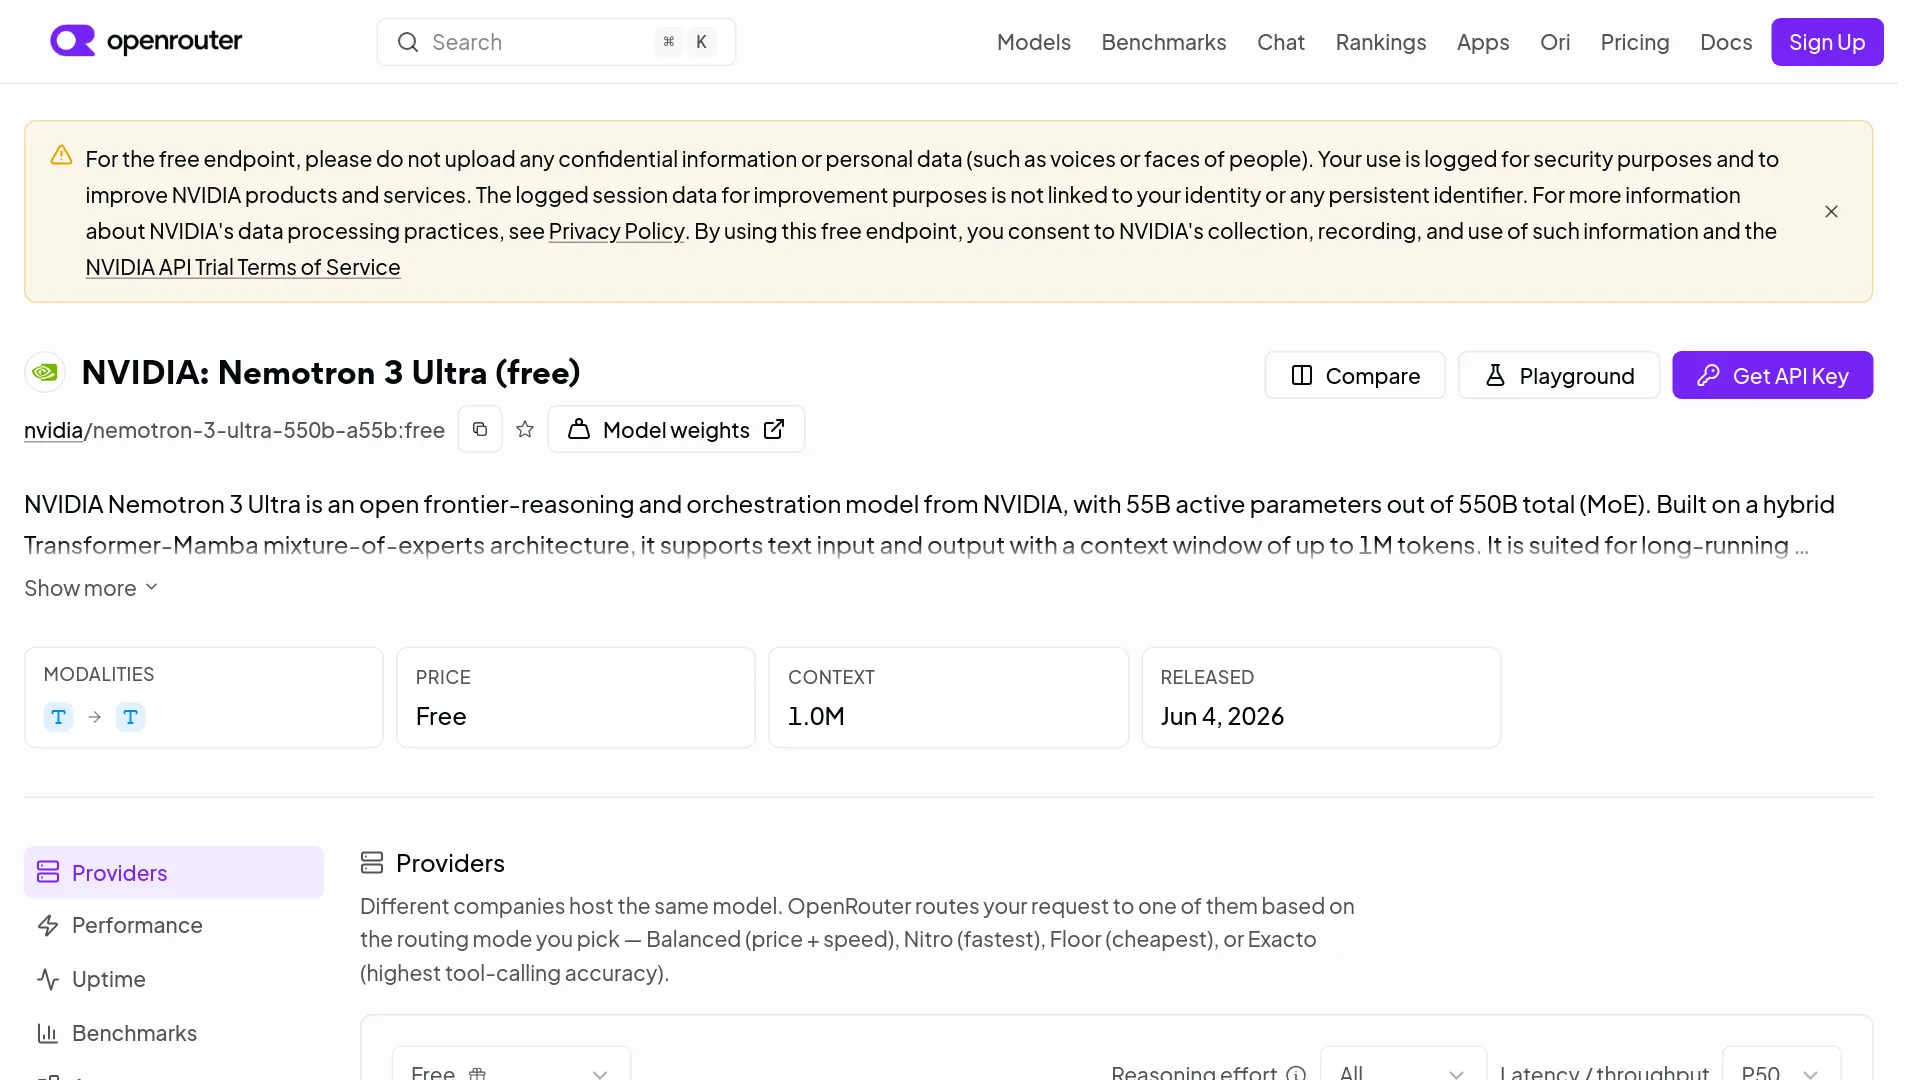
L’API Nemotron 3 Ultra vaut-elle le détour ?
L’API Nemotron 3 Ultra mérite d’être testée pour les agents textuels exécutant des tâches longues, l’analyse de documents volumineux et les workflows de programmation qui tirent parti d’un contexte très étendu. En revanche, ce n’est pas le meilleur choix par défaut pour les conversations courantes à faible latence, les prompts confidentiels envoyés à un endpoint gratuit journalisé ou un service de production sans solution de repli.
NVIDIA a lancé Nemotron 3 Ultra le 4 juin 2026. La fiche officielle du modèle identifie le checkpoint NVFP4 comme la version 1.0 GA, utilisable à des fins commerciales et non commerciales sous licence OpenMDW 1.1.
| Élément déterminant | Valeur vérifiée | Pourquoi c’est important |
|---|---|---|
| Taille du modèle | 550B au total, 55B actifs | Le calcul parcimonieux ne réduit pas la taille de l’ensemble des poids |
| Contexte maximal | Jusqu’à 1M de tokens | Les limites peuvent être inférieures selon le fournisseur |
| Modalité | Entrées et sorties texte | Pas de compréhension des images ou des vidéos |
| SWE-Bench Verified officiel en NVFP4 | 69.7 | Un indicateur pertinent pour évaluer les agents de programmation |
| RULER 1M officiel en NVFP4 | 94.0 | Confirme l’intérêt du modèle pour les contextes très longs |
| Tarif gratuit OpenRouter | $0 en entrée, $0 en sortie | Adapté aux essais, pas à un SLA |
| Disponibilité gratuite OpenRouter observée | 84.07 % de succès sur trois jours | Le service était accessible, mais pas toujours exploitable |
| Configuration minimale officielle en auto-hébergement | 4x B200 ou 8x H100 | Ce n’est pas un déploiement prévu pour une station de travail classique |
Les résultats de benchmark ci-dessus proviennent de la fiche officielle de NVIDIA et doivent être considérés comme des mesures fournies par le constructeur. La disponibilité observée sur OpenRouter est une mesure dynamique du fournisseur, pas une garantie permanente.
Appeler gratuitement l’API Nemotron 3 Ultra en cinq minutes
La méthode gratuite la plus rapide consiste à utiliser l’endpoint de chat compatible avec l’API OpenAI proposé par OpenRouter, avec l’identifiant exact nvidia/nemotron-3-ultra-550b-a55b:free. Créez une clé OpenRouter, stockez-la dans une variable d’environnement et envoyez d’abord un petit test avant de lancer une tâche exploitant un long contexte.
- Créez une clé API dans OpenRouter.
- Exportez-la sous le nom
OPENROUTER_API_KEY. - Appelez
/api/v1/chat/completionsavec l’identifiant du modèle gratuit. - Lors de l’évaluation, journalisez le statut HTTP, la latence et les réponses vides.
- Ajoutez une route payante ou un autre modèle avant de passer en production.
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nvidia/nemotron-3-ultra-550b-a55b:free",
    "messages": [
      {
        "role": "user",
        "content": "Return three risks in this migration plan as a numbered list."
      }
    ],
    "max_tokens": 500
  }'
La même route fonctionne avec le client Python OpenAI : il suffit de modifier base_url et model :
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENROUTER_API_KEY"],
    base_url="https://openrouter.ai/api/v1",
)

response = client.chat.completions.create(
    model="nvidia/nemotron-3-ultra-550b-a55b:free",
    messages=[
        {
            "role": "user",
            "content": "Inspect this plan and list the three highest-impact risks.",
        }
    ],
    max_tokens=500,
)

print(response.choices[0].message.content)
Ce que garantit réellement l’accès gratuit
La route gratuite de Nemotron 3 Ultra ne garantit ni une capacité illimitée ni une disponibilité adaptée à la production. La fiche OpenRouter indique que les endpoints gratuits sont soumis à des limites de débit, sans publier de quota précis sur la page du modèle. Son relevé du 19 septembre affichait 100 % d’accessibilité, mais seulement 84.07 % de disponibilité réussie sur trois jours ; les erreurs et les réponses vides étaient comptabilisées comme des échecs.
Dans ce relevé, OpenRouter affichait un contexte de 1M de tokens, une complétion maximale de 65 536 tokens, l’appel d’outils, une latence médiane de 2,28 secondes et un débit médian de 29 tokens par seconde.
Il existe également une limite liée aux fonctionnalités du fournisseur : l’offre gratuite d’OpenRouter prenait en charge tools et tool_choice, mais n’imposait pas response_format. La route payante de Segmind documente la sortie JSON Schema à $0.625 par million de tokens en entrée et $2.75 par million de tokens en sortie. Si votre code dépend d’un JSON strict, testez le fournisseur choisi au lieu de déduire cette compatibilité du modèle de base.
N’envoyez pas de données confidentielles ou personnelles via la route gratuite d’OpenRouter. Sa fiche précise que l’utilisation est journalisée à des fins de sécurité et peut servir à améliorer les produits et services de NVIDIA. En cas de 429, de dépassement de délai ou de réponse vide, appliquez un backoff exponentiel borné, puis basculez vers une route payante. Ne relancez pas indéfiniment une action d’agent.
Ce que change concrètement le format 550B A55B
La désignation 550B-A55B signifie que Nemotron 3 Ultra contient 550 milliards de paramètres au total, dont environ 55 milliards sont activés pour chaque token. NVIDIA combine le routage LatentMoE, Mamba-2, certaines couches d’attention et la prédiction multi-token. L’activation parcimonieuse réduit le calcul par token, mais l’ensemble des poids doit toujours être stocké, distribué ou déporté. A55B ne transforme donc pas le modèle en déploiement 55B.
La publication de recherche de NVIDIA annonce jusqu’à 1M de tokens de contexte et compare le débit sur une charge inhabituelle composée de 8 000 tokens en entrée et de 64 000 tokens en sortie. NVIDIA revendique un débit 5,9 fois supérieur à celui de GLM-5.1-754B-A40B, 4,8 fois supérieur à celui de Kimi-K2.6-1T-A32B et 1,6 fois supérieur à celui de Qwen-3.5-397B-17B. La page ne fournit ni débit absolu ni détails sur le matériel : ces multiplicateurs ne doivent donc pas être transformés en prévisions de latence API.
Le tableau officiel BF16/NVFP4 est plus utile pour réfléchir au déploiement :
| Benchmark | BF16 | NVFP4 | Lecture pratique |
|---|---|---|---|
| SWE-Bench Verified | 71.9 | 69.7 | La quantification coûte 2,2 points sur ce test de programmation |
| Terminal Bench 2.1 | 56.4 | 53.9 | Les tâches agentiques dans un terminal régressent également |
| Moyenne TauBench V3 | 70.9 | 70.3 | La moyenne sur l’utilisation d’outils reste proche |
| GPQA, sans outils | 87.0 | 87.9 | Le NVFP4 n’est pas systématiquement moins performant |
| RULER 1M | 94.7 | 94.0 | La recherche dans les longs contextes reste proche |
| OmniScience, absence d’hallucinations | 78.7 | 75.5 | Les contrôles de factualité restent indispensables |
L’impact dépend de la tâche : le NVFP4 perd 3,2 points sur l’absence d’hallucinations, mais en gagne 0,9 sur GPQA.
Choisissez selon la tâche, pas selon le nombre de paramètres
Nemotron 3 Ultra doit être comparé à DeepSeek V4, GLM 5.2 et Qwen 3.8 Max sur la charge de travail qui sera réellement mise en production, et non sur la taille des modèles. Aucun résultat obtenu avec un même banc de test pour ce guide ne permet de désigner un vainqueur universel. La comparaison la plus solide passe donc par un plan de test et des limites vérifiées.
| Tâche | Commencez par | Éléments à vérifier avant de choisir |
|---|---|---|
| Recherche dans un million de tokens ou synthèse de documents | Nemotron 3 Ultra | Le RULER 1M officiel en NVFP4 atteint 94.0 ; testez la précision de recherche et la latence de préremplissage avec la longueur réelle des prompts |
| Agent de programmation exécutant des tâches longues | Nemotron 3 Ultra ou DeepSeek V4 | Nemotron obtient 69.7 sur SWE-Bench Verified et 53.9 sur Terminal Bench 2.1 ; comparez la réussite des tâches sur dépôt et la validité des appels d’outils avec un même banc de test |
| Automatisation avec sorties structurées | GLM 5.2, Qwen 3.8 Max ou un fournisseur Nemotron prenant en charge les schémas | L’offre gratuite d’OpenRouter n’impose pas response_format ; mesurez le respect du schéma et le nombre de relances sur la route exacte |
| Requêtes courtes à fort volume | DeepSeek V4, GLM 5.2 ou Qwen 3.8 Max | Comparez le coût par tâche réussie et la latence p95 ; la taille d’Ultra n’est pas automatiquement un avantage |
| Déploiement open-weight sur matériel NVIDIA | Nemotron 3 Ultra | Comparez BF16 et NVFP4 sur la tâche cible, puis calculez l’utilisation soutenue |
DeepSeek V4 et GLM 5.2 disposent de surfaces API dédiées sur AIReiter, tandis que Qwen 3.8 Max est disponible comme modèle de chat hébergé : guide de l’API DeepSeek V4 Pro, analyse de l’API GLM 5.2 et tarifs de l’API Qwen 3.8 Max. Il s’agit d’alternatives à évaluer, pas d’une affirmation selon laquelle un modèle serait meilleur pour toutes les tâches.
Peut-on exécuter Nemotron 3 Ultra en local ?
Nemotron 3 Ultra peut être auto-hébergé, mais « en local » signifie ici du matériel de centre de données ou une DGX Station, pas un ordinateur portable. NVIDIA indique comme configurations minimales 4x GB200, 4x B200, 4x GB300, 4x B300 ou 8x H100 pour le déploiement standard.
Les exemples officiels vLLM de la fiche NVIDIA utilisent le parallélisme tensoriel et expert en 4 voies, un cache KV en FP8, le préremplissage par blocs et le décodage spéculatif MTP. Un exemple standard utilise par défaut 262 144 tokens ; l’activation de 1 048 576 tokens nécessite une surcharge explicite. Le contexte annoncé n’est donc pas la configuration de service par défaut.
NVIDIA documente également un déploiement sur une DGX Station unique. Il exécute le checkpoint NVFP4 sur un seul GPU GB300 intégré, en rendant disponibles jusqu’à 150 Gio de mémoire CPU cohérente et en déportant les poids des experts. Cette recette nécessite vLLM 0.22.0, le backend NVFP4 spécifique à Blackwell et l’architecture mémoire de la DGX Station ; elle ne s’applique pas à un PC ordinaire équipé d’un seul GPU.
| Déploiement | À choisir quand | Contrainte principale |
|---|---|---|
| API gratuite OpenRouter | Vous évaluez les prompts et le comportement des outils | Limites de débit, journalisation et disponibilité variable |
| API hébergée payante | Vous devez lancer le service avant que le volume justifie du matériel | Différences de tarifs, de précision, de contexte et de fonctionnalités selon le fournisseur |
| Auto-hébergement sur 4x B200 ou 8x H100 | Le volume soutenu, le contrôle des données ou la personnalisation du modèle sont prioritaires | Coût d’investissement et exploitation de l’inférence distribuée |
| DGX Station GB300 unique avec déport | Vous possédez précisément ce système à mémoire cohérente | Latence du déport et dépendance à ce matériel particulier |
FAQ sur l’API Nemotron 3 Ultra
L’API Nemotron 3 Ultra est-elle gratuite ?
Oui. OpenRouter affiche nvidia/nemotron-3-ultra-550b-a55b:free à $0 pour les tokens d’entrée et de sortie, mais l’endpoint est soumis à des limites de débit et journalisé.
Nemotron 3 Ultra prend-il vraiment en charge un million de tokens ?
NVIDIA indique un maximum de 1M de tokens, mais les routes des fournisseurs peuvent exposer des valeurs par défaut inférieures. L’exemple vLLM de NVIDIA utilise par défaut 262 144 tokens, sauf si l’opérateur active 1 048 576 tokens.
L’API prend-elle en charge les outils et le JSON structuré ?
Le modèle prend en charge les outils, mais l’application dépend du fournisseur : l’offre gratuite d’OpenRouter ne force pas response_format, tandis que Segmind documente le JSON Schema strict.
Puis-je utiliser Nemotron 3 Ultra à des fins commerciales ?
NVIDIA indique que la version publiée sous OpenMDW 1.1 autorise les usages commerciaux et non commerciaux. Consultez les conditions de licence accessibles depuis la fiche officielle du modèle pour connaître les obligations liées à la redistribution et au déploiement.
Peut-on désactiver le raisonnement ?
La documentation API de NVIDIA expose enable_thinking=True/False. Les fournisseurs hébergés peuvent gérer ce contrôle différemment : vérifiez donc le paramètre accepté et le décompte des tokens sur la route choisie.
550B A55B équivaut-il à un modèle dense de 55B ?
Non. Environ 55B paramètres sont actifs pour chaque token, mais les 550B paramètres doivent toujours être stockés, distribués ou déportés.
Une décision de déploiement, pas un trophée de benchmark
Le meilleur point de départ consiste à utiliser gratuitement l’API Nemotron 3 Ultra avec des prompts non sensibles et un petit jeu d’évaluation. Passez à un endpoint payant lorsque les erreurs, l’application des schémas ou la capacité prévisible deviennent importantes. Ne vous tournez vers l’auto-hébergement que si l’utilisation mesurée, la confidentialité ou la personnalisation justifient au moins quatre GPU actuels à grande capacité mémoire ou le chemin de déploiement documenté pour la DGX Station.
| Résultat après vos tests | Action suivante |
|---|---|
| La qualité est bonne, mais les appels gratuits échouent ou restent en attente | Ajoutez une route Nemotron payante et une politique de relance |
| La recherche dans les longs contextes fait la différence | Testez le document réel le plus volumineux et mesurez le temps de préremplissage |
| Les erreurs JSON sont majoritaires | Utilisez un fournisseur qui impose les schémas ou comparez les routes GLM/Qwen |
| Le coût ou la latence des tâches courtes domine | Préférez un modèle plus petit et réservez Ultra aux cas nécessitant une escalade |
| Les données ne peuvent pas quitter votre réseau | Budgétez le déploiement officiel multi-GPU avant de vous engager |