 AIREITER
Toutes les portes d’entrée de GLM-5.2 acceptent des requêtes au format OpenAI. Pourtant, derrière cette façade, leurs comportements divergent fortement. Depuis son lancement du 16 juin, l’API GLM-5.2 mérite l’attention pour les usages de code et d’agents sensibles aux coûts — à condition de gérer vous-même trois sources de panne : la sémantique des appels d’outils, les tempêtes de tentatives et la comptabilité du cache. Le tarif catalogue de 1,40 $/4,40 $ par million de tokens est bien réel ; le coût effectif d’une tâche terminée l’est beaucoup moins. C’est cet écart que ce test examine.
Compatibilité OpenAI : ce qui est réellement pris en charge
La documentation officielle de GLM-5.2 valide l’usage du SDK Python OpenAI avec l’URL de base https://api.z.ai/api/paas/v4/ et l’identifiant glm-5.2. Pour une intégration de chat basique, le changement tient donc réellement en trois lignes. Cette compatibilité porte toutefois sur la forme de la requête, pas sur la sémantique des réponses, les champs de contrôle optionnels d’OpenAI ni la surface plus récente de l’API Responses.
| Contrat documenté | Valeur |
|---|---|
| Modalité | Texte en entrée, texte en sortie (sans vision) |
| Fenêtre de contexte | 1M tokens |
| Sortie maximale | 128K tokens |
| Fonctionnalités documentées | Mode réflexion, streaming, appel de fonction, cache de contexte, sortie structurée, MCP |
| Endpoint facturé à l’usage | https://api.z.ai/api/paas/v4/ |
| Endpoint Coding Plan | https://api.z.ai/api/coding/paas/v4 |
| Endpoint compatible Anthropic | https://api.z.ai/api/anthropic |
| SDK officiels | zai-sdk (Python), Java, SDK OpenAI |
Première limite : Z.ai ne propose aucune API Responses. « Codex only supports the Responses API format, which isn't available at Z.ai », note u/quinncom ; d’autres passent par ZenMux comme couche de traduction. Deuxième limite : Claude Code fonctionne via l’endpoint compatible Anthropic, mais les notes de configuration de @armor_rust signalent deux pièges. Il faut utiliser AUTH_TOKEN, et non API_KEY : ce dernier déclenche une confirmation de confiance qui peut ensuite refuser définitivement après un seul rejet. Il faut aussi tenir compte des URL de base distinctes entre abonnement et paiement à l’usage. Le guide complet est disponible dans notre guide de configuration Claude Code.
Comme le résume un développeur : « api compatibility stops at request shape; tool calling still needs provider-specific evals » — @sebuzdugan.
Appels d’outils : corrects en test, fragiles dans les longues boucles
Sur des boucles d’outils courtes et contrôlées, l’API GLM-5.2 tient ses promesses. Dans les boucles d’agents prolongées, des utilisateurs intensifs rapportent en revanche des séquences d’appels corrompues qui tournent en rond jusqu’à ce que vos propres limites les arrêtent. Ces deux constats ne se contredisent pas : le risque dépend entièrement du type de boucle que vous construisez.
D’après la documentation Z.ai, testée par la suite Docker de 27 requêtes de GLM52.ai, le contrat prévoit jusqu’à 128 définitions de fonctions, des noms limités à 64 caractères respectant ^[a-zA-Z0-9_-]+$, des paramètres JSON Schema, ainsi que des arguments renvoyés sous forme de chaîne JSON que l’application doit valider. Seul tool_choice: "auto" est documenté. Cette suite a validé 27 requêtes sur 27 via la route Coding Plan : 4/4 correspondances exactes entre outil et arguments, 3/3 refus corrects sans outil, 4/4 commandes doubles dans deux appels de premier niveau, pour une latence médiane de 5,3 secondes.
Le problème se situe dans les champs que les utilisateurs d’OpenAI supposent disponibles. Lors de tests contradictoires envoyés par GLM52.ai, l’endpoint a renvoyé HTTP 200 avant d’ignorer les instructions :
| Contrôle au format OpenAI envoyé | Comportement observé |
|---|---|
tool_choice: "required" + « n’utilisez aucun outil » | Arrêt, zéro appel |
| Objet de fonction forcée + « n’utilisez jamais cet outil » | Arrêt, zéro appel |
parallel_tool_calls: false + prompt à deux commandes | Deux appels renvoyés malgré tout |
strict: true | Accepté une fois ; aucune preuve d’application du schéma |
Accepter une requête en HTTP ne vaut pas contrat de comportement. Et c’est dans les longues boucles que les coutures craquent.
Un développeur ayant fait passer environ quatre milliards de tokens dans le modèle l’exprime sans détour : « biggest issue with GLM 5.2 4bil tokens in was the lack of vision, some tool call confusion, tool call corruption death (it just spirals) » — @RasputinKaiser. Un signalement isolé, resté sans réponse, évoque aussi un second appel d’outil encodé par le modèle dans les arguments du premier. Un seul cas, certes, mais précisément le type de défaillance contre lequel une boucle côté client doit se protéger.
En pratique, la défense la plus robuste consiste à ne pas confier l’orchestration au modèle. Un développeur utilise NVIDIA NIM avec tool_call: false et laisse l’intégralité de la boucle à son framework d’agents. La boucle de référence bornée limite le modèle à quatre étapes, autorise au plus quatre appels par tour et valide chaque JSON d’arguments avant exécution.
Streaming et latence : les chiffres peu mis en avant
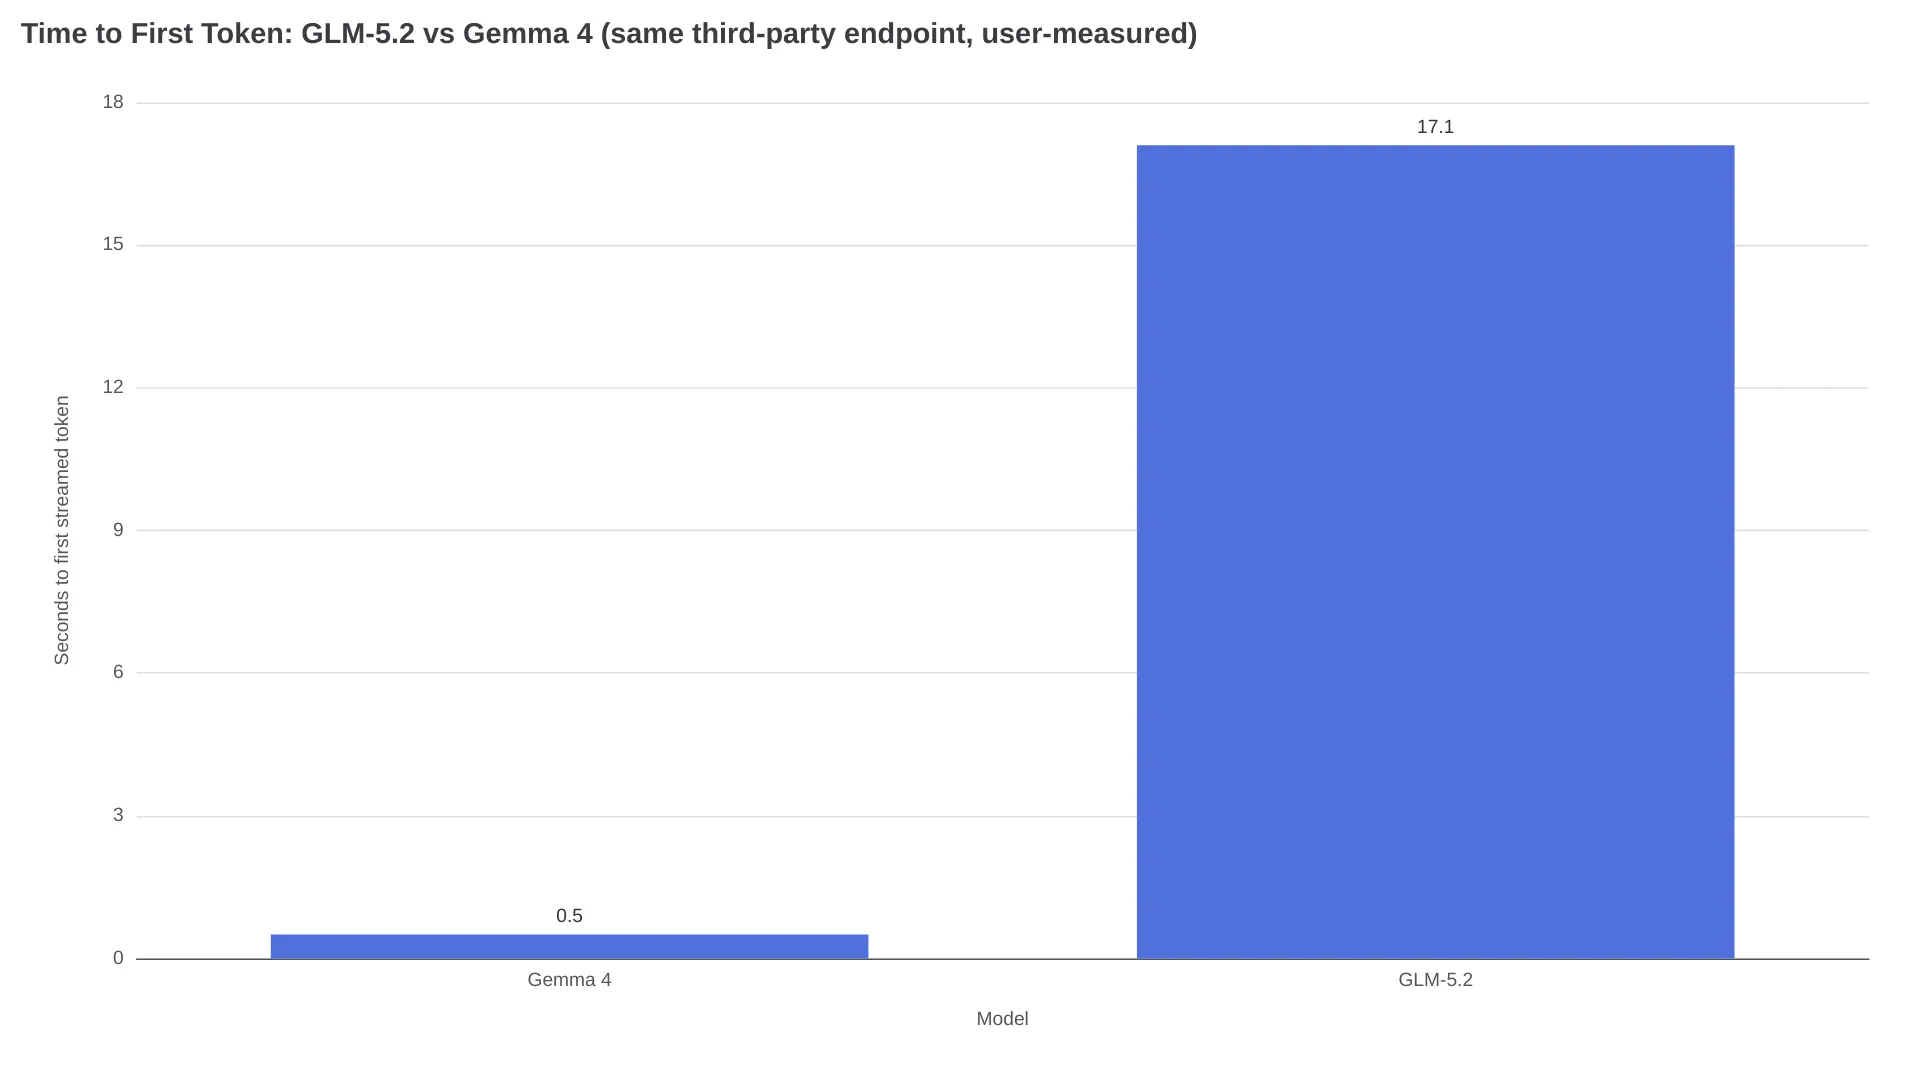
La latence jusqu’au premier token est le point mesuré le plus faible de l’API. Lors d’un test comparatif d’endpoints sur Sarvam, GLM-5.2 a atteint 148 tokens par seconde en streaming face aux 260 de Gemma 4, avec 17,1 secondes jusqu’au premier token contre 0,5 seconde : « starts generating 33x sooner », souligne @noctus91.
Le débit annoncé pose le même problème :
« All these GLM 5.2 providers advertise 200+ tok/s. Yet you try them and get 50 tok/s » — @tomgreenwald, qui parle de « benchmaxxing but for providers ».
Deux autres formes de panne sont rapportées sur les routes d’abonnement : des flux qui s’interrompent en pleine session — « the streaming just...stopped », après quoi un utilisateur du GLM Pro Coding Plan a complètement abandonné — et une dégradation avec l’échelle : « when you reach 300k+ context the model getting slow » (@mosh_Ontong). À titre de comparaison, le benchmark exécuté de neuf tâches de DataLLM Lab sur sa propre passerelle a affiché une moyenne de 12,3 secondes par tâche terminée. Dans votre récit de latence, l’endpoint pèse plus que le modèle.
Limites de débit et 429 : les retries font partie du fonctionnement
La documentation des modèles Z.ai ne publie aucun tableau de limites de débit : les développeurs découvrent donc les leurs empiriquement, au gré des 429. Sur les routes Coding Plan, les retours de la communauté décrivent les tentatives de reprise comme un fonctionnement normal, pas comme un cas d’exception. Ces discussions identifient des modes de panne plutôt que des taux de prévalence, mais les constats reviennent régulièrement.
Extraits d’une discussion sur les limites de débit dans r/ZaiGLM :
- « Right now hitting 429/529 on coding max plan nearly for every second request. No concurrency... » — u/A-B-user
- « Yes, almost every request is retried, but the results are very good » — u/hyeluoh
- « It works fine (super slow but no errors) if I use single concurrency for glm52 » — u/evia89
Les erreurs dépendent aussi du client : une même clé API fonctionne dans ZCode tout en produisant des 429 dans OpenClaw, qu’un autre utilisateur résume à un message « too busy ». Les couches d’abonnement compliquent encore le tableau : des utilisateurs chinois signalent que le Coding Plan bascule automatiquement les charges GLM-5.2 vers GLM-5.3, qui consomme le quota plus vite, tandis que des revendeurs tiers de Coding Plan limitent le débit après seulement quelques appels.
Les réponses d’ingénierie qui tiennent la route : backoff exponentiel avec jitter, clés d’idempotence pour toute opération d’écriture, budget de retry par tâche plutôt que par requête, et un mode dégradé en concurrence=1 activable automatiquement. Les schémas de reprise de notre guide de correction des 429 OpenRouter s’appliquent ici sans modification.
La question de la facturation du cache, toujours sans réponse
Le cache de contexte est documenté. Lors de notre consultation des pages des fournisseurs le 13 juillet, le token d’entrée mis en cache était affiché autour de 0,26 $ par million de tokens, contre 1,40 $ pour une entrée fraîche. Le grief non résolu — celui qui a généré le plus d’engagement parmi les plaintes API des discussions examinées — est que, sur certaines routes, le contexte répété serait facturé comme une entrée fraîche. De quoi multiplier le coût de chaque boucle d’agent qui renvoie un long prompt système.
« cached tokens are not working properly on GLM 5.2. The repeated context is being counted as normal input instead of cached tokens. » — @Da7_Tech, qui décrit « a serious billing/cache accounting problem ».
Dans cette discussion, une même tâche terminée par Claude Opus 4.8 avec moins de 1,5M tokens est restée inachevée sur GLM-5.2 après 53M tokens, le quota de cinq heures ayant atteint 100 %, tandis que le compteur de l’application affichait environ 1,67M.
Deux mois plus tard, le même développeur résumait encore la situation ainsi : « plenty of users complain that cache hits appear to count against usage. If that happens to you, the value of the plan collapses. » Aucune réponse officielle n’était apparue dans ces discussions jusqu’à la fin août.
Tant que cette correction n’est pas confirmée, considérez le tarif des entrées en cache comme un scénario optimiste à vérifier sur vos propres factures : enregistrez cached_tokens depuis l’objet d’usage de chaque réponse et faites le rapprochement chaque semaine.
Effort de raisonnement : un réglage, trois appellations
L’interface officielle propose thinking.type (enabled/disabled), ainsi que reasoning_effort avec les valeurs high et max. Les propres exemples de la documentation utilisent reasoning_effort: "max". Les recommandations de lancement de Z.ai indiquaient que max privilégie les capacités, high équilibre performances et efficacité en tokens, et recommandaient max pour le code.
Deux conséquences pratiques en découlent. D’abord, les routes de code utilisent max par défaut : « It defaults to max so you don't need to unless you want to scale it down » (r/ZaiGLM). Les tokens de raisonnement sont facturés au tarif des tokens de sortie, ce qui multiplie silencieusement les dépenses. Sur les Coding Plans, les utilisateurs ayant documenté la comptabilité de l’offre indiquent que les appels en effort max consomment 3x plus de quota pendant le créneau de 14:00 à 18:00, heure de Pékin, en semaine, en plus d’une fenêtre de cinq heures et des crédits hebdomadaires.
Ensuite, ce réglage n’atteint pas toujours le backend : les utilisateurs d’OpenCode indiquent que « currently it does not let you tweak reasoning effort » pour les fournisseurs personnalisés. Certains clients exposent aussi ce même paramètre sous un troisième nom, xhigh, sans nécessairement le transmettre (r/opencodeCLI). La verbosité est liée au même réglage : un développeur effectuant des comparaisons quotidiennes a noté qu’un modèle concurrent était « not as verbose as Opus-4.8 or GLM-5.2 ».
Même identifiant, déploiements différents : la dérive des endpoints
glm-5.2 est un identifiant unique qui peut pointer vers des déploiements sensiblement différents. Lorsque des résultats de précision par endpoint ont circulé début août, le responsable de Z.ai a demandé à la communauté « to test the official GLM-5.2 API as an additional reference point. It may score above 100% » — @ZixuanLi_. Son point de référence était l’API officielle, et non les endpoints tiers mesurés dans le rapport.
Concrètement, cette dérive se manifeste par des plafonds de tokens de sortie assez bas pour tronquer le raisonnement en plein flux, un débit observé au lancement qui s’érode ensuite — le schéma de « benchmaxxing » évoqué plus haut — et des plafonds de contexte différents selon l’hébergeur. Together AI propose GLM-5.2 avec 256K, tandis que l’API officielle, annoncée à 1M dans la documentation, et les agrégateurs de notre comparaison de juillet offrent la fenêtre complète.
L’écart de prix est encore plus large que l’écart de comportement : face au tarif Z.ai de 1,40 $/4,40 $, OpenRouter affichait 0,42 $/1,32 $ dans notre comparaison de fournisseurs de juillet, avec des tarifs d’entrée en cache allant de 0,14 $ chez Fireworks à 0,26 $. Choisissez l’endpoint en fonction de votre charge de travail, puis testez à nouveau sur cet endpoint précis : une validation de comportement sur une route ne se transfère pas à une autre.
Avant le déploiement : un test de validation de 30 minutes
Tous les modes de panne décrits ci-dessus se détectent en une demi-heure, avant d’engager une charge de production. Exécutez ces tests sur l’endpoint, l’identifiant de modèle et le SDK exacts que vous prévoyez de déployer :
- Testez les conflits du contrat d’outils. Envoyez
tool_choice: "required"avec une instruction interdisant tout outil, puisparallel_tool_calls: falseavec un prompt à deux commandes. Attendez-vous à ce que les deux soient ignorés ; si votre orchestration dépend de l’un d’eux, arrêtez-vous là. - Soumettez les retries à une charge continue. Lancez 50 requêtes à la concurrence prévue et enregistrez le taux de 429/529 ainsi que le ratio de succès après retry. Si les reprises dépassent environ un tiers des requêtes — un seuil opérationnel prudent — réduisez la concurrence à 1 et mesurez de nouveau.
- Vérifiez la comptabilité du cache. Renvoyez cinq fois un préfixe identique de 10K tokens ; additionnez les
cached_tokensdes réponses d’usage et rapprochez le résultat de ce que votre tableau de bord a facturé en entrée. Un écart invalide votre modèle de coût. - Testez la latence à la taille de contexte réelle. Mesurez le délai jusqu’au premier token et les interruptions en milieu de flux avec des tailles de contexte représentatives, pas avec un simple smoke test à 1K tokens : sinon, le ralentissement au-delà de 300K restera invisible.
- Choisissez la bonne route. Le Coding Plan est conçu pour les outils de code interactifs. Les analyses de sa comptabilité indiquent qu’il n’est pas autorisé à servir des sites web, bots ou trafics SaaS ; les backends de produits doivent donc utiliser l’API facturée à l’usage.
Le compromis ne disparaît pas : GLM-5.2 vend certains des tokens de code capables les moins chers du marché, mais le droit d’entrée prend la forme d’une ingénierie d’enrobage que les API frontier intègrent plutôt dans leur coût par token.
FAQ sur l’API GLM-5.2
Puis-je utiliser le SDK OpenAI avec GLM-5.2 ?
Oui, pour les chat completions : pointez base_url vers https://api.z.ai/api/paas/v4/ avec le modèle glm-5.2. Il n’existe pas d’API Responses ; la surface récente d’OpenAI, ainsi que Codex, exige donc une couche de traduction.
L’API GLM-5.2 prend-elle en charge le streaming, les appels de fonctions et les sorties structurées ?
Les trois fonctionnalités sont documentées, aux côtés du cache de contexte et de MCP. Les réserves sont comportementales : la stabilité du streaming varie selon l’endpoint, et les champs de contrôle d’outils OpenAI — tool_choice au-delà de auto, parallel_tool_calls, strict — ne sont pas respectés.
Quel identifiant de modèle et quelle URL de base utiliser ?
Pour la route officielle facturée à l’usage : glm-5.2 à l’adresse https://api.z.ai/api/paas/v4/. Le Coding Plan utilise une autre URL de base, tandis qu’OpenRouter référence le modèle sous z-ai/glm-5.2.
Pourquoi GLM-5.2 est-il lent ou inhabituellement verbeux ?
Les routes de code utilisent par défaut l’effort de raisonnement max, facturé comme des tokens de sortie. Les retours de la communauté situent par ailleurs le débit soutenu autour de 50 tok/s, contre plus de 200 annoncés. La latence et la verbosité relèvent généralement de la configuration et de l’endpoint avant de relever des limites du modèle.
Le GLM Coding Plan peut-il alimenter l’API de mon application ?
Non. Les analyses de comptabilité de l’offre indiquent que l’abonnement est réservé aux outils de code interactifs et exclut le service de sites web, bots ou produits SaaS. Les multiplicateurs de quota durant les heures de pointe à Pékin le rendent de toute façon peu adapté à un trafic régulier.
La fenêtre de contexte de 1M est-elle disponible chez tous les fournisseurs ?
Non. L’API officielle et la plupart des agrégateurs offrent 1M, mais Together AI limite GLM-5.2 à 256K — une différence suffisante pour changer l’architecture des workflows à l’échelle d’un dépôt.
À lire également
- Test de GLM-5.2 : deux mois après l’engouement — qualité du modèle, benchmarks et profils d’usage
- API GLM 5.2 : accès le moins cher, tarifs et clés gratuites — la matrice complète des prix par fournisseur
- GLM-5.2 vs GLM-5.3 — l’impact éventuel du successeur d’août