 AIREITER
Nemotron 3.5 Lightning ne cherche pas à être le meilleur modèle de raisonnement à tout faire. Les propres benchmarks de NVIDIA le placent derrière Qwen 3.6 35B-A3B dans 11 tests sur 12 comparables. En contrepartie, il promet une génération de tokens jusqu'à 4x plus rapide. Son rôle est donc clair : prendre en charge les étapes répétitives d'un pipeline d'agents, là où la vitesse et le coût priment sur le raisonnement de pointe. Ce MoE de 30B n'active que 3B de paramètres par token. Attention toutefois : les poids BF16 en pleine précision demandent un GPU de 80 GB ; pour la production, NVIDIA recommande le checkpoint NVFP4.
Pourquoi Nemotron 3.5 Lightning ne fonctionne pas comme les autres modèles de 30B
Nemotron 3.5 Lightning repose sur une architecture hybride qui alterne des couches d'espace d'états Mamba-2, du routage MoE et des couches d'attention sélectionnées, une combinaison que NVIDIA identifie par nemotron_h. Les couches Mamba-2 limitent la mémoire et les calculs associés à l'attention sur les longs contextes. C'est ce qui permet à Lightning d'annoncer une fenêtre de contexte de 1M de tokens, plafonnée en pratique à 256K sur un seul H100 80GB selon la model card, sans subir le coût quadratique d'un modèle fondé uniquement sur l'attention.
| Caractéristique | Valeur |
|---|---|
| Paramètres totaux | 30B |
| Paramètres actifs par token | 3B |
| Architecture | Hybride Mamba-2 + MoE + Attention |
| Longueur de contexte | Jusqu'à 1M de tokens (256K sur un seul H100) |
| Options de précision | BF16, NVFP4 |
| Licence | OpenMDW v1.1 (utilisation commerciale autorisée) |
| Langues | Anglais, espagnol, français, allemand, italien, japonais + code |
| Corpus de pré-entraînement | 20T+ tokens |
| Mode raisonnement | Activable via enable_thinking dans le template de chat |
| Échantillonnage recommandé | Température 1.0, top-p 0.95 |
NVIDIA présente Lightning comme le plus petit modèle de la famille Nemotron 3, entraîné spécifiquement pour le comportement des harnesses d'agents : appels d'outils, validation des sorties, mise en forme des résultats et délégation à des sous-agents. Un modèle de raisonnement de frontière, tel que Nemotron 3 Ultra, s'occupe de la planification complexe ; Lightning exécute les opérations courantes qui consommeraient autrement le budget de tokens d'un modèle plus coûteux.
Benchmarks : les points forts et les limites de Lightning
La model card HuggingFace publie 14 lignes de benchmarks comparant Lightning à Qwen 3.6 35B-A3B, Gemma 4 26B-A4B, Nemotron 3 Nano/Super et GPT-OSS 20B. Voici les 10 résultats les plus utiles pour faire un choix :
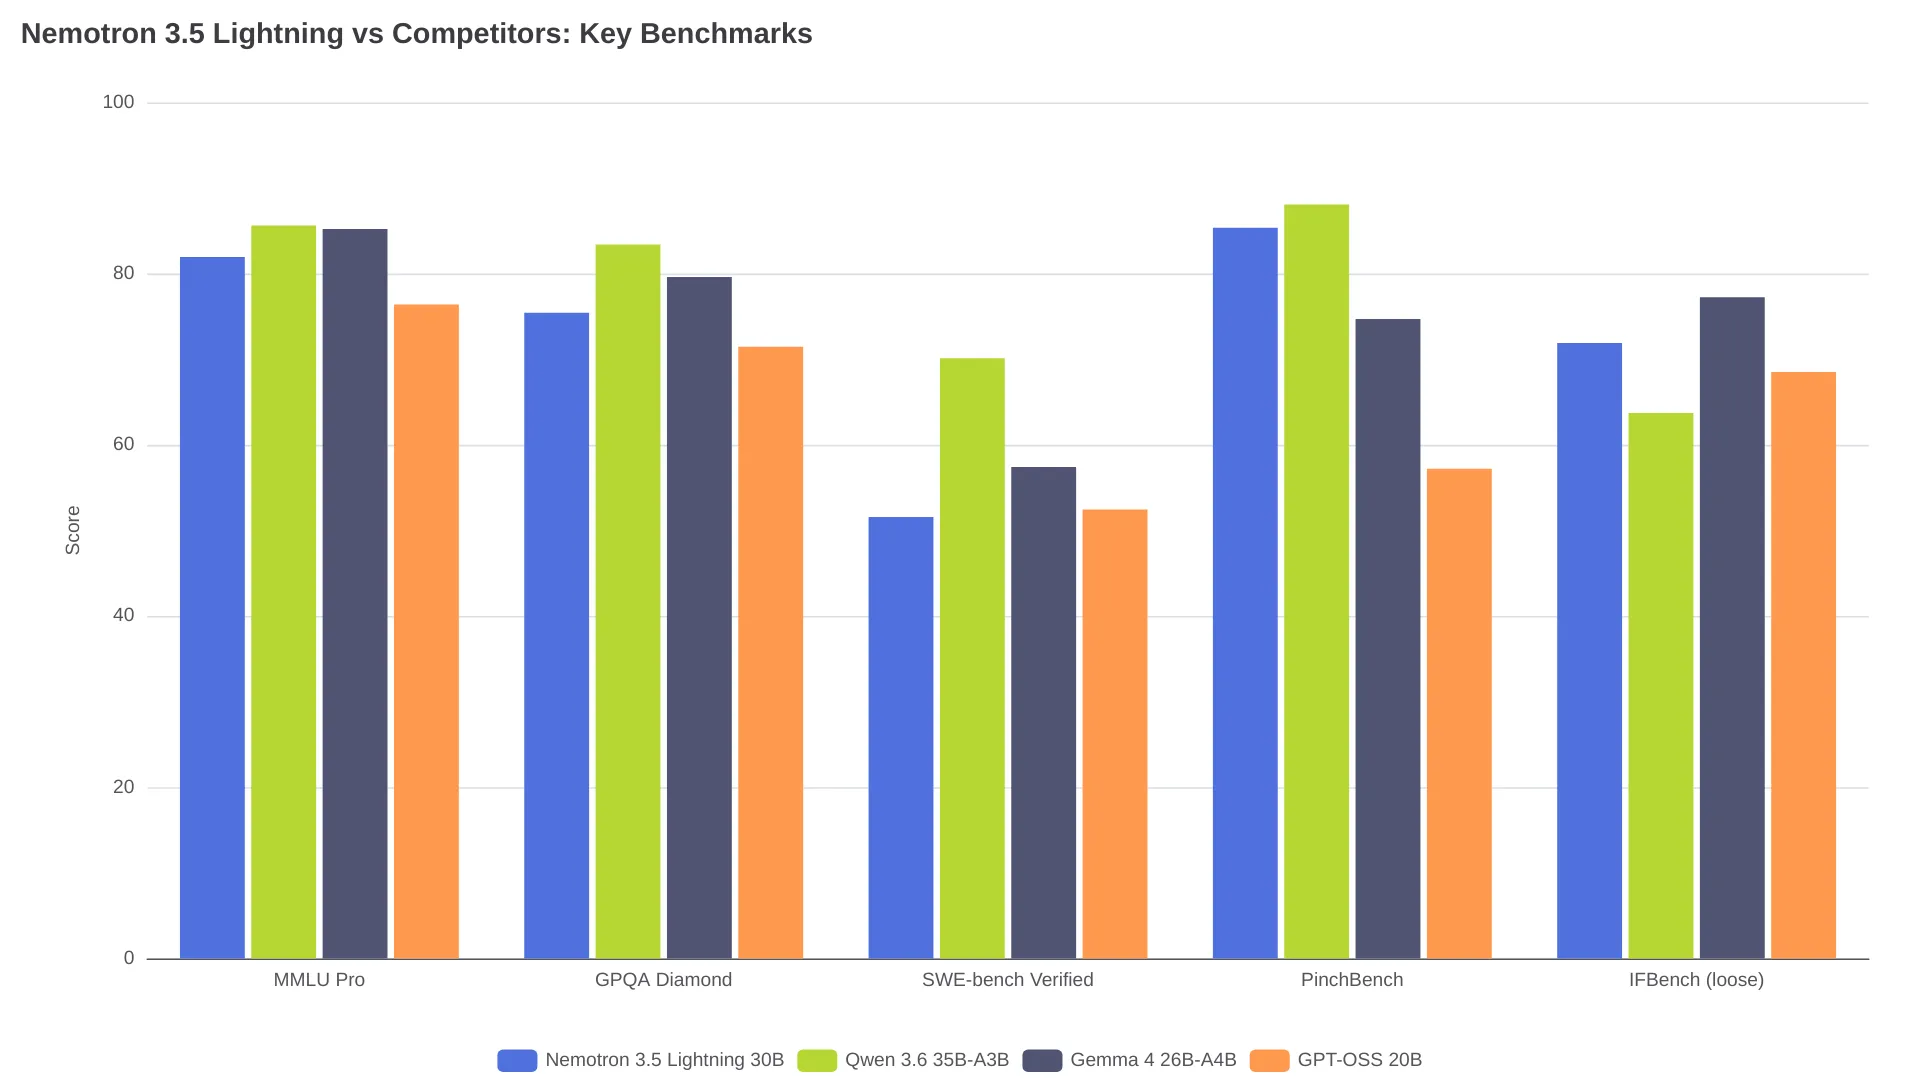
| Benchmark | Nemotron 3.5 Lightning | Qwen 3.6 35B-A3B | Gemma 4 26B-A4B | GPT-OSS 20B |
|---|---|---|---|---|
| MMLU Pro | 81.94 | 85.63 | 85.20 | 76.40 |
| GPQA Diamond (sans outils) | 75.44 | 83.40 | 79.61 | 71.46 |
| SWE-bench Verified | 51.56 | 70.12 | 57.40 | 52.44 |
| SWE-bench Multilingual | 39.33 | 63.40 | 43.40 | 41.93 |
| Terminal-Bench 2.1 | 24.58 | 44.38 | 37.22 | 15.17 |
| PinchBench | 85.37 | 88.07 | 74.70 | 57.20 |
| BrowseComp | 36.97 | 48.74 | 26.30 | - |
| IFBench (souple) | 71.88 | 63.71 | 77.25 | 68.50 |
| AA-LCR | 52.00 | 61.06 | 57.56 | 32.88 |
| SciCode | 32.60 | 35.33 | 40.28 | 38.63 |
Lightning est derrière Qwen 3.6 35B-A3B sur 11 des 12 lignes comparables. L'exception est IFBench, en mode souple de suivi des instructions : 71.88 contre 63.71 pour Qwen, soit 8 points d'avance. Un résultat cohérent avec son positionnement d'exécution agentique : le respect des consignes compte davantage que le raisonnement brut lorsqu'il faut formater un appel d'outil ou valider une sortie.
C'est sur la vitesse que Lightning se distingue. Dans l'évaluation PinchBench de NVIDIA, qui mesure 10,000 tâches d'agents en heures GPU H100, Lightning termine la charge en environ 16.5 heures GPU avec 86% de précision. Qwen 3.6 35B nécessite 23.5-24 heures GPU pour 87% de précision, et Gemma 4 26B 25-26 heures GPU pour 73% :
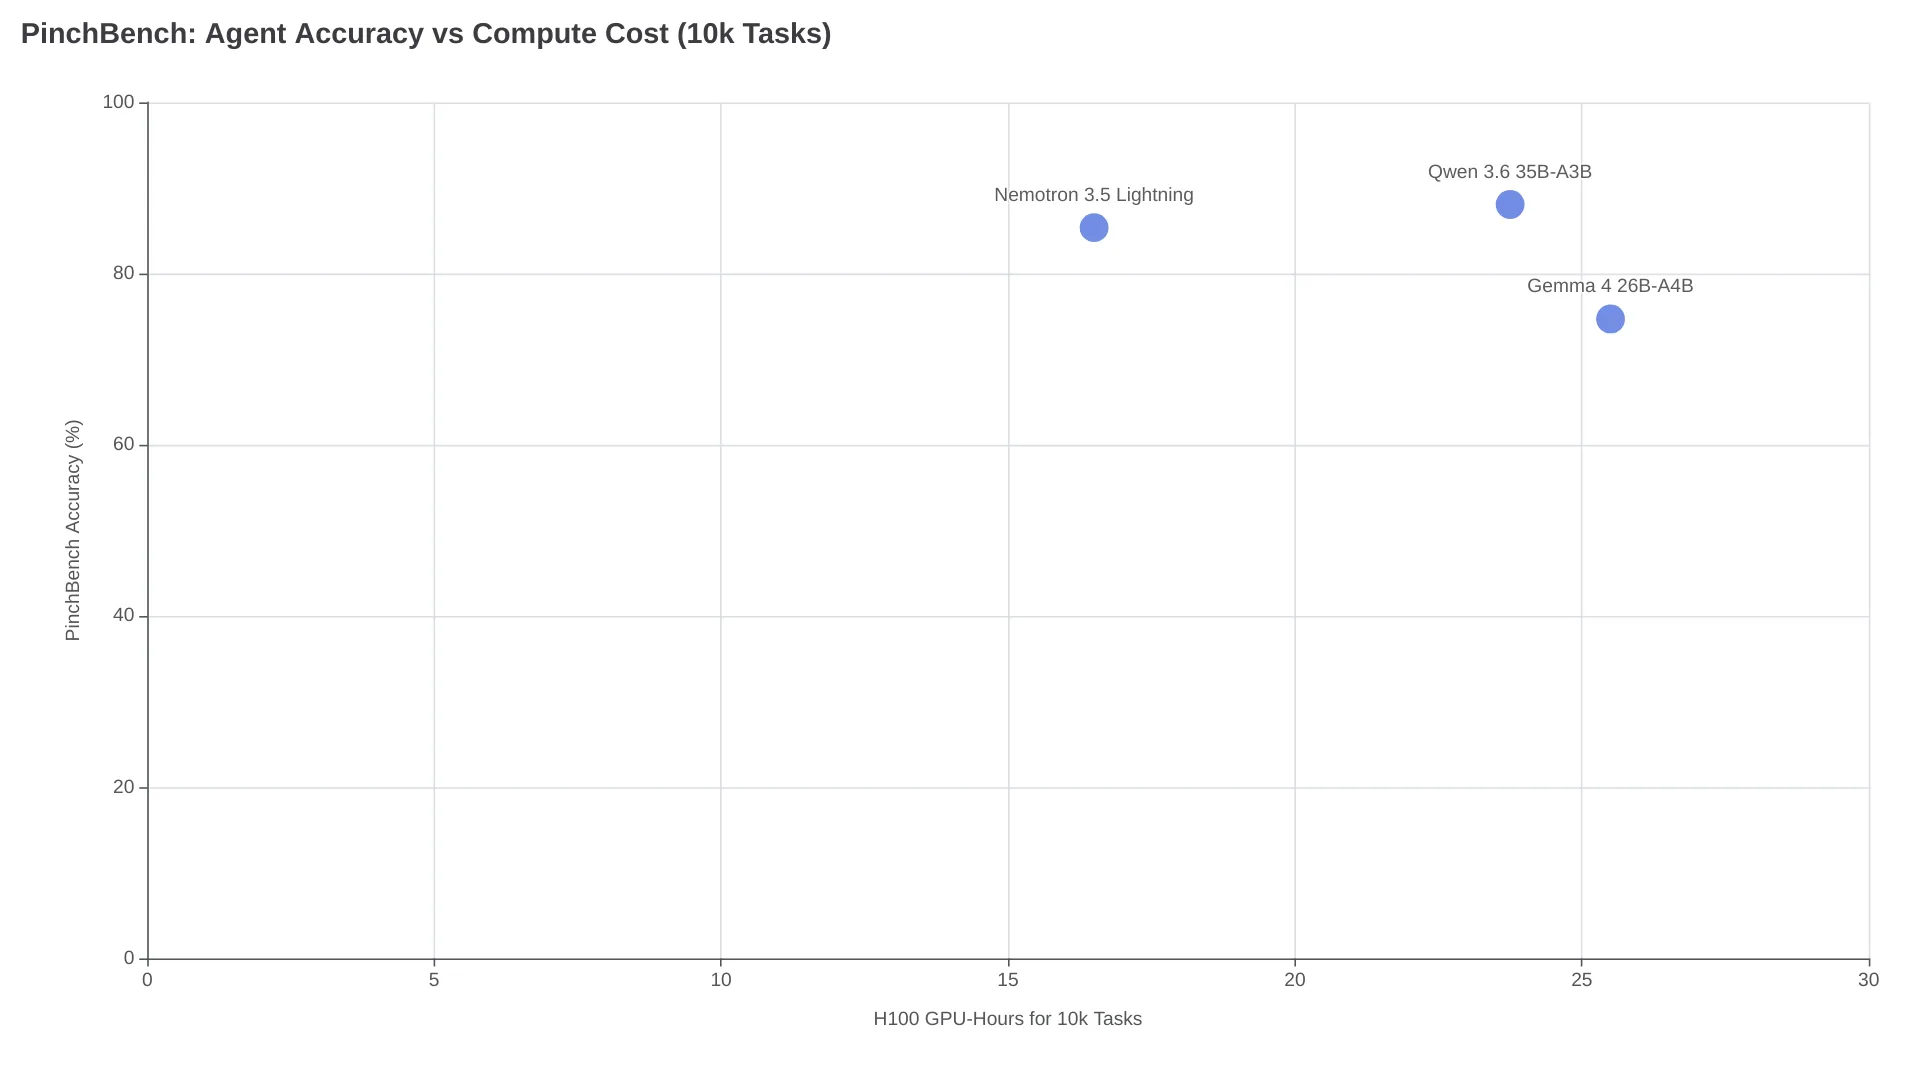
On parle donc d'environ 30% de calcul en moins pour une précision quasiment identique, un écart important sur 10,000 étapes d'agents facturées à l'heure GPU. NVIDIA indique aussi environ 670 tokens de sortie par seconde et ~23-24 points d'Intelligence Index sur le classement Artificial Analysis. Cela le place sur la frontière de Pareto des modèles à poids ouverts de moins de 40B de paramètres totaux.
Les essais de la communauté sur r/LocalLLaMA vont dans le même sens. Un utilisateur de DGX Spark a relevé 78.5 tokens par seconde sans spéculation, puis 90.7 tokens par seconde avec speculative decoding sur le checkpoint NVFP4. Dans le fil de discussion principal, un autre utilisateur situe la qualité de Lightning « entre Gemma 4 26B et 31B, beaucoup plus près de 26B ». Il note une vitesse environ 2x supérieure à Gemma 31B, mais aussi de nombreux thinking tokens qui réduisent ce gain dans les usages réels. Les premières conversions GGUF Q4, annoncées à 25 GB, signalent des avertissements sur des tenseurs inutilisés : l'architecture hybride Mamba-2 ne semble donc pas encore pleinement prise en charge par tous les outils basés sur GGUF.
Configuration matérielle et déploiement local
Le checkpoint BF16, qui correspond aux poids de référence en pleine précision, demande 1x H100 80GB ou 1x A100 80GB pour un déploiement sur un seul GPU. Son fichier safetensors fragmenté pèse 65.8 GB. NVIDIA recommande explicitement la version NVFP4 distincte pour l'inférence en production.
| Checkpoint | Taille de fichier (env.) | GPU minimum | Usage recommandé |
|---|---|---|---|
| BF16 | 65.8 GB | 1x H100/A100 80GB | Fine-tuning, recherche, création de variantes quantifiées |
| NVFP4 | ~16 GB | RTX 5090, DGX Spark, Jetson (Blackwell/Hopper/Ampere) | Inférence de production, déploiement d'agents |
| GGUF Q4 | ~25 GB | 16 GB+ de VRAM (créé par la communauté) | llama.cpp, Ollama, LM Studio |
NVIDIA a collaboré avec quatre projets de serving local afin d'assurer une prise en charge dès le lancement : vLLM, SGLang, Ollama et llama.cpp. LM Studio et Unsloth sont également cités. Le modèle prend en charge trois stratégies de speculative decoding :
- DSpark - recommandé pour DGX Spark et l'inférence en datacenter à faible concurrence
- DFlash - modèle de brouillon alternatif, à évaluer selon la charge
- MTP (Multi-Token Prediction) - intégré au modèle, idéal pour une concurrence moyenne à élevée
Sans matériel local, Lightning est accessible via build.nvidia.com sous forme de microservice NIM, ainsi que sur OpenRouter. Le checkpoint NVFP4 fonctionne sur GeForce RTX 5090, DGX Spark, les systèmes OEM GB10 et NVIDIA Jetson.
Le routage d'agents, le terrain de jeu de Lightning
La bibliothèque de routage open source de NVIDIA, NeMo Switchyard, oriente chaque étape d'un workflow d'agents vers le modèle le plus adapté selon la précision, la vitesse et le coût. La planification est confiée à un modèle de raisonnement de frontière ; l'exécution redescend vers Lightning. D'après le benchmark interne de NVIDIA, Switchyard conserve un taux de finalisation de tâche « de niveau frontière » tout en ramenant le coût à environ un tiers de celui d'Opus 4.8 utilisé seul. Parmi les tâches confiées à Lightning figurent git pull, la validation des sorties d'outils, le formatage des résultats et les appels API de routine.
Ce schéma a déjà été appliqué en conditions réelles. CodeRabbit a publié un cas d'usage sur Reddit : l'équipe a post-entraîné Nemotron 3.5 Lightning pour le routage de revues de code, au moyen d'un SFT ciblé et de RLVR (reinforcement learning with verifiable rewards). Sur une évaluation gelée de 1,000 tâches, le modèle a dépassé leur baseline, pour moins de $100 de coûts d'entraînement. NVIDIA prend en charge ce workflow avec NeMo Automodel et NeMo Megatron Bridge (LoRA/SFT), NeMo RL et NeMo Gym (apprentissage par renforcement), ainsi qu'un jeu de données ouvert nommé Nemotron-RL Agentic Terminal Pivot.
Pour les équipes qui construisent des pipelines d'agents, la question pratique est simple : peut-on fine-tuner Lightning pour lui confier l'essentiel des étapes, au coût de 3B de paramètres actifs, et réserver un modèle de frontière aux rares étapes qui le justifient ?
Faut-il adopter Nemotron 3.5 Lightning ?
| Cas d'usage | Recommandation | Pourquoi |
|---|---|---|
| Routage d'agents à fort volume (appels d'outils, validation, formatage) | Lightning NVFP4 | 3B de paramètres actifs, vitesse de tokens 4x supérieure, ~30% de calcul en moins à précision comparable |
| Assistant de programmation généraliste | Qwen 3.6 35B-A3B | 70.12 contre 51.56 sur SWE-bench Verified, soit 19 points d'écart |
| Raisonnement / planification complexe | Nemotron 3 Ultra ou modèle de frontière | Lightning n'est explicitement pas le modèle de planification |
| Chat local sur un seul GPU grand public | Lightning NVFP4 sur RTX 5090 | Fonctionne, mais les conversions GGUF restent imparfaites ; vLLM/SGLang sont plus fiables |
| Fine-tuning pour une tâche d'agent ciblée | Lightning BF16 | 3B de paramètres actifs = fine-tuning moins coûteux ; OpenMDW v1.1 autorise l'usage commercial |
| Suivi d'instructions à grande échelle | Lightning | IFBench 71.88 contre 63.71 pour Qwen, soit 8 points d'avance |
Lightning échange de la précision maximale contre de la vitesse dans les tâches d'exécution à fort volume. La réduction de 30% du calcul s'accumule au fil des centaines d'étapes d'agents d'une session. Mais le modèle a été lancé le 11 août 2026 et son écosystème reste en phase de maturation. Son architecture hybride Mamba-2 implique que les outils fondés sur GGUF ne le prennent pas tous encore entièrement en charge. Sur du matériel NVIDIA avec vLLM ou SGLang, le checkpoint NVFP4 est aujourd'hui le chemin de déploiement le plus sûr ; sur Apple Silicon ou dans un environnement limité à GGUF, mieux vaut attendre que les conversions communautaires se stabilisent.
Questions fréquentes
Nemotron 3.5 Lightning peut-il fonctionner sur du matériel grand public ?
Seul le checkpoint NVFP4 est pris en charge par NVIDIA sur du matériel grand public. Les poids BF16 exigent un GPU de 80GB, H100 ou A100. NVFP4 fonctionne sur GeForce RTX 5090, DGX Spark et NVIDIA Jetson. Des conversions communautaires GGUF Q4 existent pour llama.cpp et Ollama sur des systèmes disposant de 16 GB+ de VRAM, mais les premières versions ont signalé des problèmes de tenseurs inutilisés liés à l'architecture hybride Mamba-2.
Comment Nemotron 3.5 Lightning se compare-t-il à Qwen 3.6 35B ?
Qwen 3.6 35B-A3B surpasse Lightning dans 11 des 12 benchmarks publiés, avec les écarts les plus marqués sur SWE-bench Verified et Terminal-Bench. Lightning l'emporte sur le suivi d'instructions IFBench et réalise les tâches d'agents environ 30% plus vite à précision comparable. Qwen est le meilleur modèle généraliste ; Lightning est le modèle le plus rapide pour l'exécution d'agents.
Nemotron 3.5 Lightning est-il bon pour le code ?
Pour les benchmarks de programmation bruts, non : il obtient 51.56 sur SWE-bench Verified, contre 70.12 pour Qwen 3.6. CodeRabbit a toutefois réussi à fine-tuner Lightning pour le routage de revues de code, pour moins de $100, en dépassant sa baseline. Le modèle est pensé pour la personnalisation : fine-tuné sur les conventions de votre codebase, il peut gérer les tâches de code récurrentes au coût de 3B de paramètres actifs.
Quelle licence utilise Nemotron 3.5 Lightning ?
Le modèle est publié sous licence OpenMDW v1.1 (Open Model Data Weight), que NVIDIA décrit comme publiée « aussi permissivement que possible ». Elle autorise l'utilisation commerciale, y compris des poids, des données d'entraînement et des recettes. Les conditions complètes figurent dans la model card HuggingFace.