 AIREITER
Jusqu’au 31 décembre 2026, Gemini 3.8 Flash est facturé $0.75 par million de tokens en entrée et $3.75 par million de tokens en sortie. Mais son raisonnement plus poussé peut renchérir chaque tâche menée à bien. Mieux vaut donc le tester sur des agents multimodaux ou spécialisés que migrer d’un coup toutes vos requêtes Gemini 3.7 Flash.
La réponse dès le lancement : qu’est-ce que Gemini 3.8 Flash ?
Gemini 3.8 Flash a été lancé le 2 septembre 2026, selon l’annonce de lancement de Google, avec l’identifiant stable gemini-3.8-flash pour l’API. Google le destine notamment au développement logiciel, aux agents autonomes et aux workflows d’entreprise en plusieurs étapes. La fiche du modèle sur Google AI for Developers le présente comme stable, tandis que la fiche de modèle de Google DeepMind précise qu’il repose sur Gemini 3.7 Flash.
Ce qui change par rapport à Gemini 3.7 Flash
Google indique que Gemini 3.8 Flash multiplie les étapes de raisonnement et appelle les outils de façon itérative lorsque la tâche se complique, tout en avertissant qu’un niveau d’effort supérieur peut consommer davantage de tokens. Artificial Analysis lui attribue un score de 59 à l’Intelligence Index avec un raisonnement élevé, contre 56 pour Gemini 3.7 Flash. En revanche, son coût par tâche dans ce même mode atteint $0.58, contre $0.40. (Annonce de lancement de Google ; comparatif d’Artificial Analysis)
Choisissez d’abord le workload, ensuite le modèle
Gemini 3.8 Flash donne le meilleur de lui-même lorsqu’une requête exploite un contexte étendu, plusieurs outils ou des éléments multimodaux. Pour des tâches courtes et répétitives, ses boucles de raisonnement supplémentaires ne feront pas forcément la différence.
Privilégiez Gemini 3.8 Flash pour les agents multimodaux et spécialisés
BenchmarkList rapporte 61.4% sur Finance Agent v2, 54.9% sur HLE-Verified, 87.8% sur LVBench, 86.2% sur CharXiv-R et 86.2% sur LABBench2. Sa fiche distingue les résultats issus de l’annonce de lancement, ceux auto-déclarés et ceux provenant de sources indépendantes : ces chiffres constituent donc des indicateurs, pas les résultats d’un test indépendant homogène. (fiche du modèle sur BenchmarkList)
| Workload | Éléments à prendre en compte | Décision |
|---|---|---|
| Analyse financière et structurée | Finance Agent v2 : 61.4% | Candidat solide pour un pilote maîtrisé |
| Compréhension de longues vidéos ou de graphiques | LVBench : 87.8% ; CharXiv-R : 86.2% | Candidat solide lorsque les modèles limités au texte montrent leurs limites |
| Workflows biologiques et scientifiques | LABBench2 : 86.2% ; BioMysteryBench human-difficult : 56.5% | À tester avec une revue réalisée par des experts |
| Longs documents et PDF | Limite de 1,048,576 tokens en entrée ; prise en charge des PDF | Utile pour la recherche et la synthèse, puis validez le rappel des informations |
La fiche de modèle de Google cite toujours les hallucinations, les timeouts et une certaine lenteur occasionnelle parmi ses limites. (fiche du modèle Gemini 3.8 Flash)
Conservez Gemini 3.7 Flash pour les requêtes simples où l’efficacité prime
Une chaîne de classification, d’extraction, d’étiquetage ou de résumé court n’a pas forcément besoin d’un raisonnement supplémentaire. Artificial Analysis mesure Gemini 3.8 Flash à $0.24 par tâche et 0.8 minute avec un niveau de raisonnement faible, contre $0.58 et 2.5 minutes avec un niveau élevé. Pour Gemini 3.7 Flash, les chiffres en raisonnement élevé sont de $0.40 par tâche et 2.2 minutes.
Utilisez 3.8 lorsque le raisonnement supplémentaire évite un échec ; gardez 3.7 lorsque la sortie additionnelle ne fait qu’augmenter la facture.
N’en faites pas pour autant le champion universel des agents de code autonomes
BenchmarkList recense 89.4% sur Terminal-Bench 2.1 et 73.7% sur DeepSWE 1.1, mais seulement 19.1% sur Terminal-Bench 4.0. La plateforme lui attribue aussi 59.0% sur OSWorld 2.0, une évaluation de l’utilisation d’un ordinateur sur de longues séquences d’actions. (résultats de BenchmarkList en programmation et pour les agents)
Pour un agent de terminal ou de bureau capable de reconstituer un état caché, de vérifier ses modifications et de poursuivre son travail après un échec d’outil, comparez Gemini 3.8 Flash à votre modèle actuel sur le même workflow avant de changer de solution.
Le vrai coût se mesure par tâche, pas par million de tokens
Tarifs de l’API Gemini 3.8 Flash jusqu’en 2026
L’annonce officielle de Google fournit les tarifs directs suivants pour l’API. Le prix d’introduction prend fin le 31 décembre 2026 ; le tarif standard entre en vigueur le 1er janvier 2027. (annonce de lancement de Google)
| Période | Prix des entrées | Prix des sorties | À retenir |
|---|---|---|---|
| Jusqu’au 31 déc. 2026 | $0.75 / 1M tokens | $3.75 / 1M tokens | Tarif de lancement |
| À partir du 1er janv. 2027 | $1.50 / 1M tokens | $7.50 / 1M tokens | Les deux tarifs doublent |
Au tarif de lancement, les sorties coûtent cinq fois plus cher que les entrées. La documentation de Google mentionne également la Batch API, l’inférence Flex et l’inférence Priority, mais la fiche du modèle citée n’en indique pas les prix chiffrés.
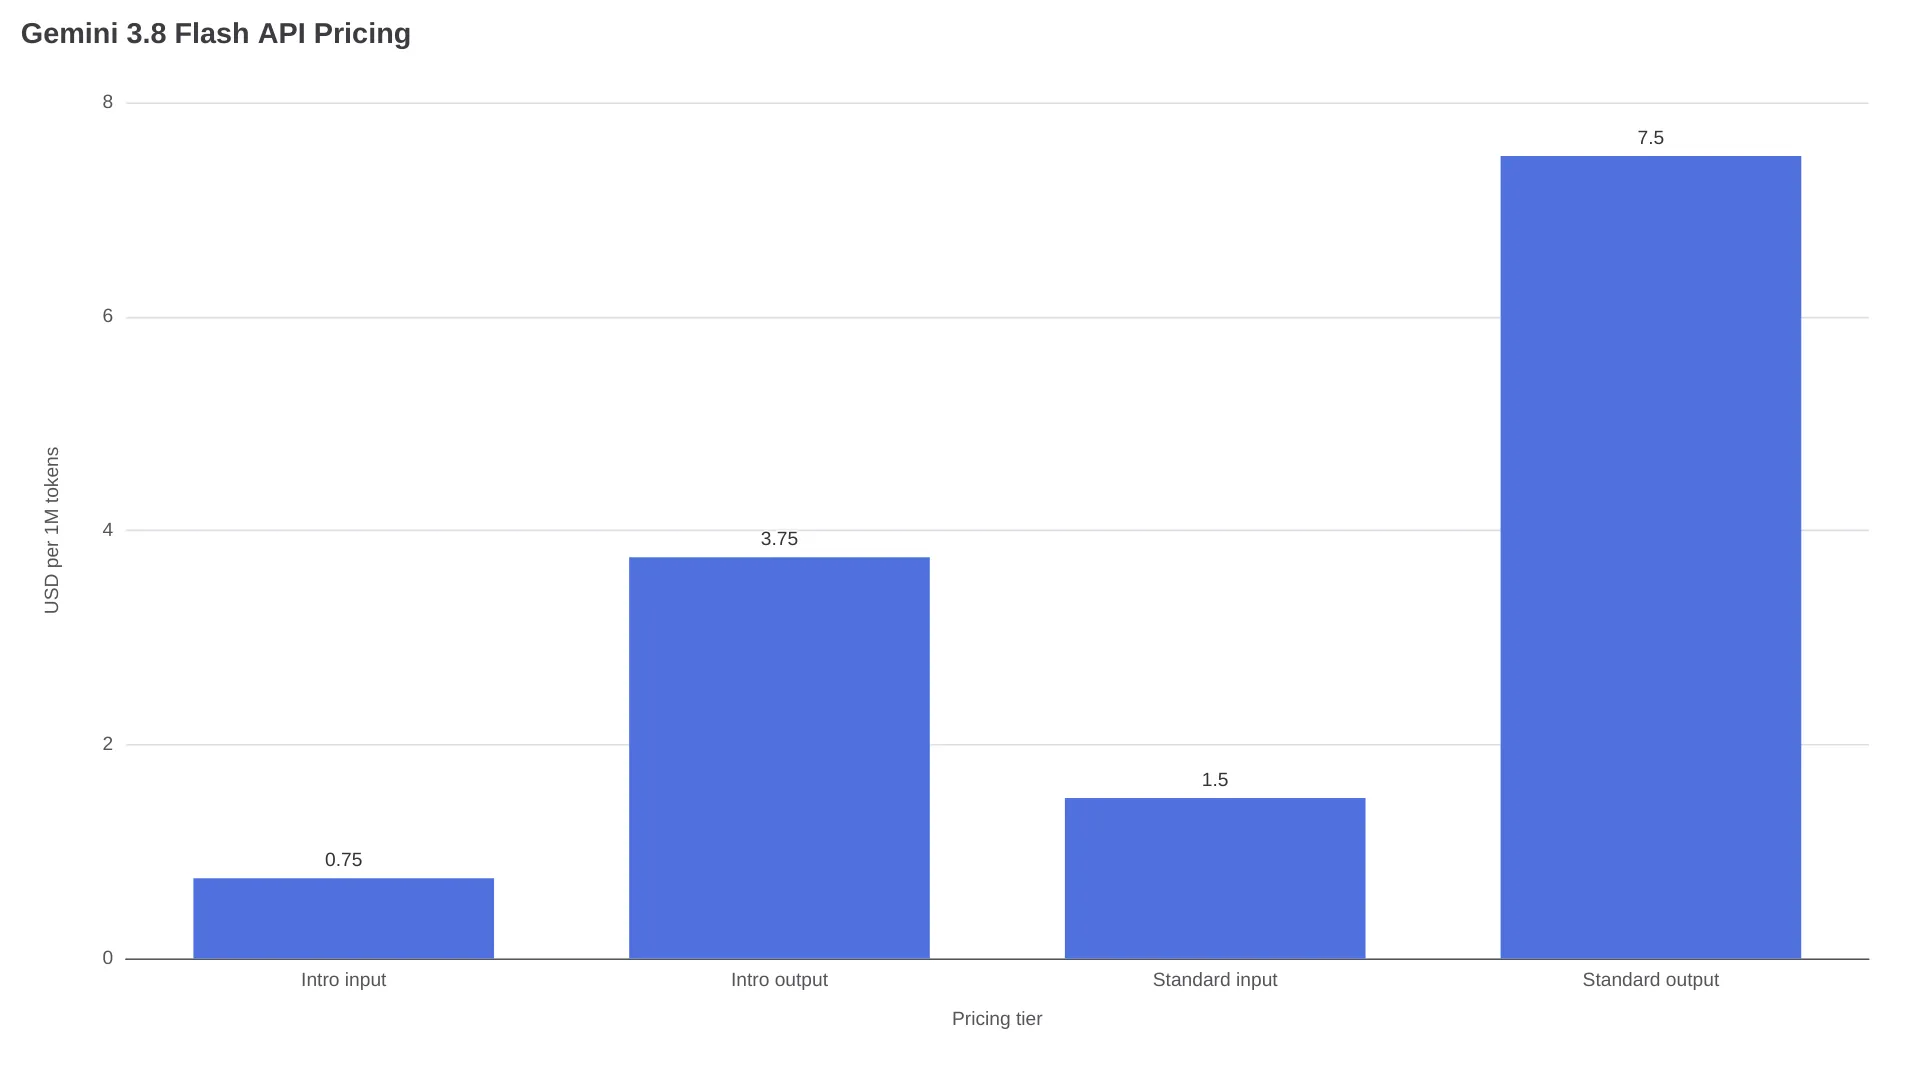
Une tâche utilisant 2 millions de tokens en entrée et 500,000 tokens en sortie coûte $3.38 au tarif de lancement : (2 × $0.75) + (0.5 × $3.75). Le même volume coûtera $6.75 à partir du 1er janvier 2027 : (2 × $1.50) + (0.5 × $7.50).
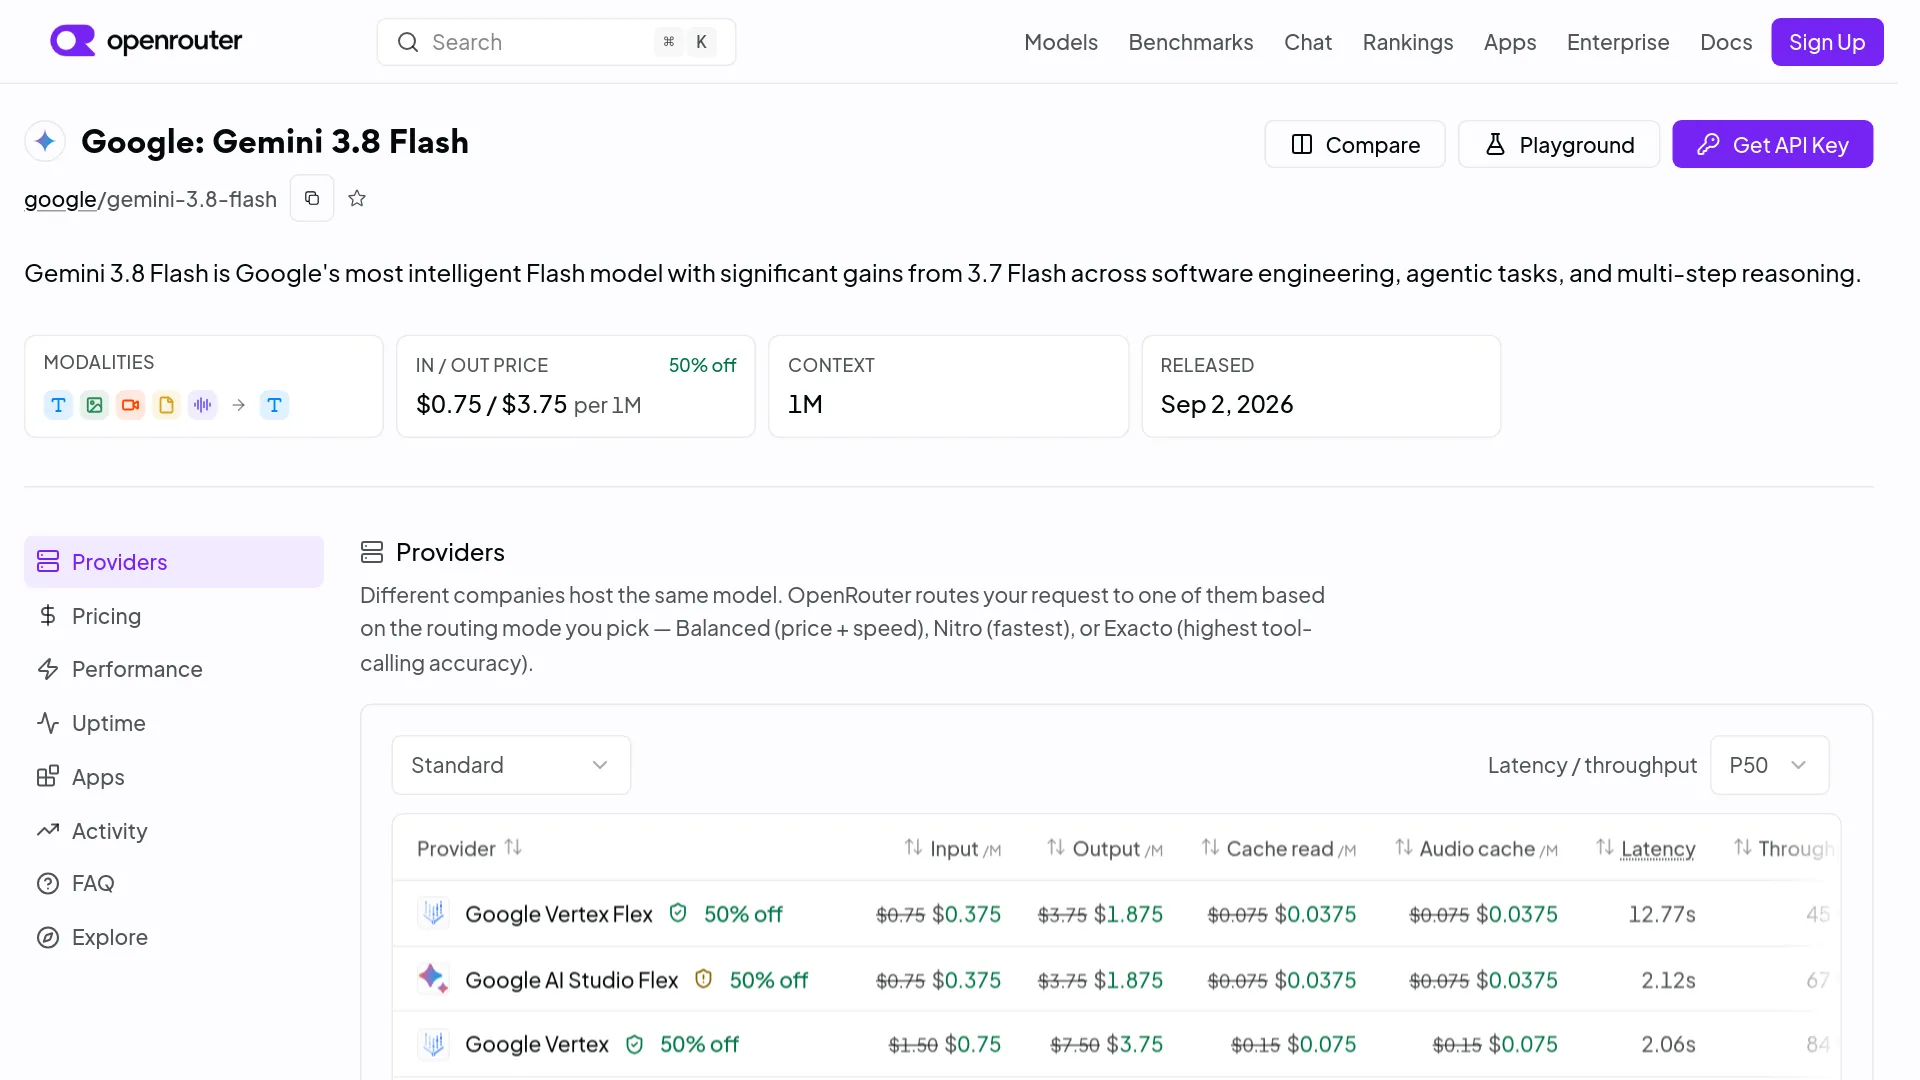
La page OpenRouter consacrée à Gemini 3.8 Flash détaille séparément les routes Google Vertex et Google AI Studio, les tarifs du cache, la latence, le débit et une remise affichée. Vérifiez le fournisseur et le circuit de facturation avant de comparer le prix d’un routeur avec la grille tarifaire directe de Google.
Pourquoi un token moins cher peut quand même faire grimper la facture
Artificial Analysis rapporte les mesures suivantes pour les différents niveaux de raisonnement de Gemini 3.8 Flash :
| Niveau de raisonnement | Intelligence Index | Coût par tâche | Durée par tâche |
|---|---|---|---|
| Faible | 52 | $0.24 | 0.8 minute |
| Moyen | 57 | $0.41 | Non indiqué |
| Élevé | 59 | $0.58 | 2.5 minutes |
Artificial Analysis n’indique pas la durée associée au raisonnement moyen dans l’analyse citée. Cette même analyse précise que Gemini 3.8 Flash a généré 120 millions de tokens en sortie lors de son évaluation Intelligence Index, contre une médiane de 71 millions de tokens pour les modèles comparables. Il s’agit d’une mesure portant sur l’ensemble de l’évaluation, pas d’une prévision pour chaque requête API. Elle montre néanmoins pourquoi le prix des tokens ne suffit pas à établir un budget de production. (profil du modèle sur Artificial Analysis)
Pour vos propres comparaisons, mesurez le total des tokens en entrée, des tokens d’entrée mis en cache, des tokens de raisonnement et des tokens en sortie pour chaque tâche terminée. Divisez ensuite la dépense API par le nombre de tâches réussies, et non par le nombre de requêtes envoyées. Intégrez aussi les appels d’outils, les nouvelles tentatives et les corrections humaines.
Limites et capacités de l’API
Ce que prend en charge l’API stable
La fiche officielle du modèle indique une limite maximale de 1,048,576 tokens en entrée et de 65,536 tokens en sortie. Gemini 3.8 Flash accepte du texte, des images, des vidéos, de l’audio et des PDF en entrée, et renvoie du texte. Il prend en charge la mise en cache, l’exécution de code, la recherche dans des fichiers, les appels de fonctions, l’ancrage Google Maps, l’ancrage par recherche, les sorties structurées, le contexte d’URL et l’utilisation d’un ordinateur en Preview. (documentation officielle du modèle)
Les niveaux de réflexion disponibles sont low, medium et high ; minimal n’est pas pris en charge et renvoie une erreur. Le modèle ne génère pas nativement d’images ni d’audio, et la documentation destinée aux développeurs ne mentionne pas de prise en charge de Live API.
Où l’utiliser — et pourquoi Cyber est un cas à part
Google référence Gemini 3.8 Flash dans Gemini API, Google AI Studio, Android Studio, Stitch, Google Antigravity, Gemini Enterprise, l’application Gemini, AI Mode dans Google Search et Gemini dans Google Sheets. (annonce de lancement de Google)
Gemini 3.8 Flash Cyber est une variante distincte dédiée à la cybersécurité. Google indique que l’accès à Fairwind est prioritairement accordé aux défenseurs de confiance, notamment aux autorités publiques, aux opérateurs d’infrastructures critiques et aux mainteneurs de logiciels. L’annonce fait état d’un taux de réussite supérieur à 70% sur un benchmark interne de découverte de vulnérabilités couvrant 20 langages de programmation, ainsi que de 47.2% en pass@1 sur le patching évalué par CWE-Bench ; ces chiffres concernent Cyber, pas le modèle généraliste. Google décrit un accès via Fairwind : ne supposez donc pas que la route API Flash standard donne accès à Cyber. (annonce de Google sur Cyber)
Le déploiement initial peut varier selon le compte et l’interface. Un utilisateur de Reddit a signalé :
« 3.8 Flash apparaît aussi chez moi dans l’application web Gemini, donc on dirait qu’il est officiellement disponible. Je suis en Australie avec un abonnement Pro, mais il n’est pas encore apparu dans AntiGravity ni dans l’application iOS. » — u/DMAC80, r/GeminiAI
Pour une application, vérifiez l’identifiant API configuré, gemini-3.8-flash, ainsi que les métadonnées de réponse accessibles à votre intégration ; l’auto-description d’un modèle ne suffit pas à vérifier le endpoint utilisé.
Ce que les données disponibles ne permettent pas encore d’affirmer
| Limitation documentée | Conséquence pratique |
|---|---|
| Artificial Analysis mesure 13.39 secondes avant le premier token de réponse avec un raisonnement élevé, malgré environ 304.6 tokens de sortie par seconde ensuite. (profil du modèle sur Artificial Analysis) | Prévoyez une attente initiale liée au raisonnement, suivie d’une génération rapide. |
| La fiche de modèle de DeepMind indique une date de coupure des connaissances en mars 2026, certains domaines étant limités à janvier 2025. (fiche du modèle Gemini 3.8 Flash) | Utilisez l’ancrage par recherche ou une récupération vérifiée pour les informations actuelles. |
| L’utilisation d’un ordinateur est uniquement disponible en Preview, la documentation développeur ne mentionne pas d’option d’auto-hébergement et la sortie est textuelle, pas visuelle, audio ou vidéo. (documentation développeur de Google) | Prévoyez un déploiement ou un modèle de secours distinct pour ces besoins. |
Un déploiement progressif pour limiter les risques en production
- Sélectionnez 30–50 tâches réelles représentatives de votre production, en incluant les cas à long contexte et les échecs connus.
- Faites tourner Gemini 3.8 Flash avec des niveaux de réflexion faible, moyen et élevé face à votre modèle actuel.
- Journalisez le nombre total de tokens, les accès au cache, les tours d’outils, les nouvelles tentatives, le délai avant le premier token, la durée complète, les corrections humaines et le taux de tâches acceptées.
- Calculez le coût par tâche réussie et séparez le trafic interactif du trafic batch.
- Déployez Gemini sur une petite partie du trafic de production avant de modifier la route par défaut.
- Conservez Gemini 3.7 Flash pour les tâches simples si le raisonnement supplémentaire n’améliore pas le coût par tâche acceptée.
- Intégrez dans votre budget le tarif du 1er janvier 2027 : $1.50 par million de tokens en entrée et $7.50 en sortie.
Le meilleur premier test repose sur un résultat vérifiable : une modification impliquant plusieurs fichiers avec ses tests, un workflow documentaire dont la réponse est connue ou une tâche d’extraction multimodale avec des labels contrôlés.
FAQ sur les tarifs de l’API Gemini 3.8 Flash
Combien coûte Gemini 3.8 Flash ?
Le tarif direct de lancement de Google pour l’API est de $0.75 par million de tokens en entrée et $3.75 par million de tokens en sortie jusqu’au 31 décembre 2026. À partir du 1er janvier 2027, les tarifs indiqués passent respectivement à $1.50 et $7.50.
Gemini 3.8 Flash est-il meilleur que Gemini 3.7 Flash ?
Il obtient de meilleurs résultats sur plusieurs mesures de raisonnement et d’utilisation d’agents publiées au lancement, notamment un score de 59 contre 56 à l’Intelligence Index d’Artificial Analysis avec un raisonnement élevé. Gemini 3.7 Flash peut toutefois coûter moins cher sur les tâches simples, car 3.8 est susceptible de générer davantage de tokens en sortie.
Gemini 3.8 Flash convient-il aux agents de programmation ?
C’est un candidat crédible, avec des scores rapportés de 89.4% sur Terminal-Bench 2.1 et 73.7% sur DeepSWE 1.1. Son résultat de 19.1% sur Terminal-Bench 4.0 montre toutefois que les workflows de terminal et de bureau sur de longues séquences doivent faire l’objet d’une évaluation spécifique.
Gemini 3.8 Flash est-il gratuit ?
L’API est payante selon les tarifs par token indiqués. Consultez séparément les conditions actuelles des projets AI Studio et la grille tarifaire de l’API directe.
Qu’est-ce que Gemini 3.8 Flash Cyber et qui peut y accéder ?
Gemini 3.8 Flash Cyber est optimisé pour la découverte de vulnérabilités et l’application automatisée de correctifs. Google indique que l’accès est accordé en priorité via le Fairwind Program aux défenseurs de confiance ; il ne s’agit pas d’un modèle public général accessible avec une simple clé API Gemini 3.8 Flash.
Commencez avec un raisonnement faible ou moyen sur un jeu de tâches fixe, mesurez le coût par résultat accepté et n’augmentez le niveau d’effort que lorsque le travail supplémentaire évite un échec mesurable.