 AIREITER
Un appel à gemini-2.5-pro effectué le 2 décembre ne renverra pas forcément d’erreur. Il répondra simplement avec un autre modèle. Google a déprécié gemini-2.5-pro et gemini-2.5-flash le 2 novembre 2026 et, à partir du 1er décembre 2026, la Gemini Developer API redirigera automatiquement ces identifiants vers gemini-3.8-flash et gemini-3.5-flash-lite, selon les tarifs des modèles de remplacement. Le vrai problème est là : il ne s’agit pas seulement d’un changement de nom, mais d’un changement de gamme accompagné de paramètres incompatibles. Continuer à utiliser les anciens identifiants jusqu’en décembre est donc une stratégie risquée.
Ce que Google a annoncé pour le 1er décembre
Google a déprécié gemini-2.5-pro et gemini-2.5-flash dans la Gemini Developer API. Les deux identifiants ont disparu du sélecteur de Google AI Studio, et l’accès à l’API est désormais limité aux développeurs qui ont déjà utilisé chacun de ces modèles. À partir du 1er décembre 2026, les requêtes continueront d’aboutir, mais elles seront exécutées par d’autres modèles et facturées à d’autres tarifs.
Voici la correspondance indiquée sur la page de dépréciation de la Gemini API :
| Ancien identifiant appelé | Modèle qui répond à partir du 1er décembre 2026 | Facturation à partir du 1er décembre |
|---|---|---|
gemini-2.5-pro | gemini-3.8-flash | Tarifs de Gemini 3.8 Flash |
gemini-2.5-flash | gemini-3.5-flash-lite | Tarifs de Gemini 3.5 Flash-Lite |
gemini-2.5-flash-lite | inchangé, aucune redirection | inchangée |
Google indique le 1er décembre 2026 comme date de redirection pour les deux identifiants stables. L’annonce figure dans l’entrée du changelog du 2 novembre 2026. Patrick Loeber, membre de l’équipe Google DeepMind, l’a relayée dans un PSA en rappelant que les intégrations avancées nécessitent un travail de migration.
Cette annonce concerne uniquement la Gemini Developer API et AI Studio. Vertex AI suit un calendrier de retrait distinct : Google Cloud y indique des dates en octobre 2026 pour les mêmes noms de modèles, tandis que Firebase AI Logic publie sa propre liste de modèles pris en charge. Les utilisateurs de Vertex doivent donc consulter la console Cloud au lieu de supposer que le 1er décembre s’applique partout.
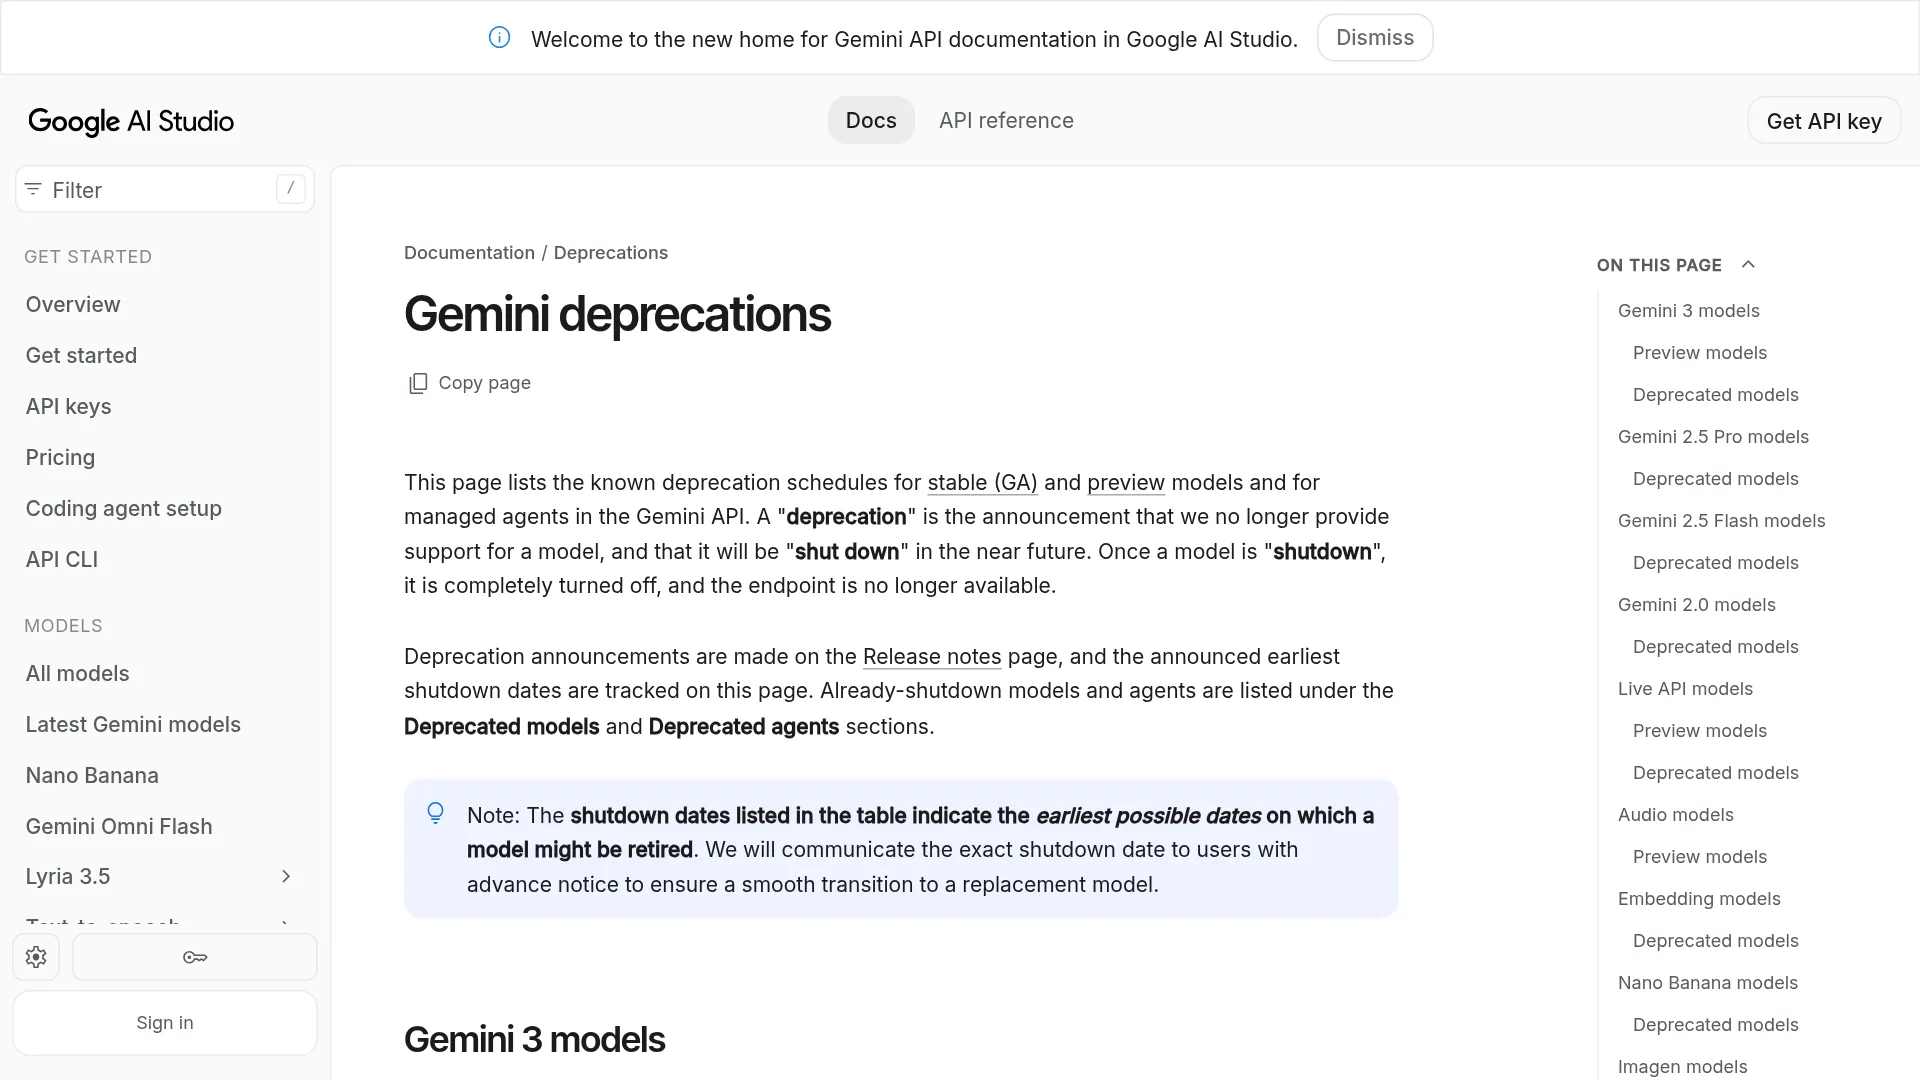
Google affirmait encore le 18 septembre que la version 2.5 n’était « pas dépréciée », avant de la déprécier le 2 novembre. Considérez donc le 1er décembre comme une échéance ferme. Le changelog complet permet de suivre ce revirement.
Combien coûteront les requêtes redirigées en décembre et janvier
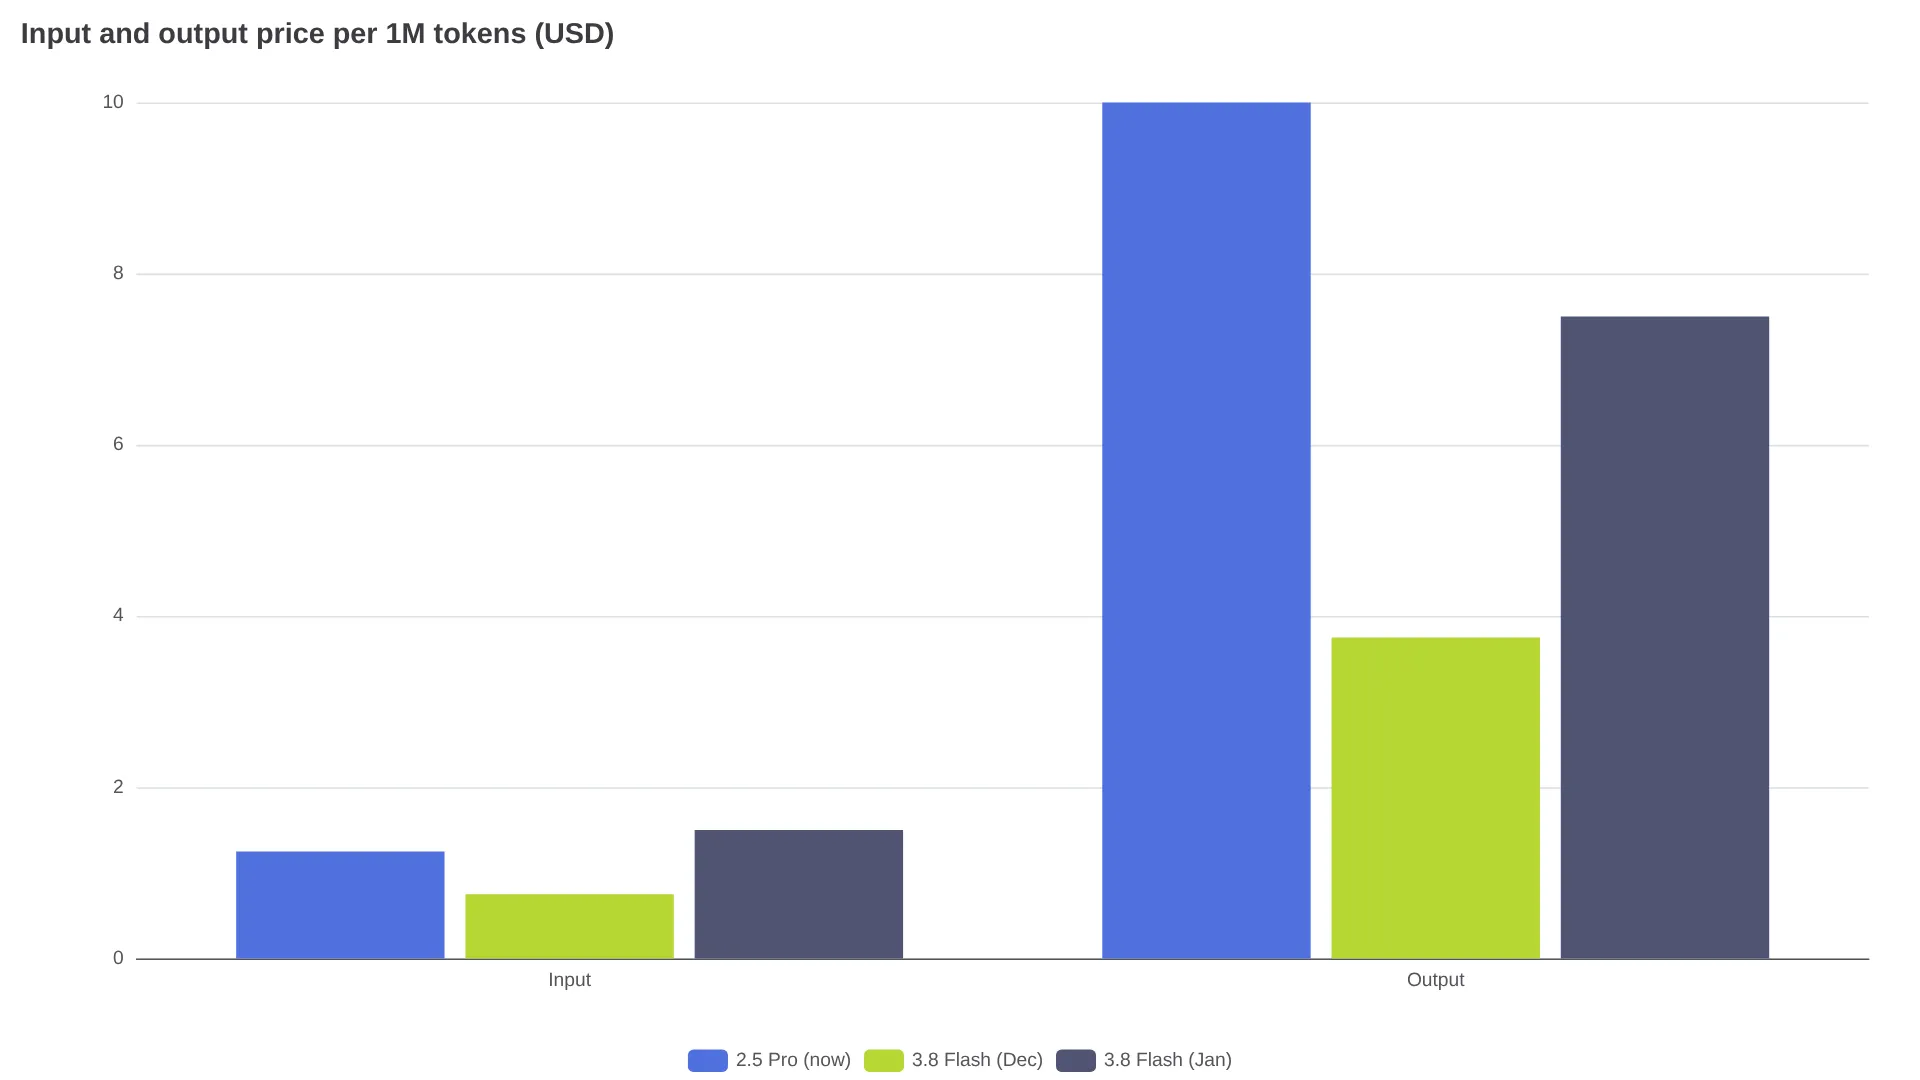
Le trafic Gemini 2.5 Pro coûtera moins cher en décembre, avant une hausse du prix des entrées en janvier. Pour Gemini 2.5 Flash, le texte conservera le même tarif après la bascule, tandis que l’audio deviendra nettement moins cher. Les montants ci-dessous correspondent aux tarifs catalogue des offres payantes par million de tokens, tirés de la page de tarification de la Gemini API telle qu’elle était disponible le 3 novembre 2026. Pour le détail de chaque modèle, consultez aussi les analyses consacrées aux tarifs de Gemini 3.8 Flash et de Gemini 3.5 Flash-Lite.
| Modèle et période | Entrée / million | Sortie, réflexion incluse / million |
|---|---|---|
gemini-2.5-pro, prompts ≤200k tokens, jusqu’au 30 novembre | $1.25 | $10.00 |
gemini-2.5-pro, prompts >200k tokens, jusqu’au 30 novembre | $2.50 | $15.00 |
gemini-3.8-flash, du 1er au 31 décembre 2026 | $0.75 | $3.75 |
gemini-3.8-flash, à partir du 1er janvier 2027 | $1.50 | $7.50 |
Gemini 3.8 Flash applique un tarif unique quelle que soit la longueur du prompt. Les traitements utilisant plus de 200 000 tokens de contexte sont donc ceux qui profiteront le plus de la baisse. Un prompt de 300 000 tokens en entrée et 4 000 en sortie pour un long document coûte environ $0.81 avec Gemini 2.5 Pro au tarif de $2.50/$15.00, environ $0.24 avec le tarif de décembre de Gemini 3.8 Flash à $0.75/$3.75, puis environ $0.48 avec le tarif de janvier à $1.50/$7.50. En janvier, les conversations courtes mais très chargées en entrées sont les seules à revenir près de l’ancienne facture.
Pour la bascule de Flash, le calcul est plus simple :
| Modèle | Entrées texte/image/vidéo | Entrées audio | Sorties |
|---|---|---|---|
gemini-2.5-flash jusqu’au 30 novembre | $0.30 | $1.00 | $2.50 |
gemini-3.5-flash-lite à partir du 1er décembre | $0.30 | $0.30 | $2.50 |
Le cache de contexte, le traitement par lots et la priorité suivent la même logique : les tarifs texte restent identiques, tandis que ceux de l’audio baissent. Un détail compte pour les prévisions budgétaires : les tokens de réflexion sont facturés comme des tokens de sortie, et les modèles de remplacement peuvent en générer un nombre différent sur les tâches longues. Il est donc impossible de supposer que le volume de sortie restera identique. Comparez les champs usage_metadata sur du trafic réel avant de figer vos estimations.
Pourquoi le même identifiant de modèle peut casser du code fonctionnel
La redirection automatique conserve la réponse HTTP 200, mais change le modèle qui s’exécute en arrière-plan. Gemini 3.x applique des règles de requête que Gemini 2.5 acceptait, si bien qu’un code qui ne fait jamais référence au nom du modèle peut commencer à échouer ou à produire des résultats différents après le 1er décembre.
Gemini 3.x remplace thinking_budget par thinking_level. Gemini 3.8 Flash accepte low, medium et high, mais rejette minimal ; Gemini 3.5 Flash-Lite utilise par défaut minimal. Envoyer les deux champs provoque une erreur HTTP 400, et réutiliser une configuration minimal pour les deux modèles de remplacement casse le chemin Gemini 3.8 Flash. Google recommande minimal pour l’extraction, le routage et la classification, et medium ou high pour les sous-agents, les appels d’outils, l’exécution de code et le raisonnement en plusieurs étapes, afin d’éviter l’arrêt prématuré des outils.
Les paramètres d’échantillonnage et de gestion de l’historique évoluent eux aussi, comme l’explique le guide de migration vers Gemini 3. temperature, top_p et top_k sont actuellement ignorés sur Gemini 3.x et devraient provoquer une erreur HTTP 400 dans les prochaines générations. candidate_count n’est pas pris en charge. Toute requête dont le dernier tour non vide utilise le rôle model — notamment l’ancienne technique de préremplissage consistant à terminer par Translation: — renvoie une erreur HTTP 400. Google recommande plutôt system_instruction et les sorties structurées.
Les appels de fonctions sont également plus strictement validés. Gemini 3.x vérifie thought_signature et exige que chaque FunctionResponse contienne l’identifiant et le nom de l’appel correspondant. Supprimer la signature ou reconstruire le tour du modèle sans elle peut produire une réponse STOP vide ou une fin MISSING_THOUGHT_SIGNATURE, au lieu d’une erreur explicite. Les tests de non-régression doivent donc vérifier le texte de la réponse, pas seulement l’absence d’exception.
Des utilisateurs ont signalé exactement ce comportement dans les heures qui ont suivi l’annonce :
Google vient de fixer une date pour la fin de Gemini 2.5, mais le point important n’est pas la dépréciation. C’est la redirection automatique. […] Votre code ne renverra donc pas une erreur 404. Il commencera discrètement à répondre avec un autre modèle. — @VarunChopr17597
Si votre agent appelle encore gemini-2.5-flash, il fonctionnera à partir du 1er décembre avec Gemini 3.5 Flash-Lite, dont le niveau de réflexion par défaut est minimal. — @MarMarLabs
Migrer en novembre : la checklist en 7 étapes
La solution la plus sûre consiste à modifier explicitement les identifiants de modèle et les paramètres en novembre, puis à comparer le modèle de remplacement à l’existant avec une évaluation côte à côte. Ne faites pas du routeur votre stratégie de migration.
- Repérez chaque référence, ainsi que les alias preview. Cherchez les deux identifiants concernés dans le code, les configurations, les bancs d’évaluation et la documentation, en excluant le modèle Lite qui n’est pas concerné :
grep -rnE 'gemini-2\.5-(pro|flash)([^-]|$)' .
- Remplacez explicitement les identifiants. Dans une branche — et non le matin du 1er décembre — remplacez
gemini-2.5-propargemini-3.8-flashetgemini-2.5-flashpargemini-3.5-flash-lite. - Corrigez la configuration de réflexion. Remplacez
thinking_budgetparthinking_level, définissez ce niveau pour chaque modèle (mediumouhighpour les agents sur 3.8 Flash ;minimal,mediumouhighexplicitement selon les usages de Flash-Lite) et évitez de partagerminimalavec 3.8 Flash. - Supprimez les paramètres obsolètes. Retirez
temperature,top_p,top_k,candidate_countainsi que les tours finaux du modèle préremplis avant de lancer les tests. - Mettez à jour le SDK et la gestion des outils. Passez à un SDK récent, conservez les tours complets du modèle, y compris
thoughtSignature, construisez lesFunctionResponseavec l’identifiant et le nom de l’appel, puis retestez les appels d’outils en plusieurs tours de bout en bout. - Relancez les références avec le modèle de remplacement. Comparez la qualité, la latence, la longueur des sorties et les volumes de tokens indiqués dans
usage_metadatasur des prompts de production ; un modèle Flash ne reproduira pas nécessairement le style d’un modèle Pro pour chaque tâche. - Recalculez les coûts deux fois. Prévoyez pour décembre un tarif de $0.75/$3.75 sur la route Pro, puis de $1.50/$7.50 à partir de janvier, et vérifiez à nouveau les lignes audio et cache pour la route Flash.
Les équipes déjà passées à Gemini 3.x ou à gemini-2.5-flash-lite peuvent ignorer cette migration. Tous les autres devraient terminer l’étape 6 avant le 30 novembre : une suite de tests au vert le 1er décembre pourrait simplement signifier que le routeur répond, pas que le comportement est resté identique.
Les équipes qui construisent des agents devraient également consulter l’analyse des tarifs de Gemini 3.8 Flash pour les tâches d’agent avant de choisir les niveaux de réflexion pour les charges de travail riches en appels d’outils.
FAQ
Gemini 2.5 Pro sera-t-il arrêté le 1er décembre 2026 ?
Non. Google présente le 1er décembre 2026 comme une date de redirection pour la Gemini Developer API : les requêtes vers gemini-2.5-pro seront envoyées vers gemini-3.8-flash au lieu de renvoyer une erreur.
Les requêtes redirigées seront-elles facturées aux anciens ou aux nouveaux tarifs ?
Aux nouveaux tarifs. Une requête envoyée sous gemini-2.5-pro après le 1er décembre sera facturée selon les tarifs de Gemini 3.8 Flash, tandis qu’une requête gemini-2.5-flash sera facturée selon ceux de Gemini 3.5 Flash-Lite.
Dois-je modifier le code puisque la redirection est automatique ?
Oui. La configuration de réflexion, les paramètres d’échantillonnage, les tours préremplis et la gestion des appels de fonctions diffèrent sur Gemini 3.x. Un code inchangé peut rencontrer des paramètres ignorés, des erreurs HTTP 400 ou un comportement de raisonnement sensiblement différent.
Le 1er décembre concerne-t-il Vertex AI ?
Non. Le 1er décembre est la date annoncée pour la Gemini Developer API. Google Cloud documente des dates de retrait distinctes, en octobre 2026, pour Gemini 2.5 sur Vertex AI et l’Enterprise Agent Platform.
Gemini 2.5 Flash-Lite est-il concerné ?
Non. Google indique que gemini-2.5-flash-lite n’est pas déprécié et reste disponible jusqu’à nouvel ordre.
Quel modèle de remplacement choisir pour chaque usage ?
Choisissez selon la tâche, puis évaluez les résultats. Ne partez pas du principe qu’un modèle Flash équivaut à l’ancien modèle Pro.
| Usage actuel | Cible explicite | Point de vigilance |
|---|---|---|
| Prompts Pro généralistes, code, longs documents | gemini-3.8-flash avec medium ou plus | Changement de gamme Pro vers Flash ; réévaluez la qualité, la longueur des sorties et le prix des entrées en janvier |
| Agents avec outils | gemini-3.8-flash avec medium ou high | thought_signature, identifiants de réponse et arrêt prématuré avec minimal |
| Classification, extraction, routage | gemini-3.5-flash-lite avec minimal | Le choix le moins cher ; passez à medium si des outils sont ajoutés |
| Chaînes de transcription audio | gemini-3.5-flash-lite | Le prix des entrées audio passe de $1.00 à $0.30 ; vérifiez les lignes de cache |
Ce qu’il faut faire avant le 30 novembre
Modifiez les deux identifiants de modèle cette semaine, corrigez la gestion de la réflexion et des outils, puis établissez une nouvelle référence avec les modèles de remplacement tant que Gemini 2.5 répond encore. La redirection de décembre évitera la panne, mais seule une migration menée en novembre vous permettra de garder le comportement et la facture sous contrôle.